

Antecedentes
Siendo un aficionado al hardware retro, compré un ZX Spectrum+ a un vendedor del Reino Unido. Junto con el ordenador, recibí varias cintas de casete con juegos (en el embalaje original con instrucciones), así como programas grabados en casetes sin ninguna identificación especial. Para mi sorpresa, los datos de las cintas de 40 años de antigüedad se leían bien y logré cargar casi todos los juegos y programas desde ellas.
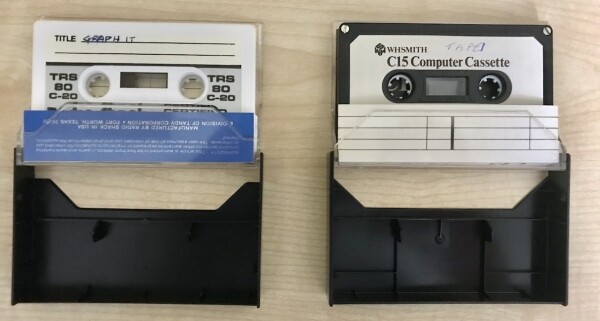
Sin embargo, en algunas cintas encontré grabaciones que claramente no fueron hechas con un ZX Spectrum. Sonaban completamente diferentes y, a diferencia de las grabaciones del mencionado ordenador, no comenzaban con el corto cargador BASIC que suele estar presente en las grabaciones de todos los programas y juegos.
Durante un tiempo, esto me inquietó; realmente quería saber qué había oculto en ellas. Si lograra leer la señal de audio como una secuencia de bytes, podría buscar símbolos o algo que indicara el origen de la señal. Una especie de arqueología retro.
Ahora, cuando he recorrido todo el camino y miro las etiquetas de las cintas, sonrío porque
la respuesta estuvo justo delante de mis ojos todo este tiempo.
En la etiqueta de la cinta izquierda está el nombre del ordenador TRS-80, y un poco más abajo el nombre del fabricante: «Manufactured by Radio Shack in USA»
(Si deseas mantener la intriga hasta el final, no entres en el spoiler)
Comparación de señales de audio
Lo primero que haremos es digitalizar las grabaciones de audio. Puedes escuchar cómo suena:
Y así suena normalmente una grabación del ordenador ZX Spectrum:
En ambos casos, al principio de la grabación presente el llamado tonalidad piloto — un sonido de una frecuencia (en la primera grabación es muy corto <1 seg, pero distinguible). La tonalidad piloto sirve de señal para que el ordenador se prepare para recibir datos. Por lo general, cada ordenador reconoce solo su «tonalidad piloto» según la forma de la señal y su frecuencia.
Es necesario mencionar la forma de la señal. Por ejemplo, en el ZX Spectrum, su forma es rectangular:
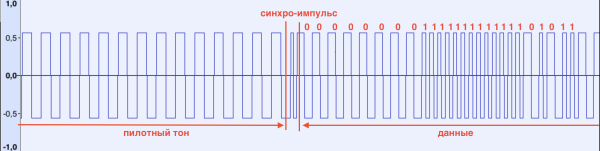
Al detectar la tonalidad piloto, el ZX Spectrum muestra franjas alternas de rojo y azul en la parte de borde de la pantalla, indicando que la señal ha sido reconocida. La tonalidad piloto termina con un pulso de sincronización., que señala a la computadora que debe comenzar a aceptar datos. Se caracteriza por una duración menor (en comparación con el tono de piloto y los datos posteriores) (ver figura).
Después de que se recibe el pulso de sincronización, la computadora registra cada subida/bajada de la señal, midiendo su duración. Si la duración es menor que un umbral determinado, se almacena un bit 1 en la memoria; de lo contrario, se almacena un 0. Los bits se agrupan en bytes y el proceso se repite hasta que se obtienen N bytes. El número N, por lo general, se toma de la cabecera del archivo que se está cargando. La secuencia de carga es la siguiente:
- tonalidad piloto
- cabecera (de longitud fija), que contiene el tamaño de los datos a cargar (N), el nombre y el tipo de archivo.
- tonalidad piloto
- los propios datos.
Para asegurarse de que los datos se han cargado correctamente, el ZX Spectrum lee el último byte denominado byte de paridad. (parity byte), que se calcula al guardar el archivo mediante la operación XOR sobre todos los bytes de los datos almacenados. Al leer el archivo, la computadora calcula el byte de paridad a partir de los datos recibidos y, si el resultado difiere del guardado, muestra un mensaje de error «Error de carga de cinta R». Estrictamente hablando, la computadora puede emitir este mensaje antes, si al leer no puede reconocer el pulso (se perdió o su duración no corresponde a los límites determinados).
Así que, ahora veamos cómo se ve una señal desconocida:
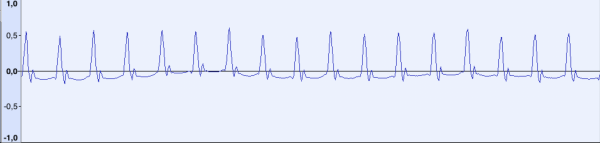
Este es el tono de piloto. La forma de la señal es significativamente diferente, pero se puede observar que la señal consiste en pulsos cortos repetidos de una frecuencia determinada. Con una frecuencia de muestreo de 44100 Hz, la distancia entre los «picos» es aproximadamente igual a 48 muestras (lo que corresponde a una frecuencia de ~918 Hz). Recordemos este número.
Veamos ahora un fragmento de datos:
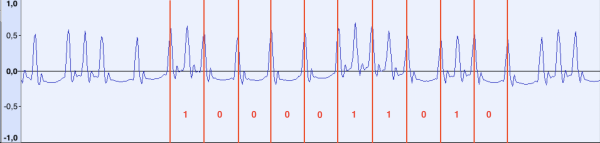
Si se mide la distancia entre los pulsos individuales, se descubrirá que entre los «pulsos largos» la distancia sigue siendo de ~48 muestras, mientras que entre los cortos es de ~24. Avanzando un poco, diré que al final se descubrió que los pulsos de referencia a una frecuencia de 918 Hz siguen de manera continua, desde el principio hasta el final del archivo. Se puede suponer que durante la transmisión de datos, si entre los pulsos de referencia aparece un pulso adicional, se cuenta como un bit 1; de lo contrario, como un 0.
¿Qué pasa con el pulso de sincronización? Miremos el comienzo de los datos:
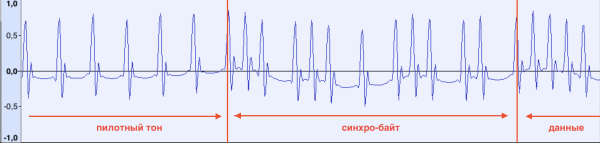
El tono piloto termina y los datos comienzan de inmediato. Un poco más tarde, al analizar varias grabaciones de audio diferentes, se pudo descubrir que el primer byte de datos siempre es el mismo (10100101b, A5h). Es posible que la computadora comience a leer los datos después de recibirlo.
También se puede prestar atención al desplazamiento del primer pulso de referencia inmediatamente después del último 1 en el sincrobite. Se pudo detectar significativamente más tarde en el proceso de desarrollo del programa de reconocimiento de datos, cuando los datos al principio del archivo no podían ser leídos de manera estable.
Ahora intentaremos describir el algoritmo que procesará el archivo de audio y cargará los datos.
Carga de datos
Primero, consideremos algunas suposiciones para no complicar el algoritmo:
- Consideraremos archivos solo en formato WAV;
- El archivo de audio debe comenzar con un tono piloto y no debe contener silencio al principio.
- El archivo original debe tener una frecuencia de muestreo de 44100 Hz. En este caso, la distancia entre los pulsos de referencia de 48 muestras ya está definida y no necesitamos calcularla programáticamente;
- El formato de las muestras puede ser cualquier (8/16 bits/ punto flotante) — ya que al leer podemos convertirlo al necesario;
- Supondremos que el archivo original está normalizado en amplitud, lo que debería estabilizar el resultado;
El algoritmo de lectura será el siguiente:
- Leemos el archivo en memoria, convirtiendo simultáneamente el formato de las muestras a 8 bits;
- Determinamos la posición del primer pulso en los datos de audio. Para esto, necesitamos calcular el número de muestra con la amplitud máxima. Para simplificar, lo contaremos una vez manualmente. Lo guardaremos en la variable prev_pos;
- Sumamos 48 a la posición del último pulso (pos := prev_pos + 48)
- Dado que el aumento de la posición en 48 no garantiza que lleguemos a la posición del siguiente impulso de referencia (defectos de la cinta, funcionamiento inestable del mecanismo de transporte de la cinta, etc.), se debe corregir la posición del impulso pos. Para ello, tomaremos un pequeño tramo de datos (pos-8;pos+8) y encontraremos el máximo valor de amplitud en él. Guardaremos la posición correspondiente al máximo en pos. Aquí 8 = 48/6 — una constante obtenida experimentalmente, que garantiza que determinemos el verdadero máximo y no toquemos otros impulsos que puedan estar cerca. En casos muy malos, cuando la distancia entre impulsos sea significativamente menor o mayor que 48, se puede implementar una búsqueda forzada del impulso, pero no describiré esto en el algoritmo dentro del artículo.
- En el paso anterior también es necesario verificar que se ha encontrado el impulso de referencia. Es decir, simplemente buscar el máximo no garantiza que el impulso esté presente en este tramo. En mi última implementación del programa de lectura, verifico la diferencia entre el valor máximo y el mínimo de la amplitud en el tramo, y si esta excede un cierto límite, considero que hay un impulso presente. También surge la cuestión de qué hacer si no se encuentra el impulso de referencia. Aquí hay dos opciones: o bien los datos han terminado y luego sigue el silencio, o bien esto debe considerarse como un error de lectura. Sin embargo, omitiremos esto para simplificar el algoritmo.
- En el siguiente paso, es necesario determinar la presencia del impulso de datos (bit 0 o 1). Para ello, tomaremos la mitad del tramo (prev_pos;pos) middle_pos igual a middle_pos := (prev_pos+pos)/2 y en cierta vecindad de middle_pos en el tramo (middle_pos-8;middle_pos+8) contaremos el máximo y mínimo de la amplitud. Si la diferencia entre ellos es mayor que 10, registramos en el resultado el bit 1, de lo contrario, 0. 10 es una constante obtenida prácticamente.
- Guardamos la posición actual en prev_pos (prev_pos := pos)
- Repetimos a partir del paso 3, hasta que leamos todo el archivo.
- El arreglo de bits obtenido debe ser guardado como un conjunto de bytes. Dado que no tomamos en cuenta el byte de sincronización al leer, el número de bits puede no ser múltiplo de 8, y también se desconoce el desplazamiento necesario en bits. En la primera implementación del algoritmo, no sabía de la existencia del byte de sincronización y simplemente guardaba 8 archivos con diferentes cantidades de desplazamiento de bits. Uno de ellos contenía datos correctos. En el algoritmo final, simplemente elimino todos los bits hasta A5h, lo que permite obtener un archivo correcto de inmediato.
Algoritmo en Ruby, para quien le interese.
Elegí Ruby como lenguaje para escribir el programa, ya que la mayor parte del tiempo programo en él. La opción no es muy eficiente, sin embargo, no se busca hacer que la velocidad de lectura sea lo más rápida posible.
# Используем gem 'wavefile'
require 'wavefile'

reader = WaveFile::Reader.new('input.wav')
samples = []
format = WaveFile::Format.new(:mono, :pcm_8, 44100)

# Читаем WAV файл, конвертируем в формат Mono, 8 bit
# Массив samples будет состоять из байт со значениями 0-255
reader.each_buffer(10000) do |buffer|
  samples += buffer.convert(format).samples
end

# Позиция первого импульса (вместо 0)
prev_pos = 0
# Расстояние между импульсами
distance = 48
# Значение расстояния для окрестности поиска локального максимума
delta = (distance / 6).floor
# Биты будем сохранять в виде строки из "0" и "1"
bits = ""

loop do
  # Рассчитываем позицию следующего импульса
  pos = prev_pos + distance

  # Выходим из цикла если данные закончились
  break if pos + delta >= samples.size

  # Корректируем позицию pos обнаружением максимума на отрезке [pos - delta;pos + delta]
  (pos - delta..pos + delta).each { |p| pos = p if samples[p] > samples[pos] }

  # Находим середину отрезка [prev_pos;pos]
  middle_pos = ((prev_pos + pos) / 2).floor

  # Берем окрестность в середине
  sample = samples[middle_pos - delta..middle_pos + delta]

  # Определяем бит как "1" если разница между максимальным и минимальным значением на отрезке превышает 10
  bit = sample.max - sample.min > 10
  bits += bit ? "1" : "0"
end

# Определяем синхро-байт и заменяем все предшествующие биты на 256 бит нулей (согласно спецификации формата)
bits.gsub! /^[01]*?10100101/, ("0" * 256) + "10100101"

# Сохраняем выходной файл, упаковывая биты в байты
File.write "output.cas", [bits].pack("B*")
Resultado
Después de probar varias versiones del algoritmo y constantes, tuve la suerte de obtener algo extremadamente interesante:
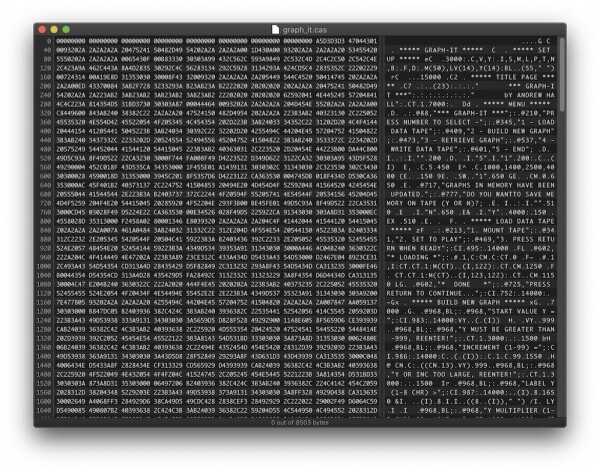
Entonces, según las cadenas de caracteres, tenemos un programa para construir gráficos. Sin embargo, en el texto del programa faltan las palabras clave. Todas las palabras clave están codificadas en forma de bytes (cuyo valor es > 80h). Ahora necesitamos averiguar qué computadora de los 80 podría guardar programas en ese formato.
De hecho, se parece mucho a un programa en lenguaje BASIC. Aproximadamente en el mismo formato, la computadora ZX Spectrum almacena en su memoria y guarda programas en cinta. Por si acaso, verifiqué las palabras clave con . Sin embargo, el resultado resultó ser negativo.
También verifiqué las palabras clave BASIC de computadoras populares de la época como Atari, Commodore 64 y algunas otras para las que logré encontrar documentación, pero sin éxito; mis conocimientos sobre las variedades de computadoras retro no eran tan amplios.
Entonces decidí seguir por , y aquí mi mirada se posó en el nombre del fabricante Radio Shack y la computadora TRS-80. ¡Precisamente esos nombres estaban escritos en las etiquetas de las cintas que tenía sobre mi escritorio! No conocía esos nombres anteriormente y no estaba familiarizado con la computadora TRS-80, así que me parecía que Radio Shack era un fabricante de cintas de audio, como BASF, Sony o TDK, y que el TRS-80 — era la duración de reproducción. ¿Por qué no?
Computadora Tandy/Radio Shack TRS-80
Es muy probable que la grabación de audio que mencioné como ejemplo al principio del artículo haya sido hecha en una computadora así:
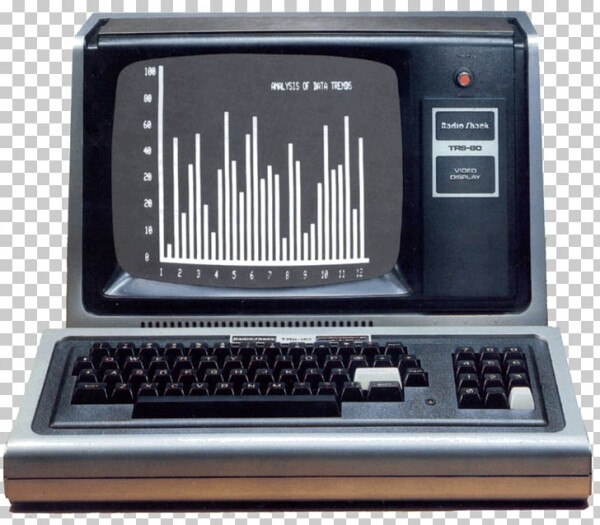
Resulta que esta computadora y sus variantes (Model I/Model III/Model IV, etc.) fueron muy populares en su tiempo (por supuesto, no en Rusia). Es notable que el procesador utilizado en ellas también era un Z80. Se puede encontrar mucha información sobre esta computadora en Internet. . En la década de los 80, la información sobre la computadora se difundía en . En la actualidad, existen varios de la computadora para diferentes plataformas.
Cargué el emulador y pude ver por primera vez cómo funcionaba esta computadora. Por supuesto, la computadora no soportaba salida en color, la resolución de la pantalla era de solo 128x48 píxeles, pero había muchas extensiones y modificaciones que podían aumentar la resolución de la pantalla. También había muchas variantes de sistemas operativos para esta computadora y opciones de implementación del lenguaje BASIC (que, a diferencia del ZX Spectrum, en algunos modelos ni siquiera estaba 'grabado' en la ROM y cualquier opción podía cargarse desde un disquete, al igual que el propio sistema operativo).
También encontré una herramienta para convertir grabaciones de audio al formato CAS, que es compatible con los emuladores, sin embargo, no pude leer las grabaciones de mis cintas por alguna razón.
Después de entender el formato del archivo CAS (que resultó ser simplemente una copia bit a bit de los datos de la cinta que ya tenía en mis manos, excepto por el encabezado con la presencia de un byte de sincronización), hice algunos cambios en mi programa y pude generar un archivo CAS funcional que trabajó en el emulador (TRS-80 Model III):
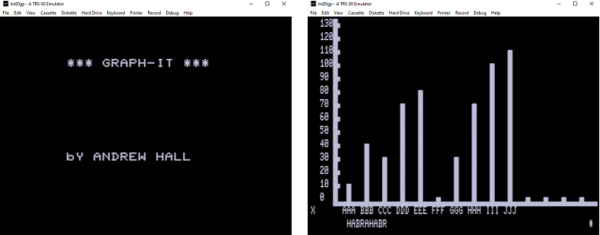
La última versión de la herramienta de conversión con detección automática del primer impulso y la distancia entre los impulsos de referencia la empaqueté como un paquete GEM, el código fuente está disponible en .
Conclusión
El camino recorrido resultó ser un emocionante viaje al pasado y me alegra haber encontrado la solución. Además,
- investigé el formato de guardado de datos en el ZX Spectrum y estudié las subrutinas integradas en ROM para guardar/leer datos de cintas de audio.
- Conocí la computadora TRS-80 y sus variantes, estudié el sistema operativo, revisé ejemplos de programas e incluso tuve la oportunidad de hacer depuración en código máquina (todas las mnemotécnicas Z80 me son bien conocidas).
- Desarrollé una herramienta completa para convertir grabaciones de audio al formato CAS, que puede leer datos no reconocidos por la herramienta "oficial".
Fuente: habr.com
