

La traducción del artículo ha sido preparada en la víspera del inicio del curso
El entrenamiento distribuido en múltiples instancias computacionales de alto rendimiento puede reducir el tiempo de entrenamiento de redes neuronales profundas modernas en grandes volúmenes de datos de varias semanas a horas, o incluso minutos, lo que convierte esta técnica en la más utilizada en aplicaciones prácticas de aprendizaje profundo. Los usuarios deben comprender cómo compartir y sincronizar datos en múltiples instancias, lo que a su vez tiene un gran impacto en la eficiencia del escalado. Además, los usuarios también deben saber cómo desplegar un script de entrenamiento en múltiples instancias que funcione en una sola instancia.
En este artículo, hablaremos sobre una forma rápida y sencilla de entrenamiento distribuido utilizando la biblioteca de código abierto para aprendizaje profundo Apache MXNet y el marco de trabajo de entrenamiento distribuido Horovod. Demostraremos claramente las ventajas del marco Horovod en términos de rendimiento y cómo escribir un script de entrenamiento de MXNet para que funcione de manera distribuida con Horovod.
Qué es Apache MXNet
es un marco de código abierto para aprendizaje profundo que se utiliza para crear, entrenar y desplegar redes neuronales profundas. MXNet abstrae las complejidades asociadas con la implementación de redes neuronales, ofrece un alto rendimiento y escalabilidad, y proporciona API para lenguajes de programación populares, como , , , , , , y otros.
Entrenamiento distribuido en MXNet con servidor de parámetros
utiliza un enfoque de servidor de parámetros (parameter server). Utiliza un conjunto de servidores de parámetros para recopilar gradientes de cada trabajador, realizar la agregación y enviar los gradientes actualizados de vuelta a los trabajadores para la siguiente iteración de optimización. La definición de la correcta proporción de servidores a trabajadores es clave para un escalado eficiente. Si hay solo un servidor de parámetros, puede convertirse en un cuello de botella en los cálculos. Por el contrario, si se utilizan demasiados servidores, la conexión “muchos-a-muchos” puede saturar todas las conexiones de red.
Qué es Horovod
Un marco abierto de aprendizaje profundo distribuido, desarrollado en Uber. Utiliza tecnologías eficientes de interacción entre múltiples GPU y nodos, como la NVIDIA Collective Communications Library (NCCL) y Message Passing Interface (MPI) para la distribución y agregación de parámetros del modelo entre los workers. Optimiza el uso del ancho de banda de la red y se escala bien al trabajar con modelos de redes neuronales profundas. Actualmente, admite varios marcos populares de aprendizaje automático, a saber, , Tensorflow, Keras y PyTorch.
Integración de MXNet y Horovod
MXNet se integra con Horovod a través de la API de aprendizaje distribuido, definida en Horovod. En Horovod, las API de comunicación horovod.broadcast(), horovod.allgather() y horovod.allreduce() se implementan mediante callbacks asíncronos del motor MXNet, como parte de su grafo de tareas. Así, las dependencias de datos entre la comunicación y los cálculos son manejadas con facilidad por el motor MXNet, para evitar pérdidas de rendimiento debido a la sincronización. El objeto optimizador distribuido, definido en Horovod horovod.DistributedOptimizer extiende Optimizer en MXNet de tal manera que llama a las API correspondientes de Horovod para la actualización distribuida de parámetros. Todos estos detalles de implementación son transparentes para los usuarios finales.
Inicio rápido
Puedes comenzar rápidamente a entrenar una pequeña red neuronal convolucional en el conjunto de datos MNIST utilizando MXNet y Horovod en tu MacBook.
Para empezar, instala mxnet y horovod desde PyPI:
pip install mxnet
pip install horovod
Nota: Si recibes un error durante pip install horovod, es posible que debas agregar la variable MACOSX_DEPLOYMENT_TARGET=10.vv, donde vv – es la versión de tu versión de MacOS, por ejemplo, para MacOSX Sierra deberás escribir MACOSX_DEPLOYMENT_TARGET=10.12 pip install horovod
Luego, instala OpenMPI. .
Finalmente, descarga el script de prueba mxnet_mnist.py y ejecuta los siguientes comandos en la terminal de tu MacBook en el directorio de trabajo:
mpirun -np 2 -H localhost:2 -bind-to none -map-by slot python mxnet_mnist.pyAsí iniciarás el entrenamiento en dos núcleos de tu procesador. La salida será la siguiente:
INFO:root:Epoch[0] Batch [0-50] Speed: 2248.71 samples/sec      accuracy=0.583640
INFO:root:Epoch[0] Batch [50-100] Speed: 2273.89 samples/sec      accuracy=0.882812
INFO:root:Epoch[0] Batch [50-100] Speed: 2273.39 samples/sec      accuracy=0.870000
Demostración de rendimiento
Al entrenar el modelo ResNet50-v1 en el conjunto de datos ImageNet en 64 GPU con ocho instancias p3.16xlarge EC2, cada uno de los cuales contiene 8 GPU NVIDIA Tesla V100 en la nube de AWS, alcanzamos un rendimiento de entrenamiento de 45000 imágenes/segundo (es decir, el número de muestras entrenadas por segundo). El entrenamiento se completó en 44 minutos después de 90 épocas con la mejor precisión del 75.7%.
Comparámos esto con el entrenamiento distribuido MXNet usando un enfoque con servidores de parámetros en 8, 16, 32 y 64 GPU con un servidor con un solo parámetro y una relación de servidores a trabajadores de 1 a 1 y 2 a 1 respectivamente. El resultado se puede ver en la Figura 1 a continuación. En el eje y a la izquierda, las columnas reflejan el número de imágenes para entrenamiento por segundo, y las líneas reflejan la eficiencia de escalado (es decir, la relación de la capacidad de rendimiento real a la ideal) en el eje y a la derecha. Como pueden ver, elegir la cantidad de servidores afecta la eficiencia de escalado. Si hay un servidor de parámetros, la eficiencia de escalado cae al 38% en 64 GPU. Para lograr la misma eficiencia de escalado que con Horovod, es necesario duplicar el número de servidores en relación con la cantidad de trabajadores.
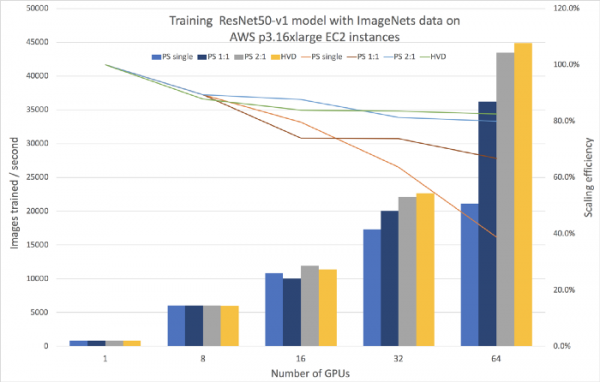
Figura 1. Comparación del entrenamiento distribuido usando MXNet con Horovod y con un servidor de parámetros.
En la Tabla 1 a continuación, comparamos el costo total de la instancia al realizar experimentos en 64 GPU. Usar MXNet junto con Horovod proporciona la mejor capacidad de rendimiento al menor costo.
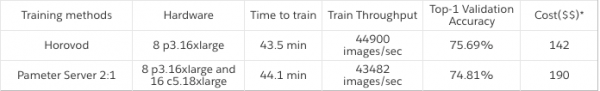
Tabla 1. Comparación de costos entre Horovod y un servidor de parámetros con una relación de servidores a trabajadores de 2 a 1.
Pasos para reproducir
En los siguientes pasos, explicaremos cómo reproducir el resultado del entrenamiento distribuido usando MXNet y Horovod. Para saber más sobre el entrenamiento distribuido con MXNet, lea .
Compra una suscripción
Cree un clúster de instancias homogéneas con MXNet versión 1.4.0 o superior y Horovod versión 0.16.0 o superior para utilizar el entrenamiento distribuido. También necesitará instalar las bibliotecas para entrenamiento en GPU. Para nuestras instancias, elegimos Ubuntu 16.04 Linux, con Driver GPU 396.44, CUDA 9.2, biblioteca cuDNN 7.2.1, comunicador NCCL 2.2.13 y OpenMPI 3.1.1. También puede usar , donde estas bibliotecas ya están preinstaladas.
Paso 2
Agregue la posibilidad de trabajar con la API Horovod en su script de entrenamiento con MXNet. El siguiente script basado en la API Gluon de MXNet se puede utilizar como una plantilla simple. Las líneas en negrita son necesarias si ya tiene un script de entrenamiento correspondiente. Aquí hay algunos cambios críticos que deben hacerse para el entrenamiento con Horovod:
- Establezca el contexto de acuerdo con el rango local de Horovod (línea 8) para asegurarse de que el entrenamiento se esté realizando en la GPU correcta.
- Transmita los parámetros iniciales de un trabajador a todos (línea 18) para asegurarse de que todos los trabajadores comiencen con los mismos parámetros iniciales.
- Cree Horovod DistributedOptimizer (línea 25), para actualizar los parámetros de manera distribuida.
Para obtener el script completo, consulte los ejemplos de Horovod-MXNet y .
1  import mxnet as mx
2  import horovod.mxnet as hvd
3
4  # Horovod: inicializar Horovod
5  hvd.init()
6
7  # Horovod: asignar una GPU para ser utilizada al rango local
8  context = mx.gpu(hvd.local_rank())
9
10 # Construir el modelo
11 model = ...
12
13 # Inicializar parámetros
14 model.initialize(initializer, ctx=context)
15 params = model.collect_params()
16
17 # Horovod: transmitir parámetros
18 hvd.broadcast_parameters(params, root_rank=0)
19
20 # Crear optimizador
21 optimizer_params = ...
22 opt = mx.optimizer.create('sgd', **optimizer_params)
23
24 # Horovod: envolver el optimizador con DistributedOptimizer
25 opt = hvd.DistributedOptimizer(opt)
26
27 # Crear entrenador y función de pérdida
28 trainer = mx.gluon.Trainer(params, opt, kvstore=None)
29 loss_fn = ...
30
31 # Entrenar modelo
32 for epoch in range(num_epoch):
33    ...
Paso 3
Inicie sesión en uno de los trabajadores para ejecutar el entrenamiento distribuido mediante la directiva MPI. En este ejemplo, el entrenamiento distribuido se inicia en cuatro instancias con 4 GPU en cada una, y con un total de 16 GPU en el clúster. Se utilizará el optimizador de descenso de gradiente estocástico (SGD) con los siguientes hiperparámetros:
- tamaño de mini-lote: 256
- tasa de aprendizaje: 0.1
- momentum: 0.9
- decadencia de peso: 0.0001
A medida que escalamos de una GPU a 64 GPU, escalamos linealmente la velocidad de aprendizaje en función del número de GPU (de 0.1 para 1 GPU a 6.4 para 64 GPU), manteniendo el número de imágenes por GPU en 256 (de un lote de 256 imágenes para 1 GPU a 16,384 para 64 GPU). Los parámetros de decadencia de peso y momentum se ajustaron a medida que aumentaba el número de GPU. Utilizamos precisión mixta para el entrenamiento con el tipo de datos float16 en la pasada hacia adelante y float32 para los gradientes, con el fin de acelerar los cálculos en float16, soportados por las GPU NVIDIA Tesla.
$ mpirun -np 16
    -H server1:4,server2:4,server3:4,server4:4
    -bind-to none -map-by slot
    -mca pml ob1 -mca btl ^openib
    python mxnet_imagenet_resnet50.py
Conclusión
En este artículo, analizamos un enfoque escalable para el aprendizaje distribuido de modelos utilizando Apache MXNet y Horovod. Mostramos la efectividad del escalado y la rentabilidad en comparación con el enfoque de servidor de parámetros en el conjunto de datos ImageNet, en el que se entrenó el modelo ResNet50-v1. También detallamos los pasos que puede seguir para modificar un script existente y ejecutar el entrenamiento en múltiples instancias usando Horovod.
Si recién está comenzando a trabajar con MXNet y aprendizaje profundo, visite la página de instalación , para primero compilar MXNet. También le recomendamos encarecidamente que lea el artículo , para comenzar.
Si ya ha trabajado con MXNet y desea probar el aprendizaje distribuido con Horovod, consulte la , compílelo con MXNet y siga el ejemplo o .
*el costo se calcula en función de la de AWS para las instancias EC2
Descubre más sobre el curso
Fuente: habr.com
