

Hoy en día existen 100500 cursos de Data Science y es bien sabido que se puede ganar mucho dinero en Data Science precisamente vendiendo cursos de Data Science (¿para qué cavar, cuando se pueden vender palas?). El principal inconveniente de estos cursos es que no tienen nada que ver con el trabajo real: nadie te proporcionará datos limpios y procesados en el formato necesario. Y cuando terminas el curso y comienzas a resolver un problema real, surgen muchos matices.
Por eso comenzamos una serie de notas llamadas «Qué puede salir mal con Data Science», basadas en eventos reales que me han sucedido a mí, a mis compañeros y colegas. Vamos a analizar ejemplos reales de tareas típicas de Data Science: cómo sucede realmente. Comencemos hoy con la tarea de recopilación de datos.
Y lo primero con lo que tropiezan las personas al comenzar a trabajar con datos reales es, en realidad, la recopilación de esos datos que son relevantes para nosotros. El mensaje clave de este artículo es:
Subestimamos sistemáticamente el tiempo, los recursos y los esfuerzos necesarios para recopilar, limpiar y preparar datos.
Y lo más importante, discutiremos qué hacer para evitar que esto suceda.
Según diversas estimaciones, la limpieza, transformación, procesamiento de datos, ingeniería de características, etc., ocupan entre el 80 y el 90% del tiempo, mientras que el análisis toma del 10 al 20%, mientras que prácticamente todo el material de aprendizaje se centra exclusivamente en el análisis.
Vamos a desglosar cómo un ejemplo típico de una tarea analítica sencilla en tres variantes y veremos cuáles pueden ser las «circunstancias agravantes».
Y para el ejemplo, nuevamente, consideraremos variaciones similares de la tarea de recopilación de datos y comparación de comunidades para:
- Dos subreddits de Reddit
- Dos secciones de Habr
- Dos grupos de Odnoklassniki
Enfoque condicional en teoría
Abrir el sitio y leer ejemplos, si es claro, dedicar unas horas a la lectura, unas horas al código por los ejemplos y la depuración. Añadir unas horas para la recopilación. Sumar unas horas extra (multiplicar por dos y añadir N horas).
El punto clave: la estimación de tiempo se basa en suposiciones e conjeturas sobre cuánto tiempo tomará.
Para comenzar el análisis del tiempo, es necesario evaluar los siguientes parámetros para la tarea condicional descrita anteriormente:
- Cuál es el tamaño de los datos y cuánto se necesita recopilar físicamente (*ver abajo*).
- Cuál es el tiempo de recolección de un registro y cuánto tiempo se necesita esperar antes de poder recoger el segundo.
- Incorporar la escritura de código que conserve el estado y que inicie un reinicio cuando (y no si) todo falle.
- Determinar si necesitamos autorización e implementar el tiempo de acceso a través de API.
- Incorporar la cantidad de errores como una función de la complejidad de los datos; evaluar según la tarea específica: estructura, cuántas transformaciones, qué y cómo extraemos.
- Incorporar errores de red y problemas con el comportamiento no estándar del proyecto.
- Evaluar si las funciones necesarias están en la documentación y, si no lo están, cuántas y cómo se necesitan para una solución alternativa.
Lo más importante para evaluar el tiempo es que realmente necesitas dedicar tiempo y esfuerzo a la "exploración inicial"; solo así tu planificación será adecuada. Por lo tanto, aunque te presionen para que digas "cuánto tiempo se necesita para recopilar datos", asegúrate de que te den tiempo para un análisis preliminar y argumenta que el tiempo variará según los parámetros reales de la tarea.
Y ahora vamos a mostrar ejemplos concretos donde tales parámetros cambiarán.
El punto clave: la estimación se basa en el análisis de factores clave que influyen en el volumen y la complejidad del trabajo.
La estimación basada en conjeturas es un buen enfoque cuando los elementos funcionales son bastante pequeños y no hay muchos factores que puedan afectar significativamente la estructura de la tarea. Pero en el caso de varias tareas de Data Science, hay muchos factores, y este enfoque se vuelve inadecuado.
Comparación de comunidades de Reddit
Comencemos con el caso más simple (como resultará después). En realidad, si somos completamente honestos, tenemos casi el caso ideal; verifiquemos nuestra lista de verificación de complejidad:
- Contamos con un API limpio, claro y documentado.
- Es extremadamente fácil y, lo principal, se obtiene automáticamente un token.
- Hay — con un montón de ejemplos.
- Comunidad que se dedica al análisis y recopilación de datos en Reddit (hasta videos de YouTube que explican cómo usar el python wrapper) .
- Los métodos que necesitamos probablemente existen en el API. Además, el código se ve compacto y limpio; aquí hay un ejemplo de una función que recopila comentarios sobre una publicación.
def get_comments(submission_id):
    reddit = Reddit(check_for_updates=False, user_agent=AGENT)
    submission = reddit.submission(id=submission_id)
    more_comments = submission.comments.replace_more()
    if more_comments:
        skipped_comments = sum(x.count for x in more_comments)
        logger.debug('Skipped %d MoreComments (%d comments)',
                     len(more_comments), skipped_comments)
    return submission.comments.list()
Tomado de colecciones de utilidades convenientes para envolver.
A pesar de que este es el mejor caso, aún debemos tener en cuenta una serie de factores importantes de la vida real:
- Límites de API: nos vemos obligados a tomar datos en lotes (esperar entre solicitudes, etc.).
- Tiempo de recolección: para un análisis completo y comparación, deberemos dedicar un tiempo considerable solo para que el spider pase por el subreddit.
- El bot debe funcionar en un servidor: no puedes simplemente ejecutarlo en una laptop, meterlo en una mochila y salir a hacer tus cosas. Por eso, lo he ejecutado todo en un VPS. Con el código promocional habrahabr10 puedes ahorrar un 10% adicional.
- La inaccesibilidad física de algunos datos (son visibles para los administradores o son muy difíciles de recopilar) debe ser considerada, no todos los datos pueden ser recopilados en un tiempo razonable.
- Errores de funcionamiento de la red: trabajar con la red es complicado.
- Estos son datos reales y vivos, nunca son completamente limpios.
Por supuesto, es necesario tener en cuenta los matices mencionados en el desarrollo. Las horas/días específicos dependen de la experiencia en desarrollo o en tareas similares, sin embargo, vemos que esta tarea es puramente ingenieril y no requiere movimientos adicionales para su resolución: se puede evaluar, detallar y realizar todo muy bien.
Comparación de secciones de Habr
Pasemos a un caso más interesante y no trivial, comparando flujos y/o secciones de Habr.
Revisaremos nuestra lista de verificación de complejidad: aquí, para entender cada punto, ya será necesario experimentar un poco con la tarea misma.
- Al principio piensas que hay API, pero no la hay. Sí, Habr tiene API, pero solo está disponible para administradores (o puede que no funcione en absoluto).
- Después simplemente comienzas a parsear html: "import requests", ¿qué podría salir mal?
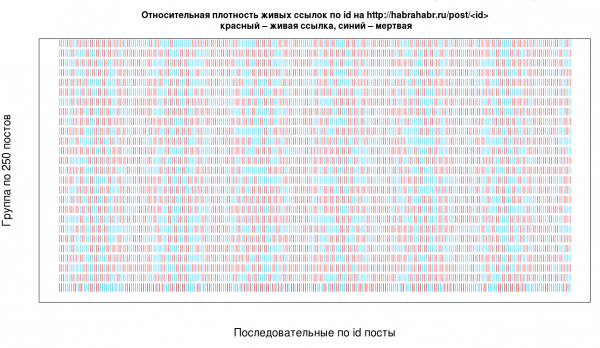
- ¿Y cómo se para todo? El enfoque más simple y utilizado es iterar por ID, cabe destacar que no es el más eficiente y deberás manejar diferentes casos: aquí, por ejemplo, está la densidad de ID reales entre todos los existentes.

Tomado de artículo. - Los datos en crudo envueltos en HTML a través de la red son un dolor. Por ejemplo, si deseas recopilar y almacenar la puntuación de un artículo: extraes el score del html y decides guardarlo como un número para su procesamiento posterior:
1) int(score) genera un error: ya que en Habr el signo menos, como en la cadena "–5" — es un guion corto, no un signo negativo (sorpresivo, ¿verdad?), así que en algún momento tuve que revivir el analizador con este horrible arreglo.
try:
      score_txt = post.find(class_="score").text.replace(u"–","-").replace(u"+","+")
      score = int(score_txt)
      if check_date(date):
        post_score += score
No puede haber fechas, signos positivos o negativos en absoluto (como vemos arriba en la función check_date, y eso ha sucedido).
2) Los caracteres especiales no escapados — vendrán, hay que estar preparado.
3) La estructura cambia dependiendo del tipo de publicación.
4) Las publicaciones antiguas pueden tener **una estructura extraña**.
- En esencia, el manejo de errores y lo que puede o no puede ocurrir tendrá que ser gestionado y no se puede predecir con certeza qué saldrá mal, cómo puede ser la estructura y qué fallará — solo hay que probar y tener en cuenta los errores que lanza el analizador.
- Luego te das cuenta de que necesitas analizar en múltiples hilos, de lo contrario, el análisis en uno solo tomará 30+ horas (este es solo el tiempo de ejecución de un analizador en un solo hilo que está en pausa y no cae bajo ningún tipo de ban). En el artículo, esto condujo en algún momento a un esquema similar:
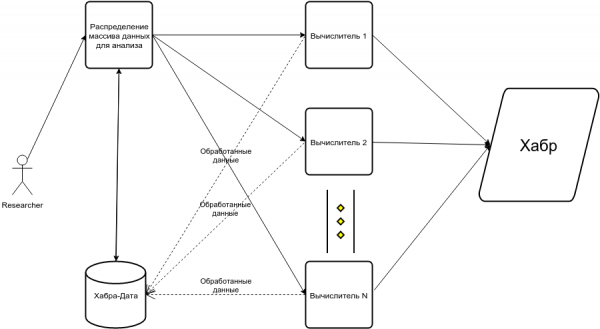
Así que el checklist por dificultad:
- Trabajo con la red y análisis de html con iteración y recorrido por ID.
- Documentos de estructura heterogénea.
- Muchos lugares donde el código puede fallar fácilmente.
- Es necesario escribir || código.
- Falta la documentación necesaria, ejemplos de código y/o comunidad.
La estimación condicional de tiempo para esta tarea será de 3 a 5 veces más alta que para la recopilación de datos de Reddit.
Comparación de grupos de Odnoklassniki
Pasemos al caso técnicamente más interesante de los descritos. Para mí, fue interesante precisamente porque a primera vista parece bastante trivial, pero en realidad no lo es — tan pronto como le pinches con un palito.
Comenzaremos con nuestra lista de verificación de dificultad y marcaremos que muchos de ellos resultarán ser mucho más complejos de lo que parecen al principio:
- Hay una API, pero carece casi por completo de las funciones necesarias.
- Para ciertas funciones, debes solicitar acceso por correo electrónico, es decir, la concesión de acceso no es inmediata.
- Está pésimamente documentado (para empezar, hay una mezcla inconsistente de términos en ruso e inglés por todas partes; a veces tienes que adivinar lo que se espera de ti en algún lugar) y, además, su diseño no se adapta para obtener datos, por ejemplo, .
- Requiere sesiones en la documentación, pero en realidad no las utiliza — y no hay manera de comprender todos los matices de los modos de API, excepto golpeando y esperando que algo funcione.
- Faltan ejemplos y comunidad, el único punto de apoyo para reunir información es un pequeño en Python (sin muchas muestras de uso).
- La opción más viable parece ser Selenium, ya que muchos de los datos necesarios están bajo llave.
1) Es decir, la autorización se realiza a través de un usuario ficticio (y el registro manualmente).2) Sin embargo, con Selenium no hay garantías de un funcionamiento correcto y repetible (al menos en el caso de ok.ru, definitivamente).
3) El sitio Ok.ru contiene errores de JavaScript y a veces se comporta de manera extraña e inconsistente.
4) Es necesario encargarse de la paginación, de la carga de elementos, etc.…
5) Los errores de API que devuelve el wrapper tendrán que ser tratados de manera chapucera, por ejemplo, así (un fragmento de código experimental):
def get_comments(args, context, discussions):
    pause = 1
    if args.extract_comments:
        all_comments = set()
#tiene sentido hacer un seguimiento de las discusiones ya procesadas
        for discussion in tqdm(discussions):
            try:
                comments = get_comments_from_discussion_via_api(context, discussion)
            except odnoklassniki.api.OdnoklassnikiError as e:
                if "NOT_FOUND" in str(e):
                    comments = set()
                else:
                    print(e)
                    bp()
                    pass
            all_comments |= comments
            time.sleep(pause)
        return all_comments
Mi error favorito fue:
OdnoklassnikiError("Error(código: 'None', descripción: 'error HTTP', método: 'discussions.getComments', params: …)")6) Al final, la opción de Selenium + API parece ser la más racional.
- Es necesario conservar el estado y reiniciar el sistema, manejar múltiples errores, incluido el comportamiento inconsistente del sitio — además, estos errores son bastante difíciles de imaginar (a menos que escribas parsers profesionalmente, por supuesto).
La estimación condicional del tiempo para esta tarea sería de 3 a 5 veces mayor que la recolección de datos de Habr. A pesar de que en el caso de Habr utilizamos un enfoque directo con el parsing de HTML, en el caso de OK podemos trabajar con el API en lugares críticos.
Conclusiones
Por mucha evaluación que se requiera 'in situ' (¡hoy tenemos planificación!) del voluminoso módulo del pipeline de procesamiento de datos, el tiempo de ejecución casi nunca puede evaluarse de manera efectiva sin un análisis de los parámetros de la tarea.
Si hablamos de manera algo más filosófica, las estrategias de evaluación en agile son adecuadas para tareas de ingeniería, pero en tareas más experimentales y, en cierto sentido, 'creativas' e investigativas, es decir, menos predecibles, surgen dificultades, como en los ejemplos que hemos discutido aquí.
Por supuesto, la recopilación de datos es simplemente un ejemplo ilustrativo: generalmente, esta tarea parece increíblemente simple y técnicamente poco complicada, y es precisamente en los detalles donde a menudo reside el diablo. Y en esta tarea se puede mostrar toda la gama de posibles variantes de lo que puede salir mal y cuánto puede alargarse el trabajo.
Si observamos rápidamente las características de la tarea sin experimentos adicionales, Reddit y OK parecen similares: hay API, un wrapper de Python, pero en esencia, la diferencia es enorme. Si juzgamos por estos parámetros, el parsing de Habr parece más complicado que OK, pero en la práctica es totalmente lo contrario y esto se puede averiguar realizando simples experimentos de análisis de parámetros de la tarea.
Según mi experiencia, el enfoque más efectivo es una estimación aproximada del tiempo que necesitarás para el análisis preliminar y los primeros experimentos simples, la lectura de la documentación; son estos los que te permitirán dar una evaluación precisa para todo el trabajo. En términos de la metodología ágil popular, pido que me creen un ticket para 'evaluar los parámetros de la tarea', a partir del cual puedo dar una estimación de lo que puede realizarse dentro del 'sprint' y proporcionar una evaluación más precisa para cada tarea.
Por lo tanto, el argumento más efectivo parece ser uno que muestre a un especialista 'no técnico' cuán variable será el tiempo y los recursos según los parámetros que aún deben ser evaluados.
Fuente: habr.com
