

Estimados lectores, buenos días. Hoy hablaremos un poco sobre Apache Spark y sus perspectivas de desarrollo.
En el mundo actual de Big Data, Apache Spark es el estándar de facto para desarrollar tareas de procesamiento por lotes. Además, se utiliza para crear aplicaciones de streaming que operan bajo el concepto de micro lotes, procesando y entregando datos en pequeñas porciones (Spark Structured Streaming). Tradicionalmente, también ha sido parte de la pila general de Hadoop, utilizando YARN como gestor de recursos (o, en algunos casos, Apache Mesos). Para el 2020, su uso en su forma tradicional por la mayoría de las empresas se encuentra en gran duda debido a la falta de distribuciones adecuadas de Hadoop: el desarrollo de HDP y CDH ha cesado, CDH está insuficientemente desarrollado y tiene un alto costo, mientras que los demás proveedores de Hadoop han dejado de existir o tienen un futuro incierto. Por lo tanto, la comunidad y las grandes empresas están cada vez más interesadas en ejecutar Apache Spark a través de Kubernetes, que se ha establecido como el estándar en la orquestación de contenedores y la gestión de recursos en nubes privadas y públicas, resolviendo el problema de la planificación incómoda de recursos de las tareas de Spark en YARN y ofreciendo una plataforma en constante evolución con múltiples distribuciones comerciales y de código abierto para empresas de todos los tamaños y sectores. Además, con la ola de popularidad, la mayoría ya ha logrado establecer un par de sus instalaciones y aumentar su experiencia en su uso, lo que facilita la migración.
Desde la versión 2.3.0, Apache Spark cuenta con soporte oficial para ejecutar tareas en clústeres de Kubernetes y hoy hablaremos sobre la madurez actual de este enfoque, las diversas formas de utilizarlo y los desafíos que se presentarán al implementarlo.
Primero, examinaremos el proceso de desarrollo de tareas y aplicaciones basadas en Apache Spark y destacaremos los casos típicos en los que es necesario ejecutar una tarea en un clúster de Kubernetes. Para la preparación de este post, se utiliza OpenShift como distribución y se proporcionarán los comandos relevantes para su herramienta de línea de comandos (oc). Para otras distribuciones de Kubernetes, se pueden usar los comandos correspondientes de la herramienta de línea de comandos estándar de Kubernetes (kubectl) o sus análogos (por ejemplo, para oc adm policy).
La primera opción de uso: spark-submit
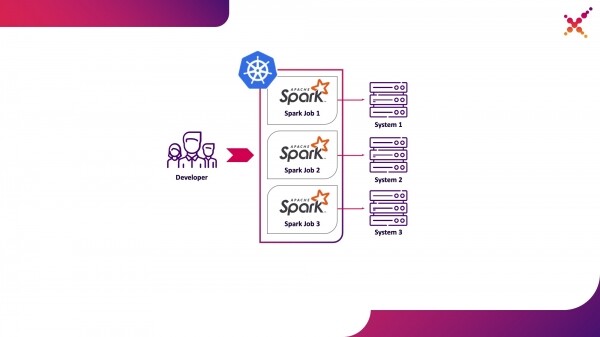
Durante el desarrollo de tareas y aplicaciones, el desarrollador necesita ejecutar tareas para depurar la transformación de datos. Teóricamente, se pueden usar simulaciones para estos fines, pero el desarrollo con instancias reales (aunque sea de prueba) de sistemas finales ha demostrado ser más rápido y de mayor calidad en este tipo de tareas. En los casos en los que estamos depurando con instancias reales de sistemas finales, se pueden dar dos escenarios de trabajo:
- el desarrollador ejecuta la tarea Spark localmente en modo standalone;

- el desarrollador ejecuta la tarea Spark en un clúster de Kubernetes en un entorno de prueba.
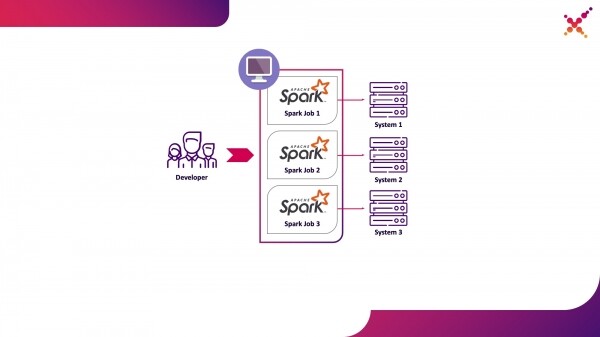
La primera opción tiene derecho a existir, pero conlleva una serie de desventajas:
- cada desarrollador necesita asegurarse de tener acceso desde su lugar de trabajo a todas las instancias necesarias de los sistemas finales;
- la máquina de trabajo requiere una cantidad suficiente de recursos para ejecutar la tarea en desarrollo.
La segunda opción carece de estas desventajas, ya que el uso de un clúster de Kubernetes permite asignar el grupo de recursos necesario para ejecutar tareas y garantizar el acceso necesario a las instancias de los sistemas finales, proporcionando acceso flexible mediante el modelo de roles de Kubernetes a todos los miembros del equipo de desarrollo. Destacaremos esto como la primera opción de uso: ejecutar tareas Spark desde la máquina local del desarrollador en un clúster de Kubernetes en un entorno de prueba.
Hablemos en detalle sobre el proceso de configuración de Spark para ejecución local. Para comenzar a usar Spark, es necesario instalarlo:
mkdir /opt/spark
cd /opt/spark
wget http://mirror.linux-ia64.org/apache/spark/spark-2.4.5/spark-2.4.5.tgz
tar zxvf spark-2.4.5.tgz
rm -f spark-2.4.5.tgz
Reunimos los paquetes necesarios para trabajar con Kubernetes:
cd spark-2.4.5/
./build/mvn -Pkubernetes -DskipTests clean package
La compilación completa lleva mucho tiempo, y para crear imágenes Docker y ejecutarlas en un clúster Kubernetes, en realidad solo se necesitan los archivos jar del directorio «assembly/», por lo que se puede compilar solo este subproyecto:
./build/mvn -f ./assembly/pom.xml -Pkubernetes -DskipTests clean package
Para ejecutar tareas Spark en Kubernetes es necesario crear una imagen Docker que se utilizará como base. Aquí hay 2 enfoques posibles:
- La imagen Docker creada incluye el código ejecutable de la tarea Spark;
- La imagen creada incluye solo Spark y las dependencias necesarias, el código ejecutable se ubica de forma remota (por ejemplo, en HDFS).
Primero, crearemos una imagen Docker que contenga un ejemplo de prueba de una tarea Spark. Para crear imágenes Docker, Spark tiene una utilidad correspondiente llamada «docker-image-tool». Revisemos la ayuda de esta herramienta:
./bin/docker-image-tool.sh --help
Con ella, se pueden crear imágenes Docker y cargarlas en registros remotos, pero por defecto tiene varias desventajas:
- obligatoriamente crea 3 imágenes Docker — para Spark, PySpark y R;
- no permite especificar el nombre de la imagen.
Por lo tanto, utilizaremos una versión modificada de esta herramienta, que se muestra a continuación:
vi bin/docker-image-tool-upd.sh
#!/usr/bin/env bash

function error {
  echo "$@" 1>&2
  exit 1
}

if [ -z "${SPARK_HOME}" ]; then
  SPARK_HOME="$(cd "`dirname "$0"`"/..; pwd)"
fi
. "${SPARK_HOME}/bin/load-spark-env.sh"

function image_ref {
  local image="$1"
  local add_repo="${2:-1}"
  if [ $add_repo = 1 ] && [ -n "$REPO" ]; then
    image="$REPO/$image"
  fi
  if [ -n "$TAG" ]; then
    image="$image:$TAG"
  fi
  echo "$image"
}

function build {
  local BUILD_ARGS
  local IMG_PATH

  if [ ! -f "$SPARK_HOME/RELEASE" ]; then
    IMG_PATH=$BASEDOCKERFILE
    BUILD_ARGS=(
      ${BUILD_PARAMS}
      --build-arg
      img_path=$IMG_PATH
      --build-arg
      datagram_jars=datagram/runtimelibs
      --build-arg
      spark_jars=assembly/target/scala-$SPARK_SCALA_VERSION/jars
    )
  else
    IMG_PATH="kubernetes/dockerfiles"
    BUILD_ARGS=(${BUILD_PARAMS})
  fi

  if [ -z "$IMG_PATH" ]; then
    error "Cannot find docker image. This script must be run from a runnable distribution of Apache Spark."
  fi

  if [ -z "$IMAGE_REF" ]; then
    error "Cannot find docker image reference. Please add -i arg."
  fi

  local BINDING_BUILD_ARGS=(
    ${BUILD_PARAMS}
    --build-arg
    base_img=$(image_ref $IMAGE_REF)
  )
  local BASEDOCKERFILE=${BASEDOCKERFILE:-"$IMG_PATH/spark/docker/Dockerfile"}

  docker build $NOCACHEARG "${BUILD_ARGS[@]}"
    -t $(image_ref $IMAGE_REF)
    -f "$BASEDOCKERFILE" .
}

function push {
  docker push "$(image_ref $IMAGE_REF)"
}

function usage {
  cat <<EOF
Usage: $0 [options] [command]
Builds or pushes the built-in Spark Docker image.

Commands:
  build       Build image. Requires a repository address to be provided if the image will be
              pushed to a different registry.
  push        Push a pre-built image to a registry. Requires a repository address to be provided.

Options:
  -f file               Dockerfile to build for JVM based Jobs. By default builds the Dockerfile shipped with Spark.
  -p file               Dockerfile to build for PySpark Jobs. Builds Python dependencies and ships with Spark.
  -R file               Dockerfile to build for SparkR Jobs. Builds R dependencies and ships with Spark.
  -r repo               Repository address.
  -i name               Image name to apply to the built image, or to identify the image to be pushed.
  -t tag                Tag to apply to the built image, or to identify the image to be pushed.
  -m                    Use minikube's Docker daemon.
  -n                    Build docker image with --no-cache
  -b arg      Build arg to build or push the image. For multiple build args, this option needs to
              be used separately for each build arg.

Using minikube when building images will do so directly into minikube's Docker daemon.
There is no need to push the images into minikube in that case, they'll be automatically
available when running applications inside the minikube cluster.

Check the following documentation for more information on using the minikube Docker daemon:

  https://kubernetes.io/docs/getting-started-guides/minikube/#reusing-the-docker-daemon

Examples:
  - Build image in minikube with tag "testing"
    $0 -m -t testing build

  - Build and push image with tag "v2.3.0" to docker.io/myrepo
    $0 -r docker.io/myrepo -t v2.3.0 build
    $0 -r docker.io/myrepo -t v2.3.0 push
EOF
}

if [[ "$@" = *--help ]] || [[ "$@" = *-h ]]; then
  usage
  exit 0
fi

REPO=
TAG=
BASEDOCKERFILE=
NOCACHEARG=
BUILD_PARAMS=
IMAGE_REF=
while getopts f:mr:t:nb:i: option
do
 case "${option}"
 in
 f) BASEDOCKERFILE=${OPTARG};;
 r) REPO=${OPTARG};;
 t) TAG=${OPTARG};;
 n) NOCACHEARG="--no-cache";;
 i) IMAGE_REF=${OPTARG};;
 b) BUILD_PARAMS=${BUILD_PARAMS}" --build-arg "${OPTARG};;
 esac
done

case "${@: -1}" in
  build)
    build
    ;;
  push)
    if [ -z "$REPO" ]; then
      usage
      exit 1
    fi
    push
    ;;
  *)
    usage
    exit 1
    ;;
esac
Con ella, generamos la imagen base de Spark, que contiene una tarea de prueba para calcular el número Pi usando Spark (aquí {docker-registry-url} — es la URL de su registro de imágenes Docker, {repo} — es el nombre del repositorio dentro del registro, que coincide con el proyecto en OpenShift, {image-name} — es el nombre de la imagen (si se utiliza una división de imágenes de tres niveles, por ejemplo, como en el registro de imágenes integrado de Red Hat OpenShift), {tag} — es la etiqueta de esta versión de la imagen):
./bin/docker-image-tool-upd.sh -f resource-managers/kubernetes/docker/src/main/dockerfiles/spark/Dockerfile -r {docker-registry-url}/{repo} -i {image-name} -t {tag} build
Iniciamos sesión en el clúster OKD utilizando la herramienta de consola (aquí {OKD-API-URL} — es la URL de la API del clúster OKD):
oc login {OKD-API-URL}
Obtenemos el token del usuario actual para la autenticación en Docker Registry:
oc whoami -t
Iniciamos sesión en el Docker Registry interno del clúster OKD (utilizamos el token obtenido mediante el comando anterior como contraseña):
docker login {docker-registry-url}
Cargamos la imagen Docker compilada en Docker Registry OKD:
./bin/docker-image-tool-upd.sh -r {docker-registry-url}/{repo} -i {image-name} -t {tag} push
Verifiquemos que la imagen recopilada esté disponible en OKD. Para ello, abramos en el navegador la URL de la lista de imágenes del proyecto correspondiente (aquí {project} es el nombre del proyecto dentro del clúster de OpenShift, {OKD-WEBUI-URL} es la URL de la consola web de OpenShift) — https://{OKD-WEBUI-URL}/console/project/{project}/browse/images/{image-name}.
Para ejecutar tareas, debe crearse una cuenta de servicio con privilegios para iniciar pods como root (discutiremos este tema más adelante):
oc create sa spark -n {project}
oc adm policy add-scc-to-user anyuid -z spark -n {project}
Ejecutaremos el comando spark-submit para publicar una tarea Spark en el clúster de OKD, especificando la cuenta de servicio creada y la imagen de Docker:
/opt/spark/bin/spark-submit --name spark-test --class org.apache.spark.examples.SparkPi --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} local:///opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar
Aquí:
—name — el nombre de la tarea que participará en la formación del nombre de los pods de Kubernetes;
—class — la clase del archivo ejecutable que se invoca al iniciar la tarea;
—conf — parámetros de configuración de Spark;
spark.executor.instances — el número de ejecutores de Spark que se van a iniciar;
spark.kubernetes.authenticate.driver.serviceAccountName — el nombre de la cuenta de servicio de Kubernetes utilizada al iniciar pods (para determinar el contexto de seguridad y capacidades al interactuar con la API de Kubernetes);
spark.kubernetes.namespace — el espacio de nombres de Kubernetes en el que se ejecutarán los pods del controlador y de los ejecutores;
spark.submit.deployMode — el modo de despliegue de Spark (para el spark-submit estándar se utiliza "cluster", para el Spark Operator y versiones posteriores de Spark se usa "client");
spark.kubernetes.container.image — la imagen de Docker utilizada para ejecutar los pods;
spark.master — URL de la API de Kubernetes (se indica la externa, ya que la conexión se realiza desde la máquina local);
local:// — la ruta al archivo ejecutable de Spark dentro de la imagen de Docker.
Vamos al proyecto correspondiente en OKD y revisamos los pods creados — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods.
Para simplificar el proceso de desarrollo, se puede usar otra opción en la que se crea una imagen base común de Spark, utilizada por todas las tareas para ejecutar, y los snapshots de los archivos ejecutables se publican en un almacenamiento externo (por ejemplo, Hadoop) y se indican al llamar a spark-submit como un enlace. En este caso, se pueden ejecutar diferentes versiones de tareas Spark sin reconstruir imágenes de Docker, usando, por ejemplo, WebHDFS para publicar las imágenes. Enviamos una solicitud para crear un archivo (aquí {host} es el host del servicio WebHDFS, {port} es el puerto del servicio WebHDFS, {path-to-file-on-hdfs} es la ruta deseada del archivo en HDFS):
curl -i -X PUT "http://{host}:{port}/webhdfs/v1/{path-to-file-on-hdfs}?op=CREATE"
Se obtendrá una respuesta del tipo (aquí {location} es la URL que debe usarse para cargar el archivo):
HTTP/1.1 307 TEMPORARY_REDIRECT
Location: {location}
Content-Length: 0
Cargando el archivo ejecutable de Spark en HDFS (aquí {path-to-local-file} es la ruta al archivo ejecutable de Spark en el host actual):
curl -i -X PUT -T {path-to-local-file} "{location}"
Después de esto, podemos ejecutar spark-submit utilizando el archivo de Spark que se ha cargado en HDFS (aquí {class-name} es el nombre de la clase que se requiere ejecutar para realizar la tarea):
/opt/spark/bin/spark-submit --name spark-test --class {class-name} --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} hdfs://{host}:{port}/{path-to-file-on-hdfs}
Es importante mencionar que para acceder a HDFS y asegurar el funcionamiento de la tarea, puede ser necesario modificar el Dockerfile y el script entrypoint.sh: agregar en el Dockerfile una directiva para copiar las bibliotecas dependientes al directorio /opt/spark/jars e incluir el archivo de configuración de HDFS en SPARK_CLASSPATH en entrypoint.sh.
La segunda opción de uso es Apache Livy
A continuación, cuando la tarea está desarrollada y es necesario probar el resultado obtenido, surge la cuestión de su ejecución dentro del proceso CI/CD y el seguimiento de los estados de su ejecución. Por supuesto, se puede ejecutar localmente usando spark-submit, pero esto complica la infraestructura CI/CD ya que requiere la instalación y configuración de Spark en los agentes/corrunners del servidor CI y la configuración de acceso a la API de Kubernetes. Para este caso, se ha elegido implementar Apache Livy como API REST para ejecutar tareas de Spark, alojado dentro del clúster de Kubernetes. Con esto, se pueden ejecutar tareas de Spark en el clúster de Kubernetes utilizando solicitudes cURL comunes, lo cual es fácilmente realizable en cualquier solución de CI, y su colocación dentro del clúster de Kubernetes resuelve el problema de autenticación al interactuar con la API de Kubernetes.
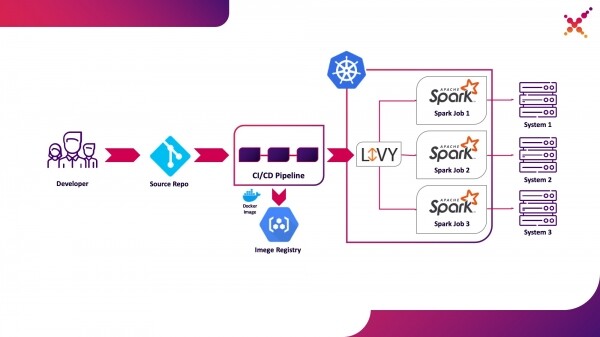
Destacamos esto como la segunda opción de uso: ejecutar tareas de Spark dentro del proceso CI/CD en el clúster de Kubernetes en un entorno de prueba.
Un poco sobre Apache Livy: funciona como un servidor HTTP, que proporciona una interfaz web y una API RESTful, permitiendo ejecutar spark-submit de forma remota, pasando los parámetros necesarios. Tradicionalmente, se suministraba como parte de la distribución HDP, pero también puede desplegarse en OKD o cualquier otra instalación de Kubernetes utilizando el manifiesto correspondiente y un conjunto de imágenes Docker, por ejemplo, este — . Para nuestro caso se construyó una imagen Docker similar, que incluye Spark versión 2.4.5 del siguiente Dockerfile:
DE java:8-alpine

ENV SPARK_HOME=\/opt\/spark
ENV LIVY_HOME=\/opt\/livy
ENV HADOOP_CONF_DIR=\/etc\/hadoop\/conf
ENV SPARK_USER=spark

WORKDIR \/opt

RUN apk add --update openssl wget bash &&
    wget -P \/opt https:\/\/downloads.apache.org\/spark\/spark-2.4.5\/spark-2.4.5-bin-hadoop2.7.tgz &&
    tar xvzf spark-2.4.5-bin-hadoop2.7.tgz &&
    rm spark-2.4.5-bin-hadoop2.7.tgz &&
    ln -s \/opt\/spark-2.4.5-bin-hadoop2.7 \/opt\/spark

RUN wget http:\/\/mirror.its.dal.ca\/apache\/incubator\/livy\/0.7.0-incubating\/apache-livy-0.7.0-incubating-bin.zip &&
    unzip apache-livy-0.7.0-incubating-bin.zip &&
    rm apache-livy-0.7.0-incubating-bin.zip &&
    ln -s \/opt\/apache-livy-0.7.0-incubating-bin \/opt\/livy &&
    mkdir \/var\/log\/livy &&
    ln -s \/var\/log\/livy \/opt\/livy\/logs &&
    cp \/opt\/livy\/conf\/log4j.properties.template \/opt\/livy\/conf\/log4j.properties

ADD livy.conf \/opt\/livy\/conf
ADD spark-defaults.conf \/opt\/spark\/conf\/spark-defaults.conf
ADD entrypoint.sh \/entrypoint.sh

ENV PATH="\/opt\/livy\/bin:${PATH}"

EXPOSE 8998

ENTRYPOINT ["\/entrypoint.sh"]
CMD ["livy-server"]
La imagen creada puede ser construida y cargada en su repositorio Docker existente, por ejemplo, el repositorio interno de OKD. Para su despliegue se utiliza el siguiente manifiesto ({registry-url} — URL del registro de imágenes Docker, {image-name} — nombre de la imagen Docker, {tag} — etiqueta de la imagen Docker, {livy-url} — URL deseada donde estará disponible el servidor Livy; el manifiesto "Route" se utiliza en caso de que se use Red Hat OpenShift como distribución de Kubernetes, de lo contrario se utiliza el manifiesto correspondiente de Ingress o Service de tipo NodePort):
---
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    component: livy
  name: livy
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      component: livy
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        component: livy
    spec:
      containers:
        - command:
            - livy-server
          env:
            - name: K8S_API_HOST
              value: localhost
            - name: SPARK_KUBERNETES_IMAGE
              value: 'gnut3ll4/spark:v1.0.14'
          image: '{registry-url}/{image-name}:{tag}'
          imagePullPolicy: Always
          name: livy
          ports:
            - containerPort: 8998
              name: livy-rest
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
          volumeMounts:
            - mountPath: /var/log/livy
              name: livy-log
            - mountPath: /opt/.livy-sessions/
              name: livy-sessions
            - mountPath: /opt/livy/conf/livy.conf
              name: livy-config
              subPath: livy.conf
            - mountPath: /opt/spark/conf/spark-defaults.conf
              name: spark-config
              subPath: spark-defaults.conf
        - command:
            - /usr/local/bin/kubectl
            - proxy
            - '--port'
            - '8443'
          image: 'gnut3ll4/kubectl-sidecar:latest'
          imagePullPolicy: Always
          name: kubectl
          ports:
            - containerPort: 8443
              name: k8s-api
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      serviceAccount: spark
      serviceAccountName: spark
      terminationGracePeriodSeconds: 30
      volumes:
        - emptyDir: {}
          name: livy-log
        - emptyDir: {}
          name: livy-sessions
        - configMap:
            defaultMode: 420
            items:
              - key: livy.conf
                path: livy.conf
            name: livy-config
          name: livy-config
        - configMap:
            defaultMode: 420
            items:
              - key: spark-defaults.conf
                path: spark-defaults.conf
            name: livy-config
          name: spark-config
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: livy-config
data:
  livy.conf: |-
    livy.spark.deploy-mode=cluster
    livy.file.local-dir-whitelist=/opt/.livy-sessions/
    livy.spark.master=k8s://http://localhost:8443
    livy.server.session.state-retain.sec = 8h
  spark-defaults.conf: 'spark.kubernetes.container.image        "gnut3ll4/spark:v1.0.14"'
---
apiVersion: v1
kind: Service
metadata:
  labels:
    app: livy
  name: livy
spec:
  ports:
    - name: livy-rest
      port: 8998
      protocol: TCP
      targetPort: 8998
  selector:
    component: livy
  sessionAffinity: None
  type: ClusterIP
---
apiVersion: route.openshift.io/v1
kind: Route
metadata:
  labels:
    app: livy
  name: livy
spec:
  host: {livy-url}
  port:
    targetPort: livy-rest
  to:
    kind: Service
    name: livy
    weight: 100
  wildcardPolicy: None
Después de su aplicación y el inicio exitoso del pod, la interfaz gráfica de Livy está disponible en el enlace: http://{livy-url}/ui. Con Livy, podemos publicar nuestra tarea Spark utilizando una solicitud REST, por ejemplo, desde Postman. A continuación se presenta un ejemplo de colección con solicitudes (en el array 'args' se pueden enviar argumentos de configuración con variables necesarias para la ejecución de la tarea lanzada):
{
    "info": {
        "_postman_id": "be135198-d2ff-47b6-a33e-0d27b9dba4c8",
        "name": "Spark Livy",
        "schema": "https://schema.getpostman.com/json/collection/v2.1.0/collection.json"
    },
    "item": [
        {
            "name": "1 Enviar trabajo con jar",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"local:////opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar\", nt\"className\": \"org.apache.spark.examples.SparkPi\",nt\"numExecutors\":1,nt\"name\": \"spark-test-1\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt}n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        },
        {
            "name": "2 Enviar trabajo sin jar",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"hdfs://{host}:{port}/{path-to-file-on-hdfs}\", nt\"className\": \"{class-name}\",nt\"numExecutors\":1,nt\"name\": \"spark-test-2\",nt\"proxyUser\": \"0\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt},nt\"args\": [ntt\"HADOOP_CONF_DIR=/opt/spark/hadoop-conf\",ntt\"MASTER=k8s://https://kubernetes.default.svc:8443\"nt]n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        }
    ],
    "event": [
        {
            "listen": "prerequest",
            "script": {
                "id": "41bea1d0-278c-40c9-ad42-bf2e6268897d",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        },
        {
            "listen": "test",
            "script": {
                "id": "3cdd7736-a885-4a2d-9668-bd75798f4560",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        }
    ],
    "protocolProfileBehavior": {}
}
Realizaremos la primera solicitud de la colección, iremos a la interfaz de OKD y verificaremos que la tarea se haya iniciado correctamente — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods. Mientras tanto, en la interfaz de Livy (http://{livy-url}/ui) aparecerá una sesión, dentro de la cual se puede rastrear el progreso de la tarea utilizando la API de Livy o la interfaz gráfica y revisar los registros de la sesión.
Ahora mostraremos el mecanismo de funcionamiento de Livy. Para ello, estudiaremos los registros del contenedor de Livy dentro del pod con el servidor de Livy — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods/{livy-pod-name}?tab=logs. De ellos se puede ver que al invocar la API REST de Livy en el contenedor llamado "livy", se ejecuta spark-submit, similar al que usamos anteriormente (aquí {livy-pod-name} es el nombre del pod creado con el servidor de Livy). La colección también presenta una segunda solicitud que permite ejecutar tareas con la ubicación remota del archivo ejecutable de Spark a través del servidor de Livy.
La tercera opción de uso es el Spark Operator.
Ahora que la tarea ha sido probada, surge la pregunta de su ejecución regular. La forma nativa para ejecutar tareas de manera regular en un clúster de Kubernetes es a través de la entidad CronJob y se puede utilizar, pero en este momento se ha vuelto más popular el uso de operadores para gestionar aplicaciones en Kubernetes, y para Spark existe un operador bastante maduro que se utiliza en soluciones de nivel empresarial (por ejemplo, Lightbend FastData Platform). Recomendamos utilizarlo: la versión estable actual de Spark (2.4.5) tiene capacidades bastante limitadas para la configuración de la ejecución de tareas de Spark en Kubernetes, mientras que en la próxima versión importante (3.0.0) se promete soporte completo para Kubernetes, aunque la fecha de lanzamiento sigue siendo desconocida. Spark Operator compensa esta limitación al agregar parámetros importantes de configuración (por ejemplo, el montaje de ConfigMap con la configuración de acceso a Hadoop en los pods de Spark) y la posibilidad de ejecutar regularmente tareas según un horario.
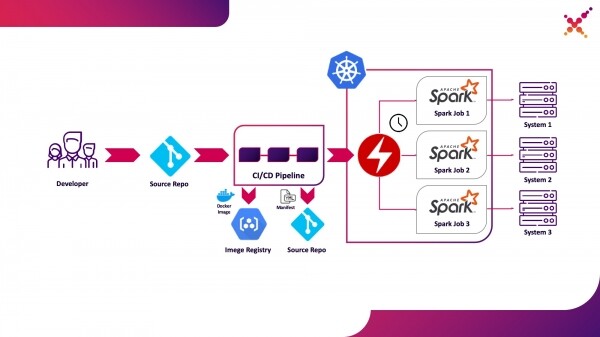
Lo destacaremos como la tercera opción de uso: ejecución regular de tareas de Spark en el clúster de Kubernetes en un entorno de producción.
El Spark Operator tiene código abierto y se desarrolla en el marco de Google Cloud Platform — . Su instalación puede llevarse a cabo de 3 maneras:
- Como parte de la instalación de Lightbend FastData Platform/Cloudflow;
- Usando Helm:
helm repo add incubator http://storage.googleapis.com/kubernetes-charts-incubator helm install incubator/sparkoperator --namespace spark-operator - La implementación de manifiestos desde el repositorio oficial (https://github.com/GoogleCloudPlatform/spark-on-k8s-operator/tree/master/manifest). Cabe señalar lo siguiente: Cloudflow incluye un operador con la versión de API v1beta1. Si se utiliza este tipo de instalación, las descripciones de los manifiestos de aplicaciones Spark deben basarse en ejemplos de etiquetas en Git con la versión de API correspondiente, por ejemplo, "v1beta1-0.9.0-2.4.0". La versión del operador se puede consultar en la descripción del CRD incluido en el operador en el diccionario "versions":
oc get crd sparkapplications.sparkoperator.k8s.io -o yaml
Si el operador está instalado correctamente, aparecerá un pod activo con el operador Spark en el proyecto correspondiente (por ejemplo, cloudflow-fdp-sparkoperator en el espacio Cloudflow para la instalación de Cloudflow) y aparecerá el tipo correspondiente de recursos de Kubernetes con el nombre "sparkapplications". Se puede estudiar las aplicaciones Spark existentes con el siguiente comando:
oc get sparkapplications -n {project}
Para ejecutar tareas utilizando el Spark Operator, se deben realizar 3 cosas:
- crear una imagen Docker que incluya todas las bibliotecas necesarias, así como archivos de configuración y ejecutables. En el contexto objetivo, esta imagen se crea durante la etapa de CI/CD y se prueba en un clúster de prueba;
- publicar la imagen Docker en un registro accesible desde el clúster de Kubernetes;
- formular un manifiesto con el tipo "SparkApplication" y la descripción de la tarea que se va a ejecutar. Se pueden encontrar ejemplos de manifiestos en el repositorio oficial (por ejemplo, ). Es importante destacar los aspectos clave relacionados con el manifiesto:
- en el diccionario "apiVersion" debe indicarse la versión de la API correspondiente a la versión del operador;
- en el diccionario "metadata.namespace" debe indicarse el espacio de nombres en el que se ejecutará la aplicación;
- en el diccionario "spec.image" debe indicarse la dirección de la imagen Docker creada en el registro accesible;
- en el diccionario "spec.mainClass" debe indicarse la clase de tarea Spark que se requiere ejecutar al iniciar el proceso;
- en el diccionario "spec.mainApplicationFile" debe indicarse la ruta al archivo jar ejecutable;
- en el diccionario "spec.sparkVersion" debe indicarse la versión de Spark utilizada;
- en el diccionario "spec.driver.serviceAccount" debe indicarse la cuenta de servicio dentro del espacio de nombres Kubernetes correspondiente que se utilizará para ejecutar la aplicación;
- en el diccionario "spec.executor" debe indicarse la cantidad de recursos asignados a la aplicación;
- En el diccionario «spec.volumeMounts» debe especificarse el directorio local donde se crearán los archivos locales de la tarea Spark.
Ejemplo de creación de un manifiesto (aquí {spark-service-account} es la cuenta de servicio dentro del clúster de Kubernetes para ejecutar tareas Spark):
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 0.1
    coreLimit: "200m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: {spark-service-account}
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
En este manifiesto se especifica la cuenta de servicio para la cual es necesario crear los enlaces de roles requeridos antes de publicar el manifiesto, otorgando los permisos necesarios para que la aplicación Spark interactúe con la API de Kubernetes (si es necesario). En nuestro caso, la aplicación necesita permisos para crear Pods. Crearemos el enlace de rol necesario:
oc adm policy add-role-to-user edit system:serviceaccount:{project}:{spark-service-account} -n {project}
También cabe señalar que en la especificación de este manifiesto puede incluirse el parámetro «hadoopConfigMap», que permite especificar un ConfigMap con la configuración de Hadoop sin necesidad de colocar previamente el archivo correspondiente en la imagen de Docker. También es adecuado para la ejecución programada de tareas: mediante el parámetro «schedule» se puede establecer un horario para la ejecución de esta tarea.
Después de eso, guardamos nuestro manifiesto en el archivo spark-pi.yaml y lo aplicamos a nuestro clúster de Kubernetes:
oc apply -f spark-pi.yaml
Esto creará un objeto del tipo «sparkapplications»:
oc get sparkapplications -n {project}
> NAME       AGE
> spark-pi   22h
Se creará un pod con la aplicación, cuyo estado se mostrará en el «sparkapplications» creado. Se puede consultar con el siguiente comando:
oc get sparkapplications spark-pi -o yaml -n {project}
Al finalizar la tarea, el POD cambiará a estado «Completed», que también se actualizará en el «sparkapplications». Los registros de la aplicación se pueden consultar en el navegador o usando el siguiente comando (aquí {sparkapplications-pod-name} es el nombre del pod de la tarea en ejecución):
oc logs {sparkapplications-pod-name} -n {project}
La gestión de tareas de Spark también se puede realizar mediante la utilidad especializada sparkctl. Para su instalación, clonamos el repositorio con su código fuente, instalamos Go y compilamos esta utilidad:
git clone https://github.com/GoogleCloudPlatform/spark-on-k8s-operator.git
cd spark-on-k8s-operator/
wget https://dl.google.com/go/go1.13.3.linux-amd64.tar.gz
tar -xzf go1.13.3.linux-amd64.tar.gz
sudo mv go /usr/local
mkdir $HOME/Projects
export GOROOT=/usr/local/go
export GOPATH=$HOME/Projects
export PATH=$GOPATH/bin:$GOROOT/bin:$PATH
go -version
cd sparkctl
go build -o sparkctl
sudo mv sparkctl /usr/local/bin
Examinemos la lista de tareas de Spark en ejecución:
sparkctl list -n {project}
Creamos una descripción para la tarea de Spark:
vi spark-app.yaml
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 1
    coreLimit: "1000m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: spark
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
Ejecutemos la tarea descrita utilizando sparkctl:
sparkctl create spark-app.yaml -n {project}
Examinemos la lista de tareas de Spark en ejecución:
sparkctl list -n {project}
Revisemos la lista de eventos de la tarea de Spark en ejecución:
sparkctl event spark-pi -n {project} -f
Verifiquemos el estado de la tarea de Spark en ejecución:
sparkctl status spark-pi -n {project}
En conclusión, nos gustaría considerar los inconvenientes descubiertos en la explotación de la versión estable actual de Spark (2.4.5) en Kubernetes:
- La primera y, posiblemente, la mayor desventaja es la falta de Localidad de Datos. A pesar de todas las desventajas, YARN tenía algunos beneficios en su uso, como el principio de entregar el código a los datos (y no los datos al código). Gracias a ello, las tareas de Spark se ejecutaban en los nodos donde se encontraban los datos implicados en los cálculos, lo que reducía significativamente el tiempo de entrega de datos a través de la red. Al utilizar Kubernetes, nos encontramos con la necesidad de mover a través de la red los datos involucrados en el trabajo de la tarea. Si estos son lo suficientemente grandes, el tiempo de ejecución de la tarea puede aumentar considerablemente, además de requerir un volumen considerable de espacio en disco asignado a las instancias de la tarea Spark para su almacenamiento temporal. Esta desventaja se puede reducir mediante el uso de herramientas de software especializadas que garantizan la localidad de datos en Kubernetes (por ejemplo, Alluxio), pero esto significa efectivamente que es necesario almacenar una copia completa de los datos en los nodos del clúster de Kubernetes.
- La segunda desventaja importante es la seguridad. Por defecto, las funciones relacionadas con la seguridad en la ejecución de tareas Spark están desactivadas, la opción de usar Kerberos en la documentación oficial no está cubierta (aunque los parámetros correspondientes aparecieron en la versión 3.0.0, lo que requerirá un trabajo adicional), y en la documentación sobre seguridad al utilizar Spark (https://spark.apache.org/docs/2.4.5/security.html) solo se mencionan YARN, Mesos y Standalone Cluster como almacenes de claves. Además, el usuario bajo el cual se ejecutan las tareas de Spark no puede ser especificado directamente; solo podemos establecer una cuenta de servicio bajo la cual funcionará el pod, y el usuario se elige según las políticas de seguridad configuradas. Debido a esto, o se utiliza el usuario root, lo cual no es seguro en un entorno de producción, o un usuario con un UID aleatorio, lo que resulta incómodo para la distribución de permisos de acceso a los datos (esto se puede resolver creando PodSecurityPolicies y vinculándolas a las cuentas de servicio correspondientes). Actualmente, se aborda ya sea incluyendo todos los archivos necesarios directamente en la imagen de Docker, o modificando el script de inicio de Spark para utilizar el mecanismo de almacenamiento y recuperación de secretos adoptado en su organización.
- El lanzamiento de tareas de Spark utilizando Kubernetes sigue estando oficialmente en modo experimental, y en el futuro podrían haber cambios significativos en los artefactos utilizados (archivos de configuración, imágenes base de Docker y scripts de inicio). De hecho, al preparar el material se probaron las versiones 2.3.0 y 2.4.5, y el comportamiento fue bastante diferente.
Estaremos atentos a las actualizaciones: recientemente se lanzó una nueva versión de Spark (3.0.0), que trajo cambios significativos en el funcionamiento de Spark en Kubernetes, aunque manteniendo el estatus experimental de soporte de este gestor de recursos. Es posible que las próximas actualizaciones realmente permitan recomendar plenamente abandonar YARN y ejecutar tareas de Spark en Kubernetes, sin temer por la seguridad de su sistema y sin necesidad de realizar modificaciones manuales en los componentes funcionales.
Fin.
Fuente: habr.com
