

En este estudio, quise investigar qué mejoras de rendimiento se pueden obtener al usar ClickHouse como fuente de datos en lugar de PostgreSQL. Sé cuáles son las ventajas de rendimiento al utilizar ClickHouse. ¿Se mantendrán estas ventajas si accedo a ClickHouse desde PostgreSQL a través de un wrapper de datos externo (FDW)?
Los entornos de bases de datos en estudio son PostgreSQL v11, clickhousedb_fdw y la base de datos ClickHouse. En última instancia, desde PostgreSQL v11 ejecutaremos varias consultas SQL, enrutadas a través de nuestro clickhousedb_fdw a la base de datos ClickHouse. Luego veremos cómo se compara el rendimiento de FDW con las mismas consultas ejecutadas en PostgreSQL nativo y ClickHouse nativo.
Base de datos Clickhouse
ClickHouse es un sistema de gestión de bases de datos orientado a columnas de código abierto que puede alcanzar un rendimiento de 100 a 1000 veces más rápido que los enfoques tradicionales de bases de datos, capaz de procesar más de mil millones de filas en menos de un segundo.
Clickhousedb_fdw
clickhousedb_fdw es un wrapper de datos externos para la base de datos ClickHouse, o FDW, es un proyecto de código abierto de Percona. .
.
Como verás, esto proporciona un FDW para ClickHouse que permite SELECT from e INSERT INTO la base de datos ClickHouse desde un servidor PostgreSQL v11.
FDW admite funciones avanzadas como agregados y uniones. Esto aumenta significativamente el rendimiento al utilizar los recursos del servidor remoto para estas operaciones que consumen muchos recursos.
Entorno de referencia
- Servidor Supermicro:
- Intel® Xeon® CPU E5-2683 v3 @ 2.00GHz
- 2 sockets / 28 cores / 56 threads
- Memoria: 256GB de RAM
- Almacenamiento: Samsung SM863 1.9TB Enterprise SSD
- Sistema de archivos: ext4/xfs
- OS: Linux smblade01 4.15.0-42-generic #45~16.04.1-Ubuntu
- PostgreSQL: versión 11
Pruebas de referencia
En lugar de utilizar algún conjunto de datos generado por máquina para esta prueba, utilizamos los datos de 'Rendimiento en el tiempo, reportando el tiempo de actividad del operador' de 1987 a 2018. Puedes acceder a los datos .
El tamaño de la base de datos es de 85 GB, proporcionando una tabla de 109 columnas.
Consultas de referencia
Aquí están las consultas que utilicé para comparar ClickHouse, clickhousedb_fdw y PostgreSQL.
Q#
La consulta contiene agregados y agrupaciones
Q1
SELECCIONAR DíaDeLaSemana, contar(*) COMO c DE ontime DONDE Año >= 2000 Y Año <= 2008 AGRUPAR POR DíaDeLaSemana ORDENAR POR c DESC;
Q2
SELECCIONAR DíaDeLaSemana, contar(*) COMO c DE ontime DONDE DepDelay > 10 Y Año >= 2000 Y Año <= 2008 AGRUPAR POR DíaDeLaSemana ORDENAR POR c DESC;
Q3
SELECCIONAR Origen, contar(*) COMO c DE ontime DONDE DepDelay > 10 Y Año >= 2000 Y Año <= 2008 AGRUPAR POR Origen ORDENAR POR c DESC LÍMITE 10;
Q4
SELECCIONAR Transportista, contar() DE ontime DONDE DepDelay > 10 Y Año = 2007 AGRUPAR POR Transportista ORDENAR POR contar() DESC;
Q5
SELECCIONAR a.Transportista, c, c2, c1000/c2 COMO c3 DE ( SELECCIONAR Transportista, contar() COMO c DE ontime DONDE DepDelay > 10 Y Año = 2007 AGRUPAR POR Transportista ) a UNIR INTERNO ( SELECCIONAR Transportista, contar(*) COMO c2 DE ontime DONDE Año = 2007 AGRUPAR POR Transportista ) b EN a.Transportista = b.Transportista ORDENAR POR c3 DESC;
Q6
SELECCIONAR a.Transportista, c, c2, c1000/c2 COMO c3 DE ( SELECCIONAR Transportista, contar() COMO c DE ontime DONDE DepDelay > 10 Y Año >= 2000 Y Año = 2000 Y Año <= 2008 AGRUPAR POR Transportista ) b EN a.Transportista = b.Transportista ORDENAR POR c3 DESC;
Q7
SELECCIONAR Transportista, prom(DepDelay) * 1000 COMO c3 DE ontime DONDE Año >= 2000 Y Año <= 2008 AGRUPAR POR Transportista;
Q8
SELECCIONAR Año, prom(DepDelay) DE ontime AGRUPAR POR Año;
Q9
seleccionar Año, contar(*) como c1 de ontime agrupar por Año;
Q10
SELECCIONAR prom(cnt) DE (SELECCIONAR Año, Mes, contar(*) COMO cnt DE ontime DONDE DepDel15 = 1 AGRUPAR POR Año, Mes) a;
Q11
seleccionar prom(c1) de (seleccionar Año, Mes, contar(*) como c1 de ontime agrupar por Año, Mes) a;
Q12
SELECCIONAR NombreCiudadOrigen, NombreCiudadDestino, contar(*) COMO c DE ontime AGRUPAR POR NombreCiudadOrigen, NombreCiudadDestino ORDENAR POR c DESC LÍMITE 10;
Q13
SELECCIONAR NombreCiudadOrigen, contar(*) COMO c DE ontime AGRUPAR POR NombreCiudadOrigen ORDENAR POR c DESC LÍMITE 10;
La consulta contiene uniones
Q14
SELECCIONAR a.Año, c1/c2 DE (seleccionar Año, contar()1000 COMO c1 DE ontime DONDE DepDelay > 10 AGRUPAR POR Año) a UNIR INTERNO (seleccionar Año, contar(*) como c2 de ontime agrupar por Año) b EN a.Año = b.Año ORDENAR POR a.Año;
Q15
SELECCIONAR a.”Año”, c1/c2 DE (seleccionar “Año”, contar()1000 COMO c1 DE fontime DONDE “DepDelay” > 10 AGRUPAR POR “Año”) a UNIR INTERNO (seleccionar “Año”, contar(*) como c2 de fontime agrupar por “Año”) b EN a.”Año” = b.”Año”;
Tabla-1: Consultas utilizadas en la evaluación comparativa
Ejecuciones de consulta
Aquí están los resultados de cada una de las consultas al ejecutarse en diferentes configuraciones de base de datos: PostgreSQL con índices y sin ellos, el ClickHouse propio y clickhousedb_fdw. El tiempo se muestra en milisegundos.
Q#
PostgreSQL
PostgreSQL (Indexed)
ClickHouse
clickhousedb_fdw
Q1
27920
19634
23
57
Q2
35124
17301
50
80
Q3
34046
15618
67
115
Q4
31632
7667
25
37
Q5
47220
8976
27
60
Q6
58233
24368
55
153
Q7
30566
13256
52
91
Q8
38309
60511
112
179
Q9
20674
37979
31
81
Q10
34990
20102
56
148
Q11
30489
51658
37
155
Q12
39357
33742
186
1333
Q13
29912
30709
101
384
Q14
54126
39913
124
1364212
Q15
97258
30211
245
259
Tabla-1: Tiempo tomado para ejecutar las consultas utilizadas en la evaluación comparativa
Ver resultados
El gráfico muestra el tiempo de ejecución de la consulta en milisegundos, el eje X muestra el número de la consulta de las tablas anteriores, y el eje Y muestra el tiempo de ejecución en milisegundos. Los resultados de ClickHouse y los datos obtenidos de postgres a través de clickhousedb_fdw se muestran. De la tabla se puede ver que hay una gran diferencia entre PostgreSQL y ClickHouse, pero una mínima diferencia entre ClickHouse y clickhousedb_fdw.
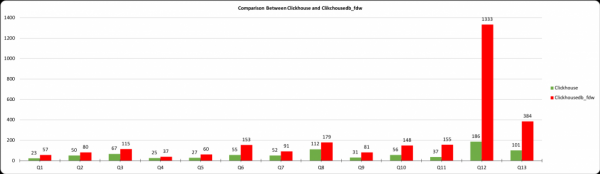
Este gráfico muestra la diferencia entre ClickhouseDB y clickhousedb_fdw. En la mayoría de las consultas, los costos de FDW no son tan altos y apenas son significativos, excepto en Q12. Esta consulta incluye uniones y una cláusula ORDER BY. Debido a la cláusula ORDER BY, GROUP/BY y ORDER BY no se eliminan hasta ClickHouse.
En la tabla 2, vemos un aumento en el tiempo de las consultas Q12 y Q13. Para reiterar, esto se debe a la cláusula ORDER BY. Para confirmar esto, ejecuté las consultas Q-14 y Q-15 con y sin la cláusula ORDER BY. Sin la cláusula ORDER BY, el tiempo de finalización es de 259 ms, mientras que con la cláusula ORDER BY es de 1364212. Para depurar esta consulta, explico ambas consultas y aquí se presentan los resultados de la explicación.
Q15: Sin cláusula ORDER BY
bm=# EXPLAIN VERBOSE SELECT a."Year", c1/c2
     FROM (SELECT "Year", count(*)*1000 AS c1 FROM fontime WHERE "DepDelay" > 10 GROUP BY "Year") a
     INNER JOIN(SELECT "Year", count(*) AS c2 FROM fontime GROUP BY "Year") b ON a."Year"=b."Year";
Q15: Consulta sin cláusula ORDER BY
PLAN DE CONSULTA
Unión Hash  (costo=2250.00..128516.06 filas=50000000 ancho=12)
Salida: fontime."Year", (((count(*) * 1000)) / b.c2)
Único interno: verdadero   Condición Hash: (fontime."Year" = b."Year")
->  Escaneo externo  (costo=1.00..-1.00 filas=100000 ancho=12)
Salida: fontime."Year", ((count(*) * 1000))
Relaciones: Agregado en (fontime)
SQL remoto: SELECT "Year", (count(*) * 1000) FROM "default".ontime WHERE (("DepDelay" > 10)) GROUP BY "Year"
->  Hash  (costo=999.00..999.00 filas=100000 ancho=12)
Salida: b.c2, b."Year"
->  Escaneo de subconsulta en b  (costo=1.00..999.00 filas=100000 ancho=12)
Salida: b.c2, b."Year"
->  Escaneo externo  (costo=1.00..-1.00 filas=100000 ancho=12)
Salida: fontime_1."Year", (count(*))
Relaciones: Agregado en (fontime)
SQL remoto: SELECT "Year", count(*) FROM "default".ontime GROUP BY "Year"(16 filas)
Q14: Consulta con cláusula ORDER BY
bm=# EXPLAIN VERBOSE SELECT a."Year", c1/c2 FROM(SELECT "Year", count(*)*1000 AS c1 FROM fontime WHERE "DepDelay" > 10 GROUP BY "Year") a
     INNER JOIN(SELECT "Year", count(*) as c2 FROM fontime GROUP BY "Year") b  ON a."Year"= b."Year"
     ORDER BY a."Year";
Q14: Plan de consulta con cláusula ORDER BY
PLAN DE CONSULTA
Unión por combinación  (costo=2.00..628498.02 filas=50000000 ancho=12)
Salida: fontime."Year", (((count(*) * 1000)) / (count(*)))
Único interno: verdadero   Condición de unión: (fontime."Year" = fontime_1."Year")
->  Agregado de grupo  (costo=1.00..499.01 filas=1 ancho=12)
Salida: fontime."Year", (count(*) * 1000)
Clave de grupo: fontime."Year"
->  Escaneo externo en public.fontime  (costo=1.00..-1.00 filas=100000 ancho=4)
SQL remoto: SELECT "Year" FROM "default".ontime WHERE (("DepDelay" > 10))
            ORDER BY "Year" ASC
->  Agregado de grupo  (costo=1.00..499.01 filas=1 ancho=12)
Salida: fontime_1."Year", count(*)         Clave de grupo: fontime_1."Year"
->  Escaneo externo en public.fontime fontime_1  (costo=1.00..-1.00 filas=100000 ancho=4)

SQL remoto: SELECT "Year" FROM "default".ontime ORDER BY "Year" ASC(16 filas)
Salida
Los resultados de estos experimentos muestran que ClickHouse ofrece un rendimiento realmente bueno, y clickhousedb_fdw proporciona ventajas de rendimiento de ClickHouse desde PostgreSQL. Aunque hay algunos costos adicionales al utilizar clickhousedb_fdw, estos son insignificantes y comparables al rendimiento logrado al ejecutarse directamente en la base de datos ClickHouse. Esto también confirma que fdw en PostgreSQL proporciona resultados excepcionales.
Chat de Telegram sobre ClickHouse
Chat de Telegram sobre PostgreSQL
Fuente: habr.com
