

El teorema CAP es la piedra angular de la teoría de sistemas distribuidos. Por supuesto, las disputas sobre él no cesan: las definiciones no son canónicas y no hay una prueba rigurosa... Sin embargo, firmemente basados en el sentido común™, entendemos intuitivamente que el teorema es verdadero.
Lo único que no es obvio es el significado de la letra 'P'. Cuando un clúster se divide, decide si no responder hasta que se alcance el quorum o si devolver los datos disponibles. Dependiendo de los resultados de esta elección, el sistema se clasifica como CP o AP. Cassandra, por ejemplo, puede comportarse de ambas maneras, no solo dependiendo de la configuración del clúster, sino también de los parámetros de cada solicitud específica. Pero si el sistema no es 'P' y se ha dividido, entonces, ¿qué pasa?
La respuesta a esta pregunta es algo inesperada: un clúster CA no puede dividirse.
¿Qué tipo de clúster es este que no puede dividirse?
Un atributo indispensable de tal clúster es un sistema de almacenamiento de datos común. En la gran mayoría de los casos, esto significa conexión a través de SAN, lo que limita la aplicación de soluciones CA a grandes empresas capaces de mantener infraestructura SAN. Para que varios servidores puedan trabajar con los mismos datos, se necesita un sistema de archivos en clúster. Existen tales sistemas de archivos en las carteras de HPE (CFS), Veritas (VxCFS) e IBM (GPFS).
Oracle RAC
La opción Real Application Cluster apareció por primera vez en 2001 en el lanzamiento de Oracle 9i. En tal clúster, varios instancias servidores trabajan con la misma base de datos.
Oracle puede trabajar tanto con un sistema de archivos en clúster como con su propia solución: ASM, Automatic Storage Management.
Cada instancia lleva su propio registro. La transacción se ejecuta y se registra por una instancia. En caso de fallo de una instancia, uno de los nodos sobrevivientes del clúster (instancias) lee su registro y recupera los datos perdidos; esto garantiza la disponibilidad.
Todas las instancias mantienen su propia caché, y las mismas páginas (bloques) pueden estar simultáneamente en las cachés de varias instancias. Además, si alguna página es necesaria para una instancia y está en la caché de otra, esta puede obtenerla de su 'vecino' mediante el mecanismo de cache fusion, en lugar de leerla desde el disco.
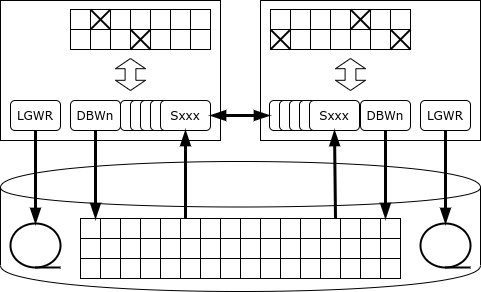
Pero, ¿qué sucede si uno de los nodos necesita modificar los datos?
La característica de Oracle es que no tiene un servicio de bloqueo dedicado: si un servidor quiere bloquear una fila, la información del bloqueo se coloca directamente en la página de memoria donde se encuentra la fila bloqueada. Gracias a este enfoque, Oracle es el campeón en rendimiento entre bases de datos monolíticas: el servicio de bloqueo nunca se convierte en un cuello de botella. Sin embargo, en una configuración en clúster, tal arquitectura puede llevar a un intercambio de red intensivo y bloqueos mutuos.
En cuanto se bloquea una fila, la instancia notifica a todas las demás instancias que la página donde se almacena esta fila está ocupada en modo exclusivo. Si otra instancia necesita modificar la fila en la misma página, debe esperar hasta que los cambios en la página sean confirmados, es decir, que la información de la modificación se haya registrado en el diario en el disco (aún así, la transacción puede continuar). También puede suceder que la página sea modificada secuencialmente por varias instancias, y entonces al escribir la página en el disco será necesario determinar quién tiene la versión actual de esa página.
Las actualizaciones aleatorias de las mismas páginas a través de diferentes nodos RAC conducen a una drástica disminución en el rendimiento de la base de datos, hasta el punto en que el rendimiento del clúster puede ser inferior al de una única instancia.
El uso correcto de Oracle RAC implica la división física de los datos (por ejemplo, mediante un mecanismo de tablas particionadas) y el acceso a cada conjunto de particiones a través de un nodo dedicado. El principal propósito de RAC no es la escalabilidad horizontal, sino garantizar la alta disponibilidad.
Si un nodo deja de responder al heartbeat, el nodo que lo detectó primero inicia un procedimiento de votación en disco. Si tampoco se registra en esta etapa el nodo perdido, uno de los nodos asume la responsabilidad de recuperar los datos:
- «congela» todas las páginas que estaban en la memoria caché del nodo perdido;
- lee los registros (redo) del nodo perdido y aplica nuevamente los cambios registrados en esos registros, verificando al mismo tiempo si otros nodos tienen versiones más recientes de las páginas modificadas.
- revierte transacciones no finalizadas.
Para simplificar el cambio entre nodos, Oracle tiene el concepto de servicio: una instancia virtual. Una instancia puede atender varios servicios, y un servicio puede trasladarse entre nodos. La instancia de aplicación que maneja una parte específica de la base de datos (por ejemplo, un grupo de clientes) trabaja con un servicio, y el servicio responsable de esa parte de la base de datos se traslada a otro nodo si un nodo falla.
IBM Pure Data Systems for Transactions
La solución de clúster para bases de datos se integró en el portafolio del Gigante Azul en 2009. Ideológicamente, es el heredero del clúster Parallel Sysplex, construido en hardware ‘convencional’. En 2009 se lanzó el producto DB2 pureScale, que es un conjunto de software, y en 2012 IBM ofrece un conjunto de hardware y software (appliance) llamado Pure Data Systems for Transactions. No debe confundirse con Pure Data Systems for Analytics, que no es más que un Netezza renombrado.
La arquitectura pureScale a primera vista se asemeja a Oracle RAC: de la misma manera, varios nodos están conectados a un sistema de almacenamiento de datos común, y en cada nodo se ejecuta su propia instancia de base de datos con sus propias áreas de memoria y registros de transacciones. Pero, a diferencia de Oracle, en DB2 hay un servicio de bloqueos dedicado, representado por un conjunto de procesos db2LLM*. En una configuración de clúster, este servicio se lleva a un nodo separado, que en Parallel Sysplex se llama coupling facility (CF), y en Pure Data – PowerHA.
PowerHA proporciona los siguientes servicios:
- gestor de bloqueos;
- cache de buffer global;
- área de comunicaciones entre procesos.
Para la transmisión de datos de PowerHA a los nodos de la base de datos y viceversa, se utiliza acceso remoto a la memoria, por lo que el interconector de clúster debe soportar el protocolo RDMA. PureScale puede utilizar tanto Infiniband como RDMA sobre Ethernet.
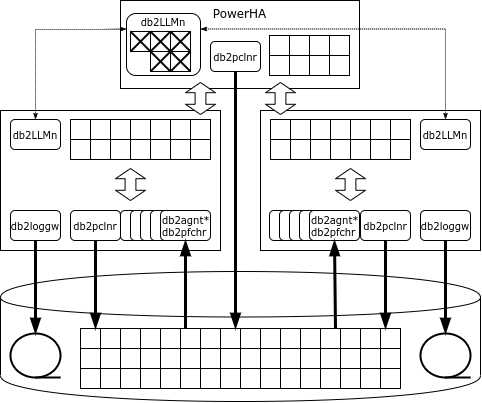
Si un nodo necesita una página y esta no está en el cache, el nodo solicita la página del cache global, y solo si no está allí, la lee del disco. A diferencia de Oracle, la solicitud solo va a PowerHA, no a nodos adyacentes.
Si una instancia va a modificar una fila, la bloquea en modo exclusivo, mientras que la página que contiene la fila se bloquea en modo compartido. Todos los bloqueos se registran en el administrador global de bloqueos. Cuando la transacción finaliza, el nodo envía un mensaje al administrador de bloqueos, que copia la página modificada en la caché global, libera los bloqueos e invalida la página modificada en las cachés de otros nodos.
Si la página que contiene la fila modificable ya está bloqueada, el administrador de bloqueos leerá la página modificada de la memoria del nodo que realizó los cambios, liberará el bloqueo, invalidará la página modificada en las cachés de otros nodos y otorgará el bloqueo de la página al nodo que lo solicitó.
Las páginas 'sucias', es decir, modificadas, pueden escribirse en el disco tanto desde un nodo normal como desde PowerHA (castout).
En caso de falla de uno de los nodos pureScale, la recuperación se limita únicamente a aquellas transacciones que en el momento del fallo aún no se habían completado: las páginas modificadas por este nodo en transacciones completadas están en la caché global en PowerHA. El nodo se reinicia en una configuración reducida en uno de los servidores del clúster, revierte las transacciones no finalizadas y libera los bloqueos.
PowerHA opera en dos servidores, y el nodo principal replica su estado de manera sincrónica. En caso de falla del nodo principal, el clúster PowerHA continúa funcionando con el nodo de respaldo.
Por supuesto, si se accede a un conjunto de datos a través de un solo nodo, el rendimiento general del clúster será mayor. PureScale incluso puede notar que cierta área de datos está siendo procesada por un nodo, y entonces todos los bloqueos relacionados con esa área se gestionarán localmente por el nodo sin comunicaciones con PowerHA. Pero tan pronto como la aplicación intente acceder a esos datos a través de otro nodo, el procesamiento centralizado de bloqueos se reanudará.
Las pruebas internas de IBM bajo una carga compuesta por un 90% de lecturas y un 10% de escrituras, lo cual se asemeja mucho a una carga industrial real, muestran una escalabilidad casi lineal hasta 128 nodos. Las condiciones de las pruebas, lamentablemente, no se divulgan.
HPE NonStop SQL
La plataforma de alta disponibilidad también está en el portafolio de Hewlett-Packard Enterprise. Se trata de la plataforma NonStop, que fue lanzada al mercado en 1976 por Tandem Computers. En 1997, la compañía fue adquirida por Compaq, que a su vez se integró a Hewlett-Packard en 2002.
NonStop se utiliza para construir aplicaciones críticas, como HLR o procesamiento de tarjetas bancarias. La plataforma se ofrece como un conjunto de hardware y software (appliance) que incluye nodos computacionales, sistema de almacenamiento de datos y equipo de comunicación. La red ServerNet (en sistemas modernos, Infiniband) sirve tanto para el intercambio entre nodos como para el acceso al sistema de almacenamiento de datos.
En las versiones tempranas del sistema se utilizaban procesadores propietarios, que estaban sincronizados entre sí: todas las operaciones se ejecutaban de manera sincrónica por varios procesadores, y tan pronto como uno de los procesadores fallaba, se apagaba, mientras que el segundo continuaba trabajando. Más tarde, el sistema cambió a procesadores estándares (primero MIPS, luego Itanium y, finalmente, x86), y se empezaron a usar otros mecanismos para la sincronización:
- mensajes: cada proceso del sistema tiene un duplicado o 'sombra', al que el proceso activo envía periódicamente mensajes sobre su estado; en caso de fallo del proceso principal, el proceso sombra comienza a trabajar desde el momento definido por el último mensaje;
- votación: el sistema de almacenamiento de datos tiene un componente hardware especial que recibe múltiples solicitudes idénticas y las ejecuta solo si las solicitudes coinciden; en lugar de sincronización física, los procesadores trabajan de manera asíncrona, y sus resultados se comparan solo en momentos de entrada/salida.
Desde 1987, en la plataforma NonStop opera un sistema de gestión de bases de datos relacional, primero SQL/MP y más tarde SQL/MX.
Toda la base de datos se divide en partes, y cada parte es gestionada por su propio proceso Data Access Manager (DAM). Este se encarga de la escritura de datos, la caché y el mecanismo de bloqueo. Los datos son procesados por los procesos ejecutores (Executor Server Process), que funcionan en los mismos nodos que los correspondientes gestores de datos. El planificador SQL/MX distribuye las tareas entre los ejecutores y combina los resultados. Para realizar cambios consistentes se utiliza el protocolo de compromiso en dos fases, asegurado por la biblioteca TMF (Transaction Management Facility).
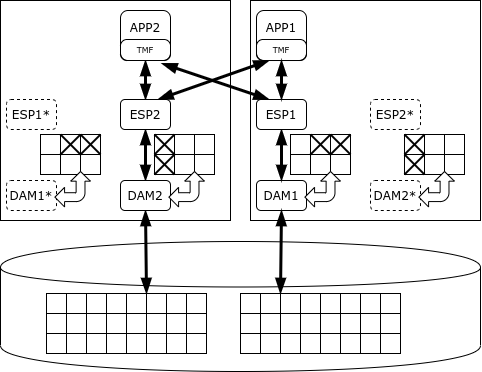
NonStop SQL puede priorizar procesos de manera que las largas consultas analíticas no interfieran con la ejecución de transacciones. Sin embargo, su propósito es precisamente el procesamiento de transacciones cortas, no la analítica. El desarrollador garantiza la disponibilidad del clúster NonStop en el nivel cinco «nueves», lo que significa que el tiempo de inactividad es solo de 5 minutos al año.
SAP HANA
El primer lanzamiento estable de la base de datos HANA (1.0) tuvo lugar en noviembre de 2010, y el paquete SAP ERP migró a HANA en mayo de 2013. La plataforma se basa en tecnologías adquiridas: TREX Search Engine (búsqueda en almacenamiento columnar), base de datos P*TIME y MAX DB.
La propia palabra «HANA» es un acrónimo de High performance ANalytical Appliance. Esta base de datos se ofrece como código que puede funcionar en cualquier servidor x86, sin embargo, las instalaciones industriales solo están permitidas en hardware que haya pasado la certificación. Existen soluciones de HP, Lenovo, Cisco, Dell, Fujitsu, Hitachi y NEC. Algunas configuraciones de Lenovo incluso permiten la operación sin SAN, utilizando un clúster GPFS en discos locales como almacenamiento compartido.
A diferencia de las plataformas mencionadas anteriormente, HANA es una base de datos en memoria, es decir, la imagen primaria de los datos se almacena en la memoria RAM, y en disco solo se guardan los registros y las instantáneas periódicas, para recuperación en caso de falla.
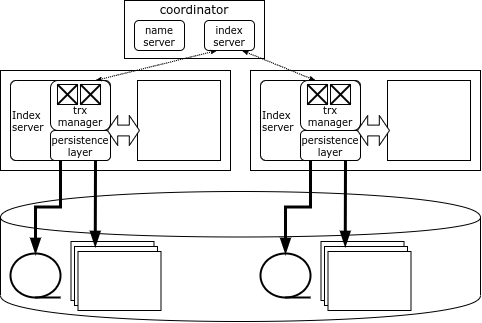
Cada nodo del clúster HANA es responsable de su parte de los datos, y el mapa de datos se guarda en un componente especial: Name Server, ubicado en el nodo coordinador. Los datos no se duplican entre nodos. La información sobre bloqueos también se almacena en cada nodo, pero existe un detector global de bloqueos en el sistema.
El cliente HANA, al conectarse al clúster, carga su topología y posteriormente puede dirigirse directamente a cualquier nodo según los datos que necesite. Si la transacción afecta a los datos de un único nodo, puede ser ejecutada localmente por ese nodo. Sin embargo, si se modifican los datos de varios nodos, el nodo iniciador se dirige al nodo coordinador, que abre y coordina la transacción distribuida, confirmándola mediante un protocolo optimizado de dos fases.
El nodo coordinador está duplicado, por lo que en caso de que el coordinador falle, un nodo de respaldo entra en funcionamiento inmediatamente. En cambio, si falla un nodo de datos, la única forma de acceder a sus datos es reiniciar el nodo. Por lo general, en los clústeres HANA se mantiene un servidor de reserva (spare) para reiniciar lo más rápido posible el nodo perdido.
Fuente: habr.com
