

A pesar de que hay muchos datos casi en todas partes, las bases de datos analíticas siguen siendo bastante exóticas. Se conocen poco y se utilizan aún peor y, muchos continúan "comiendo cactus" con MySQL o PostgreSQL, que están diseñados para otros escenarios, luchando con NoSQL o pagando de más por soluciones comerciales. ClickHouse cambia las reglas del juego y reduce significativamente la barrera de entrada en el mundo de los SGBD analíticos.
Este es un informe de la BackEnd Conf 2018 y ha sido publicado con el permiso del ponente.
¿Quién soy y por qué hablo de ClickHouse? Soy el director de desarrollo en LifeStreet, que utiliza ClickHouse. Además, soy el fundador de Altinity. Este es un socio de Yandex que promueve ClickHouse y ayuda a Yandex a hacer que ClickHouse sea más exitoso. También estoy dispuesto a compartir conocimientos sobre ClickHouse.
Y no, no soy hermano de Petya Zaitsev. A menudo me preguntan sobre esto. No, no somos hermanos.
«Es bien sabido» que ClickHouse:
- Es muy rápido,
- Es muy conveniente,
- Se utiliza en Yandex.
Es menos conocido en qué empresas y cómo se utiliza.
Les contaré para qué, dónde y cómo se utiliza ClickHouse, además de en Yandex.
Les hablaré sobre cómo se abordan tareas específicas utilizando ClickHouse en diferentes empresas, qué herramientas de ClickHouse pueden usar para sus tareas, y cómo han sido utilizadas en diversas compañías.
He seleccionado tres ejemplos que muestran ClickHouse desde diferentes perspectivas. Creo que serán interesantes.
Primera pregunta: «¿Para qué sirve ClickHouse?». A primera vista, la pregunta parece bastante obvia, pero hay más de una respuesta.
- La primera respuesta es por el rendimiento. ClickHouse es muy rápido. La analítica en ClickHouse también es muy rápida. A menudo se puede utilizar donde algo más funciona muy lentamente o muy mal.
- La segunda respuesta es el costo. Y, sobre todo, el costo de escalado. Por ejemplo, Vertica es una base de datos completamente excelente. Funciona muy bien si no tiene muchos terabytes de datos. Pero cuando se trata de cientos de terabytes o petabytes, el costo de la licencia y el soporte puede ser bastante significativo. Y eso es caro. En cambio, ClickHouse es gratuito.
- La tercera respuesta es el costo operativo. Este enfoque es un poco diferente. RedShift es un excelente análogo. En RedShift se puede implementar una solución muy rápidamente. Funcionará bien, pero cada hora, cada día y cada mes tendréis que pagar a Amazon un precio bastante elevado, ya que es un servicio considerablemente caro. Google BigQuery también. Aquellos que lo han usado saben que se pueden lanzar varias consultas y recibir sorpresas en la factura de cientos de dólares.
En ClickHouse no hay esos problemas.
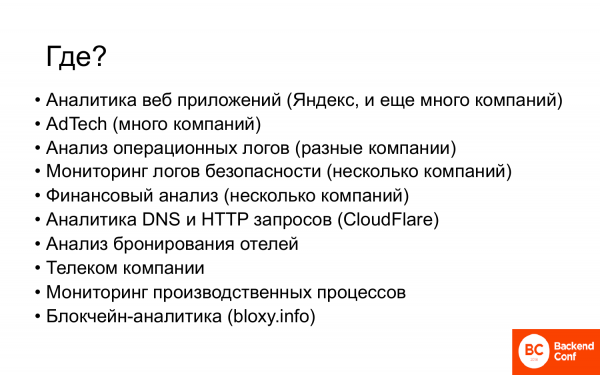
¿Dónde se utiliza ClickHouse actualmente? Además de Yandex, ClickHouse se usa en una variedad de negocios y empresas.
- En primer lugar, es la analítica de aplicaciones web, es decir, es un caso de uso que proviene de Yandex.
- Muchas compañías de AdTech utilizan ClickHouse.
- Numerosas empresas que necesitan analizar registros operativos de diversas fuentes.
- Algunas empresas utilizan ClickHouse para monitorear registros de seguridad. Los cargan en ClickHouse, generan informes y obtienen los resultados que necesitan.
- Las empresas comienzan a utilizarlo en análisis financiero, es decir, poco a poco, grandes negocios también se están acercando a ClickHouse.
- CloudFlare. Si alguien está al tanto de ClickHouse, seguramente ha escuchado el nombre de esta empresa. Es uno de los contribuyentes más significativos de la comunidad. Y tienen una instalación de ClickHouse muy seria. Por ejemplo, han desarrollado el Motor Kafka para ClickHouse.
- Las empresas de telecomunicaciones han comenzado a usarlo. Varias empresas utilizan ClickHouse ya sea como prueba de concepto o en producción.
- Una empresa utiliza ClickHouse para monitorear procesos de producción. Prueban circuitos, registran un montón de parámetros, alrededor de 2000 características. Luego analizan si la partida es buena o mala.
- Análisis de blockchain. Existe una empresa rusa llamada Bloxy.info que analiza la red de Ethereum. También lo hicieron utilizando ClickHouse.
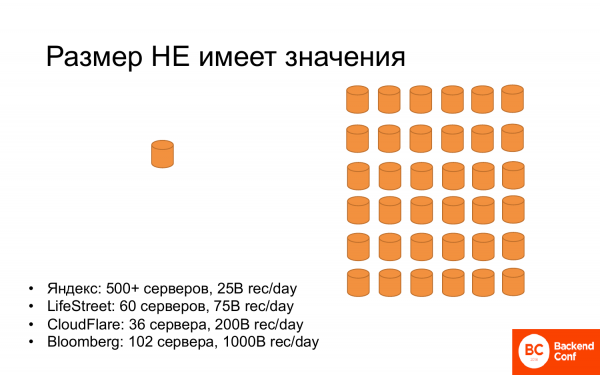
De hecho, el tamaño no importa. Hay muchas empresas que utilizan un pequeño servidor. Y eso les permite resolver sus problemas. Y aún más empresas utilizan grandes clústeres de muchos servidores o decenas de servidores.
Y si miramos los récords, entonces:
- Yandex: más de 500 servidores, guardan 25 mil millones de registros al día.
- LifeStreet: 60 servidores, aproximadamente 75 mil millones de registros al día. Menos servidores, más registros que en Yandex.
- CloudFlare: 36 servidores, almacenan 200 mil millones de registros al día. Tienen aún menos servidores y almacenan aún más datos.
- Bloomberg: 102 servidores, aproximadamente un billón de registros al día. Récord en registros.
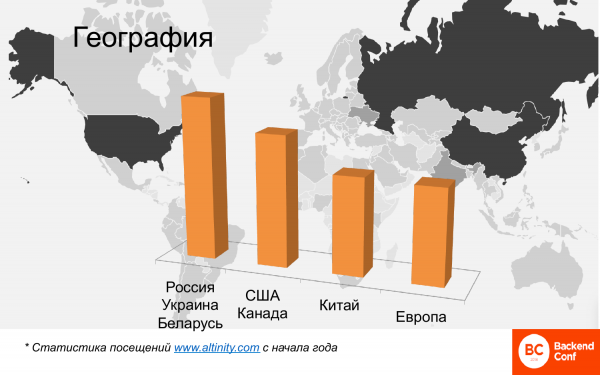
Geográficamente, esto también es mucho. Este mapa muestra el heatmap de dónde se utiliza ClickHouse en el mundo. Rusia, China y Estados Unidos destacan de manera brillante. Hay pocos países europeos. Se pueden identificar 4 clústeres.
Este es un análisis comparativo, aquí no hay que buscar cifras absolutas. Este análisis se basa en los visitantes que leen material en inglés en el sitio de Altinity, porque no hay contenido en ruso. Rusia, Ucrania y Bielorrusia, es decir, la parte de la comunidad de habla rusa, son los usuarios más numerosos. Luego están Estados Unidos y Canadá. China está alcanzando muy rápidamente. Hace seis meses, casi no había usuarios de China; ahora, China ya ha superado a Europa y sigue creciendo. La vieja Europa tampoco se queda atrás, y curiosamente, el líder en el uso de ClickHouse es Francia.
¿Por qué cuento todo esto? Para mostrar que ClickHouse se está convirtiendo en una solución estándar para el análisis de big data y ya se está utilizando en muchos lugares. Si lo estás usando, estás en la tendencia correcta. Si aún no lo usas, no temas quedarte solo y que nadie te ayude, porque ya muchos están trabajando con esto.
Estos son ejemplos de uso real de ClickHouse en varias empresas.
- El primer ejemplo es una red publicitaria: migración de Vertica a ClickHouse. Sé de varias empresas que han cambiado de Vertica o están en proceso de hacerlo.
- El segundo ejemplo es un almacén de transacciones en ClickHouse. Este ejemplo se basa en antipatrón. Todo lo que no se debe hacer en ClickHouse según los consejos de los desarrolladores, se ha hecho aquí. Y aun así, se ha hecho de tal manera que funciona. Y funciona mucho mejor que una solución transaccional típica.
- El tercer ejemplo son los cálculos distribuidos en ClickHouse. Hubo preguntas sobre cómo se puede integrar ClickHouse en el ecosistema de Hadoop. Mostraré un ejemplo de cómo una empresa desarrolló algo similar a un contenedor de map reduce en ClickHouse, supervisando la localización de datos, etc., para resolver una tarea muy no trivial.
- LifeStreet – Es una empresa de Ad Tech que tiene todas las tecnologías asociadas con la red publicitaria.
- Se dedica a la optimización de anuncios, pujas programáticas.
- Mucho datos: alrededor de 10 mil millones de eventos al día. Además, estos eventos pueden dividirse en varios subtipo de eventos.
- Muchos clientes utilizan estos datos, y no solo personas, sino muchas más: son varios algoritmos que se dedican a la oferta programática.
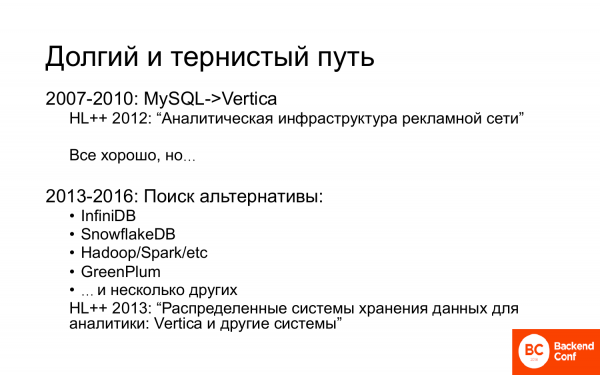
La compañía ha recorrido un largo y difícil camino. Hablé de ello en HighLoad. Primero, LifeStreet pasó de MySQL (con una breve parada en Oracle) a Vertica. Se puede encontrar una historia sobre esto.
Y todo iba muy bien, pero pronto se hizo evidente que los datos estaban creciendo y Vertica resultaba caro. Por ello, se buscaban diversas alternativas. Algunas de ellas se mencionan aquí. De hecho, realizamos pruebas de concepto o pruebas de rendimiento en casi todas las bases de datos que estaban disponibles en el mercado entre 2013 y 2016 y que más o menos cumplían con la funcionalidad. También hablé de algunas de ellas en HighLoad.
La tarea era migrar de Vertica en primer lugar, porque los datos estaban creciendo. Y crecieron exponencialmente durante varios años. Luego se estabilizaron, pero aun así. Al prever este crecimiento, y las demandas del negocio sobre el volumen de datos que se necesitaban para realizar alguna analítica, estaba claro que pronto se hablaría de petabytes. Y pagar por petabytes ya es muy caro, así que se buscó una alternativa a la que migrar.
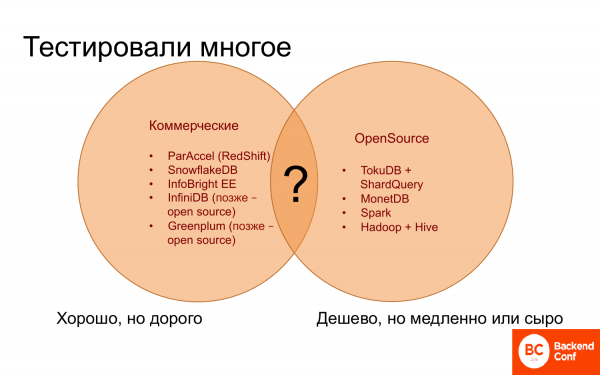
¿A dónde migrar? Durante mucho tiempo no estaba claro hacia dónde ir, ya que, por un lado, existen bases de datos comerciales que parecen funcionar bien. Algunas funcionan casi tan bien como Vertica, y otras un poco peor. Pero todas son caras, no se podía encontrar nada más barato y mejor.
Por otro lado, existen soluciones open source, pero no son muchas, es decir, para analítica se pueden contar con los dedos. Y son gratuitas o baratas, pero funcionan lentamente. Además, a menudo les falta la funcionalidad necesaria y útil.
Por lo tanto, no había nada que combinara lo bueno de las bases de datos comerciales y todo lo gratuito que existe en open source.
No hubo nada hasta que, de repente, Yandex sacó, como un mago saca un conejo de su sombrero, ClickHouse. Y esta fue una solución inesperada, aún se hacen preguntas: "¿Por qué?", pero aun así.
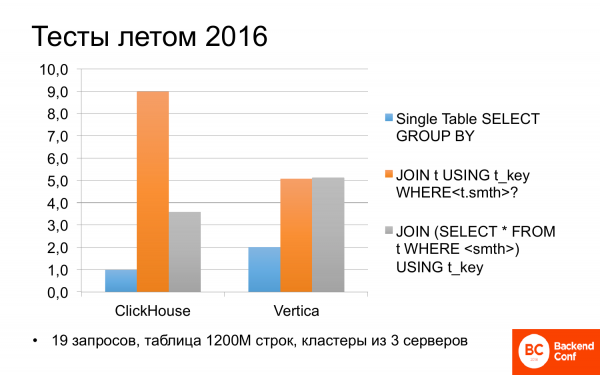
Y ya en el verano de 2016 comenzamos a investigar qué es ClickHouse. Y resultó que a veces puede ser más rápido que Vertica. Probamos diferentes escenarios con distintas consultas. Y si la consulta utilizaba solo una tabla, es decir, sin ningún tipo de unión (join), ClickHouse era dos veces más rápido que Vertica.
No me molesté y revisé las pruebas de Yandex recientemente. Allí también sucede lo mismo: ClickHouse es dos veces más rápido que Vertica, por lo que a menudo hablan de ello.
Pero si hay uniones (join) en las consultas, la situación no es tan clara. Y ClickHouse puede ser hasta dos veces más lento que Vertica. Sin embargo, si se ajusta un poco la consulta y se reescribe, entonces son aproximadamente iguales. No está mal. Y es gratuito.
Así que, tras obtener los resultados de las pruebas y mirándolo desde diferentes perspectivas, LifeStreet optó por ClickHouse.
Esto fue en el año 16, lo recuerdo. Era como el chiste sobre los ratones que lloraban y se pinchaban, pero seguían comiendo el cactus. Se habló de ello en detalle, hay un video al respecto, etc.
Por eso no voy a entrar en detalle sobre esto, solo hablaré de los resultados y de algunas cosas interesantes que no mencioné entonces.
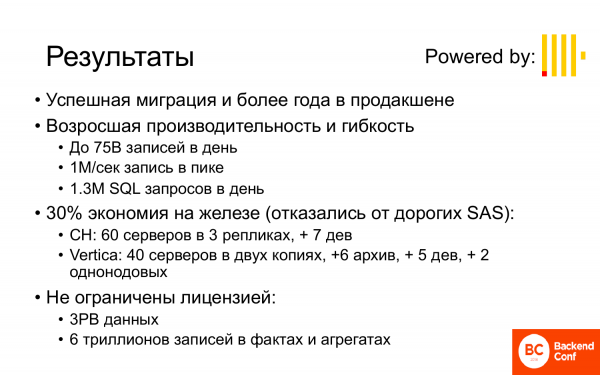
Los resultados son los siguientes:
- La migración fue exitosa y el sistema ya lleva más de un año funcionando en producción.
- El rendimiento y la flexibilidad han aumentado. De los 10 mil millones de registros que podíamos almacenar por día, y eso solo por poco tiempo, ahora LifeStreet almacena 75 mil millones de registros al día y puede hacerlo durante 3 meses o más. Si se calcula en picos, son hasta un millón de eventos por segundo que se guardan. Más de un millón de consultas SQL llegan a este sistema cada día, principalmente de diferentes robots.
- A pesar de que para ClickHouse se utilizaron más servidores que para Vertica, hubo ahorro en el hardware, porque en Vertica se utilizaban discos SAS bastante caros. En ClickHouse se utilizaron discos SATA. ¿Y por qué? Porque en Vertica el insert es síncrono. Y la sincronización requiere que los discos no se ralenticen demasiado, así como que la red tampoco lo haga, es decir, es una operación bastante costosa. En ClickHouse, en cambio, el insert es asíncrono. Además, se puede escribir todo localmente siempre, no hay costos adicionales, por lo que los datos en ClickHouse se pueden insertar mucho más rápido que en Vertica, incluso en discos que no son los más rápidos. Y en lectura es aproximadamente igual. La lectura en SATA, si están en RAID, es bastante rápida.
- No están limitados por licencia, es decir, 3 petabytes de datos en 60 servidores (20 servidores son una réplica) y 6 billones de registros en hechos y agregados. Nada parecido podía permitirse en Vertica.
Ahora paso a cuestiones prácticas en este ejemplo.
- El primero es un esquema eficiente. Del esquema depende mucho.
- El segundo es la generación de SQL eficiente.
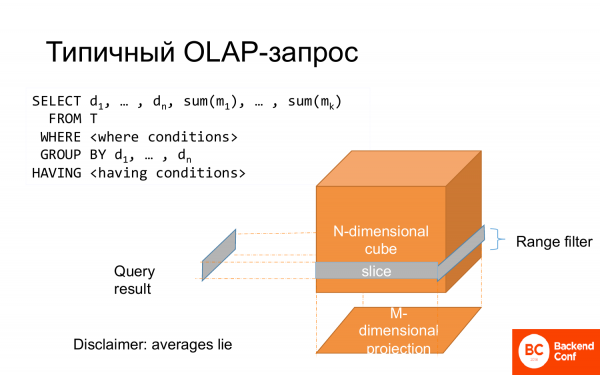
Una consulta OLAP típica es un select. Parte de las columnas va en group by, parte de las columnas va en funciones agregadas. Hay un where, que se puede presentar como un corte del cubo. Todo el group by se puede ver como una proyección. Por ello se llama análisis de datos multidimensional.
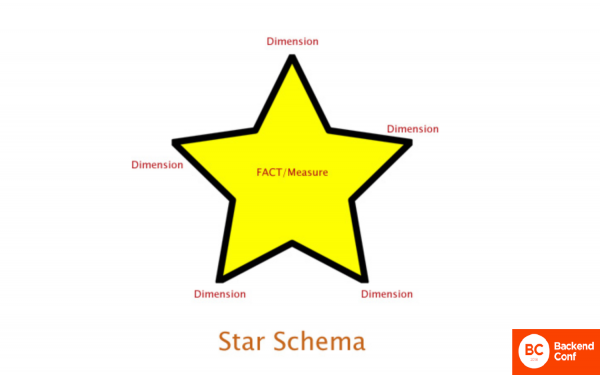
Y a menudo esto se modela en forma de esquema estrella, donde hay un hecho central y características de este hecho a los lados, en los rayos.
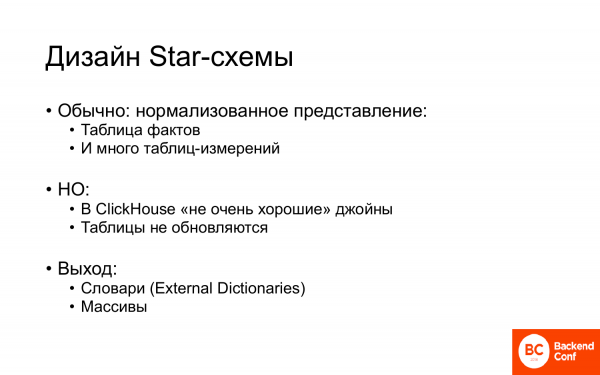
Y desde el punto de vista del diseño físico, de cómo se adapta a la tabla, por lo general se hace una representación normalizada. Puedes desnormalizar, pero es costoso en cuanto a disco y no muy eficiente en las consultas. Por lo tanto, normalmente se hace una representación normalizada, es decir, una tabla de hechos y muchas tablas de dimensiones.
Pero en ClickHouse esto funciona mal. Hay dos razones:
- La primera es que en ClickHouse no hay muy buenos joins, es decir, los joins existen, pero son deficientes. Por ahora son deficientes.
- La segunda es que las tablas no se actualizan. Normalmente en estas tablitas, que están alrededor del esquema estrella, es necesario cambiar algo. Por ejemplo, el nombre del cliente, el nombre de la empresa, etc. Y eso no funciona.
Y hay una salida en ClickHouse. De hecho, hay dos:
- La primera es el uso de diccionarios. Los Diccionarios Externos son lo que ayudan a resolver en un 99 % el problema con el esquema estrella, con las actualizaciones y demás.
- La segunda es el uso de arreglos. Los arreglos también ayudan a deshacerse de los joins y de los problemas de normalización.
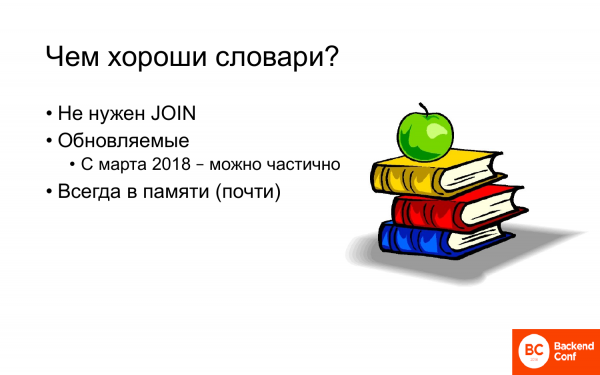
- No se necesita un join.
- Actualizables. Desde marzo de 2018 apareció una capacidad no documentada (no la encontrarás en la documentación) para actualizar diccionarios parcialmente, es decir, aquellas entradas que han cambiado. Prácticamente, esto es como una tabla.
- Siempre en memoria, por lo que los joins con el diccionario funcionan más rápido que si fuera una tabla, que está en disco y no es seguro que esté en caché, lo más probable es que no.
- Tampoco se necesita un join.
- Es una representación compacta de una a muchos.
- Y en mi opinión, los arreglos están hechos para frikis. Son funciones lambda y demás.
Esto no es una exageración. Es una funcionalidad muy potente que permite hacer muchas cosas de manera simple y elegante.
Ejemplos típicos que ayudan a resolver arreglos. Estos ejemplos son sencillos y bastante ilustrativos:
- Búsqueda por etiquetas. Si tienes hashtags y quieres encontrar algunas entradas por hashtag.
- Búsqueda por pares clave-valor. También hay algunos atributos con valores.
- Almacenamiento de listas de claves que necesitas traducir en algo diferente.
Todas estas tareas se pueden resolver sin arreglos. Se pueden colocar las etiquetas en una línea y seleccionar con una expresión regular o en una tabla separada, pero entonces tendrás que hacer uniones (join).
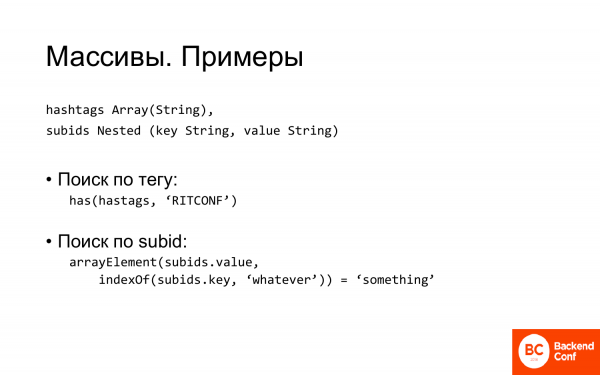
Y en ClickHouse no necesitas hacer nada, solo describir un arreglo string para los hashtags o hacer una estructura anidada para sistemas tipo clave-valor.
Una estructura anidada puede no ser el nombre más afortunado. Son dos arreglos que tienen una parte común en el nombre y algunas características relacionadas.
Y buscar por etiqueta es muy sencillo. Hay una función has, que verifica si hay un elemento en el arreglo. Eso es todo, encontramos todas las entradas que pertenecen a nuestra conferencia.
La búsqueda por subid es un poco más complicada. Primero debemos encontrar el índice de la clave y luego obtener el elemento con ese índice y verificar que el valor sea el que necesitamos. Sin embargo, sigue siendo muy simple y compacto.
La expresión regular que te gustaría escribir si tuvieras todo eso almacenado en una línea sería, por un lado, torpe. Y, por otro lado, funcionaría mucho más lento que dos arreglos.
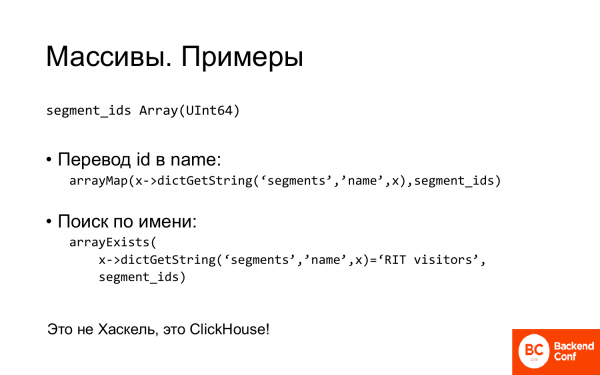
Otro ejemplo. Tienes un arreglo en el que almacenas IDs. Y puedes traducirlos a nombres. La función arrayMap. Es una función lambda típica. Pasas expresiones lambda a ella. Y extrae el valor del nombre para cada ID del diccionario.
De manera similar se puede hacer la búsqueda. Se pasa una función predicado que verifica a qué cumplen los elementos.
Estas cosas simplifican mucho el esquema y resuelven un montón de problemas.
Pero el siguiente problema con el que nos encontramos y del que me gustaría hablar, son las consultas eficientes.
- En ClickHouse no hay un planificador de consultas. No hay ninguno.
- Sin embargo, las consultas complejas aún necesitan ser planificadas. ¿En qué casos?
- Si hay múltiples joins en la consulta que se envuelven en subconsultas. Y el orden en que se ejecutan es importante.
- Y lo segundo, si la consulta es distribuida. Porque en una consulta distribuida, solo la subconsulta más interna se realiza de manera distribuida, y todo lo demás se envía a un solo servidor al que te conectaste y se ejecuta allí. Por lo tanto, si tienes consultas distribuidas con muchos joins, debes elegir el orden.
Y incluso en casos más simples, a veces es necesario que el planificador trabaje y reescribir las consultas un poco.
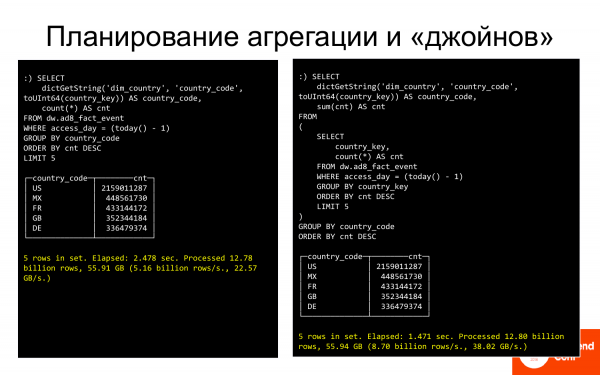
Aquí hay un ejemplo. En la parte izquierda, la consulta que muestra las 5 principales países. Y se ejecuta en 2,5 segundos, creo. Y en la parte derecha, la misma consulta, pero reescrita un poco. En lugar de agrupar por cadena, comenzamos a agrupar por clave (int). Y eso es más rápido. Luego conectamos un diccionario al resultado. En lugar de 2,5 segundos, la consulta se ejecuta en 1,5 segundos. Eso es bueno.
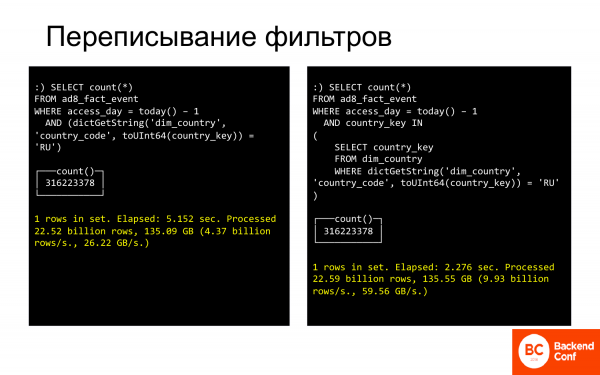
Un ejemplo similar con la reescritura de filtros. Aquí está la consulta sobre Rusia. Se ejecuta en 5 segundos. Si la reescribimos de manera que comparemos nuevamente no por cadena, sino por números con algún conjunto de claves que pertenezcan a Rusia, será mucho más rápido.
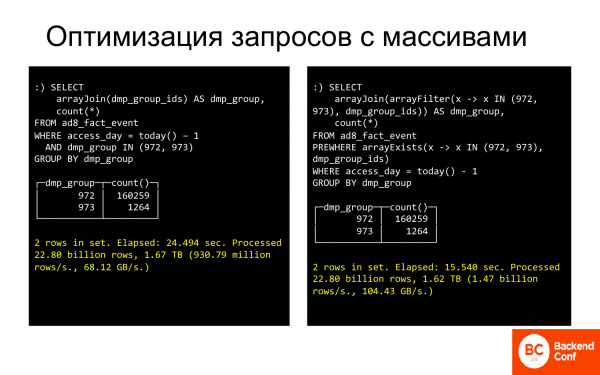
Hay muchos trucos como esos. Y permiten acelerar significativamente las consultas que creías que ya estaban funcionando rápido, o, por el contrario, que funcionaban lentamente. Se pueden hacer aún más rápidas.
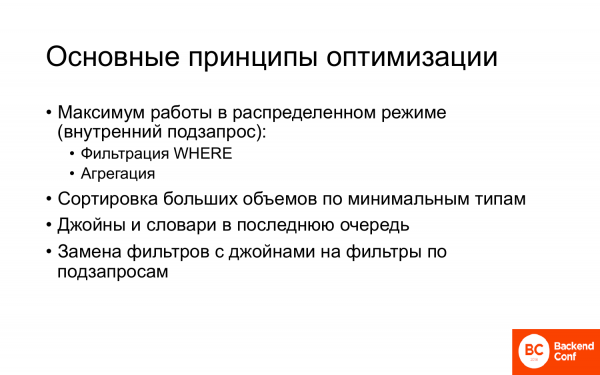
- Máximo rendimiento en modo distribuido.
- Ordenación por tipos mínimos, como lo hice con ints.
- Si hay algunos joins, diccionarios, es mejor hacerlos en último lugar, cuando ya tengas los datos al menos parcialmente agrupados, entonces la operación de join o la llamada al diccionario se hará menos veces y eso será más rápido.
- Reemplazo de filtros.
Hay otras técnicas, no solo las que he demostrado. Y todas ellas pueden a veces acelerar significativamente la ejecución de las consultas.
Pasemos al siguiente ejemplo. La empresa X de EE. UU. ¿Qué hace?
Hubo una tarea:
- Vinculación offline de transacciones publicitarias.
- Modelado de diferentes modelos de vinculación.
¿En qué consiste el escenario?
Un visitante habitual accede al sitio, por ejemplo, 20 veces al mes desde diferentes anuncios o simplemente llega a veces sin ningún anuncio, porque recuerda este sitio. Mira algunos productos, los añade al carrito y los quita del carrito. Y, al final, compra algo.
Preguntas razonables: "¿A quién se le debe pagar por la publicidad, si es necesario?" y "¿Qué anuncio le influyó, si es que le influyó?" Es decir, ¿por qué compró y cómo hacer para que personas que se parezcan a esta persona también compren?
Para resolver esta tarea, es necesario vincular los eventos que ocurren en el sitio web de la manera correcta, es decir, establecer alguna relación entre ellos. Luego, se envían para análisis a DWH. Y sobre la base de este análisis, se construyen modelos de a quién y qué publicidad mostrar.
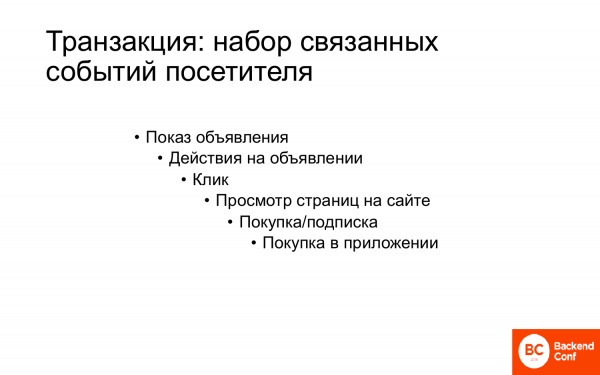
Una transacción publicitaria es un conjunto de eventos relacionados del usuario que comienzan con la visualización de un anuncio, luego ocurre algo, puede haber una compra, y luego pueden haber compras dentro de la compra. Por ejemplo, si se trata de una aplicación móvil o un juego móvil, generalmente la instalación de la aplicación es gratuita, pero si se realiza algo más, pueden requerirse fondos. Y cuanto más gaste una persona en la aplicación, más valiosa es. Pero para esto, todo debe estar vinculado.
Hay muchos modelos de vinculación.
Los más populares son:
- Última Interacción, donde interacción es ya sea un clic o una visualización.
- Primera Interacción, es decir, lo primero que llevó a la persona al sitio.
- Combinación Lineal – a todos por igual.
- Desvanecimiento.
- Y otros.
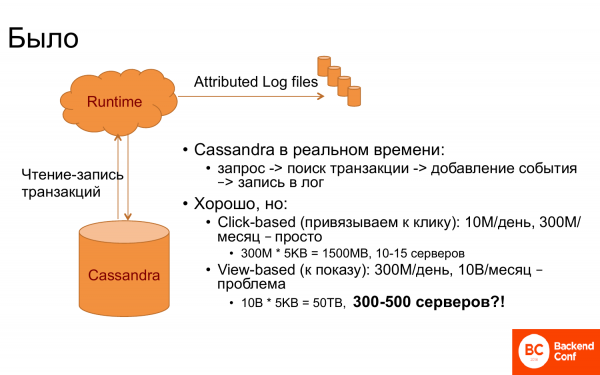
¿Y cómo funcionaba todo esto inicialmente? Había un Runtime y Cassandra. Cassandra se usaba como almacenamiento de transacciones, es decir, contenía todas las transacciones relacionadas. Y cuando llega un evento en Runtime, como la visualización de una página o algo más, se hacía una consulta en Cassandra: ¿hay tal persona o no? Luego se recuperaban las transacciones que le corresponden. Y se producía la vinculación.
Y si tuviste suerte de que en la consulta hay un id de transacción, entonces es fácil. Pero normalmente no hay suerte. Por lo tanto, había que encontrar la última transacción o la transacción con el último clic, etc.
Y todo funcionó muy bien mientras la vinculación se basaba en el último clic. Porque hay, digamos, 10 millones de clics al día, 300 millones al mes, si consideramos la ventana de un mes. Y dado que en Cassandra todo debe estar en memoria para que funcione rápidamente, porque se requiere que Runtime responda rápidamente, se necesitaban aproximadamente 10-15 servidores.
Pero cuando quisieron vincular la transacción a la visualización, no resultó tan divertido. ¿Y por qué? Se ve que se deben almacenar 30 veces más eventos. Y, por tanto, se necesitan 30 veces más servidores. Y se llega a una cifra astronómica. Mantener hasta 500 servidores para hacer la vinculación, teniendo en cuenta que hay significativamente menos servidores en Runtime, representa una cifra incorrecta. Y empezaron a pensar qué hacer.
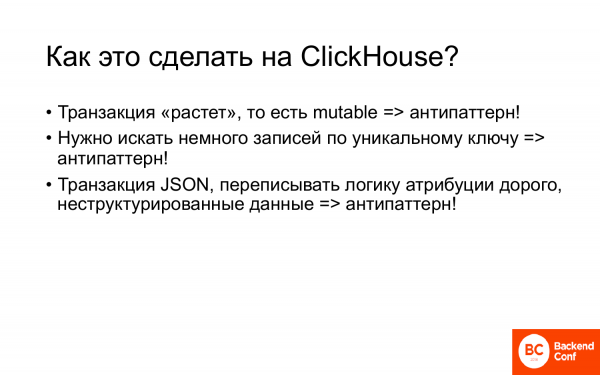
Así que se dirigieron a ClickHouse. ¿Y cómo se hace esto en ClickHouse? A primera vista parece un conjunto de antipatrón.
- La transacción crece, le estamos agregando cada vez más eventos, es decir, es mutable, y ClickHouse no funciona muy bien con objetos mutables.
- Cuando un visitante llega, necesitamos extraer sus transacciones por clave, por su id de visita. También se trata de una consulta puntual, y en ClickHouse no se hace así. Normalmente en ClickHouse hay grandes … escaneos, aquí necesitamos obtener varios registros. También es un antipatrón.
- Además, la transacción estaba en json, pero no querían reescribirla, por lo que deseaban almacenar json de manera no estructurada y, si era necesario, extraer algo de él. Y eso también es un antipatrón.
Es decir, un conjunto de antipatrón.
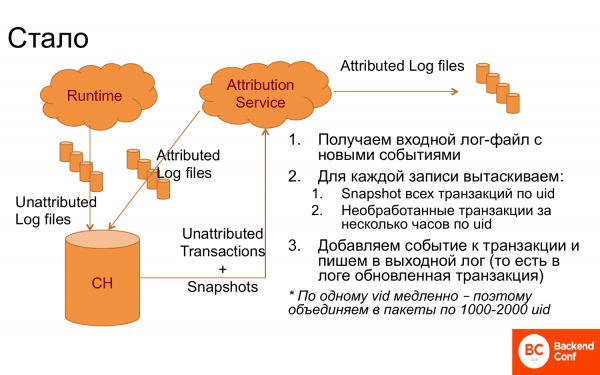
Sin embargo, lograron crear un sistema que funcionaba muy bien.
¿Qué se hizo? Apareció ClickHouse, en el que se enviaban registros desglosados en entradas. Se creó un servicio atribuido que recuperaba registros de ClickHouse. Después, para cada entrada por id de visita, obtenía transacciones que podían no haber sido procesadas y, además, instantáneas, es decir, transacciones ya vinculadas, específicamente el resultado del trabajo anterior. A partir de ahí, formuló la lógica, eligió la transacción correcta, conectó nuevos eventos. Volvió a escribir en el registro. El registro regresó a ClickHouse, es decir, es un sistema cíclico constante. Además, también se enviaba a DWH para ser analizado allí.
En este formato, no funcionaba muy bien. Para facilitar a ClickHouse al procesar las solicitudes por visit id, agrupábamos estas solicitudes en bloques de 1,000 a 2,000 visit id, extrayendo todas las transacciones para 1,000 a 2,000 personas. Así es como comenzó a funcionar correctamente.
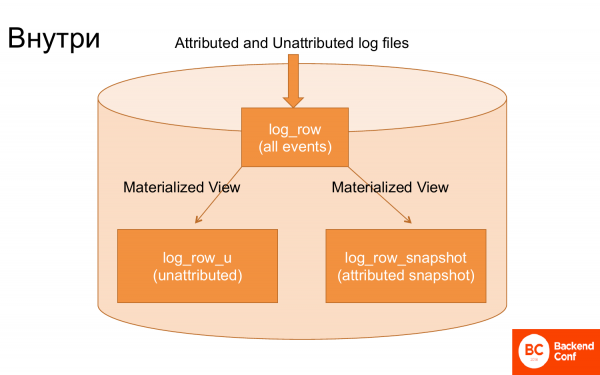
Si miramos dentro de ClickHouse, hay tres tablas principales que mantienen todo esto.
La primera tabla es donde se cargan los registros, y estos se cargan prácticamente sin procesamiento.
La segunda tabla. A través de una vista materializada, se extraían de esos registros los eventos que aún no habían sido atribuídos, es decir, no estaban relacionados. Y a través de otra vista materializada, se extraían las transacciones para construir un snapshot. Es decir, la vista materializada construía un snapshot que representaba el último estado acumulado de la transacción.
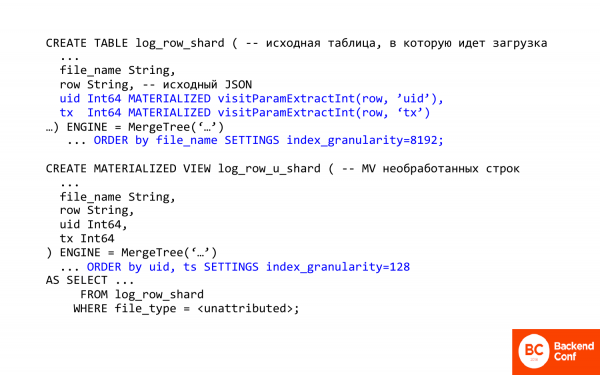
Aquí se presenta un texto en SQL. Quisiera comentar algunas cosas importantes en él.
La primera cosa importante es la capacidad de ClickHouse de extraer columnas y campos de JSON. Es decir, ClickHouse tiene algunos métodos para trabajar con JSON. Son muy primitivos.
visitParamExtractInt permite extraer atributos de JSON, es decir, la primera coincidencia se activa. De esta manera, se puede extraer el transaction id o el visit id. Eso es uno.
El segundo aspecto es que se utiliza un campo materializado ingenioso. ¿Qué significa esto? Significa que no puedes insertarlo en la tabla, es decir, no se inserta, se calcula y se almacena al insertarse. Al insertar, ClickHouse hace el trabajo por ti. Y se extrae de JSON lo que necesitarás más tarde.
En este caso, la vista materializada es para las filas no procesadas. Y se utiliza la primera tabla con registros prácticamente en bruto. ¿Y qué hace? Primero, cambia el orden, es decir, el orden ahora es por visit id, porque necesitamos extraer rápidamente la transacción de una persona en particular.
La segunda cosa importante es index_granularity. Si has visto MergeTree, normalmente el index_granularity está establecido por defecto en 8,192. ¿Qué es esto? Este es un parámetro de la esparsidad del índice. En ClickHouse, el índice es esparcido, nunca indexa cada registro. Lo hace cada 8,192. Esto es bueno cuando se requiere contar muchos datos, pero malo cuando se requiere contar pocos, ya que hay un gran overhead. Y si disminuimos la granuralidad del índice, disminuimos el overhead. No se puede reducir a uno, porque podría faltar memoria. El índice siempre se almacena en la memoria.
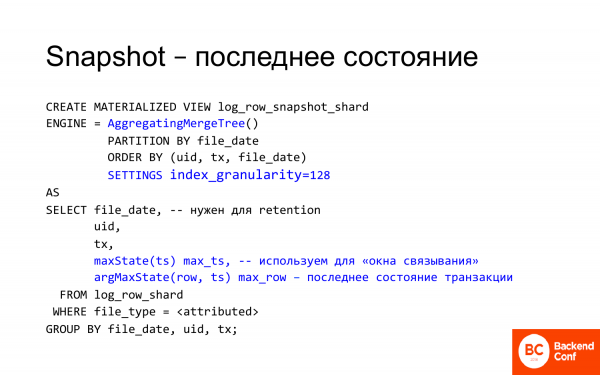
Y el snapshot utiliza algunas funciones interesantes de ClickHouse.
En primer lugar, está AggregatingMergeTree. En AggregatingMergeTree se almacena argMax, es decir, el estado de la transacción correspondiente a la última marca de tiempo. Se generan constantemente nuevas transacciones para este visitante. Y en el estado más reciente de esta transacción hemos agregado un evento y hemos obtenido un nuevo estado. Este nuevamente ha sido registrado en ClickHouse. Y a través de argMax en esta vista materializada siempre podemos obtener el estado actual.
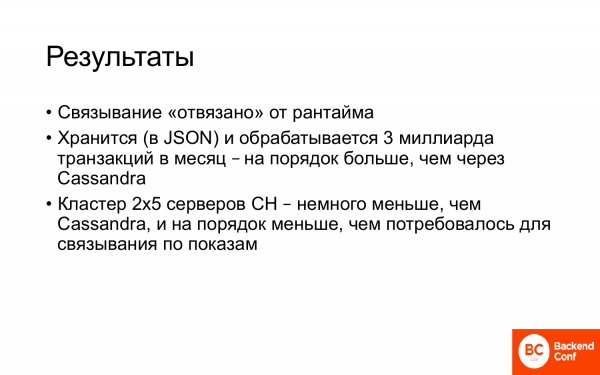
- El enlace está "desvinculado" del Runtime.
- Se almacenan y procesan hasta 3 mil millones de transacciones al mes. Esto es un orden de magnitud mayor que en Cassandra, es decir, en un sistema transaccional típico.
- Un clúster de 2x5 servidores ClickHouse. 5 servidores y cada servidor tiene una réplica. Esto es incluso menos de lo que había en Cassandra para realizar la atribución basada en clics, y aquí tenemos basada en impresiones. Es decir, en lugar de aumentar el número de servidores 30 veces, se logró reducir.
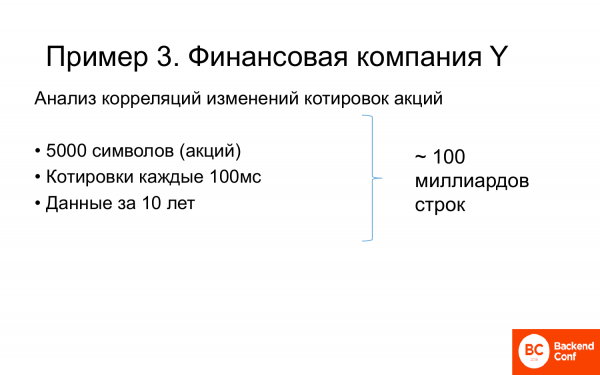
Y el último ejemplo es una compañía financiera Y, que analizaba las correlaciones de los cambios en los precios de las acciones.
Y la tarea planteada fue la siguiente:
- Hay aproximadamente 5,000 acciones.
- Las cotizaciones son conocidas cada 100 milisegundos.
- Los datos se acumularon durante 10 años. Al parecer, para algunas empresas más y para otras menos.
- En total, aproximadamente 100 mil millones de filas.
Y era necesario calcular la correlación de los cambios.
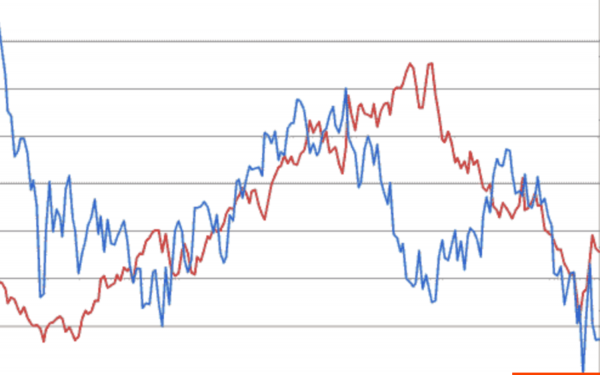
Aquí hay dos acciones y sus cotizaciones. Si una sube y la otra también, entonces hay una correlación positiva, es decir, una crece y la otra también. Si una sube, como al final del gráfico, y la otra baja, entonces hay una correlación negativa, es decir, cuando una crece, la otra cae.
Analizando estos cambios mutuos, se pueden hacer predicciones en el mercado financiero.
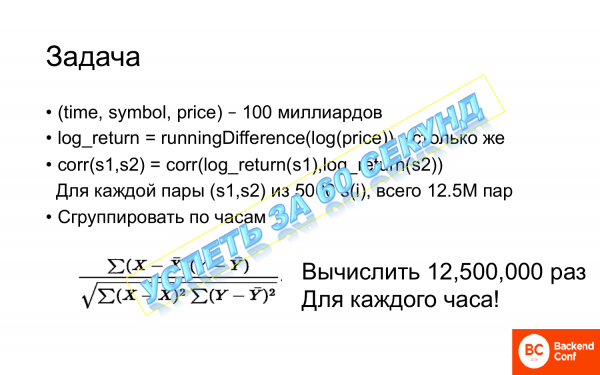
Pero la tarea es complicada. ¿Qué se hace para esto? Tenemos 100 mil millones de registros, que contienen: tiempo, acción y precio. Primero necesitamos calcular 100 mil millones de veces la diferencia en ejecución del algoritmo de precio. La diferencia en ejecución es una función en ClickHouse que calcula la diferencia entre dos filas secuencialmente.
Y después hay que calcular la correlación, y la correlación debe calcularse para cada par. Para 5,000 acciones hay 12.5 millones de pares. Y esto es mucho, es decir, hay que calcular esa función de correlación 12.5 veces.
Y si alguien lo olvidó, x e y son el valor esperado de la muestra. Es decir, no solo hay que calcular raíces y sumas, sino que dentro de esas sumas hay que hacer otras sumas. Hay que realizar un montón de cálculos 12,5 millones de veces, y además hay que agrupar por horas. Y tenemos muchas horas. Y hay que hacerlo en 60 segundos. Es una broma.
Tenía que hacerse de alguna manera, porque todo esto funcionaba muy, muy lento antes de que llegara ClickHouse.
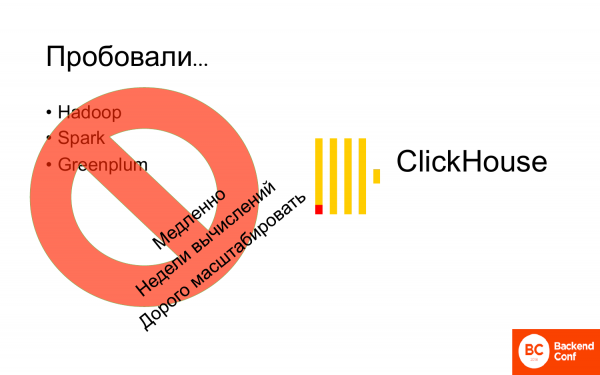
Intentaron calcular esto en Hadoop, en Spark, en Greenplum. Y todo era muy lento o costoso. Es decir, se podía calcular de alguna manera, pero luego era caro.
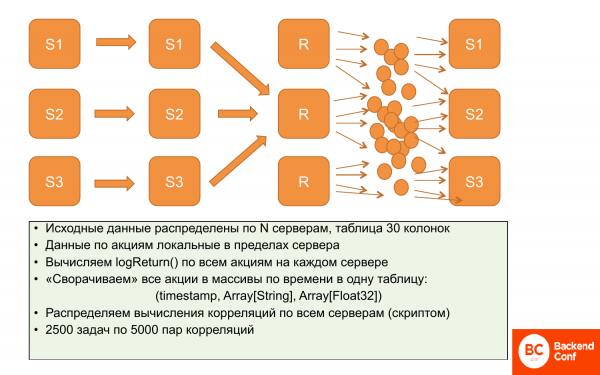
Y luego llegó ClickHouse y todo mejoró mucho.
Recuerdo, tenemos un problema con la localización de los datos, por lo que las correlaciones no se pueden localizar. No podemos sumar parte de los datos en un servidor, parte en otro y calcular; necesitamos tener todos los datos en todas partes.
¿Qué hicieron? Inicialmente, los datos estaban localizados. En cada uno de los servidores se almacena la información de precios de un conjunto específico de acciones. Y no se cruzan. Por lo tanto, se puede calcular logReturn de manera paralela e independiente; todo esto ocurre de manera paralela y distribuida.
Luego decidieron reducir estos datos sin perder expresividad. Reducirlos usando arrays, es decir, para cada intervalo de tiempo hacer un array de acciones y un array de precios. De esta forma, los datos ocupan mucho menos espacio. Y es más conveniente trabajar con ellos. Son casi operaciones paralelas, es decir, calculamos parcialmente de manera paralela y luego grabamos en el servidor.
Después de esto, se pueden replicar. La letra 'r' significa que estos datos los hemos replicado. Es decir, en los tres servidores tenemos los mismos datos: esos arrays.
Y luego, con un script especial de este conjunto de 12,5 millones de correlaciones que hay que calcular, se pueden hacer paquetes. Es decir, 2,500 tareas de 5,000 pares de correlaciones. Y esta tarea se calcula en un servidor ClickHouse específico. Todos los datos están allí, porque los datos son idénticos y puede calcularlos de manera secuencial.
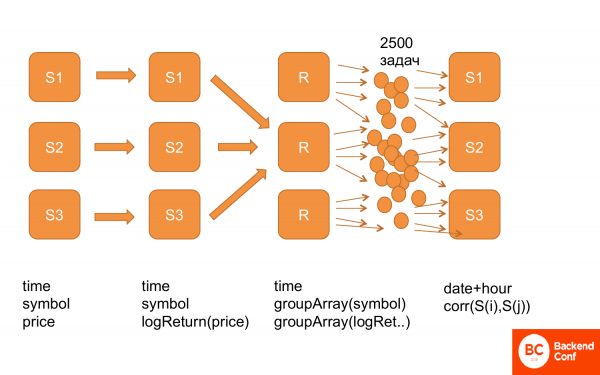
Una vez más, así es como se ve. Primero tenemos todos los datos en esta estructura: tiempo, acciones, precio. Luego calculamos logReturn, es decir, los mismos datos, solo que en lugar de precio tenemos logReturn. Después los transformamos, por lo que obtuvimos tiempo y groupArray por acciones y precios. Los replicamos. Y después de eso, generamos un montón de tareas y las alimentamos a ClickHouse para que las procesara. Y eso funciona.
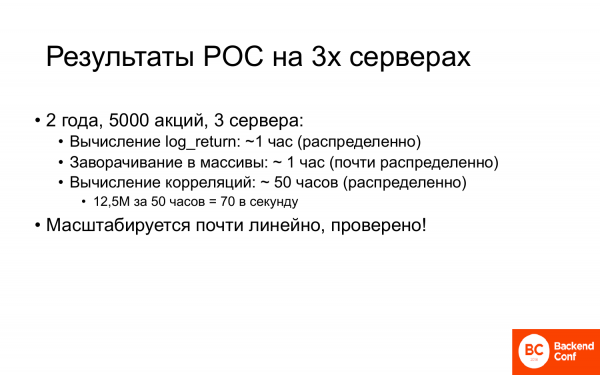
En la prueba de concepto, la tarea era una subtarea, es decir, tomamos menos datos. Y solo en tres servidores.
Los primeros dos pasos: el cálculo de Log_return y enmascararlo en arreglos tomaron aproximadamente una hora cada uno.
Pero el cálculo de la correlación tomó alrededor de 50 horas. Pero 50 horas es poco, porque antes esto funcionaba durante semanas. Fue un gran éxito. Y si lo contamos, se procesaban 70 veces por segundo en este clúster.
Pero lo más importante es que este sistema prácticamente no tiene cuellos de botella, es decir, escala prácticamente de manera lineal. Y eso lo verificaron. Lo escalaron exitosamente.
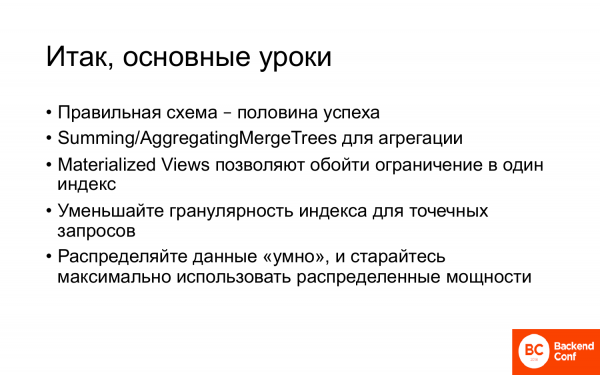
- El esquema correcto es la mitad del éxito. Y el esquema correcto es utilizar todas las tecnologías necesarias de ClickHouse.
- Summing/AggregatingMergeTrees son tecnologías que permiten agregar o calcular estados de instantáneas como un caso particular. Y esto simplifica muchas cosas significativamente.
- Las Vistas Materializadas permiten eludir la limitación de un índice. Puede que no lo haya explicado con mucha claridad, pero cuando cargamos los registros, los registros crudos estaban en una tabla con un índice, y en los registros de atributo estaban en otra tabla, es decir, los mismos datos, solo que filtrados, pero el índice era completamente diferente. Parecen ser los mismos datos, pero con diferentes ordenaciones. Y las Vistas Materializadas permiten, si es necesario, eludir tal limitación en ClickHouse.
- Reduzca la granularidad del índice para consultas puntuales.
- Y distribuye los datos de manera inteligente, intenta maximizar la localización de los datos dentro del servidor. Y asegúrate de que las consultas también usen la localización donde sea posible.
Resumiendo esta breve presentación, se puede decir que ClickHouse ha tomado firmemente el territorio tanto de las bases de datos comerciales como de las bases de datos de código abierto, es decir, específicamente para la analítica. Se ha integrado maravillosamente en este panorama. Además, poco a poco comienza a desplazar a otros, porque cuando tienes ClickHouse, no necesitas InfiniDB. Vertica, tal vez, pronto no será necesaria si hacen un buen soporte para SQL. ¡Úsalo!
—¡Gracias por la presentación! ¡Es muy interesante! ¿Hubo alguna comparación con Apache Phoenix?
-No, no he escuchado que alguien haya comparado. Nosotros y Yandex tratamos de rastrear todas las comparaciones de ClickHouse con diferentes bases de datos. Porque si de repente algo resulta ser más rápido que ClickHouse, Alexey Milovidov no puede dormir por las noches y empieza a acelerarlo rápidamente. No he oído hablar de tal comparación.
(Aleksey Milovidov) Apache Phoenix es un motor SQL sobre HBase. HBase está principalmente destinado a escenarios de trabajo tipo clave-valor. En cada fila puede haber una cantidad arbitraria de columnas con nombres arbitrarios. Esto se puede decir sobre sistemas como HBase, Cassandra. Y no funcionarán bien para consultas analíticas pesadas. O puedes pensar que funcionan bien si no has tenido ninguna experiencia con ClickHouse.
Gracias
¡Buen día! Ya estoy bastante interesado en este tema, porque tengo un subsistema analítico. Pero cuando miro ClickHouse, tengo la sensación de que ClickHouse es muy adecuado para el análisis de eventos, mutable. Y si necesito analizar muchos datos comerciales con un montón de tablas grandes, entonces ClickHouse, por lo que entiendo, no me es muy adecuado, especialmente si están cambiando. ¿Es esto correcto o hay ejemplos que puedan refutarlo?
Es correcto. Y esto es cierto para la mayoría de las bases de datos analíticas especializadas. Están diseñadas para manejar una o varias tablas grandes que son mutables y muchas tablas pequeñas que cambian lentamente. Es decir, ClickHouse no es como Oracle, donde puedes almacenar todo y construir consultas muy complejas. Para usar ClickHouse de manera eficiente, es necesario estructurar el esquema de una manera que funcione bien en ClickHouse. Es decir, evitar la sobre-normalización, utilizar diccionarios y tratar de hacer menos conexiones largas. Y si se construye el esquema de esta manera, entonces tareas empresariales similares en ClickHouse pueden ser resueltas de manera mucho más eficiente que en una base de datos relacional tradicional.
¡Gracias por la presentación! Tengo una pregunta sobre el último caso financiero. Tenían analítica. Era necesario comparar cómo suben y bajan. Y entiendo que construyeron el sistema específicamente para esta analítica, ¿verdad? Si mañana, supongamos, necesitan algún otro informe sobre esos datos, ¿tendrían que reconstruir el esquema y cargar los datos nuevamente? Es decir, ¿hacer algún preprocesamiento para obtener la consulta?
Por supuesto, este es el uso de ClickHouse para una tarea bastante específica. Anteriormente, esto podría haberse resuelto de manera más tradicional dentro de Hadoop. Para Hadoop, esta es una tarea ideal. Pero en Hadoop es muy lento. Y mi objetivo es demostrar que en ClickHouse se pueden resolver tareas que normalmente se manejan con otros medios, pero de manera mucho más eficiente. Está diseñado para una tarea específica. Es obvio que si hay una tarea similar, se puede resolver de manera similar.
Entiendo. Dijo que se procesaron 50 horas. ¿Esto es desde el principio, cuando se cargaron los datos o cuando se obtuvieron los resultados?
Sí, sí.
Bien, muchas gracias.
Esto es en un clúster de 3 servidores.
¡Saludos! Gracias por la presentación. Todo es muy interesante. Quisiera preguntar un poco no sobre la funcionalidad, sino sobre el uso de ClickHouse en términos de estabilidad. Es decir, ¿han tenido algún problema o han tenido que restaurar? ¿Cómo se comporta ClickHouse en esos casos? Y, ¿ha habido ocasiones en que incluso la réplica se cae? Por ejemplo, nosotros hemos tenido el problema con ClickHouse de que, a veces, supera su límite y se cae.
Por supuesto, no existen sistemas perfectos. ClickHouse también tiene sus problemas. Pero, ¿alguna vez han escuchado que Yandex.Metrica ha dejado de funcionar por mucho tiempo? Probablemente no. Ha estado funcionando de manera confiable desde aproximadamente 2012-2013 en ClickHouse. También puedo hablar de mi experiencia. Nunca hemos tenido fallos totales. Pueden ocurrir algunos problemas parciales, pero nunca han sido tan críticos como para afectar seriamente el negocio. Nunca ha pasado. ClickHouse es bastante confiable y no se cae aleatoriamente. No hay de qué preocuparse. No es algo primitivo. Esto ha sido demostrado por muchas empresas.
¡Hola! Dijo que es necesario pensar bien en el esquema de datos desde el principio. ¿Y si eso ya ocurrió? Mis datos están fluyendo sin parar. Pasan seis meses y me doy cuenta que no se puede seguir así, necesito volver a cargar los datos y hacer algo con ellos.
Esto depende, por supuesto, de su sistema. Hay varias formas de hacerlo prácticamente sin detenerse. Por ejemplo, puede crear una Vista Materializada, en la que hacer otra estructura de datos, siempre que se pueda mapear de manera clara. Es decir, si permite el mapeo mediante ClickHouse, es decir, extraer ciertas cosas, cambiar la clave primaria, cambiar la partición, entonces se puede hacer una Vista Materializada. Allí puede reescribir sus datos antiguos, los nuevos se escribirán automáticamente. Luego simplemente cambiar a usar la Vista Materializada, después cambiar la escritura y eliminar la tabla antigua. Esta es una forma de hacerlo sin detenerse.
Gracias.
Fuente: habr.com
