

Nota de traducción.: el autor de este artículo (Luc Perkins) es defensor de desarrolladores en la organización CNCF, que es el hogar de proyectos de código abierto como Linkerd, SMI (Service Mesh Interface) y Kuma (por cierto, ¿también se han preguntado por qué no está Istio en esta lista?). Una vez más, tratando de aportar una mejor comprensión al mundo DevOps sobre la moda llamada «service mesh», menciona 16 características típicas que ofrecen estas soluciones.
Hoy en día, ― uno de los temas más candentes en el ámbito de la ingeniería de software (y con razón). Creo que esta tecnología es increíblemente prometedora y sueño con ser testigo de su amplia adopción (por supuesto, cuando tenga sentido). Sin embargo, todavía está rodeada de un halo de misterio para la mayoría de las personas. Incluso aquellos que están bien familiarizados con ella a menudo tienen dificultades para definir sus ventajas y qué es exactamente (incluido este humilde servidor). En este artículo intentaré corregir la situación enumerando varios escenarios de uso de las «redes de servicios»*.
* Nota del traductor: en este artículo se utilizará esta traducción («red de servicios») para el término todavía nuevo service mesh.
Pero primero quiero hacer algunas observaciones:
- Nunca he trabajado con redes de servicios ni las he utilizado fuera de proyectos iniciados para mi propia educación. Por otro lado, fui quien escribió un montón de documentación para la red de servicios interna de Twitter en 2015 (en ese entonces ni siquiera se llamaba «red de servicios») y participé en el desarrollo del sitio y la documentación para , así que eso significa algo.
- Mi lista es aproximada e incompleta. Es completamente posible que existan escenarios de uso desconocidos para mí, y sin duda surgirán nuevas posibilidades a medida que la tecnología evolucione y su popularidad crezca.
- Al mismo tiempo, no todas las implementaciones existentes de service mesh soportan todos los casos de uso mencionados. Por lo tanto, mis expresiones como «service mesh puede...» deben leerse como «algunas, y posiblemente todas, las implementaciones populares de service mesh pueden...».
- El orden de los ejemplos no tiene ningún significado.
Lista breve:
- descubrimiento de servicios;
- encriptación;
- autenticación y autorización;
- balanceo de carga;
- circuit breaking;
- escalado automático;
- despliegues canarios;
- despliegues azul-verde;
- verificación de salud;
- carga de sobrecarga;
- mirroring de tráfico;
- aislamiento;
- límite de frecuencia de solicitudes, reintentos y tiempos de espera;
- telemetría;
- auditoría;
- visualización.
1. Detección de servicios
TL;DR: Conéctese a otros servicios en la red mediante nombres simples.
Los servicios deben tener la capacidad de 'encontrarse' automáticamente entre sí utilizando nombres adecuados, por ejemplo, service.api.production, pets/staging o cassandra. Los entornos en la nube se caracterizan por su elasticidad, y detrás de un solo nombre puede haber múltiples instancias del servicio. Es evidente que en tal situación no es físicamente posible codificar todas las direcciones IP.
Además, cuando un servicio encuentra a otro, debe poder enviar solicitudes a ese servicio sin temor a que estas terminen en una instancia no operativa. En otras palabras, la service mesh debe supervisar la salud de todas las instancias de servicios y mantener una lista de hosts lo más actualizada posible.
Cada service mesh implementa un mecanismo de detección de servicios de su manera. Actualmente, el método más común es delegar a procesos externos como DNS de Kubernetes. En el pasado, en Twitter, utilizábamos un sistema de nombres . Además, la tecnología de service mesh permite la aparición de mecanismos de nombramiento personalizados (aunque aún no he encontrado ninguna implementación de SM con tal funcionalidad).
2. Cifrado
TL;DR: Elimine el tráfico no cifrado entre servicios y asegúrese de que este proceso sea automatizado y escalable.
Es reconfortante saber que los atacantes no pueden acceder a su red interna. Los cortafuegos hacen bien este trabajo. Pero, ¿qué pasaría si un hacker logra penetrar? ¿Podría hacer lo que quiera con el tráfico interno del servicio? Esperemos que eso no suceda. Para prevenir tal escenario, se debe implementar una red de confianza cero (zero-trust), en la que todo el tráfico entre los servicios esté cifrado. La mayoría de las redes de servicios modernas logran esto a través de mutual (mutual TLS, mTLS). En algunos casos, mTLS funciona en nubes y clústeres enteros (creo que alguna vez las comunicaciones interplanetarias estarán organizadas de manera similar).
Por supuesto, para mTLS la service mesh no es obligatoria. Cada servicio puede ocuparse de su propio TLS, pero esto significa que será necesario encontrar una manera de generar certificados, distribuirlos entre los hosts del servicio, incluir en la aplicación código que cargue estos certificados desde archivos. Además, no se olvide de actualizar estos certificados periódicamente. Las mallas de servicios automatizan el mTLS utilizando sistemas como , que a su vez automatizan el proceso de emisión y rotación de certificados.
3. Autenticación y autorización
TL;DR: Establezca quién es el iniciador de la solicitud y determine qué se le permite hacer antes de que la solicitud llegue al servicio.
Los servicios a menudo quieren saber, quién realiza la solicitud (autenticación), y utilizando esta información, deciden que qué se le permite hacer a ese sujeto (autorización). En este caso, el pronombre «quién» puede referirse a:
- Otros servicios. Esto se llama «autenticación de pares». Por ejemplo, el servicio
webquiere acceder al serviciodb. Las mallas de servicios suelen resolver problemas similares mediante mTLS: los certificados en este caso actúan como el identificador necesario. - Ciertos usuarios-humanos. Esto se llama «autenticación de solicitudes». Por ejemplo, el usuario
haxor69quiere comprar una nueva lámpara. Las mallas de servicios proporcionan varios mecanismos, como .Muchos de nosotros hemos hecho esto en el código de la aplicación. Llega una solicitud, revisamos la tabla
usuarios, encontramos al usuario y comparamos la contraseña, luego verificamos la columnapermissionsy así sucesivamente. En el caso de la malla de servicios, esto ocurre incluso antes de que la solicitud llegue al servicio.
Después de haber establecido de quién proviene la solicitud, es necesario determinar qué se le permite hacer a ese sujeto. Algunas mallas de servicios permiten definir políticas básicas (sobre quién y qué puede hacer) en forma de archivos YAML o en la línea de comandos, mientras que otras ofrecen integración con marcos como . El objetivo final es lograr que sus servicios acepten cualquier solicitud, asumiendo con confianza que provienen de una fuente confiable y si esa acción está permitida.
4. Balanceo de carga
TL;DR: Distribuya la carga entre instancias del servicio según un patrón específico.
Un «servicio» dentro de un sector de servicios a menudo consta de múltiples instancias idénticas. Por ejemplo, hoy el servicio cache consiste en 5 copias, y mañana su número podría aumentar a 11. Las solicitudes que se envían a cache, deben ser distribuidas de acuerdo con un objetivo específico. Por ejemplo, minimizar la latencia o maximizar la probabilidad de acceder a una instancia operativa. Generalmente se utiliza el algoritmo de rondas (Round-robin), pero existen muchos otros — por ejemplo, el método de solicitudes ponderadas (weighted) , el hash en anillo (ring) , el hash consistente (uso de hash consistente para hosts upstream) o el método de menor número de solicitudes (preferencia por la instancia con el menor número de solicitudes). Los balanceadores clásicos tienen otras funciones, como el almacenamiento en caché HTTP y la protección contra DDoS, pero no son muy relevantes para el tráfico tipo este-oeste (es decir, el tráfico que ocurre dentro del centro de datos — nota del traductor)(área típica de aplicación de service mesh). Por supuesto, no es necesario utilizar service mesh para el balanceo de carga, sin embargo, permite establecer y controlar políticas de balanceo para cada servicio desde una capa de gestión centralizada, eliminando así la necesidad de implementar y configurar balanceadores separados en la pila de red.
5. Ruptura del circuito (circuit breaking)
TL;DR: Detén el tráfico hacia el servicio problemático y controla el daño en los peores escenarios.
Si por alguna razón el servicio no puede manejar el tráfico, la service mesh proporciona varias opciones para resolver este problema (se hablará de otras en secciones correspondientes). La ruptura del circuito es la opción más drástica de desconectar el servicio del tráfico. Sin embargo, por sí sola no tiene sentido; se necesita un plan de contingencia. Se puede prever presión inversa
(backpressure) () Las service mesh no solo permiten definir
cuándo se llevará a cabo la desconexión y deberá realizarse la desconexión y que Esto seguirá. En este caso, "cuándo" puede incluir cualquier combinación de parámetros establecidos: el número total de solicitudes en un periodo determinado, la cantidad de conexiones paralelas, solicitudes pendientes, reintentos activos, etc.
Probablemente no querrás abusar del circuit breaking, pero es reconfortante saber que hay un plan de respaldo en caso de emergencia.
6. Escalado automático
TL;DR: Aumenta o disminuye el número de instancias del servicio según los criterios establecidos.
Las mallas de servicios no son planificadores, por lo que no realizan escalado por sí solas. Sin embargo, pueden proporcionar información sobre la cual los planificadores tomarán decisiones. Dado que las mallas de servicios tienen acceso a todo el tráfico entre servicios, disponen de amplia información sobre lo que sucede: qué servicios están enfrentando problemas, cuáles están prácticamente inactivos (los recursos asignados a ellos se desperdician), etc.
Por ejemplo, Kubernetes escala servicios en función del uso de CPU y memoria por los pods (ver nuestro informe "" — nota del traductor)", pero si decides escalar en base a cualquier otro indicador (en nuestro caso, relacionado con el tráfico), necesitarás una métrica especial. Una guía muestra cómo hacerlo con , y , pero el proceso en sí es bastante complejo. Nos gustaría que la malla de servicios lo simplificara, permitiendo simplemente establecer condiciones como "aumenta el número de instancias del servicio auth, si el número de solicitudes en espera supera un umbral durante un minuto".
7. Despliegues canary
TL;DR: Prueba nuevas funciones o versiones del servicio en un subconjunto de usuarios.
Supongamos que estás desarrollando un producto SaaS y planeas lanzar una nueva y emocionante versión. La has probado en staging y funcionó perfectamente. Sin embargo, persisten ciertas preocupaciones sobre su comportamiento en condiciones reales. En otras palabras, necesitas probar la nueva versión en tareas reales, sin arriesgar la confianza de los usuarios. Los despliegues canary son excelentes para esto. Permiten mostrar una nueva función a un subconjunto de usuarios. Este subconjunto puede estar compuesto por los usuarios más leales, aquellos que utilizan la versión gratuita del producto, o usuarios que han expresado su deseo de ser "conejillos de indias".
Las mallas de servicios implementan esto, permitiendo especificar criterios que determinan quién y qué versión de la aplicación verá, y enrutando el tráfico en consecuencia. Para los propios servicios, nada cambia. La versión 1.0 del servicio asume que todas las solicitudes provienen de usuarios que deben verla, mientras que la versión 1.1 piensa lo mismo sobre sus usuarios. Mientras tanto, tú puedes cambiar el porcentaje de tráfico entre la versión antigua y la nueva, redirigiendo un número creciente de usuarios a la nueva si funciona de manera estable y tus "conejillos de indias" dan su visto bueno.
8. Despliegues azul-verde
TL;DR: Lanza la nueva y emocionante función, pero estate preparado para revertir todo de inmediato.
Significado es que se lanza un nuevo servicio "azul" ejecutándolo en paralelo con el antiguo, "verde". Si todo sale bien y el nuevo servicio se presenta de forma efectiva, el antiguo puede ser descontinuado gradualmente. (Desafortunadamente, tarde o temprano, este nuevo servicio "azul" también repetirá la suerte del "verde" y desaparecerá...) Los despliegues azul-verde se diferencian de los canarios en que la nueva función abarca a todos los usuarios (no a una parte); la idea aquí es tener un "puerto de salvamento" listo, en caso de que algo salga mal.
Los service meshes ofrecen una forma muy conveniente de probar el servicio 'azul' y cambiar instantáneamente al 'verde' en caso de problemas. Sin mencionar que, además, proporcionan una gran cantidad de información (ver el apartado 'Telemetría' a continuación) sobre el funcionamiento del 'azul', lo que ayuda a entender si está listo para un uso completo.
Nota de traducción.: Más información sobre las diferentes estrategias de despliegue en Kubernetes (incluyendo las mencionadas canary, blue/green y otras) se puede encontrar en .
9. Comprobación de salud
TL;DR: Mantenga un seguimiento de qué instancias de servicios están operativas y responda a aquellas que dejan de estarlo.
Comprobación de salud (health check) ayuda a decidir si las instancias del servicio están listas para recibir y procesar tráfico. Por ejemplo, en el caso de servicios HTTP, la comprobación de salud podría consistir en una solicitud GET a un endpoint. /health. La respuesta 200 OK significa que la instancia está sana; cualquier otra respuesta indica que no está lista para recibir tráfico. Los service meshes permiten especificar tanto el método de verificación de la operatividad como la frecuencia con la que se realizará esta verificación. Esta información se puede utilizar posteriormente para otros fines, como la balanceo de carga y el circuit breaking.
Así, la comprobación de salud no es un escenario de uso independiente, sino que generalmente se utiliza para lograr otros objetivos. Además, dependiendo de los resultados de las comprobaciones de salud, pueden requerirse acciones externas (en relación con otros objetivos de las redes de servicios): por ejemplo, actualizar la página de estado, crear un issue en GitHub o llenar un ticket en JIRA. Y el service mesh ofrece un mecanismo conveniente para automatizar todo esto.
10. Descarga de carga (load shedding)
TL;DR: Redirija el tráfico en respuesta a un aumento temporal en el uso.
Si un servicio se ve abrumado por el tráfico, puede redirigir temporalmente parte de este tráfico a otro lugar (es decir, 'soltar', 'derramar' (shed) hacia allí). Por ejemplo, hacia un servicio de respaldo o un centro de datos, o a un tema. Como resultado, el servicio continuará procesando parte de las solicitudes en lugar de caer y dejar de procesar todo. El desbordamiento de carga es preferible a romper la cadena, pero aún así no se debe abusar de él. Esto permite prevenir fallos en cascada que hacen que fallen los servicios downstream.
11. Paralelización/espejado de tráfico
TL;DR: Envía una solicitud a varios lugares a la vez.
A veces es necesario enviar una solicitud (o un conjunto de solicitudes) a varios servicios al mismo tiempo. Un ejemplo típico es enviar parte del tráfico de producción al servicio de staging. El servidor web principal de producción envía una solicitud al servicio inferior products.production y solo a él. Y el service mesh copia inteligentemente esa solicitud y la envía a products.staging, de lo cual el servidor web ni siquiera es consciente.
Otro escenario de uso relacionado con el service mesh, que se puede implementar sobre la paralelización de tráfico, es el . Esto implica enviar las mismas solicitudes a diferentes versiones del servicio y verificar si todas las versiones se comportan de la misma manera. Hasta ahora, no he encontrado una implementación de service mesh con un sistema integrado de pruebas de regresión como , pero la idea en sí parece prometedora.
12. Aislamiento
TL;DR: Divide tu service mesh en mini-redes.
También conocida como segmentación, el aislamiento es el arte de dividir la red de servicios en segmentos lógicamente separados, que no saben nada unos de otros. El aislamiento es un poco similar a crear redes privadas virtuales. La diferencia fundamental es que aún puedes beneficiarte de todas las ventajas del service mesh (como el descubrimiento de servicios), pero con una seguridad adicional. Por ejemplo, si un atacante logra infiltrarse en un servicio en una de las subredes, no podrá ver qué servicios están activos en otras subredes ni interceptar su tráfico.
Además, los beneficios pueden ser organizativos. Tal vez desees dividir los servicios en subredes según la estructura de la empresa y liberar a los desarrolladores de la carga cognitiva causada por la necesidad de tener en mente toda la service mesh.
13. Limitación de la frecuencia de solicitudes, reintentos y tiempos de espera
TL;DR: Ya no es necesario incluir en la base de código las tareas urgentes de gestión de solicitudes.
Todas estas cuestiones podrían considerarse como casos de uso separados, pero he decidido combinarlas debido a una característica común: asumen las tareas de gestión del ciclo de vida de las solicitudes, normalmente manejadas por bibliotecas de aplicaciones. Si estás desarrollando un servidor web en Ruby on Rails (no integrado con service mesh), que realiza solicitudes a servicios backend a través de , la aplicación deberá decidir por sí misma qué hacer si N solicitudes fallan. También será necesario determinar la cantidad de tráfico que estos servicios serán capaces de manejar y 'hardcodear' esos parámetros utilizando una biblioteca específica. Además, la aplicación deberá decidir cuándo es el momento de rendirse y permitir que la solicitud caduque (por timeout). Y para cambiar cualquiera de los parámetros mencionados anteriormente, el servidor web deberá detenerse, reconfigurarse y reiniciarse.
Delegar estas tareas a una service mesh significa no solo que los desarrolladores de servicios no tendrán que pensar en ellas, sino también que se podrán considerar de manera más global. Si se utiliza una cadena compleja de servicios, digamos, A → B → C → D → E, es necesario tener en cuenta todo el ciclo de vida de la solicitud. Si se necesita extender los timeouts en el servicio C, es lógico hacerlo todo a la vez, en lugar de por partes: actualizando el código del servicio y esperando a que se apruebe la solicitud de extracción y el sistema CI despliegue el servicio actualizado.
14. Telemetría
TL;DR: Recopila toda la información necesaria (y no tan necesaria) de los servicios.
La telemetría es un término general que incluye métricas, trazado distribuido y registros. Las service mesh ofrecen mecanismos para recopilar y procesar los tres tipos de datos. Aquí es donde las cosas se vuelven un poco confusas, ya que el número de posibilidades es demasiado grande. Para la recopilación de métricas hay y otras herramientas, para la recopilación de registros se puede utilizar , , y otros. (por ejemplo, ClickHouse con nuestro para K8s — nota del traductor.), para trazado distribuido hay etc. Cada service mesh puede soportar ciertas herramientas y no soportar otras. Será interesante ver si el proyecto puede proporcionar cierta convergencia.
En este caso, la ventaja de la tecnología service mesh radica en que los contenedores sidecar pueden, en principio, recopilar todos los datos mencionados de sus servicios. En otras palabras, usted dispone de un sistema unificado de recopilación de telemetría, y el service mesh puede procesar toda esta información de diversas maneras. Por ejemplo:
- hacer tail de los logs de cierto servicio en la CLI;
- monitorear el volumen de solicitudes desde el panel de control del service mesh;
- recolectar trazas distribuidas y redirigirlas a un sistema como Jaeger.
Atención, opinión subjetiva: En general, la telemetría es un área donde la intervención de la service mesh no es deseable. La recopilación de información básica y el seguimiento en tiempo real de algunas 'métricas doradas', como el porcentaje de solicitudes exitosas y las latencias, es normal, pero esperemos no ser testigos de la aparición de esos 'stacks Frankenstein' que intenten reemplazar sistemas especializados, algunos de los cuales ya han demostrado su eficacia y están bien estudiados.
15. Auditoría
TL;DR: Quien olvida las lecciones de la historia está condenado a repetirlas.
La auditoría es el arte de observar eventos importantes en el sistema. En el caso del service mesh, esto puede significar rastrear quién hizo solicitudes a endpoints específicos de ciertos servicios o cuántas veces ocurrió un evento relacionado con la seguridad en el último mes.
Es claro que la auditoría está muy ligada a la telemetría. La diferencia radica en que la telemetría normalmente se asocia con aspectos como rendimiento y eficiencia técnica, mientras que la auditoría puede referirse a cuestiones legales y otros asuntos que trascienden el ámbito estrictamente técnico (por ejemplo, cumplimiento de la GDPR - Regulación General de Protección de Datos de la UE).
16. Visualización
TL;DR: Larga vida a React.js - inagotable fuente de interfaces peculiares.
Es posible que haya un término más adecuado, pero no lo conozco. Solo me refiero a la representación gráfica del service mesh o de algunos de sus componentes. Estas visualizaciones pueden incluir indicadores como latencias medias, información sobre la configuración de los contenedores sidecar, resultados de chequeos de salud y alertas.
Trabajar en un entorno orientado a servicios implica una carga cognitiva mucho más fuerte en comparación con Su Majestad el Monolito. Por lo tanto, la presión cognitiva debe reducirse a toda costa. Una interfaz gráfica banal para el service mesh con la capacidad de hacer clic en un botón y obtener el resultado deseado puede ser crucial para el crecimiento de la popularidad de esta tecnología.
No se incluyeron en la lista
Inicialmente, tenía la intención de incluir algunos escenarios de uso más en la lista, pero luego decidí no hacerlo. Aquí están junto con las razones de mi decisión:
- Multi-datacenter. En mi opinión, esto no es tanto un escenario de uso, sino un área estrecha y específica de aplicación de las redes de servicios o algún conjunto de funciones como el descubrimiento de servicios.
- Ingress y egress. Esta es un área relacionada, pero me limité (quizás artificialmente) al escenario de uso de 'tráfico este-oeste'. Ingress y egress merecen un artículo por separado.
Conclusión
¡Eso es todo por ahora! Nuevamente, esta lista es bastante condicional y probablemente esté incompleta. Si crees que he pasado algo por alto o que he cometido un error, contáctame en Twitter (). Por favor, mantén las normas de cortesía.
P.D. del traductor
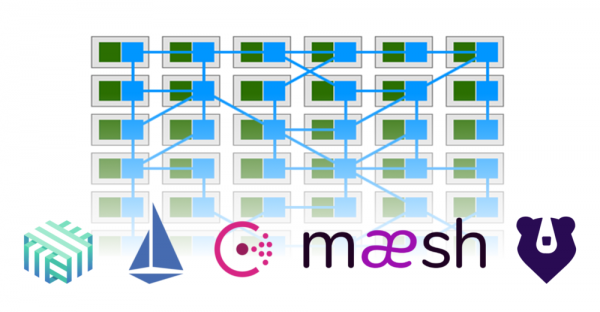
Como base para la ilustración principal del artículo se tomó una imagen del artículo '' (autor — Gregory MacKinnon). En ella se muestra cómo parte de la funcionalidad de las aplicaciones (en verde) se trasladó al service mesh, que proporciona las interconexiones entre ellas (en azul).
También puedes leer en nuestro blog:
- «»;
- «»;
- «».
Fuente: habr.com
