

por St-Pete
¡Hola a todos! Soy Mons Anderson, arquitecto de la plataforma , les contaré cómo construimos nuestro almacenamiento S3, cómo funciona, qué soluciones resultaron exitosas y cuáles deberíamos modificar si comenzáramos un proyecto similar desde cero hoy.
Este artículo fue preparado sobre la base de una presentación en por Mail.ru Cloud Solutions & Tarantool. En el artículo hablaremos de:
- cómo estaba estructurado el almacenamiento de Mail.ru, sobre el cual construimos el almacenamiento S3;
- qué añadimos para crear Mail.ru Cloud Storage;
- cómo funciona el modelo de almacenamiento de objetos y qué pasos se dieron para lanzarlo a producción;
- sobre ajustes del sistema en producción: conmutación por error y escalado;
- cómo implementamos el particionamiento y re-particionamiento;
- así como sobre el trabajo con certificados SSL.
Si no quieres leer, puedes .
Cómo estaba estructurado el almacenamiento de Mail.ru, sobre el cual construimos el almacenamiento S3
El desarrollo de nuestro S3 comenzó sobre el almacenamiento de Mail.ru Cloud, por lo que primero vale la pena contar cómo está estructurado y qué capacidades tiene.
El almacenamiento de Mail.ru Cloud consiste en servidores con discos. En promedio, un servidor de almacenamiento moderno tiene 36 discos de 12 a 14 terabytes. Antes los discos eran más pequeños, pero en tres años su capacidad ha crecido y hoy en día casi alcanza medio petabyte de datos en bruto.
Los discos de diferentes servidores de almacenamiento se combinan en lo que se llama "pares" (pair). Un par es una unidad única de almacenamiento de archivos. En esencia, es un disco montado en una partición determinada en una ruta específica, donde pueden residir los archivos identificados por hashes.
El par es un nombre histórico que ha perdurado hasta hoy, aunque en un par no necesariamente hay solo dos discos. Pueden ser tres discos o diferentes tipos de almacenamiento híbrido, por ejemplo, 3/2.
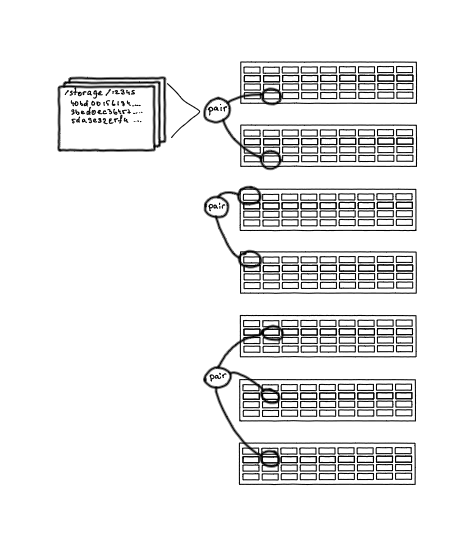
Pares (pair) — unidades de almacenamiento de objetos
Todos los pares se almacenan en PairDB — una aplicación basada en Tarantool. Todas las bases en nuestro almacenamiento, desde las más antiguas, son Tarantool, no utilizamos otras bases.
PairDB almacena todos los pares, sus estados, el espacio libre, las capacidades de fallo, los últimos errores. También puede por sí misma consultar a los pares, actualizar su estado, verificar si están funcionando o no. Es decir, PairDB proporciona una visión general del estado de todos los discos de nuestro sistema.
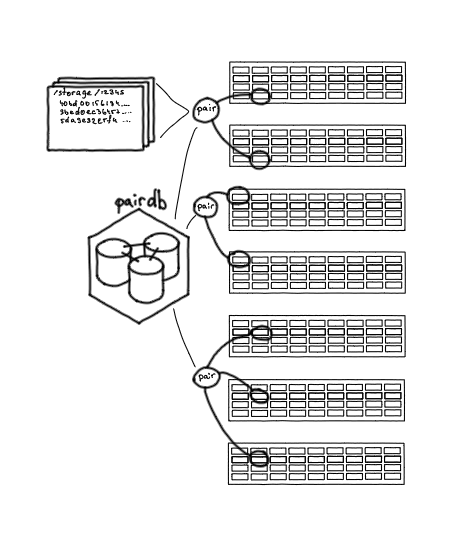
Pair DB: base de datos con el estado de los pares
En los pares se almacenan archivos, y para saber qué archivo está en qué par, se necesita otra base de datos: FileDB. Esta almacena el mapeo, la definición de correspondencia: el archivo tal se almacena en el par tal, así como una pequeña cantidad de atributos necesarios.
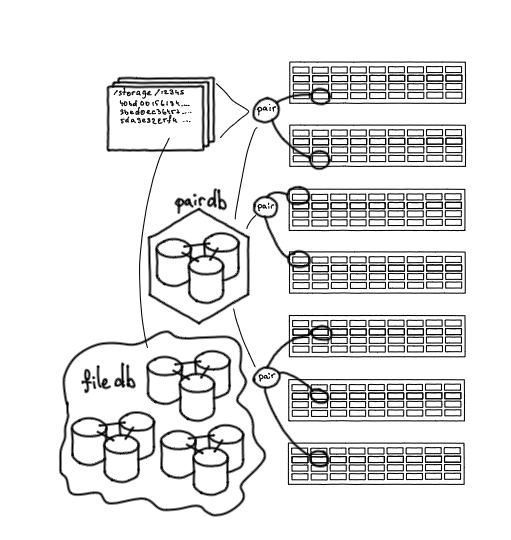 File DB: el lugar donde se almacena el archivo
Otro eslabón importante es el servicio Nylon, un enrutador para trabajar con bases de datos. Es un único punto de entrada que permite trabajar a través de una interfaz única tanto con PairDB como con FileDB. Es un servicio sin estado, realiza el balanceo de solicitudes, entiende a qué shard de FileDB se debe acceder, y sabe qué pares están activos y cuáles no.
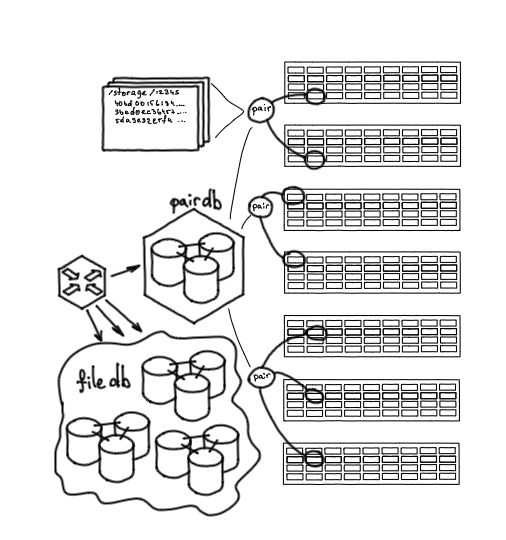
Nylon: enrutador para trabajar con bases de datos
También es necesario de alguna manera almacenar contenido en el repositorio. Para esto existe un servicio: Streamer. Proporciona dos métodos HTTP: el método PUT para cargar contenido en el repositorio y el método GET para recuperar contenido de allí. HTTP es un protocolo bastante popular y conveniente para la transferencia de datos.
Cuando nos dirigimos a Streamer, a través de Nylon se consulta a PairDB, se determina en qué par se puede cargar el archivo, y después se transfieren los datos por WebDAV a ese par.
En esencia, cualquier servidor de almacenamiento es nginx más discos montados en rutas específicas. Podemos cargar un archivo en el repositorio desde Streamer, eliminarlo, renombrarlo o verificar su integridad. Es decir, es una interfaz conveniente para la interacción de bajo nivel con el almacenamiento.
Streamer: punto de entrada al almacenamiento
Qué hemos añadido para crear almacenamiento S3
Así que hemos revisado la estructura básica del almacenamiento en el momento en que nos preparábamos para lanzar el almacenamiento S3. Con el método PUT podíamos colocar contenido arbitrario allí y obtener como identificador de esos datos un hash. Con este identificador, posteriormente se podía ir a recuperar el archivo original. Pero esto no es suficiente para implementar S3. En el protocolo S3, además del almacenamiento de objetos, existen:
- almacenamiento de metadatos: propiedades adicionales de los objetos;
- organización del acceso a los objetos a través de HTTP;
- agrupación de objetos en colecciones: buckets;
- HTTP-S3 Endpoint. S3 organiza los datos en estructuras definidas: buckets, cada uno de los cuales proporciona un punto de entrada para el almacenamiento de archivos.
Para implementar esta lógica, fue necesario contar con un servicio separado. También queríamos prever desde el principio una arquitectura para el crecimiento futuro del servicio con escalabilidad lineal.
Primeros componentes
El demonio que implementa la API S3. Esta es la API estándar S3 de Amazon, que soporta el trabajo con XML para metadatos y permite transmitir contenido directamente. No tuvimos que inventar nada, todo está descrito y documentado.
También colocamos Nginx delante del servicio. Lo utilizamos para la terminación de SSL, balanceo de carga y algo de lógica en Lua (métricas, registro y trazabilidad).
Para el almacenamiento de metadatos S3, también elegimos Tarantool. En la primera versión, el demonio S3 accedía a esta base de datos para metadatos, mientras que el contenido se almacenaba en un gran almacenamiento a través de Streamer.
Nginx + API S3 + metadatos
Modelo de objeto de almacenamiento
Veamos cómo funciona S3. El usuario puede crear un bucket: una colección de objetos. El bucket se dirige por el nombre del host y es un subdominio del servicio. Dentro del bucket, el usuario puede crear objetos. El identificador del objeto será la URL. El contenido del objeto es un blob, un arreglo de datos binarios que almacenaremos en el almacenamiento. También el objeto tiene atributos: el nombre — esa misma URL, ACL (lista de control de acceso), otros atributos adicionales o arbitrarios — todo esto se guarda en los metadatos.
El esquema normalizado de estos datos podría verse así: hay proyectos que poseen los buckets, que a su vez contienen los objetos, y los objetos pueden ser compuestos. Dado que uno de los métodos para cargar un objeto es por partes, hay dos tablas auxiliares para la carga: uploads y chunks. Además, los proyectos tienen credenciales de acceso y facturación.
Esquema de datos
Dado que estábamos creando un servicio B2B con acceso de pago, este esquema necesitaba facturación.
El servicio de facturación también lo implementamos en Tarantool.
Mejoras en el almacenamiento S3: pasos hacia la producción
Ya hemos creado un modelo funcional que se puede usar: los objetos y metadatos se almacenaron, pero faltaban algunos detalles para su salida a producción.
En primer lugar, el sistema de límites de tasa. Si se inicia el servicio sin él, podríamos sobrecargar impredeciblemente alguna parte del sistema durante picos de carga. El límite de tasa debe funcionar así: cualquier solicitud S3 llega a un host específico, este host es el identificador del bucket, y el bucket pertenece a un cliente determinado. Necesitamos definir alguna función para el bucket que permita calcular el límite de tasa.
Además, el sistema de límites de tasa debe ser lo suficientemente eficiente como para soportar la carga que llega a S3.
Aquí volvimos a usar Tarantool. Los límites de tasa son un clúster de 21 instancias, las instancias se dividen en grupos, se distribuyen en tres nodos físicos y se unen en un gran clúster topológico. Los cambios de configuración se propagan automáticamente: se establecen límites de tasa, valores predeterminados y configuración. Cada bucket es atendido estrictamente por una sola instancia. Cuando llega una solicitud a un bucket específico, se calcula la instancia responsable de ese bucket. Dentro de este nodo, se contabiliza la tasa actual de solicitudes mediante un algoritmo similar al Token Bucket. Luego, el sistema de límites de tasa, basado en los indicadores actuales de carga y las propiedades establecidas para el bucket específico, determina si se puede realizar la solicitud o no. La verificación de límites se realiza en la etapa más temprana de la ejecución de la solicitud S3, protegiendo todos los demás elementos del sistema de una sobrecarga excesiva.
Además, con carga es bastante difícil prescindir de la caché. En S3 se espera un acceso repetido a los mismos objetos, es decir, es un almacenamiento caliente. En condiciones normales, el acceso a un único archivo es atendido por toda la cadena: Streamer, FileDB, PairDB, Storage. Pero al acceder repetidamente a un archivo, optimizamos el acceso a este contenido mediante una caché local.
La caché es multicapa y se implementa mediante nginx, discos SSD locales y de RAM. Aquí no utilizamos Tarantool, porque es más conveniente entregar objetos desde el sistema de archivos, así podemos hacer un escalonamiento de la caché. Además, tenemos objetos grandes con un tamaño máximo de 32 gigabytes, y en Tarantool solo se pueden almacenar en caché objetos pequeños.
Este fue el primer sistema con el que iniciamos, tenía una capacidad calculada, suficiente para investigar y comprender el producto y asegurarnos de que funcionara.
Mejoras del sistema en producción: failover y escalabilidad
El sistema ya estaba en funcionamiento, pero al principio nos faltó algo: era necesario añadir failover y escalabilidad.
Nuestro demonio S3 obtenía metadatos a través del protocolo Tarantool. Reemplazamos la base de datos original con Tarantool, que actuaba como un enrutador proxy para las solicitudes de metadatos. Desde el punto de vista de la aplicación que implementa la API, nada cambió: continuó accediendo a la base de datos a través del protocolo Tarantool, pero el enrutador pudo asegurar un failover activo. Esto significa que pudimos verificar la disponibilidad de los nodos, manejar pausas durante los cambios y fallos, etc. Además, no modificamos la aplicación en sí.
Más sobre cómo implementamos el sharding
La siguiente cuestión a la que tuvimos que atender fue el sharding. El sistema estaba creciendo, aumentando la cantidad de objetos, y necesitábamos expandir nuestras capacidades para un mayor crecimiento.
Regresando al esquema de datos: hay proyectos, hay buckets, credenciales y facturación. Estos son objetos que con alta probabilidad en el futuro cercano no superarán un solo instancia ni en volumen ni en solicitudes. Por lo tanto, no tiene sentido hacer sharding, y los hemos trasladado a una instancia separada que permanecerá sin sharding. Esto permite una gestión más coherente de proyectos y buckets, ya que hay un único punto no shardado.
También en el esquema hay objetos que crecen linealmente: al principio eran cientos de miles, ahora su cantidad se mide en varios miles de millones. Tales objetos, junto con sus partes, necesitaban ser trasladados a un clúster shardado.
Dividimos el esquema, pero los objetos necesitan trabajar con los buckets: un objeto siempre pertenece a un bucket específico, además de que en el bucket hay ACL. Por lo tanto, para cada shard de objetos mantenemos una copia sombra de cada bucket. Además, durante la modificación de objetos y la ejecución de consultas, es necesario contar el volumen para la facturación, por lo que cada shard tiene contadores de facturación.
También añadimos varias tablas y componentes más:
- una papelera, para eliminar proyectos antiguos que son eliminados o congelados;
- cola para tareas en segundo plano, es decir, el almacenamiento principal puede realizar tareas en segundo plano que necesitan hacerse en el clúster;
- soporte del ciclo de vida: un mecanismo que permite trabajar con objetos y gestionar su ciclo de vida.
Como parte de los datos la trasladamos a los shards, se necesitó un proxy de sharding. Podríamos haber reutilizado el enrutador para este propósito, pero un proxy de sharding separado, encargado únicamente de sharding de datos, permite acceder a los datos desde el enrutador en su totalidad, sin pensar en cómo se dividen.
Voy a contar por qué no tomamos una solución lista, sino que queríamos hacer una función de sharding personalizada.
Veamos cómo está estructurada. Tenemos 256 shards disponibles. Para cada bucket, asignamos un rango utilizando alguna función consistente. Es simple — así como utilizas una función consistente para determinar la pertenencia a un shard, determinas el shard inicial y asignas el rango:
f(bucket, shards) = subset
Es decir, si tomas un bucket, puedes decir que él y sus datos siempre estarán en un subconjunto específico de todos los shards. Esto reduce el impacto de ciertos buckets sobre otros y simplifica el trabajo de las consultas map-reduce, cuando necesitas, por ejemplo, listar los objetos en un bucket. Para ello, es necesario interrogar todos los shards donde se almacenan estos objetos. Si los objetos estuvieran en todos los shards, cualquier listado afectaría al sistema en su totalidad, mientras que aquí solo afecta a un subconjunto específico.
Además, cada objeto pertenece a un bucket específico, por lo que cuando solicitamos un objeto, lo hacemos por su nombre en un bucket específico. Es decir, podemos definir una función para el objeto no desde todo el rango disponible de shards, sino solo desde el subconjunto de su bucket:
f(object, subset) = shard
Tomamos un objeto específico, y como argumentos de la función pasamos no todos los shards, sino el subconjunto de su bucket — y obtenemos un shard específico.
Así que el sharding está implementado, hay un proxy de sharding. A partir de aquí, solo queda que el enrutador y la base de datos de metadatos accedan al proxy de sharding. Por ejemplo, para crear objetos de copias de sombras — cuando creamos un bucket, el almacenamiento principal debe crear un representante de este bucket en todos los shards donde debe estar presente.
Cómo implementamos el resharding
El mayor problema del sharding es el resharding. Era importante para nosotros hacerlo sin tiempo de inactividad, ya que el sistema ya estaba en producción. Mostraré cómo resolvimos el problema mediante un ejemplo de una tarea similar con la migración en vivo de datos de un proyecto a otro.
A continuación se muestra el esquema de nuestro clúster que resultó después de implementar el sharding. Tenemos nginx, S3 API, un enrutador, una base de datos primaria con proyectos, un proxy de sharding y los shards en sí.
Anteriormente mencioné que en una etapa del proyecto había una tarea de producto: 'Lanzar otro almacenamiento, Icebox, como Hotbox, solo que para datos fríos'. En esencia, es un almacenamiento similar, pero con diferentes URL y sin cachés.
Icebox se usaba menos que Hotbox, por lo que durante bastante tiempo funcionó sin ningún tipo de sharding. Al final, decidimos abandonarlo y combinar Hotbox e Icebox en un solo servicio, simplemente separando las clases de almacenamiento.
Los buckets en los almacenes no se cruzaban, se podían fusionar y mover fácilmente, pero los clientes utilizaban ambos almacenes, lo que significaba que debíamos resolver el problema de la ausencia de tiempo de inactividad. No podíamos simplemente apagar y copiar. Realizamos la migración en varias etapas.
Para empezar, sincronizamos los almacenes primarios. Teníamos Tarantool y podíamos al crear un objeto hacer lo siguiente:
- la base recibe una solicitud para crear un bucket, por ejemplo en Hotbox;
- Tarantool verifica en la otra base (en este caso, en Icebox) que no existe tal bucket;
- si el bucket existe, la base indica que no se puede crear, y se sincronizó como existente.

Sincronización de buckets
En el almacenamiento que debía recibir todos los datos, se introdujo para proyectos y buckets un indicador que decía dónde se almacenaba este objeto. Podía almacenarse localmente, es decir, en Hotbox, en Icebox — entonces no hay datos en el nuevo almacenamiento, o podía estar en estado de migración.
Si un proyecto o bucket tenía el indicador Migrating, durante la migración la solicitud se ejecutaba primero en el nuevo almacenamiento, donde debían estar los datos, y si no estaban allí, las solicitudes se redirigían al almacenamiento alternativo.
Luego cambiamos el tráfico. Dado que la API podía atender tanto solicitudes de Icebox como de Hotbox, pudimos cambiar el tráfico sin tiempo de inactividad, simplemente trasladando los hosts y agregando las entradas correspondientes en Nginx.
Después de que el tráfico fuera redirigido, se pudo eliminar Nginx y la API de Icebox.
Luego eliminamos Nginx de Icebox y la API de S3, y todo funcionó:
A continuación, iniciamos un proceso de migración en segundo plano, que funciona dentro de la base de datos: analiza elemento por elemento todos los proyectos y sus buckets, les asigna el estado de Migrando, transfiere los datos y, al finalizar la transferencia, asigna el estado de Local.
Después de transferir los datos, ya no necesitamos el antiguo almacenamiento, por lo que eliminamos las partes restantes del antiguo sistema y quitamos del código el soporte para el estado de migración.
Siguiendo los mismos principios, se llevó a cabo la resharding del antiguo almacenamiento al shardizado:
- Marcamos todos los buckets como
No shardizado. Todas las solicitudes a ellos se dirigieron al almacenamiento original, no shardizado. - Los nuevos buckets se crearon directamente en estado
Shardizado. - . Se tomaba un bucket a la vez, se establecía el estado de
Migrandoy se transferían los datos.
Las solicitudes se atendían según el principio:
- Leemos en el nuevo, luego en el viejo.
- Creamos solo en el nuevo.
- Actualizamos en dos fases: si no está en el nuevo, transferimos del viejo al nuevo y luego actualizamos.
Trabajo con certificados SSL
En el frontend utilizamos Nginx. En nuestro caso, no es un Nginx común, sino OpenResty, Nginx con soporte para LuaJIT.
Otro componente del sistema es el manejo de certificados SSL. En el almacenamiento S3, puedes establecer tu propio dominio para acceder a un bucket específico, simplemente utilizando Del lado del proveedor, es necesario crear un alias para todas las direcciones IP de la subred en un formato que redirija la solicitud al DNS del cliente.. Pero hoy en día no se puede prescindir de HTTPS: un dominio propio implica un certificado SSL propio.
Como ya mencioné, la balanceación y terminación de SSL están a cargo de Nginx. En nuestro caso, no es un Nginx común, sino OpenResty, Nginx con soporte para LuaJIT.
Esto nos permitió enseñar a nuestro Nginx a entregar certificados arbitrarios de manera bastante simple. Además, necesitábamos entregar certificados dinámicamente (sin necesidad de escribirlos en un archivo de configuración). Utilizamos la extensión ssl_certificate_by_lua, que permite leer el certificado de una fuente arbitraria durante el handshake de TLS. Como almacenamiento de certificados, también utilizamos Tarantool: esto permite gestionar los certificados desde el exterior y proporciona una entrega extremadamente rápida.
También se implementó un demonio separado, cuya tarea es la actualización regular de los certificados emitidos mediante Let’s Encrypt.
Qué habría conservado y qué haría de manera diferente si desarrollara el almacenamiento desde cero
Qué debería haberse utilizado desde el principio
Shardear desde el principio. Generó bastantes problemas hacer resharding. Es fácil de hacer, pero aún así, si se inician proyectos que necesitan escalar, es mejor optar desde el principio por un clúster shardado, aunque sea con un mínimo de nodos. La implementación de sharding al inicio es casi gratuita en comparación con la integración de sharding en un sistema en funcionamiento.
Trabajar con Tarantool a través de balanceadores. Ahora conectamos todas las bases nuevas a través de balanceadores desde el inicio. Esto permite expandir la funcionalidad y lograr una mayor resistencia a fallos.
Auto failover. Instalaría todas las herramientas requeridas para el auto failover, ya que los primeros fracasos tras el lanzamiento estaban relacionados con su ausencia. Después de la experiencia con S3, todos los productos posteriores se lanzaron teniendo esto en cuenta.
Característica de S3 'Versionado'. Al principio, parecía que esta funcionalidad no era muy demandada. Integrar esta posibilidad en la arquitectura de un sistema en funcionamiento es extremadamente complicado.
Facturación separada. La forma en que integramos la facturación en nuestro sistema funcionó bien al principio, pero con el tiempo comenzó a entorpecer, habría sido mejor configurarla como un servicio completamente separado.
Cuál fue una decisión exitosa
Modelo de datos. La historia ha demostrado que a medida que el servicio evolucionaba, coincidimos bastante bien con el modelo de datos de Amazon, por lo que podemos implementar las características que existen allí.
Esquema de sharding. Apoyaría un diseño similar de sharding basado en rangos por buckets, ya que esto permite distribuir bien las solicitudes de diferentes buckets a través de un gran clúster.
Uso de Tarantool. Tarantool ayudó considerablemente en el desarrollo y modificación del servicio, trabajamos fácilmente con los datos, transformamos y shardamos el almacenamiento, sin necesidad de subir al nivel de la aplicación.
Esta presentación se pronunció por primera vez en by Mail.ru Cloud Solutions&Tarantool. Ver otras presentaciones y suscríbase a los anuncios de eventos en Telegram .
También puedes ver mi antigua presentación sobre S3 o leer el artículo de mi colega sobre el almacenamiento en bloques.
- .
- .
Fuente: habr.com
