

Al principio estaba la tecnología y se llamaba BPF. La examinamos en , el artículo del Antiguo Testamento de este ciclo. En 2013, gracias a los esfuerzos de Alexei Starovoitov y Daniel Borkman, se desarrolló y se incluyó en el núcleo de Linux una versión mejorada, optimizada para las modernas máquinas de 64 bits. Esta nueva tecnología llevó brevemente el nombre de Internal BPF, luego fue renombrada a Extended BPF, y ahora, después de algunos años, todos la llaman simplemente BPF.
En términos simples, BPF permite ejecutar código arbitrario proporcionado por el usuario en el espacio del núcleo de Linux, y la nueva arquitectura resultó ser tan exitosa que necesitaremos unas diez artículos más para describir todas sus aplicaciones. (Lo único con lo que los desarrolladores no lograron salir bien, como puedes ver en la imagen a continuación, es con la creación de un logo decente.)
Este artículo describe la estructura de la máquina virtual BPF, las interfaces del núcleo para trabajar con BPF, las herramientas de desarrollo, así como un resumen breve, muy breve, de las capacidades existentes, es decir, todo lo que necesitaremos más adelante para un estudio más profundo de las aplicaciones prácticas de BPF.
Resumen del artículo
Primero veremos la arquitectura BPF desde una perspectiva general y señalaremos los componentes principales.
Ya teniendo una idea de la arquitectura en general, describiremos la estructura de la máquina virtual BPF.
En esta sección examinaremos más de cerca el ciclo de vida de los objetos BPF: programas y mapas.
Con una comprensión básica del sistema, finalmente veremos cómo crear y gestionar objetos desde el espacio de usuario utilizando una llamada al sistema especial — bpf(2).
Es posible escribir programas utilizando la llamada al sistema. Pero es complicado. Para un escenario más realista, los programadores del núcleo desarrollaron una biblioteca llamada libbpf. Crearemos el esqueleto más simple de una aplicación BPF que utilizaremos en los ejemplos posteriores.
Aquí aprenderemos cómo los programas BPF pueden acceder a funciones auxiliares del núcleo, una herramienta que, junto con los mapas, expande fundamentalmente las capacidades del nuevo BPF en comparación con el clásico.
Para este momento, sabremos lo suficiente como para entender cómo crear programas que utilizan mapas. E incluso echaremos un vistazo al gran y poderoso verificador.
Una sección de referencia sobre cómo compilar las utilidades y el núcleo necesarios para realizar experimentos.
Al final del artículo, aquellos que lleguen hasta allí encontrarán palabras motivadoras y una breve descripción de lo que habrá en los próximos artículos. También enumeraremos algunos enlaces para el autoestudio para aquellos que no desean o no pueden esperar la continuación.
Introducción a la arquitectura BPF
Antes de comenzar a examinar la arquitectura BPF, nos referiremos una última vez (¿o no?) a , que fue desarrollado como respuesta a la aparición de las máquinas RISC y abordó el problema de la filtración eficiente de paquetes. La arquitectura resultó ser tan exitosa que, nacida en los agitados años noventa en Berkeley UNIX, fue portada a la mayoría de los sistemas operativos existentes, sobrevivió hasta los locos años veinte y aún encuentra nuevas aplicaciones.
El nuevo BPF fue desarrollado como respuesta a la amplia adopción de máquinas de 64 bits, servicios en la nube y la creciente necesidad de herramientas para crear SDN (Software-defined networking). Desarrollado por ingenieros de red como una versión mejorada del BPF clásico, el nuevo BPF encontró aplicación en la ardua tarea de trazar sistemas Linux en apenas seis meses, y ahora, seis años después de su aparición, necesitaremos un artículo completo solo para enumerar los diferentes tipos de programas.
VeСёЛыЕ КаРтИнКи
En su esencia, BPF es una máquina virtual sandbox que permite ejecutar código 'arbitrario' en el espacio del núcleo sin comprometer la seguridad. Los programas BPF se crean en el espacio del usuario, se cargan en el núcleo y se conectan a alguna fuente de eventos. Un evento puede ser, por ejemplo, la entrega de un paquete a una interfaz de red, la ejecución de alguna función del núcleo, etc. En el caso de un paquete, el programa BPF tendrá acceso a los datos y metadatos del paquete (en lectura y, tal vez, en escritura, dependiendo del tipo de programa); en el caso de la ejecución de una función del núcleo, tendrá acceso a los argumentos de la función, incluidos los punteros a la memoria del núcleo, etc.
Veamos este proceso con más detalle. Para empezar, hablemos de la primera diferencia respecto al BPF clásico, cuyas programas se escribían en ensamblador. En la nueva versión, la arquitectura se ha ampliado para permitir que los programas se escriban en lenguajes de alto nivel, siendo C, por supuesto, el más destacado. Para ello, se desarrolló un backend para llvm, que permite generar bytecode para la arquitectura BPF.
La arquitectura BPF fue diseñada, entre otras cosas, para ejecutarse de manera eficiente en máquinas modernas. Para que esto funcione en la práctica, el bytecode BPF, después de ser cargado en el núcleo, se traduce en código nativo mediante un componente llamado compilador JIT (Just In Time). Además, si recuerdas, en el BPF clásico, el programa se cargaba en el núcleo y se unía a la fuente de eventos de manera atómica, en el contexto de una única llamada al sistema. En la nueva arquitectura, esto ocurre en dos etapas: primero, el código se carga en el núcleo mediante una llamada al sistema bpf(2), y luego, más tarde, mediante otros mecanismos, diferentes según el tipo de programa, el programa se conecta (attaches) a la fuente de eventos.
Aquí el lector podría preguntarse: ¿de verdad se podía hacer eso? ¿Cómo se garantiza la seguridad de la ejecución de dicho código? La seguridad de la ejecución se garantiza en la etapa de carga de los programas BPF, denominada verificador (en inglés, este paso se llama verifier y a partir de ahora utilizaré la palabra en inglés):
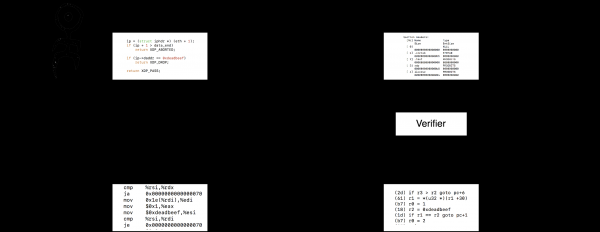
Verifier es un analizador estático que garantiza que un programa no interrumpa el funcionamiento normal del núcleo. Esto, por cierto, no significa que el programa no pueda interferir en el funcionamiento del sistema: los programas BPF, dependiendo del tipo, pueden leer y reescribir segmentos de memoria del núcleo, devolver valores de funciones, truncar, complementar, reescribir e incluso redirigir paquetes de red. Verifier garantiza que la ejecución del programa BPF no causará un fallo en el núcleo y que el programa, que tiene acceso de escritura según las reglas, como los datos de un paquete saliente, no podrá sobrescribir la memoria del núcleo fuera del paquete. Veremos más sobre el verifier en la sección correspondiente, después de familiarizarnos con todos los demás componentes de BPF.
Entonces, ¿qué hemos aprendido hasta ahora? El usuario escribe un programa en el lenguaje C y lo carga en el núcleo mediante una llamada al sistema bpf(2), donde pasa por la verificación del verifier y se traduce a bytecode nativo. Luego, el mismo o otro usuario conecta el programa a la fuente de eventos y comienza a ejecutarse. La separación de la carga y la conexión es necesaria por varias razones. Primero, la ejecución del verifier es relativamente costosa y, al cargar el mismo programa varias veces, desperdiciamos tiempo de procesamiento. En segundo lugar, la forma en que se conecta exactamente el programa depende de su tipo y una «interfaz universal» diseñada hace un año puede no ser adecuada para nuevos tipos de programas. (Aunque ahora, a medida que la arquitectura se vuelve más madura, hay una idea de unificar esta interfaz a nivel libbpf.)
Un lector atento puede notar que aún no hemos terminado con las imágenes. Y es cierto, todo lo mencionado anteriormente no explica cómo el BPF cambia fundamentalmente el panorama en comparación con el BPF clásico. Dos innovaciones que amplían significativamente las posibilidades son la capacidad de utilizar memoria compartida y las funciones auxiliares del núcleo (kernel helpers). En BPF, la memoria compartida se implementa a través de lo que se conoce como maps, estructuras de datos compartidas con una API definida. Su nombre probablemente proviene del hecho de que el primer tipo de map que apareció fue una tabla hash. Luego surgieron arreglos, tablas hash locales (por CPU) y arreglos locales, árboles de búsqueda, maps que contienen punteros a programas BPF y mucho más. Lo que nos interesa ahora es el hecho de que los programas BPF han ganado la capacidad de mantener estado entre invocaciones y compartirlo con otros programas y con el espacio de usuario.
El acceso a los maps se lleva a cabo desde procesos de usuario mediante una llamada al sistema bpf(2), y desde programas BPF que se ejecutan en el núcleo, mediante funciones auxiliares. Además, los helpers existen no solo para trabajar con maps, sino también para acceder a otras funcionalidades del núcleo. Por ejemplo, los programas BPF pueden utilizar funciones auxiliares para redirigir paquetes a otras interfaces, generar eventos de la subsistema perf, acceder a estructuras del núcleo, etc.
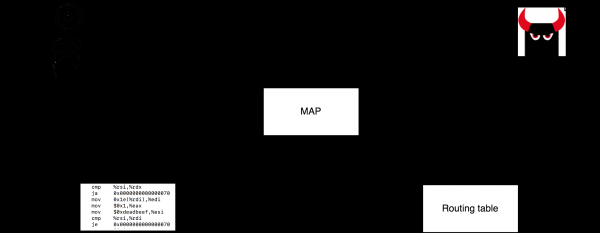
En resumen, BPF permite cargar código de usuario arbitrario, es decir, verificado por el verifier, en el espacio del núcleo. Este código puede mantener estado entre invocaciones y intercambiar datos con el espacio de usuario, así como tener acceso a subsistemas del núcleo permitidos para este tipo de programas.
Esto ya se asemeja a las capacidades proporcionadas por los módulos del núcleo, en comparación con los cuales BPF tiene algunas ventajas (por supuesto, solo se pueden comparar aplicaciones similares, por ejemplo, el rastreo del sistema; no se puede escribir un controlador arbitrario en BPF). Se puede notar un umbral de entrada más bajo (algunas utilidades que utilizan BPF no suponen que el usuario tenga habilidades de programación del núcleo, y en general, ninguna habilidad de programación), seguridad en tiempo de ejecución (levante la mano en los comentarios los que no han roto un sistema al escribir o probar módulos), atomicidad: al reiniciar módulos hay tiempo de inactividad, y el subsistema BPF garantiza que ningún evento se perderá (justo para ser justos, esto no es cierto para todos los tipos de programas BPF).
La disponibilidad de tales capacidades hace que BPF sea una herramienta universal para extender el núcleo, lo que se confirma en la práctica: se están agregando cada vez más nuevos tipos de programas a BPF, más grandes empresas utilizan BPF en servidores de producción 24×7, y más startups construyen su negocio sobre soluciones basadas en BPF. BPF se utiliza en todas partes: en la protección contra ataques DDoS, en la creación de SDN (por ejemplo, implementaciones de redes para kubernetes), como la herramienta principal para el rastreo de sistemas y la recopilación de estadísticas, en sistemas de detección de intrusiones y en sistemas de sandbox, etc.
Termine la parte de introducción del artículo y echemos un vistazo a la máquina virtual y al ecosistema de BPF con más detalle.
Nota: utilidades
Para poder ejecutar los ejemplos de las secciones siguientes, puede que necesite una cierta cantidad de utilidades, como mínimo llvm/clang con soporte para bpf y bpftool. En la sección puede leer las instrucciones sobre cómo compilar utilidades, así como su propio núcleo. Esta sección se coloca más abajo para no interrumpir la fluidez de nuestra exposición.
Registros y sistema de instrucciones de la máquina virtual BPF
La arquitectura y el sistema de comandos BPF se diseñaron teniendo en cuenta que los programas se escribirían en lenguaje C y, tras ser cargados en el núcleo, se traducirían a código nativo. Por lo tanto, el número de registros y el conjunto de instrucciones se eligieron considerando la intersección, en el sentido matemático, de las capacidades de las máquinas modernas. Además, se imponían diversos tipos de restricciones a los programas; por ejemplo, hasta hace poco no era posible escribir bucles y subprogramas, y el número de instrucciones estaba limitado a 4096 (ahora, a los programas privilegiados se les permite cargar hasta un millón de instrucciones).
En BPF hay once registros de 64 bits disponibles para el usuario. r0—r10 y un contador de instrucciones (program counter). El registro r10 contiene un puntero al stack (frame pointer) y es de solo lectura. Durante la ejecución, los programas tienen acceso a un stack de 512 bytes y a una cantidad ilimitada de memoria compartida en forma de maps.
A los programas BPF se les permite ejecutar un conjunto de funciones auxiliares (kernel helpers) definido de acuerdo con el tipo de programa y, desde hace poco, funciones normales. Cada función llamada puede aceptar hasta cinco argumentos, que se pasan en los registros r1—r5, y el valor retornado se pasa a r0. Se garantiza que, tras volver de la función, el contenido de los registros r6—r9 no cambiará.
Para la traducción efectiva de programas, los registros r0—r11 se asignan de manera inequívoca a los registros reales en todas las arquitecturas soportadas, teniendo en cuenta las particularidades del ABI de la arquitectura actual. Por ejemplo, para x86_64 los registros r1—r5, que se utilizan para pasar parámetros a las funciones, se asignan a rdi, rsi, rdx, rcx, r8, que se utilizan para pasar parámetros a las funciones en x86_64. Por ejemplo, el código a la izquierda se traduce al código de la derecha de la siguiente manera:
1:  (b7) r1 = 1                    mov    $0x1,%rdi
2:  (b7) r2 = 2                    mov    $0x2,%rsi
3:  (b7) r3 = 3                    mov    $0x3,%rdx
4:  (b7) r4 = 4                    mov    $0x4,%rcx
5:  (b7) r5 = 5                    mov    $0x5,%r8
6:  (85) call pc+1                 callq  0x0000000000001ee8
El registro r0 también se utiliza para devolver el resultado de la ejecución del programa; mientras que en el registro r1 se pasa un puntero al contexto en el programa; dependiendo del tipo de programa, esto puede ser, por ejemplo, la estructura (para XDP) o la estructura (para varios programas de red) o la estructura (para diferentes tipos de programas de tracing), etc.
Así que teníamos un conjunto de registros, ayudantes del kernel, una pila, un puntero al contexto y memoria compartida en forma de maps. No es que todo esto fuera absolutamente necesario en el viaje, pero...
Continuemos con la descripción y hablemos sobre el conjunto de instrucciones para trabajar con estos objetos. Todas () las instrucciones BPF tienen un tamaño fijo de 64 bits. Si miras una instrucción en una máquina Big Endian de 64 bits, verás

Aquí Código — esta es la codificación de la instrucción, Dst/Src — son las codificaciones del receptor y del origen, respectivamente, Desactivado — 16 bits de desplazamiento con signo, y Imm — es un número entero con signo de 32 bits, utilizado en algunos comandos (análogo a la constante K de cBPF). La codificación Código tiene uno de dos tipos:
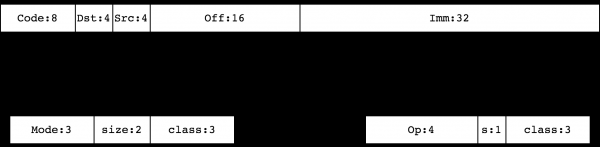
Las clases de instrucciones 0, 1, 2, 3 definen los comandos para trabajar con la memoria. Se les llama , BPF_LDX, BPF_ST, BPF_STX, , respectivamente. Las clases 4, 7 (BPF_ALUBPF_ALU64, ) constituyen un conjunto de instrucciones ALU. Las clases 5, 6 (BPF_JMPBPF_JMP32, ) incluyen instrucciones de salto.El plan para continuar estudiando el conjunto de instrucciones BPF es el siguiente: en lugar de enumerar meticulosamente todas las instrucciones y sus parámetros, analizaremos un par de ejemplos en esta sección, y de ellos quedará claro cómo están realmente estructuradas las instrucciones y cómo desensamblar manualmente cualquier archivo binario para BPF. Para reforzar el contenido, más adelante en el artículo también encontraremos instrucciones individuales en las secciones sobre Verifier, compilador JIT, traducción de BPF clásico, así como al estudiar maps, llamadas a funciones, etc.
Cuando hablemos de instrucciones individuales, nos referiremos a los archivos del kernel
bpf.h y Especificación eBPF no oficial , , Ejemplo: desensamblando BPF mentalmente
Analicemos un ejemplo donde compilaremos el programa
readelf-example.c y observaremos el binario resultante. Revelaremos el contenido original más abajo, después de restablecer su lógica a partir de los códigos binarios: y observaremos el binario resultante. Revelaremos el contenido original $ clang -target bpf -c readelf-example.c -o readelf-example.o -O2 $ llvm-readelf -x .text readelf-example.o Hex dump of section '.text': 0x00000000 b7000000 01000000 15010100 00000000 ................ 0x00000010 b7000000 02000000 95000000 00000000 ................
$ clang -target bpf -c readelf-example.c -o readelf-example.o -O2
$ llvm-readelf -x .text readelf-example.o
Volcado hexadecimal de la sección '.text':
0x00000000 b7000000 01000000 15010100 00000000 ................
0x00000010 b7000000 02000000 95000000 00000000 ................
La primera columna en la salida readelf — es un sangrado y nuestro programa, por lo tanto, consta de cuatro comandos:
Código Dst Src Off  Imm
b7   0   0   0000 01000000
15   0   1   0100 00000000
b7   0   0   0000 02000000
95   0   0   0000 00000000
Los códigos de comando son iguales b7, 15, b7 y 95. Recordemos que los tres bits menos significativos son la clase de instrucción. En nuestro caso, el cuarto bit de todas las instrucciones está vacío, por lo que las clases de instrucciones son iguales, respectivamente, 7, 5, 7, 5. La clase 7 es ) constituyen un conjunto de instrucciones ALU. Las clases 5, 6 (, y 5 es BPF_JMP32. Para ambas clases, el formato de la instrucción es el mismo (ver arriba) y podemos reescribir nuestro programa así (también reescribiremos las otras columnas de manera más comprensible):
Op S  Clase   Dst Src Off  Imm
b  0  ALU64   0   0   0    1
1  0  JMP     0   1   1    0
b  0  ALU64   0   0   0    2
9  0  JMP     0   0   0    0
Operación b de la clase ALU64 — es . Asigna un valor al registro receptor. Si el bit está establecido s (source), entonces el valor se toma del registro fuente, y si, como en nuestro caso, no está establecido, el valor se toma del campo Imm. Así, en la primera y tercera instrucciones realizamos la operación r0 = Imm. A continuación, la operación 1 de la clase JMP es (saltar si es igual). En nuestro caso, dado que el bit S es igual a cero, compara el valor del registro fuente con el campo Imm. Si los valores coinciden, la transición ocurre en PC + Off, donde PC, como suele ser, contiene la dirección de la siguiente instrucción. Finalmente, la operación 9 de la clase JMP es . Esta instrucción finaliza la ejecución del programa, devolviendo al núcleo r0. Agreguemos una nueva columna a nuestra tabla:
Op    S  Clase   Dst Src Off  Imm    Desensamblar
MOV   0  ALU64   0   0   0    1      r0 = 1
JEQ   0  JMP     0   1   1    0      si (r1 == 0) ir a pc+1
MOV   0  ALU64   0   0   0    2      r0 = 2
EXIT  0  JMP     0   0   0    0      salir
Podemos reescribir esto de una manera más conveniente:
     r0 = 1
     si (r1 == 0) ir a FIN
     r0 = 2
FIN:
     salir
Si recordamos que en el registro r1 se pasa un puntero al contexto desde el núcleo, y en el registro r0 se devuelve un valor al núcleo, podemos ver que si el puntero al contexto es cero, devolvemos 1, y de lo contrario — 2. Verifiquemos que estamos en lo correcto, observando el código fuente:
$ cat readelf-example.c
int foo(void *ctx)
{
        return ctx ? 2 : 1;
}
Sí, es un programa sin sentido, pero se traduce en solo cuatro simples instrucciones.
Ejemplo - excepción: instrucción de 16 bytes
Mencionamos anteriormente que algunas instrucciones ocupan más de 64 bits. Esto se refiere, por ejemplo, a la instrucción lddw (Código = 0x18 = | | ) — cargar en el registro una doble palabra de los campos Imm. El hecho es que Imm tiene un tamaño de 32, y una palabra doble — 64 bits, por lo que no se puede cargar un valor inmediato de 64 bits en un registro en una sola instrucción de 64 bits. Para esto, se utilizan dos instrucciones adyacentes para almacenar la segunda parte del valor de 64 bits en el campo Imm. Ejemplo:
$ cat x64.c
long foo(void *ctx)
{
        return 0x11223344aabbccdd;
}
$ clang -target bpf -c x64.c -o x64.o -O2
$ llvm-readelf -x .text x64.o
Hex dump of section '.text':
0x00000000 18000000 ddccbbaa 00000000 44332211 ............D3".
0x00000010 95000000 00000000                   ........
En el programa binario hay solo dos instrucciones:
Binary                                 Disassm
18000000 ddccbbaa 00000000 44332211    r0 = Imm[0]|Imm[1]
95000000 00000000                      exit
También nos encontraremos con la instrucción lddw, cuando hablemos sobre reubicaciones y el trabajo con maps.
Ejemplo: desensamblamos BPF con herramientas estándar
Así que hemos aprendido a leer códigos binarios BPF y estamos listos para descomponer cualquier instrucción si es necesario. Sin embargo, vale la pena mencionar que en la práctica es más conveniente y rápido desensamblar programas utilizando herramientas estándar, por ejemplo:
$ llvm-objdump -d x64.o

Disassembly of section .text:

0000000000000000 :
 0: 18 00 00 00 dd cc bb aa 00 00 00 00 44 33 22 11 r0 = 1234605617868164317 ll
 2: 95 00 00 00 00 00 00 00 exit
Ciclo de vida de los objetos BPF, sistema de archivos bpffs
(Algunos detalles que se describen en esta subsección, los aprendí por primera vez de Alexei Starovoitov en .)
Los objetos BPF — programas y maps — se crean desde el espacio de usuario utilizando los comandos BPF_PROG_LOAD y BPF_MAP_CREATE de la llamada al sistema bpf(2), hablaremos sobre cómo ocurre esto en la siguiente sección. Al mismo tiempo, se crean estructuras de datos del núcleo y para cada una de ellas refcount (contador de referencias) se establece en uno, y se devuelve al usuario un descriptor de archivo que apunta al objeto. Después de cerrar el descriptor refcount el objeto disminuye en uno, y al llegar a cero, el objeto se destruye.
Si el programa utiliza maps, entonces refcount el número de estos maps aumenta en uno después de cargar el programa, es decir, sus descriptores de archivo se pueden cerrar desde el proceso de usuario y a la vez refcount no se convertirá en cero:
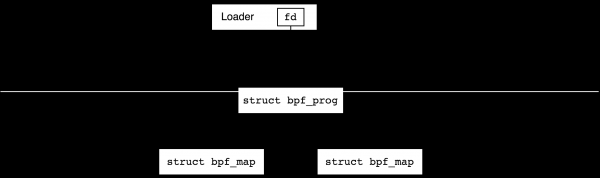
Después de que el programa se carga con éxito, normalmente lo unimos a algún generador de eventos. Por ejemplo, podemos conectarlo a una interfaz de red para procesar paquetes entrantes o conectarlo a algún tracepoint en el núcleo. En este momento, el contador de referencias también aumentará en uno y podremos cerrar el descriptor de archivo en el programa de carga.
¿Qué sucederá si ahora finalizamos el trabajo del cargador? Depende del tipo de generador de eventos (hook). Todos los hooks de red existirán después de finalizar el cargador, estos son, los llamados, hooks globales. En cambio, por ejemplo, los programas de trazado serán liberados después de finalizar el proceso que los creó (por lo tanto, se les llama locales, de 'local to the process'). Técnicamente, los hooks locales siempre tienen un descriptor de archivo correspondiente en el espacio del usuario y, por lo tanto, se cierran con el cierre del proceso, mientras que los globales no. En la siguiente imagen trato de mostrar con cruces rojas cómo la finalización del programa cargador afecta la vida de los objetos en el caso de hooks locales y globales.
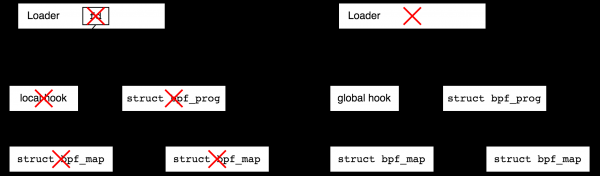
¿Por qué existe la división en hooks locales y globales? La ejecución de algunos tipos de programas de red tiene sentido incluso sin userspace, por ejemplo, imagine la protección contra DDoS: el cargador establece reglas y conecta el programa BPF a la interfaz de red, después de lo cual el cargador puede terminar y cerrarse. Por otro lado, imagina un programa de depuración de trazado que escribiste en diez minutos: después de que finalice, querrías que no quedara basura en el sistema, y los hooks locales garantizan eso.
Por otro lado, imagina que deseas conectarte a un tracepoint en el núcleo y recopilar estadísticas durante muchos años. En este caso, te gustaría finalizar la parte del usuario y regresar a las estadísticas de vez en cuando. Esta posibilidad es proporcionada por el sistema de archivos bpf. Es un sistema de archivos pseudo, que existe solo en memoria, que permite crear archivos que hacen referencia a objetos BPF y, de este modo, aumentan refcount la vida de los objetos. Después de eso, el cargador puede finalizar, y los objetos que creó permanecerán vivos.
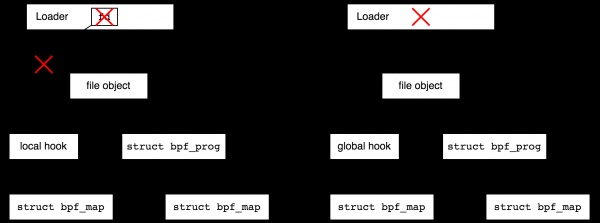
La creación de archivos en bpffs, que hacen referencia a objetos BPF, se llama 'fijación' ('pin', como en la siguiente frase: 'el proceso puede fijar un programa BPF o un mapa'). La creación de objetos de archivo para objetos BPF no solo tiene sentido para prolongar la vida de los objetos locales, sino también para la conveniencia de usar objetos globales: volviendo al ejemplo del programa global de protección contra DDoS, queremos tener la capacidad de venir de vez en cuando y mirar las estadísticas.
El sistema de archivos BPF generalmente se monta en /sys/fs/bpf, pero también se puede montar localmente, por ejemplo, así:
$ mkdir bpf-mountpoint
$ sudo mount -t bpf none bpf-mountpoint
Los nombres en el sistema de archivos se crean mediante el comando BPF_OBJ_PIN de la llamada al sistema BPF. Para ilustrar, tomemos un programa, compilémoslo, cárguémoslo y lo fijemos en bpffs. Nuestro programa no hace nada útil, proporcionamos su código solo para que puedas reproducir el ejemplo:
$ cat test.c
__attribute__((section("xdp"), used))
int test(void *ctx)
{
        return 0;
}

char _license[] __attribute__((section("license"), used)) = "GPL";
Compilaremos este programa y crearemos una copia local del sistema de archivos bpffs:
$ clang -target bpf -c test.c -o test.o
$ mkdir bpf-mountpoint
$ sudo mount -t bpf none bpf-mountpoint
Ahora cargaremos nuestro programa utilizando la utilidad bpftool y observaremos las llamadas al sistema correspondientes bpf(2) (se han eliminado algunas líneas no relacionadas de la salida de strace):
$ sudo strace -e bpf bpftool prog load .\/test.o bpf-mountpoint\/test
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, prog_name="test", ...}, 120) = 3
bpf(BPF_OBJ_PIN, {pathname="bpf-mountpoint\/test", bpf_fd=3}, 120) = 0
Aquí cargamos el programa utilizando BPF_PROG_LOAD, obtuvimos un descriptor de archivo del núcleo 3 y mediante el comando BPF_OBJ_PIN fijamos este descriptor de archivo como un archivo "bpf-mountpoint\/test". Después de esto, el programa cargador bpftool terminó su trabajo, pero nuestro programa permaneció en el núcleo, aunque no lo adjuntamos a ninguna interfaz de red:
$ sudo bpftool prog | tail -3
783: xdp  name test  tag 5c8ba0cf164cb46c  gpl
        loaded_at 2020-05-05T13:27:08+0000  uid 0
        xlated 24B  jited 41B  memlock 4096B
Podemos eliminar el objeto de archivo con el comando unlink(2) y después de esto, el programa correspondiente será eliminado:
$ sudo rm .\/bpf-mountpoint\/test
$ sudo bpftool prog show id 783
Error: get by id (783): No such file or directory
Eliminación de objetos
Al hablar de la eliminación de objetos, es importante aclarar que una vez que hemos desconectado el programa del gancho (generador de eventos), ningún nuevo evento provocará su ejecución, sin embargo, todas las instancias actuales del programa se cerrarán de manera ordenada.
Algunos tipos de programas BPF permiten reemplazar el programa sobre la marcha, es decir, proporcionan la atomicidad de la secuencia replace = detach old program, attach new program. Con esto, todas las instancias activas de la versión anterior del programa terminarán su trabajo, y se crearán nuevos controladores de eventos a partir del nuevo programa, y la "atomicidad" aquí significa que ningún evento será perdido.
Conectar programas a fuentes de eventos
En este artículo no vamos a describir por separado la conexión de programas a fuentes de eventos, ya que tiene sentido estudiarlo en el contexto de un tipo específico de programa. Véase a continuación, donde mostramos cómo se conectan programas del tipo XDP.
Gestión de objetos mediante la llamada al sistema bpf
Programas BPF
Todos los objetos BPF se crean y gestionan desde el espacio de usuario mediante la llamada al sistema bpf, que tiene el siguiente prototipo:
#include <linux/bpf.h>

int bpf(int cmd, union bpf_attr *attr, unsigned int size);
Aquí, el comando cmd es uno de los valores del tipo , attr — un puntero a los parámetros para un programa específico y tamaño — el tamaño del objeto apuntado, es decir, generalmente es sizeof(*attr). En el núcleo 5.8, la llamada al sistema bpf soporta 34 comandos diferentes, y union bpf_attr ocupa 200 líneas. Pero esto no debería asustarnos, ya que nos familiarizaremos con los comandos y parámetros a lo largo de varios artículos.
Comenzaremos con el comando BPF_PROG_LOAD, que crea programas BPF: toma un conjunto de instrucciones BPF y lo carga en el núcleo. En el momento de la carga, se inicia el verificador, luego el compilador JIT y, después de una ejecución exitosa, se devuelve al usuario un descriptor de archivo del programa. Hemos visto lo que sucede después en la sección anterior .
Ahora escribiremos un programa de usuario que cargará un programa BPF simple, pero primero necesitamos decidir qué tipo de programa queremos cargar — deberemos elegir y dentro de este tipo, escribir un programa que pase la verificación en el verificador. Sin embargo, para no complicar el proceso, aquí hay una solución lista: tomaremos un programa del tipo BPF_PROG_TYPE_XDP, que devolverá el valor XDP_PASS (pasar todos los paquetes). En assembler BPF, esto se ve muy simple:
r0 = 2
exit
Una vez que hemos decidido qué que cargaremos, podemos explicar cómo lo haremos:
#define _GNU_SOURCE
#include <string.h>
#include <unistd.h>
#include <sys/syscall.h>
#include <linux/bpf.h>

static inline __u64 ptr_to_u64(const void *ptr)
{
        return (__u64) (unsigned long) ptr;
}

int main(void)
{
    struct bpf_insn insns[] = {
        {
            .code = BPF_ALU64 | BPF_MOV | BPF_K,
            .dst_reg = BPF_REG_0,
            .imm = XDP_PASS
        },
        {
            .code = BPF_JMP | BPF_EXIT
        },
    };

    union bpf_attr attr = {
        .prog_type = BPF_PROG_TYPE_XDP,
        .insns     = ptr_to_u64(insns),
        .insn_cnt  = sizeof(insns)/sizeof(insns[0]),
        .license   = ptr_to_u64("GPL"),
    };

    strncpy(attr.prog_name, "woo", sizeof(attr.prog_name));
    syscall(__NR_bpf, BPF_PROG_LOAD, &attr, sizeof(attr));

    for ( ;; )
        pause();
}
Los eventos interesantes en el programa comienzan con la definición de un array insns — nuestro programa BPF en códigos máquina. En este caso, cada instrucción del programa BPF se empaqueta en una estructura El primer elemento insns corresponde a la instrucción r0 = 2, el segundo — exit.
Una digresión. En el núcleo se han definido macros más convenientes para escribir códigos máquina, y, utilizando el archivo de encabezado del núcleo tools/include/linux/filter.h podríamos escribir
struct bpf_insn insns[] = {
    BPF_MOV64_IMM(BPF_REG_0, XDP_PASS),
    BPF_EXIT_INSN()
};
Sin embargo, dado que escribir programas BPF en código de máquina solo es necesario para escribir pruebas en el núcleo y artículos sobre BPF, la ausencia de estos macros en realidad no complica la vida del desarrollador.
Después de definir el programa BPF, pasamos a cargarlo en el núcleo. Nuestro conjunto minimalista de parámetros attr incluye el tipo de programa, el conjunto y la cantidad de instrucciones, la licencia obligatoria, así como el nombre "woo", que utilizamos para encontrar nuestro programa en el sistema después de la carga. El programa, como se prometió, se carga en el sistema mediante una llamada al sistema bpf.
Al final del programa, entramos en un bucle infinito que simula la carga útil. Sin él, el núcleo destruiría el programa al cerrar el descriptor de archivo que nos devolvió la llamada al sistema bpf, y no lo veríamos en el sistema.
Bueno, estamos listos para la prueba. Compilaremos y ejecutaremos el programa bajo strace, para verificar que todo funcione como debería:
$ clang -g -O2 simple-prog.c -o simple-prog

$ sudo strace .\/simple-prog
execve(".\/simple-prog", [".\/simple-prog"], 0x7ffc7b553480 /* 13 vars */) = 0
...
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=2, insns=0x7ffe03c4ed50, license="GPL", log_level=0, log_size=0, log_buf=NULL, kern_version=KERNEL_VERSION(0, 0, 0), prog_flags=0, prog_name="woo", prog_ifindex=0, expected_attach_type=BPF_CGROUP_INET_INGRESS}, 72) = 3
pause(
Todo en orden, bpf(2) nos devolvió el descriptor 3 y entramos en un bucle infinito con pause(). Vamos a intentar encontrar nuestro programa en el sistema. Para ello, iremos a otra terminal y utilizaremos la utilidad bpftool:
# bpftool prog | grep -A3 woo
390: xdp  name woo  tag 3b185187f1855c4c  gpl
        loaded_at 2020-08-31T24:66:44+0000  uid 0
        xlated 16B  jited 40B  memlock 4096B
        pids simple-prog(10381)
Vemos que hay un programa cargado en el sistema woo cuyo ID global es 390, y que en este momento el proceso simple-prog tiene un descriptor de archivo abierto que apunta al programa (y si simple-prog finaliza, entonces woo desaparecerá). Como se esperaba, el programa woo ocupa 16 bytes — dos instrucciones — de códigos binarios en la arquitectura BPF, pero en forma nativa (x86_64) son ya 40 bytes. Vamos a ver nuestro programa en su forma original:
# bpftool prog dump xlated id 390
   0: (b7) r0 = 2
   1: (95) exit
sin sorpresas. Ahora miremos el código generado por el compilador JIT:
# bpftool prog dump jited id 390
bpf_prog_3b185187f1855c4c_woo:
   0:   nopl   0x0(%rax,%rax,1)
   5:   push   %rbp
   6:   mov    %rsp,%rbp
   9:   sub    $0x0,%rsp
  10:   push   %rbx
  11:   push   %r13
  13:   push   %r14
  15:   push   %r15
  17:   pushq  $0x0
  19:   mov    $0x2,%eax
  1e:   pop    %rbx
  1f:   pop    %r15
  21:   pop    %r14
  23:   pop    %r13
  25:   pop    %rbx
  26:   leaveq
  27:   retq
no es muy eficiente para exit(2), pero en justicia, nuestro programa es demasiado simple, y para programas no triviales, el prólogo y el epílogo, añadidos por el compilador JIT, son, por supuesto, necesarios.
Maps
Los programas BPF pueden utilizar áreas de memoria estructuradas, accesibles tanto para otros programas BPF como para programas del espacio de usuario. Estos objetos se llaman maps y en esta sección mostraremos cómo gestionarlos mediante llamadas al sistema. bpf.
Dicho esto, las capacidades de los maps no se limitan solo al acceso a la memoria compartida. Existen maps de propósito especial que contienen, por ejemplo, punteros a programas BPF o punteros a interfaces de red, maps para trabajar con eventos de perf, etc. Aquí no hablaremos de ellos para no confundir al lector. Además, ignoraremos los problemas de sincronización, ya que no son relevantes para nuestros ejemplos. Se puede encontrar una lista completa de los tipos de maps disponibles en , y en esta sección tomaremos como ejemplo el primer tipo históricamente, la tabla hash. BPF_MAP_TYPE_HASH.
Si estuvieras creando una tabla hash, digamos, en C++, dirías unordered_map woo, que en español significa 'necesito una tabla woo de tamaño ilimitado, donde las claves son del tipo int, y los valores son del tipo long'. Para crear una tabla hash BPF debemos hacer algo similar, con la salvedad de que deberemos especificar el tamaño máximo de la tabla y, en lugar de los tipos de las claves y los valores, necesitamos indicar sus tamaños en bytes. Se utiliza el comando BPF_MAP_CREATE de la llamada al sistema bpf. Veamos un programa más o menos mínimo que crea un map. Después del programa anterior que carga programas BPF, este debería parecerte sencillo:
$ cat simple-map.c
#define _GNU_SOURCE
#include
#include
#include
#include

int main(void)
{
    union bpf_attr attr = {
        .map_type = BPF_MAP_TYPE_HASH,
        .key_size = sizeof(int),
        .value_size = sizeof(int),
        .max_entries = 4,
    };
    strncpy(attr.map_name, "woo", sizeof(attr.map_name));
    syscall(__NR_bpf, BPF_MAP_CREATE, &attr, sizeof(attr));

    for (;;)
        pause();
}
Aquí definimos un conjunto de parámetros attr, en los que decimos 'necesito una tabla hash con claves y valores del tamaño sizeof(int), en la que puedo colocar un máximo de cuatro elementos'. Al crear maps BPF también se pueden especificar otros parámetros, por ejemplo, al igual que en el ejemplo del programa, especificamos el nombre del objeto como "woo".
Compilaremos y ejecutaremos el programa:
$ clang -g -O2 simple-map.c -o simple-map
$ sudo strace ./simple-map
execve("./simple-map", ["./simple-map"], 0x7ffd40a27070 /* 14 vars */) = 0
...
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_HASH, key_size=4, value_size=4, max_entries=4, map_name="woo", ...}, 72) = 3
pause(
Aquí la llamada al sistema bpf(2) nos devolvió el descriptor del mapa número 3 y luego el programa, como se esperaba, espera más instrucciones en la llamada del sistema pause(2).
Ahora enviaremos nuestro programa al fondo o abriremos otra terminal y veremos nuestro objeto con la utilidad bpftool (podemos distinguir nuestro mapa de otros por su nombre):
$ sudo bpftool map
...
114: hash  name woo  flags 0x0
        key 4B  value 4B  max_entries 4  memlock 4096B
...
El número 114 es el ID global de nuestro objeto. Cualquier programa en el sistema puede usar este ID para abrir el mapa existente con el comando BPF_MAP_GET_FD_BY_ID de la llamada al sistema bpf.
Ahora podemos jugar con nuestra tabla hash. Echemos un vistazo a su contenido:
$ sudo bpftool map dump id 114
Found 0 elements
Está vacío. Vamos a poner un valor en ella hash[1] = 1:
$ sudo bpftool map update id 114 key 1 0 0 0 value 1 0 0 0Veamos la tabla una vez más:
$ sudo bpftool map dump id 114
key: 01 00 00 00  value: 01 00 00 00
Found 1 element
¡Hurra! Hemos logrado agregar un elemento. Tenga en cuenta que para esto tenemos que trabajar a nivel de bytes, ya que bpftool no sabe qué tipo tienen los valores en la tabla hash. (Se puede transmitir este conocimiento utilizando BTF, pero eso no es ahora.)
¿Cómo exactamente lee y agrega elementos bpftool? Miremos debajo del capó:
$ sudo strace -e bpf bpftool map dump id 114
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_MAP_GET_NEXT_KEY, {map_fd=3, key=NULL, next_key=0x55856ab65280}, 120) = 0
bpf(BPF_MAP_LOOKUP_ELEM, {map_fd=3, key=0x55856ab65280, value=0x55856ab652a0}, 120) = 0
key: 01 00 00 00  value: 01 00 00 00
bpf(BPF_MAP_GET_NEXT_KEY, {map_fd=3, key=0x55856ab65280, next_key=0x55856ab65280}, 120) = -1 ENOENT
Primero abrimos el mapa por su ID global usando el comando BPF_MAP_GET_FD_BY_ID y bpf(2) nos devolvió el descriptor 3. Luego, usando el comando BPF_MAP_GET_NEXT_KEY encontramos la primera clave en la tabla, pasando NULL como un puntero a la clave 'anterior'. Si hay una clave, podemos hacer BPF_MAP_LOOKUP_ELEM, que retorna el valor en el puntero value. El siguiente paso es intentar encontrar el siguiente elemento, pasando el puntero a la clave actual, pero nuestra tabla contiene solo un elemento y el comando BPF_MAP_GET_NEXT_KEY devuelve ENOENT.
Bien, cambiemos el valor de la clave 1, digamos que nuestra lógica de negocio requiere establecer hash[1] = 2:
$ sudo strace -e bpf bpftool map update id 114 key 1 0 0 0 value 2 0 0 0
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_MAP_UPDATE_ELEM, {map_fd=3, key=0x55dcd72be260, value=0x55dcd72be280, flags=BPF_ANY}, 120) = 0
Como se esperaba, es muy simple: el comando BPF_MAP_GET_FD_BY_ID abre nuestro mapa por ID, y el comando BPF_MAP_UPDATE_ELEM reescribe el elemento.
En resumen, después de crear una tabla hash de un programa, podemos leer y escribir su contenido desde otro. Tenga en cuenta que si hemos podido hacerlo desde la línea de comandos, cualquier otro programa en el sistema también puede. Además de los comandos descritos anteriormente, para trabajar con mapas desde el espacio de usuario están disponibles :
BPF_MAP_LOOKUP_ELEM: encontrar el valor por claveBPF_MAP_UPDATE_ELEM: actualizar/crear valorBPF_MAP_DELETE_ELEM: eliminar claveBPF_MAP_GET_NEXT_KEY: encontrar la siguiente (o primera) claveBPF_MAP_GET_NEXT_ID: permite recorrer todos los mapas existentes, así es como funcionabpftool mapBPF_MAP_GET_FD_BY_ID: abrir un mapa existente por su ID globalBPF_MAP_LOOKUP_AND_DELETE_ELEM: actualizar atómicamente el valor del objeto y devolver el antiguoBPF_MAP_FREEZE: hacer que el mapa sea inmutable desde el espacio de usuario (esta operación no se puede deshacer)BPF_MAP_LOOKUP_BATCH,BPF_MAP_LOOKUP_AND_DELETE_BATCH,BPF_MAP_UPDATE_BATCH,BPF_MAP_DELETE_BATCH: operaciones masivas. Por ejemplo,BPF_MAP_LOOKUP_AND_DELETE_BATCH— este es el único método confiable para leer y restablecer todos los valores de un mapa
No todos estos comandos funcionan para todos los tipos de mapas, pero en general, trabajar con otros tipos de mapas desde el espacio de usuario se ve exactamente igual que trabajar con tablas hash.
Para finalizar, completemos nuestros experimentos con la tabla hash. Recuerde que creamos una tabla que puede contener hasta cuatro claves. Agreguemos algunos elementos más:
$ sudo bpftool map update id 114 key 2 0 0 0 value 1 0 0 0
$ sudo bpftool map update id 114 key 3 0 0 0 value 1 0 0 0
$ sudo bpftool map update id 114 key 4 0 0 0 value 1 0 0 0
Hasta ahora todo bien:
$ sudo bpftool map dump id 114
key: 01 00 00 00  value: 01 00 00 00
key: 02 00 00 00  value: 01 00 00 00
key: 04 00 00 00  value: 01 00 00 00
key: 03 00 00 00  value: 01 00 00 00
Encontrados 4 elementos
Intentemos agregar uno más:
$ sudo bpftool map update id 114 key 5 0 0 0 value 1 0 0 0
Error: actualización fallida: lista de argumentos demasiado larga
Como se esperaba, no funcionó. Vamos a examinar el error más de cerca:
$ sudo strace -e bpf bpftool map update id 114 key 5 0 0 0 value 1 0 0 0
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_OBJ_GET_INFO_BY_FD, {info={bpf_fd=3, info_len=80, info=0x7ffe6c626da0}}, 120) = 0
bpf(BPF_MAP_UPDATE_ELEM, {map_fd=3, key=0x56049ded5260, value=0x56049ded5280, flags=BPF_ANY}, 120) = -1 E2BIG (lista de argumentos demasiado larga)
Error: actualización fallida: lista de argumentos demasiado larga
+++ salió con 255 +++
Todo está bien: como se esperaba, el comando BPF_MAP_UPDATE_ELEM intenta crear una nueva, quinta, clave, pero falla con E2BIG.
Así que sabemos cómo crear y cargar programas BPF, así como crear y gestionar mapas desde el espacio de usuario. Ahora es lógico ver cómo podemos utilizar mapas directamente desde los programas BPF. Podríamos hablar de esto con difícil lenguaje de programación en códigos máquina-mácaros, pero en realidad ha llegado el momento de mostrar cómo se escriben y mantienen los programas BPF de verdad — usando libbpf.
(Para los lectores insatisfechos con la falta de un ejemplo de bajo nivel: desglosaremos los programas que utilizan mapas y funciones auxiliares creadas con libbpf y explicaremos lo que sucede a nivel de instrucciones. Para los lectores insatisfechos con mucho, hemos añadido en el lugar correspondiente del artículo.)
Escribiendo programas BPF con libbpf
Escribir programas BPF usando códigos de máquina puede ser interesante solo al principio, pero luego llega la saturación. En ese momento, es necesario dirigir nuestra atención a llvm, que tiene un backend para la generación de código para la arquitectura BPF, así como a la biblioteca libbpf, que permite escribir la parte de usuario de las aplicaciones BPF y cargar el código de los programas BPF generados con llvm/clang.
En realidad, como veremos en este y en los artículos posteriores, libbpf hace bastante trabajo y sin él (o herramientas similares — iproute2, libbcc, libbpf-go, etc.) es imposible vivir. Una de las características clave del proyecto libbpf es BPF CO-RE (Compile Once, Run Everywhere) — un proyecto que permite escribir programas BPF portables de un núcleo a otro, con la posibilidad de ejecutarse en diferentes API (por ejemplo, cuando la estructura del núcleo cambia de una versión a otra). Para poder trabajar con CO-RE, su núcleo debe ser compilado con soporte para BTF (cómo hacerlo se explica en la sección . Puedes verificar fácilmente si tu núcleo está compilado con BTF o no, comprobando si existe el siguiente archivo:
$ ls -lh /sys/kernel/btf/vmlinux
-r--r--r-- 1 root root 2.6M Jul 29 15:30 /sys/kernel/btf/vmlinux
Este archivo contiene información sobre todos los tipos de datos utilizados en el núcleo y se usa en todos nuestros ejemplos que utilizan libbpf. Hablaremos detalladamente sobre CO-RE en el próximo artículo, pero en este — simplemente construye tu núcleo con CONFIG_DEBUG_INFO_BTF.
La biblioteca libbpf se encuentra directamente en el directorio tools/lib/bpf del núcleo y su desarrollo se lleva a cabo a través de la lista de correo bpf@vger.kernel.org. Sin embargo, para las aplicaciones que viven fuera del núcleo, se admite un repositorio separado donde la biblioteca del núcleo se refleja para acceso de lectura más o menos tal como está.
En esta sección veremos cómo crear un proyecto que utilice libbpf, escribiremos algunos (más o menos sin sentido) programas de prueba y explicaremos detalladamente cómo funciona todo esto. Esto nos permitirá, en secciones posteriores, explicar más fácilmente cómo interactúan los programas BPF con maps, kernel helpers, BTF, etc.
Generalmente, los proyectos que usan libbpf agregan el repositorio de GitHub como un submódulo de git, hagámoslo nosotros también:
$ mkdir /tmp/libbpf-example
$ cd /tmp/libbpf-example/
$ git init-db
Repositorio Git vacío inicializado en /tmp/libbpf-example/.git/
$ git submodule add https://github.com/libbpf/libbpf.git
Clonando en '/tmp/libbpf-example/libbpf'...
remoto: Enumerando objetos: 200, hecho.
remoto: Contando objetos: 100% (200/200), hecho.
remoto: Comprimiendo objetos: 100% (103/103), hecho.
remoto: Total 3354 (delta 101), reutilizado 118 (delta 79), pack-reused 3154
Recibiendo objetos: 100% (3354/3354), 2.05 MiB | 10.22 MiB/s, hecho.
Resolviendo deltas: 100% (2176/2176), hecho.
Se compila libbpf muy fácilmente:
$ cd libbpf/src
$ mkdir build
$ OBJDIR=build DESTDIR=root make -s install
$ find root
root
root/usr
root/usr/include
root/usr/include/bpf
root/usr/include/bpf/bpf_tracing.h
root/usr/include/bpf/xsk.h
root/usr/include/bpf/libbpf_common.h
root/usr/include/bpf/bpf_endian.h
root/usr/include/bpf/bpf_helpers.h
root/usr/include/bpf/btf.h
root/usr/include/bpf/bpf_helper_defs.h
root/usr/include/bpf/bpf.h
root/usr/include/bpf/libbpf_util.h
root/usr/include/bpf/libbpf.h
root/usr/include/bpf/bpf_core_read.h
root/usr/lib64
root/usr/lib64/libbpf.so.0.1.0
root/usr/lib64/libbpf.so.0
root/usr/lib64/libbpf.a
root/usr/lib64/libbpf.so
root/usr/lib64/pkgconfig
root/usr/lib64/pkgconfig/libbpf.pc
Nuestro plan a continuación en esta sección es el siguiente: escribiremos un programa BPF de tipo BPF_PROG_TYPE_XDP, el mismo que en el ejemplo anterior, pero en C, lo compilaremos usando clang, y escribiremos un programa auxiliar que lo cargará en el núcleo. En secciones posteriores ampliaremos las capacidades tanto del programa BPF como del programa auxiliar.
Ejemplo: creando una aplicación completa usando libbpf
Para empezar, utilizaremos el archivo /sys/kernel/btf/vmlinux, mencionado anteriormente, y crearemos su equivalente en forma de archivo de encabezado:
$ bpftool btf dump file /sys/kernel/btf/vmlinux format c > vmlinux.hEste archivo contendrá todas las estructuras de datos que existen en nuestro núcleo, por ejemplo, así se define el encabezado IPv4 en el núcleo:
$ grep -A 12 'struct iphdr {' vmlinux.h
struct iphdr {
    __u8 ihl: 4;
    __u8 version: 4;
    __u8 tos;
    __be16 tot_len;
    __be16 id;
    __be16 frag_off;
    __u8 ttl;
    __u8 protocol;
    __sum16 check;
    __be32 saddr;
    __be32 daddr;
};
Ahora escribiremos nuestro programa BPF en lenguaje C:
$ cat xdp-simple.bpf.c
#include "vmlinux.h"
#include

SEC("xdp/simple")
int simple(void *ctx)
{
        return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
Aunque nuestro programa es muy simple, aún debemos prestar atención a muchos detalles. En primer lugar, el primer archivo de encabezado que incluimos es vmlinux.h, que acabamos de generar usando bpftool btf dump — ahora no necesitamos instalar el paquete kernel-headers para saber cómo se ven las estructuras del núcleo. El siguiente archivo de encabezado proviene de la biblioteca libbpf. Ahora lo necesitamos solo para que el macro SEC, que envía un símbolo a la sección correspondiente del archivo objeto ELF, se defina. Nuestro programa se encuentra en la sección xdp/simple, donde antes de la barra inclinada definimos el tipo de programa BPF — este es un acuerdo utilizado en libbpf, según el nombre de la sección, automáticamente asignará el tipo correcto al ejecutarlo bpf(2). El propio programa BPF en C — es muy simple y consta de una sola línea return XDP_PASS. Finalmente, una sección separada "license" contiene el nombre de la licencia.
Podemos compilar nuestro programa usando llvm/clang, versión >= 10.0.0, o mejor, una versión más reciente (ver sección ):
$ clang --version
clang version 11.0.0 (https://github.com/llvm/llvm-project.git afc287e0abec710398465ee1f86237513f2b5091)
...

$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
De las características interesantes: especificamos la arquitectura objetivo -target bpf y la ruta a los encabezados libbpf, que acabamos de instalar. Además, no se olvide de -O2, sin esta opción puede haber sorpresas más adelante. Vamos a ver nuestro código, ¿hemos logrado escribir el programa que queríamos?
$ llvm-objdump --section=xdp/simple --no-show-raw-insn -D xdp-simple.bpf.o

xdp-simple.bpf.o:       file format elf64-bpf

Desensamblado de la sección xdp/simple:

0000000000000000 :
       0:       r0 = 2
       1:       exit
¡Sí, lo logramos! Ahora tenemos un archivo binario con el programa, y queremos crear una aplicación que lo cargue en el núcleo. Para esto, la biblioteca libbpf nos ofrece dos opciones: usar una API de bajo nivel o una API de alto nivel. Tomaremos el segundo camino, ya que queremos aprender a escribir, cargar y conectar programas BPF con el menor esfuerzo para su estudio posterior.
Para comenzar, necesitamos generar el «esqueleto» de nuestro programa a partir de su binario usando la misma utilidad. bpftool — el cuchillo suizo del mundo BPF (lo cual se puede entender casi literalmente, ya que Daniel Borkman — uno de los creadores y mantenedores de BPF — es suizo):
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.hEn el archivo xdp-simple.skel.h contiene el código binario de nuestro programa y funciones para gestionar — cargar, adjuntar, eliminar nuestro objeto. En nuestro caso simple, esto parece excesivo, pero funciona también cuando el archivo objeto contiene muchos programas BPF y mapas, y para cargar este enorme ELF solo necesitamos generar un esqueleto y llamar a una o dos funciones desde la aplicación de usuario, a la cual ahora pasaremos a escribir.
En realidad, nuestro programa cargador es trivial:
#include <err.h>
#include <unistd.h>
#include "xdp-simple.skel.h"

int main(int argc, char **argv)
{
    struct xdp_simple_bpf *obj;

    obj = xdp_simple_bpf__open_and_load();
    if (!obj)
        err(1, "failed to open and/or load BPF objectn");

    pause();

    xdp_simple_bpf__destroy(obj);
}
Aquí struct xdp_simple_bpf se define en el archivo xdp-simple.skel.h y describe nuestro archivo objeto:
struct xdp_simple_bpf {
    struct bpf_object_skeleton *skeleton;
    struct bpf_object *obj;
    struct {
        struct bpf_program *simple;
    } progs;
    struct {
        struct bpf_link *simple;
    } links;
};
Podemos notar aquí rastros de la API de bajo nivel: la estructura struct bpf_program *simple y struct bpf_link *simple. La primera estructura describe específicamente nuestro programa, escrito en la sección xdp/simple, y la segunda — describe cómo el programa se conecta a la fuente de eventos.
La función xdp_simple_bpf__open_and_load, abre el objeto ELF, lo analiza, crea todas las estructuras y subestructuras (además del programa, el ELF contiene otras secciones — datos, datos de solo lectura, información de depuración, licencia, etc.), y luego lo carga en el núcleo mediante una llamada al sistema bpf, lo que podemos comprobar compilando y ejecutando el programa:
$ clang -O2 -I ./libbpf/src/root/usr/include/ xdp-simple.c -o xdp-simple ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz

$ sudo strace -e bpf ./xdp-simple
...
bpf(BPF_BTF_LOAD, 0x7ffdb8fd9670, 120)  = 3
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=2, insns=0xdfd580, license="GPL", log_level=0, log_size=0, log_buf=NULL, kern_version=KERNEL_VERSION(5, 8, 0), prog_flags=0, prog_name="simple", prog_ifindex=0, expected_attach_type=0x25 /* BPF_??? */, ...}, 120) = 4
Ahora veamos nuestro programa usando bpftool. Encontraremos su ID:
# bpftool p | grep -A4 simple
463: xdp  name simple  tag 3b185187f1855c4c  gpl
        loaded_at 2020-08-01T01:59:49+0000  uid 0
        xlated 16B  jited 40B  memlock 4096B
        btf_id 185
        pids xdp-simple(16498)
y lo volcaremos (usamos la forma abreviada del comando bpftool prog dump xlated):
# bpftool p d x id 463
int simple(void *ctx):
; return XDP_PASS;
   0: (b7) r0 = 2
   1: (95) exit
¡Algo nuevo! El programa imprimió trozos de nuestro archivo fuente en C. Esto fue realizado por la biblioteca libbpf, que encontró la sección de depuración en el binario, la compiló en un objeto BTF, la cargó en el núcleo mediante BPF_BTF_LOAD, y luego proporcionó el descriptor de archivo obtenido al cargar el programa con el comando BPG_PROG_LOAD.
Kernel Helpers
Los programas BPF pueden ejecutar funciones "externas"—ayudantes del núcleo. Estas funciones ayudantes permiten que los programas BPF accedan a estructuras del núcleo, gestionen mapas y se comuniquen con el "mundo real"—creando eventos de rendimiento, gestionando hardware (por ejemplo, redirigiendo paquetes), etc.
Ejemplo: bpf_get_smp_processor_id
En el marco de la paradigma "aprendemos con ejemplos", consideremos una de las funciones ayudantes, bpf_get_smp_processor_id(), en el archivo kernel/bpf/helpers.c. Devuelve el número del procesador en el que se ejecuta el programa BPF que la invoca. Pero no nos interesa tanto su semántica como el hecho de que su implementación ocupa una línea:
BPF_CALL_0(bpf_get_smp_processor_id)
{
    return smp_processor_id();
}
Las definiciones de funciones ayudantes BPF son similares a las definiciones de llamadas de sistema en Linux. Aquí, por ejemplo, se define una función sin argumentos. (Una función que acepta, digamos, tres argumentos, se define utilizando el macro BPF_CALL_3. El número máximo de argumentos es cinco.) Sin embargo, esta es solo la primera parte de la definición. La segunda parte consiste en la definición de una estructura del tipo struct bpf_func_proto, que contiene una descripción de la función ayudante comprensible para el verificador:
const struct bpf_func_proto bpf_get_smp_processor_id_proto = {
    .func     = bpf_get_smp_processor_id,
    .gpl_only = false,
    .ret_type = RET_INTEGER,
};
Registro de funciones ayudantes
Para que los programas BPF de un tipo determinado puedan usar esta función, deben registrarla, por ejemplo, para el tipo BPF_PROG_TYPE_XDP en el núcleo se define la función xdp_func_proto, que por ID de la función ayudante determina si XDP admite esta función o no. Nuestra función :
static const struct bpf_func_proto *
xdp_func_proto(enum bpf_func_id func_id, const struct bpf_prog *prog)
{
    switch (func_id) {
    ...
    case BPF_FUNC_get_smp_processor_id:
        return &bpf_get_smp_processor_id_proto;
    ...
    }
}
Nuevos tipos de programas BPF se "definen" en el archivo usando el macro BPF_PROG_TYPE. Se utiliza la palabra definida entre comillas, ya que es una definición lógica, y en términos del lenguaje C, la definición de un conjunto entero de estructuras específicas ocurre en otros lugares. En particular, en el archivo kernel/bpf/verifier.c todas las definiciones del archivo bpf_types.h se usan para crear un arreglo de estructuras bpf_verifier_ops[]:
static const struct bpf_verifier_ops *const bpf_verifier_ops[] = {
#define BPF_PROG_TYPE(_id, _name, prog_ctx_type, kern_ctx_type)
    [_id] = & _name ## _verifier_ops,
#include
#undef BPF_PROG_TYPE
};
Es decir, para cada tipo de programas BPF se define un puntero a una estructura de datos del tipo struct bpf_verifier_ops, que se inicializa con el valor _name ## _verifier_ops, o sea, xdp_verifier_ops para xdp. La estructura xdp_verifier_ops en el archivo net/core/filter.c de la siguiente manera:
const struct bpf_verifier_ops xdp_verifier_ops = {
    .get_func_proto     = xdp_func_proto,
    .is_valid_access    = xdp_is_valid_access,
    .convert_ctx_access = xdp_convert_ctx_access,
    .gen_prologue       = bpf_noop_prologue,
};
Aquí vemos nuestra función conocida xdp_func_proto, que se ejecutará cada vez que el verificador encuentre una llamada a alguna función dentro del programa BPF, véase .
Veamos cómo un programa BPF hipotético utiliza la función bpf_get_smp_processor_id. Para esto, reescribiremos el programa de nuestra sección anterior de la siguiente manera:
#include "vmlinux.h"
#include <bpf/bpf_helpers.h>

SEC("xdp/simple")
int simple(void *ctx)
{
    if (bpf_get_smp_processor_id() != 0)
        return XDP_DROP;
    return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
El símbolo bpf_get_smp_processor_id en <bpf/bpf_helper_defs.h> de la biblioteca libbpf cómo
static u32 (*bpf_get_smp_processor_id)(void) = (void *) 8;es decir, bpf_get_smp_processor_id — es un puntero a una función, cuyo valor es 8, donde 8 es el valor BPF_FUNC_get_smp_processor_id del tipo enum bpf_fun_id, que está definido para nosotros en el archivo vmlinux.h (el archivo bpf_helper_defs.h que se genera en el núcleo por un script, por lo que los números «mágicos» están bien). Esta función no toma argumentos y devuelve un valor del tipo __u32. Cuando la ejecutamos en nuestro programa, clang genera una instrucción BPF_CALL de «tipo correcto». Compilamos el programa y observamos la sección xdp/simple:
$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
$ llvm-objdump -D --section=xdp/simple xdp-simple.bpf.o

xdp-simple.bpf.o:       formato de archivo elf64-bpf

Desensamblaje de la sección xdp/simple:

0000000000000000 <simple>:
       0:       85 00 00 00 08 00 00 00 call 8
       1:       bf 01 00 00 00 00 00 00 r1 = r0
       2:       67 01 00 00 20 00 00 00 r1 <<= 32
       3:       77 01 00 00 20 00 00 00 r1 >>= 32
       4:       b7 00 00 00 02 00 00 00 r0 = 2
       5:       15 01 01 00 00 00 00 00 si r1 == 0 ir a +1 <LBB0_2>
       6:       b7 00 00 00 01 00 00 00 r0 = 1

0000000000000038 <LBB0_2>:
       7:       95 00 00 00 00 00 00 00 exit
En la primera línea ya vemos la instrucción call, el parámetro IMM que es igual a 8, y SRC_REG — cero. Según el convenio ABI utilizado por el verificador, esto es la llamada a la función de ayuda número ocho. Después de su ejecución, la lógica es simple. El valor devuelto del registro r0 se copia en r1 y en las líneas 2,3 se convierte al tipo u32 — los 32 bits superiores se anulan. En las líneas 4,5,6,7 devolvemos 2 (XDP_PASS) o 1 (XDP_DROP) dependiendo de si la función de ayuda de la línea 0 devolvió un valor nulo o no nulo.
Comprobemos: cargamos el programa y observamos la salida bpftool prog dump xlated:
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.h
$ clang -O2 -g -I ./libbpf/src/root/usr/include/ -o xdp-simple xdp-simple.c ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz
$ sudo ./xdp-simple &
[2] 10914

$ sudo bpftool p | grep simple
523: xdp  name simple  tag 44c38a10c657e1b0  gpl
        pids xdp-simple(10915)

$ sudo bpftool p d x id 523
int simple(void *ctx):
; if (bpf_get_smp_processor_id() != 0)
   0: (85) call bpf_get_smp_processor_id#114128
   1: (bf) r1 = r0
   2: (67) r1 <>= 32
   4: (b7) r0 = 2
; }
   5: (15) if r1 == 0x0 goto pc+1
   6: (b7) r0 = 1
   7: (95) exit
Bien, el verificador encontró el kernel-helper correcto.
Ejemplo: ¡pasemos los argumentos y finalmente ejecutemos el programa!
Todas las funciones helper en tiempo de ejecución tienen el siguiente prototipo
u64 fn(u64 r1, u64 r2, u64 r3, u64 r4, u64 r5)Los parámetros se pasan a las funciones helper en registros r1—r5, y el valor se devuelve en un registro r0. No hay funciones que acepten más de cinco argumentos y no se prevé añadir soporte para ellas en el futuro.
Veamos el nuevo helper del kernel y cómo BPF pasa los parámetros. Reescribamos xdp-simple.bpf.c de la siguiente manera (las otras líneas no cambiaron):
SEC("xdp/simple")
int simple(void *ctx)
{
    bpf_printk("ejecutándose en CPU%un", bpf_get_smp_processor_id());
    return XDP_PASS;
}
Nuestro programa imprime el número de CPU en el que se está ejecutando. Compilémoslo y veamos el código:
$ llvm-objdump -D --section=xdp/simple --no-show-raw-insn xdp-simple.bpf.o

0000000000000000 :
       0:       r1 = 10
       1:       *(u16 *)(r10 - 8) = r1
       2:       r1 = 8441246879787806319 ll
       4:       *(u64 *)(r10 - 16) = r1
       5:       r1 = 2334956330918245746 ll
       7:       *(u64 *)(r10 - 24) = r1
       8:       call 8
       9:       r1 = r10
      10:       r1 += -24
      11:       r2 = 18
      12:       r3 = r0
      13:       call 6
      14:       r0 = 2
      15:       exit
En las líneas 0-7 grabamos en la pila la cadena ejecutándose en CPU%un, y luego en la línea 8 ejecutamos nuestro familiar bpf_get_smp_processor_id. En las líneas 9-12 preparamos los argumentos del helper bpf_printk — registros r1, r2, r3. ¿Por qué son tres y no dos? Porque bpf_printk — el verdadero helper bpf_trace_printk, que requiere el tamaño de la cadena de formato.
Ahora añadamos un par de líneas a xdp-simple.c, para que nuestro programa se conecte a la interfaz lo y se ejecute realmente!
$ cat xdp-simple.c
#include
#include
#include
#include "xdp-simple.skel.h"

int main(int argc, char **argv)
{
    __u32 flags = XDP_FLAGS_SKB_MODE;
    struct xdp_simple_bpf *obj;

    obj = xdp_simple_bpf__open_and_load();
    if (!obj)
        err(1, "fallo al abrir y/o cargar el objeto BPFn");

    bpf_set_link_xdp_fd(1, -1, flags);
    bpf_set_link_xdp_fd(1, bpf_program__fd(obj->progs.simple), flags);

cleanup:
    xdp_simple_bpf__destroy(obj);
}
Aquí usamos la función bpf_set_link_xdp_fd, que conecta programas BPF de tipo XDP a interfaces de red. Hemos codificado el número de la interfaz lo, que siempre es igual a 1. Ejecutamos la función dos veces para desconectar la antigua aplicación, si estaba conectada. Observe que ahora no necesitamos la llamada pause o un ciclo infinito: nuestro programa cargador terminará su ejecución, pero la aplicación BPF no será destruida, ya que está conectada a la fuente de eventos. Después de una carga y conexión exitosas, el programa se ejecutará para cada paquete de red que llegue a lo.
Carguemos el programa y veamos la interfaz lo:
$ sudo ./xdp-simple
$ sudo bpftool p | grep simple
669: xdp  nombre simple  etiqueta 4fca62e77ccb43d6  gpl
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 669
El programa que hemos cargado tiene ID 669 y la misma ID la vemos en la interfaz lo. Enviaremos un par de paquetes a 127.0.0.1 (request + reply):
$ ping -c1 localhosty ahora veamos el contenido del archivo virtual de depuración /sys/kernel/debug/tracing/trace_pipe, en el que bpf_printk escribe sus mensajes:
# cat /sys/kernel/debug/tracing/trace_pipe
ping-13937 [000] d.s1 442015.377014: bpf_trace_printk: running on CPU0
ping-13937 [000] d.s1 442015.377027: bpf_trace_printk: running on CPU0
Se detectaron dos paquetes en lo y fueron procesados en CPU0 — ¡nuestro primer programa BPF completamente funcional ha funcionado!
Cabe destacar que bpf_printk no escribe en el archivo de depuración sin razón: este no es el mejor ayudante para usar en producción, pero nuestro objetivo era mostrar algo simple.
Acceso a maps desde programas BPF
Ejemplo: usamos un mapa desde un programa BPF
En las secciones anteriores aprendimos a crear y usar mapas desde el espacio del usuario, y ahora veamos la parte del kernel. Comencemos, como siempre, con un ejemplo. Reescribamos nuestro programa xdp-simple.bpf.c de la siguiente manera:
#include "vmlinux.h"
#include <bpf/bpf_helpers.h>

struct {
    __uint(type, BPF_MAP_TYPE_ARRAY);
    __uint(max_entries, 8);
    __type(key, u32);
    __type(value, u64);
} woo SEC(".maps");

SEC("xdp/simple")
int simple(void *ctx)
{
    u32 key = bpf_get_smp_processor_id();
    u32 *val;

    val = bpf_map_lookup_elem(&woo, &key);
    if (!val)
        return XDP_ABORTED;

    *val += 1;

    return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
Al inicio del programa hemos agregado la definición de un mapa woo: es un array de 8 elementos, en el que se almacenan valores del tipo u64 (en C definiríamos este array como u64 woo[8]). En el programa "xdp/simple" obtenemos el número del procesador actual en la variable key y luego, con la ayuda de la función asistente bpf_map_lookup_element obtenemos un puntero a la entrada correspondiente en el array, que aumenta en uno. En otras palabras, contamos las estadísticas de en qué CPU se procesaron los paquetes entrantes. Intentemos ejecutar el programa:
$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.h
$ clang -O2 -g -I ./libbpf/src/root/usr/include/ -o xdp-simple xdp-simple.c ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz
$ sudo ./xdp-simple
Verifiquemos que se ha conectado a lo y enviemos un poco de paquetes:
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 108

$ for s in `seq 234`; do sudo ping -f -c 100 127.0.0.1 >/dev/null 2>&1; done
Ahora veamos el contenido del arreglo:
$ sudo bpftool map dump name woo
[
    { "key": 0, "value": 0 },
    { "key": 1, "value": 400 },
    { "key": 2, "value": 0 },
    { "key": 3, "value": 0 },
    { "key": 4, "value": 0 },
    { "key": 5, "value": 0 },
    { "key": 6, "value": 0 },
    { "key": 7, "value": 46400 }
]
Casi todos los procesos fueron manejados en CPU7. Eso no nos importa, lo principal es que el programa funciona y entendimos cómo acceder a los mapas desde programas BPF — mediante .
El misterioso puntero
Así que podemos acceder desde el programa BPF al mapa mediante llamadas del tipo
val = bpf_map_lookup_elem(&woo, &key);donde la función asistente se ve como
void *bpf_map_lookup_elem(struct bpf_map *map, const void *key)pero estamos pasando un puntero &woo a una estructura anónima struct { ... }…
Si miramos el ensamblador del programa, veremos que el valor &woo de hecho no está definido (línea 4):
llvm-objdump -D --section xdp/simple xdp-simple.bpf.o

xdp-simple.bpf.o:       file format elf64-bpf

Desensamblado de la sección xdp/simple:

0000000000000000 :
       0:       85 00 00 00 08 00 00 00 call 8
       1:       63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0
       2:       bf a2 00 00 00 00 00 00 r2 = r10
       3:       07 02 00 00 fc ff ff ff r2 += -4
       4:       18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll
       6:       85 00 00 00 01 00 00 00 call 1
...
y se encuentra en las reubicaciones:
$ llvm-readelf -r xdp-simple.bpf.o | head -4

La sección de reubicación '.relxdp/simple' en la offset 0xe18 contiene 1 entradas:
    Offset             Info             Type               Symbol's Value  Symbol's Name
0000000000000020  0000002700000001 R_BPF_64_64            0000000000000000 woo
Pero si miramos el programa ya cargado, veremos un puntero al mapa correcto (línea 4):
$ sudo bpftool prog dump x name simple
int simple(void *ctx):
   0: (85) call bpf_get_smp_processor_id#114128
   1: (63) *(u32 *)(r10 -4) = r0
   2: (bf) r2 = r10
   3: (07) r2 += -4
   4: (18) r1 = map[id:64]
...
Por lo tanto, podemos concluir que en el momento de la ejecución de nuestro programa cargador, la referencia a &woo fue reemplazada por algo por la biblioteca libbpf. Para empezar, veamos la salida strace:
$ sudo strace -e bpf ./xdp-simple
...
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_ARRAY, key_size=4, value_size=8, max_entries=8, map_name="woo", ...}, 120) = 4
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, prog_name="simple", ...}, 120) = 5
Vemos que libbpf creó el mapa woo y luego cargó nuestro programa simple. Veamos más de cerca cómo estamos cargando el programa:
- llamando
xdp_simple_bpf__open_and_loaddesde el archivoxdp-simple.skel.h - que llama
xdp_simple_bpf__loaddesde el archivoxdp-simple.skel.h - que llama
bpf_object__load_skeletondesde el archivolibbpf/src/libbpf.c - que llama
bpf_object__load_xattrdelibbpf/src/libbpf.c
La última función, además de todo, llamará bpf_object__create_maps, que crea o abre mapas existentes, convirtiéndolos en descriptores de archivos. (Aquí es donde vemos BPF_MAP_CREATE en la salida strace.) Luego se llama a la función bpf_object__relocate , y es precisamente eso lo que nos interesa, ya que recordamos que vimos woo en la tabla de reubicaciones. Al investigar esto, al final llegamos a la función bpf_program__relocate, que se encarga :
case RELO_LD64:
    insn[0].src_reg = BPF_PSEUDO_MAP_FD;
    insn[0].imm = obj->maps[relo->map_idx].fd;
    break;
Así que tomamos nuestra instrucción
18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 lly reemplazamos el registro fuente con BPF_PSEUDO_MAP_FD, y el primer IMM con el descriptor de archivo de nuestro mapa y, si es igual a, por ejemplo, 0xdeadbeef, entonces al final obtenemos la instrucción
18 11 00 00 ef eb ad de 00 00 00 00 00 00 00 00 r1 = 0 llAsí es como se transmite la información sobre los mapas a un programa BPF cargado específico. Además, el mapa puede ser creado usando BPF_MAP_CREATE, o abierto por ID usando BPF_MAP_GET_FD_BY_ID.
En resumen, al usar libbpf el algoritmo es el siguiente:
- durante la compilación, se crean registros en la tabla de reubicación para referencias a mapas
libbpfse abre el objeto ELF, se encuentran todos los mapas utilizados y se crean descriptores de archivos para ellos- los descriptores de archivos se cargan en el núcleo como parte de la instrucción
LD64
Como pueden imaginar, esto no es todo, y tendremos que mirar en el núcleo. Afortunadamente, tenemos una pista: hemos escrito el valor BPF_PSEUDO_MAP_FD en el registro fuente y podemos buscarlo, lo que nos llevará a lo sagrado de los sagrados — kernel/bpf/verifier.c, donde una función con un nombre característico reemplaza el descriptor de archivo con la dirección de una estructura de tipo struct bpf_map:
static int replace_map_fd_with_map_ptr(struct bpf_verifier_env *env) {
    ...

    f = fdget(insn[0].imm);
    map = __bpf_map_get(f);
    if (insn->src_reg == BPF_PSEUDO_MAP_FD) {
        addr = (unsigned long)map;
    }
    insn[0].imm = (u32)addr;
    insn[1].imm = addr >> 32;
(el código completo se puede encontrar ). Así que podemos complementar nuestro algoritmo:
- durante la carga del programa, el verificador comprueba la correcta utilización del mapa y escribe la dirección de la estructura correspondiente
struct bpf_map
Al cargar un binario ELF usando libbpf suceden muchas más cosas, pero discutiremos esto en el marco de otros artículos.
Cargando programas y mapas sin libbpf
Como se prometió, aquí hay un ejemplo para los lectores que quieren saber cómo crear y cargar un programa que utiliza mapas, sin ayuda libbpf. Esto puede ser útil cuando trabajas en un entorno donde no puedes compilar dependencias, o ahorras cada bit, o escribes un programa tipo , que genera código binario BPF al vuelo.
Para que sea más fácil seguir la lógica, reescribiremos nuestro ejemplo xdp-simple. Puedes encontrar el código completo y algo ampliado del programa considerado en este .
La lógica de nuestra aplicación es la siguiente:
- crear un mapa del tipo
BPF_MAP_TYPE_ARRAYmediante el comandoBPF_MAP_CREATE, - crear un programa que use este mapa,
- conectar el programa a la interfaz
lo,
lo que se traduce a humano como
int main(void)
{
    int map_fd, prog_fd;

    map_fd = map_create();
    if (map_fd < 0)
        err(1, "bpf: BPF_MAP_CREATE");

    prog_fd = prog_load(map_fd);
    if (prog_fd < 0)
        err(1, "bpf: BPF_PROG_LOAD");

    xdp_attach(1, prog_fd);
}
Aquí map_create crea un mapa de la misma manera que lo hicimos en el primer ejemplo sobre la llamada al sistema bpf — "núcleo, por favor, crea un nuevo mapa en forma de array de 8 elementos del tipo __u64 y devuélveme un descriptor de archivo":
static int map_create()
{
    union bpf_attr attr;

    memset(&attr, 0, sizeof(attr));
    attr.map_type = BPF_MAP_TYPE_ARRAY,
    attr.key_size = sizeof(__u32),
    attr.value_size = sizeof(__u64),
    attr.max_entries = 8,
    strncpy(attr.map_name, "woo", sizeof(attr.map_name));
    return syscall(__NR_bpf, BPF_MAP_CREATE, &attr, sizeof(attr));
}
El programa también se carga de manera sencilla:
static int prog_load(int map_fd)
{
    union bpf_attr attr;
    struct bpf_insn insns[] = {
        ...
    };

    memset(&attr, 0, sizeof(attr));
    attr.prog_type = BPF_PROG_TYPE_XDP;
    attr.insns     = ptr_to_u64(insns);
    attr.insn_cnt  = sizeof(insns)/sizeof(insns[0]);
    attr.license   = ptr_to_u64("GPL");
    strncpy(attr.prog_name, "woo", sizeof(attr.prog_name));
    return syscall(__NR_bpf, BPF_PROG_LOAD, &attr, sizeof(attr));
}
La parte complicada prog_load — es la definición de nuestro programa BPF en forma de array de estructuras struct bpf_insn insns[]. Pero, como estamos usando un programa que tenemos en C, podemos hacer un pequeño truco:
$ llvm-objdump -D --section xdp/simple xdp-simple.bpf.o

0000000000000000 :
       0:       85 00 00 00 08 00 00 00 call 8
       1:       63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0
       2:       bf a2 00 00 00 00 00 00 r2 = r10
       3:       07 02 00 00 fc ff ff ff r2 += -4
       4:       18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll
       6:       85 00 00 00 01 00 00 00 call 1
       7:       b7 01 00 00 00 00 00 00 r1 = 0
       8:       15 00 04 00 00 00 00 00 if r0 == 0 goto +4
       9:       61 01 00 00 00 00 00 00 r1 = *(u32 *)(r0 + 0)
      10:       07 01 00 00 01 00 00 00 r1 += 1
      11:       63 10 00 00 00 00 00 00 *(u32 *)(r0 + 0) = r1
      12:       b7 01 00 00 02 00 00 00 r1 = 2

0000000000000068 :
      13:       bf 10 00 00 00 00 00 00 r0 = r1
      14:       95 00 00 00 00 00 00 00 exit
En resumen, necesitamos escribir 14 instrucciones en forma de estructuras del tipo struct bpf_insn (consejo: toma el volcado de arriba, vuelve a leer la sección sobre las instrucciones, abre y y trata de determinar struct bpf_insn insns[] por tu cuenta):
struct bpf_insn insns[] = {
    /* 85 00 00 00 08 00 00 00 call 8 */
    {
        .code = BPF_JMP | BPF_CALL,
        .imm = 8,
    },

    /* 63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0 */
    {
        .code = BPF_MEM | BPF_STX,
        .off = -4,
        .src_reg = BPF_REG_0,
        .dst_reg = BPF_REG_10,
    },

    /* bf a2 00 00 00 00 00 00 r2 = r10 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_X,
        .src_reg = BPF_REG_10,
        .dst_reg = BPF_REG_2,
    },

    /* 07 02 00 00 fc ff ff ff r2 += -4 */
    {
        .code = BPF_ALU64 | BPF_ADD | BPF_K,
        .dst_reg = BPF_REG_2,
        .imm = -4,
    },

    /* 18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll */
    {
        .code = BPF_LD | BPF_DW | BPF_IMM,
        .src_reg = BPF_PSEUDO_MAP_FD,
        .dst_reg = BPF_REG_1,
        .imm = map_fd,
    },
    { }, /* placeholder */

    /* 85 00 00 00 01 00 00 00 call 1 */
    {
        .code = BPF_JMP | BPF_CALL,
        .imm = 1,
    },

    /* b7 01 00 00 00 00 00 00 r1 = 0 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 0,
    },

    /* 15 00 04 00 00 00 00 00 if r0 == 0 goto +4  */
    {
        .code = BPF_JMP | BPF_JEQ | BPF_K,
        .off = 4,
        .src_reg = BPF_REG_0,
        .imm = 0,
    },

    /* 61 01 00 00 00 00 00 00 r1 = *(u32 *)(r0 + 0) */
    {
        .code = BPF_MEM | BPF_LDX,
        .off = 0,
        .src_reg = BPF_REG_0,
        .dst_reg = BPF_REG_1,
    },

    /* 07 01 00 00 01 00 00 00 r1 += 1 */
    {
        .code = BPF_ALU64 | BPF_ADD | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 1,
    },

    /* 63 10 00 00 00 00 00 00 *(u32 *)(r0 + 0) = r1 */
    {
        .code = BPF_MEM | BPF_STX,
        .src_reg = BPF_REG_1,
        .dst_reg = BPF_REG_0,
    },

    /* b7 01 00 00 02 00 00 00 r1 = 2 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 2,
    },

    /* : bf 10 00 00 00 00 00 00 r0 = r1 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_X,
        .src_reg = BPF_REG_1,
        .dst_reg = BPF_REG_0,
    },

    /* 95 00 00 00 00 00 00 00 exit */
    {
        .code = BPF_JMP | BPF_EXIT
    },
};
Un ejercicio para aquellos que no lo escribieron por su cuenta — encuentra map_fd.
En nuestro programa queda una parte más que no se ha revelado — xdp_attach. Desafortunadamente, los programas de tipo XDP no se pueden conectar mediante una llamada del sistema bpf. Las personas que crearon BPF y XDP provenían de la comunidad de redes de Linux, lo que significa que usaron la interfaz más familiar para ellos (pero no para las personas ) para interactuar con el núcleo: , consulta también . La forma más simple de implementación xdp_attach es copiar el código de libbpf, a saber, del archivo , que es lo que hicimos, acortándolo un poco:
Bienvenido al mundo de los sockets netlink
Abrimos un socket netlink de tipo NETLINK_ROUTE:
int netlink_open(__u32 *nl_pid)
{
    struct sockaddr_nl sa;
    socklen_t addrlen;
    int one = 1, ret;
    int sock;

    memset(&sa, 0, sizeof(sa));
    sa.nl_family = AF_NETLINK;

    sock = socket(AF_NETLINK, SOCK_RAW, NETLINK_ROUTE);
    if (sock < 0)
        err(1, "socket");

    if (setsockopt(sock, SOL_NETLINK, NETLINK_EXT_ACK, &one, sizeof(one)) < 0)
        warnx("la notificación de errores de netlink no es compatible");

    if (bind(sock, (struct sockaddr *)&sa, sizeof(sa)) < 0)
        err(1, "bind");

    addrlen = sizeof(sa);
    if (getsockname(sock, (struct sockaddr *)&sa, &addrlen) < 0)
        err(1, "getsockname");

    *nl_pid = sa.nl_pid;
    return sock;
}
Leemos desde este socket:
static int bpf_netlink_recv(int sock, __u32 nl_pid, int seq)
{
    bool multipart = true;
    struct nlmsgerr *errm;
    struct nlmsghdr *nh;
    char buf[4096];
    int len, ret;

    while (multipart) {
        multipart = false;
        len = recv(sock, buf, sizeof(buf), 0);
        if (len nlmsg_pid != nl_pid)
                errx(1, "pid incorrecto");
            if (nh->nlmsg_seq != seq)
                errx(1, "INVSEQ");
            if (nh->nlmsg_flags & NLM_F_MULTI)
                multipart = true;
            switch (nh->nlmsg_type) {
                case NLMSG_ERROR:
                    errm = (struct nlmsgerr *)NLMSG_DATA(nh);
                    if (!errm->error)
                        continue;
                    ret = errm->error;
                    // libbpf_nla_dump_errormsg(nh); demasiado código para copiar...
                    goto done;
                case NLMSG_DONE:
                    return 0;
                default:
                    break;
            }
        }
    }
    ret = 0;
done:
    return ret;
}
Finalmente, aquí está nuestra función que abre un socket y envía un mensaje especial a él que contiene un descriptor de archivo:
static int xdp_attach(int ifindex, int prog_fd)
{
    int sock, seq = 0, ret;
    struct nlattr *nla, *nla_xdp;
    struct {
        struct nlmsghdr  nh;
        struct ifinfomsg ifinfo;
        char             attrbuf[64];
    } req;
    __u32 nl_pid = 0;

    sock = netlink_open(&nl_pid);
    if (sock nla_type = NLA_F_NESTED | IFLA_XDP;
    nla->nla_len = NLA_HDRLEN;

    /* add XDP fd */
    nla_xdp = (struct nlattr *)((char *)nla + nla->nla_len);
    nla_xdp->nla_type = IFLA_XDP_FD;
    nla_xdp->nla_len = NLA_HDRLEN + sizeof(int);
    memcpy((char *)nla_xdp + NLA_HDRLEN, &prog_fd, sizeof(prog_fd));
    nla->nla_len += nla_xdp->nla_len;

    /* if user passed in any flags, add those too */
    __u32 flags = XDP_FLAGS_SKB_MODE;
    nla_xdp = (struct nlattr *)((char *)nla + nla->nla_len);
    nla_xdp->nla_type = IFLA_XDP_FLAGS;
    nla_xdp->nla_len = NLA_HDRLEN + sizeof(flags);
    memcpy((char *)nla_xdp + NLA_HDRLEN, &flags, sizeof(flags));
    nla->nla_len += nla_xdp->nla_len;

    req.nh.nlmsg_len += NLA_ALIGN(nla->nla_len);

    if (send(sock, &req, req.nh.nlmsg_len, 0) < 0)
        err(1, "send");
    ret = bpf_netlink_recv(sock, nl_pid, seq);

cleanup:
    close(sock);
    return ret;
}
Así que todo está listo para las pruebas:
$ cc nolibbpf.c -o nolibbpf
$ sudo strace -e bpf ./nolibbpf
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_ARRAY, map_name="woo", ...}, 72) = 3
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=15, prog_name="woo", ...}, 72) = 4
+++ salió con 0 +++
Veamos si nuestro programa está conectado a lo:
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 160
Enviaremos pings y observaremos el mapa:
$ for s in `seq 234`; do sudo ping -f -c 100 127.0.0.1 >/dev/null 2>&1; done
$ sudo bpftool m dump name woo
key: 00 00 00 00  value: 90 01 00 00 00 00 00 00
key: 01 00 00 00  value: 00 00 00 00 00 00 00 00
key: 02 00 00 00  value: 00 00 00 00 00 00 00 00
key: 03 00 00 00  value: 00 00 00 00 00 00 00 00
key: 04 00 00 00  value: 00 00 00 00 00 00 00 00
key: 05 00 00 00  value: 00 00 00 00 00 00 00 00
key: 06 00 00 00  value: 40 b5 00 00 00 00 00 00
key: 07 00 00 00  value: 00 00 00 00 00 00 00 00
Se encontraron 8 elementos
¡Hurra, todo funciona! Observa que nuestro mapa se muestra de nuevo en forma de bytes. Esto se debe a que, a diferencia de libbpf no hemos cargado la información de tipos (BTF). Pero hablaremos más de esto la próxima vez.
Herramientas de desarrollo
En esta sección, vamos a examinar el conjunto mínimo de herramientas para desarrolladores de BPF.
En general, no se necesita nada especial para desarrollar programas de BPF: BPF funciona en cualquier núcleo de distribución decente y los programas se compilan utilizando clang, que se puede instalar desde el paquete. Sin embargo, dado que BPF está en desarrollo, el núcleo y las herramientas cambian constantemente. Si no desea escribir programas BPF de la manera antigua de 2019, tendrá que compilar
llvm/clangpahole- su núcleo
bpftool
(Para referencia: esta sección y todos los ejemplos en el artículo se ejecutaron en Debian 10.)
llvm/clang
BPF trabaja bien con LLVM y, aunque desde hace poco se pueden compilar programas para BPF también con gcc, todo el desarrollo actual se realiza para LLVM. Por lo tanto, lo primero que haremos será compilar la versión actual clang de git:
$ sudo apt install ninja-build
$ git clone --depth 1 https://github.com/llvm/llvm-project.git
$ mkdir -p llvm-project/llvm/build/install
$ cd llvm-project/llvm/build
$ cmake .. -G "Ninja" -DLLVM_TARGETS_TO_BUILD="BPF;X86"
                      -DLLVM_ENABLE_PROJECTS="clang"
                      -DBUILD_SHARED_LIBS=OFF
                      -DCMAKE_BUILD_TYPE=Release
                      -DLLVM_BUILD_RUNTIME=OFF
$ time ninja
... mucho tiempo después
$
Ahora podemos verificar si todo se ha compilado correctamente:
$ ./bin/llc --version
LLVM (http://llvm.org/):
  versión de LLVM 11.0.0git
  compilación optimizada.
  objetivo por defecto: x86_64-unknown-linux-gnu
  CPU anfitriona: znver1

  Objetivos registrados:
    bpf    - BPF (endianness del host)
    bpfeb  - BPF (big endian)
    bpfel  - BPF (little endian)
    x86    - X86 de 32 bits: Pentium-Pro y superiores
    x86-64 - X86 de 64 bits: EM64T y AMD64
(Instrucciones para la compilación clang tomadas de .)
No vamos a instalar los programas recién compilados, sino que simplemente los agregaremos a PATH, por ejemplo:
export PATH="`pwd`/bin:$PATH"(Esto se puede agregar a .bashrc o a un archivo separado. Personalmente, agrego estas cosas a ~/bin/activate-llvm.sh y cuando es necesario lo hago . activate-llvm.sh.)
Pahole y BTF
Utilidad pahole se utiliza al compilar el núcleo para crear información de depuración en formato BTF. No vamos a entrar en detalles sobre la tecnología BTF en este artículo, aparte del hecho de que es conveniente y queremos utilizarla. Por lo tanto, si va a compilar su núcleo, primero compile pahole (sin pahole no podrá compilar el núcleo con la opción CONFIG_DEBUG_INFO_BTF:
$ git clone https://git.kernel.org/pub/scm/devel/pahole/pahole.git
$ cd pahole/
$ sudo apt install cmake
$ mkdir build
$ cd build/
$ cmake -D__LIB=lib ..
$ make
$ sudo make install
$ which pahole
/usr/local/bin/pahole
Núcleos para experimentar con BPF
Al explorar las posibilidades de BPF, es deseable compilar su propio núcleo. Esto, en términos generales, no es obligatorio, ya que podrá compilar y cargar programas BPF también en un núcleo de distribución. Sin embargo, tener su propio núcleo permite aprovechar las funciones más recientes de BPF, que en su distribución aparecerán, en el mejor de los casos, en meses o, en el caso de algunas herramientas de depuración, no se empaquetarán en un futuro cercano. Además, su propio núcleo le permite experimentar con el código de manera más significativa.
Para construir un núcleo, necesita, en primer lugar, el núcleo mismo y, en segundo lugar, el archivo de configuración del núcleo. Para experimentar con BPF, podemos usar un núcleo estándar. o uno de los núcleos de desarrollo. Históricamente, el desarrollo de BPF se lleva a cabo dentro de la comunidad de redes de Linux y, por lo tanto, todos los cambios, tarde o temprano, pasan a través de David Miller, el mantenedor de la parte de red de Linux. Dependiendo de su naturaleza —modificaciones o nuevas funciones—, los cambios de red se colocan en uno de los dos núcleos: o . Los cambios para BPF se distribuyen de la misma manera entre y , que luego se integran en net y net-next, respectivamente. Para más detalles, consulte la y . Así que elija el núcleo según sus preferencias y necesidades de estabilidad del sistema en el que está probando (*-next son los núcleos más inestables de los mencionados).
El alcance de este artículo no incluye cómo manejar los archivos de configuración del núcleo — se supone que ya sabe hacerlo o está por su cuenta. Sin embargo, las siguientes instrucciones deberían ser lo suficientemente claras como para que tenga un sistema funcional con soporte para BPF.
Descargue uno de los núcleos mencionados anteriormente:
$ git clone git://git.kernel.org/pub/scm/linux/kernel/git/bpf/bpf-next.git
$ cd bpf-next
Compile una configuración mínima de núcleo funcional:
$ cp /boot/config-`uname -r` .config
$ make localmodconfig
Active las opciones de BPF en el archivo .config de su elección (probablemente, la propia CONFIG_BPF ya estará habilitada, ya que la usa systemd). Aquí está la lista de opciones del núcleo que se utilizó para este artículo:
CONFIG_CGROUP_BPF=y
CONFIG_BPF=y
CONFIG_BPF_LSM=y
CONFIG_BPF_SYSCALL=y
CONFIG_ARCH_WANT_DEFAULT_BPF_JIT=y
CONFIG_BPF_JIT_ALWAYS_ON=y
CONFIG_BPF_JIT_DEFAULT_ON=y
CONFIG_IPV6_SEG6_BPF=y
# CONFIG_NETFILTER_XT_MATCH_BPF no está configurado
# CONFIG_BPFILTER no está configurado
CONFIG_NET_CLS_BPF=y
CONFIG_NET_ACT_BPF=y
CONFIG_BPF_JIT=y
CONFIG_BPF_STREAM_PARSER=y
CONFIG_LWTUNNEL_BPF=y
CONFIG_HAVE_EBPF_JIT=y
CONFIG_BPF_EVENTS=y
CONFIG_BPF_KPROBE_OVERRIDE=y
CONFIG_DEBUG_INFO_BTF=y
Luego, podremos compilar e instalar fácilmente los módulos y el núcleo (por cierto, se puede compilar el núcleo utilizando lo que acabamos de compilar clang, añadiendo CC=clang):
$ make -s -j $(getconf _NPROCESSORS_ONLN)
$ sudo make modules_install
$ sudo make install
y reiniciar con el nuevo núcleo (yo uso para esto kexec del paquete kexec-tools):
v=5.8.0-rc6+ # si recompilas el núcleo actual, puedes establecer v=`uname -r`
sudo kexec -l -t bzImage /boot/vmlinuz-$v --initrd=/boot/initrd.img-$v --reuse-cmdline &&
sudo kexec -e
bpftool
La utilidad más utilizada en este artículo será la utilidad bpftool, proporcionada con el núcleo de Linux. Está escrita y mantenida por los desarrolladores de BPF para los desarrolladores de BPF, y con ella se puede gestionar todo tipo de objetos BPF: cargar programas, crear y modificar mapas, investigar la vida de la ecosistema BPF, etc. La documentación en forma de fuentes para las páginas de manual se puede encontrar o, ya compilada, .
En el momento de escribir este artículo bpftool se proporciona en forma lista solo para RHEL, Fedora y Ubuntu (ver, por ejemplo, , que cuenta la historia inacabada del empaquetado bpftool en Debian). Pero, si ya has compilado tu núcleo, entonces compilar bpftool es pan comido:
$ cd ${linux}/tools/bpf/bpftool
# ... especifica las rutas al último clang, como se describió anteriormente
$ make -s

Auto-detectando características del sistema:
...                        libbfd: [ on  ]
...        disassembler-four-args: [ on  ]
...                          zlib: [ on  ]
...                        libcap: [ on  ]
...               clang-bpf-co-re: [ on  ]

Auto-detectando características del sistema:
...                        libelf: [ on  ]
...                          zlib: [ on  ]
...                           bpf: [ on  ]

$
(aquí ${linux} — es tu directorio con el núcleo.) Después de ejecutar estos comandos bpftool se compilará en el directorio ${linux}/tools/bpf/bpftool y se puede agregar al PATH (principalmente para el usuario root) o simplemente copiarlo en /usr/local/sbin.
Es mejor compilar bpftool utilizando la última versión clang, compilada como se describió anteriormente, y verificar si se compila correctamente usando, por ejemplo, el comando
$ sudo bpftool feature probe kernel
Escaneando la configuración del sistema...
bpf() syscall para usuarios no privilegiados está habilitado
El compilador JIT está habilitado
El endurecimiento del compilador JIT está deshabilitado
Las exportaciones kallsyms del compilador JIT están habilitadas para root
...
lo que mostrará qué características de BPF están habilitadas en tu núcleo.
Por cierto, el comando anterior se puede ejecutar como
# bpftool f p kEsto se hace por analogía con las utilidades del paquete iproute2, donde podemos, por ejemplo, decir ip a s eth0 en lugar de ip addr show dev eth0.
Conclusión
BPF permite que una pulga mida eficazmente y modifique en vuelo la funcionalidad del núcleo. El sistema resultó ser muy exitoso, en la mejor tradición de UNIX: un mecanismo simple que permite (re)programar el núcleo ha permitido que una gran cantidad de personas y organizaciones experimenten. Y, aunque los experimentos, así como el desarrollo de la propia infraestructura de BPF, aún no han terminado, el sistema ya tiene un ABI estable que permite construir una lógica de negocio confiable y, lo que es más importante, eficiente.
Quisiera señalar que, en mi opinión, la tecnología se ha vuelto tan popular porque, por un lado, se puede jugar (la arquitectura de la máquina se puede entender más o menos en una noche), y por otro lado, resolver problemas que no se podían resolver (de manera elegante) antes de su aparición. Estos dos componentes juntos hacen que las personas experimenten y sueñen, lo que conduce a la aparición de cada vez más nuevas innovaciones.
Este artículo, aunque no es especialmente corto, es solo una introducción al mundo de BPF y no describe las capacidades 'avanzadas' y las partes importantes de la arquitectura. El plan a continuación es aproximadamente el siguiente: el siguiente artículo será una revisión de los tipos de programas BPF (en el núcleo 5.8 se admiten 30 tipos de programas), luego finalmente veremos cómo escribir aplicaciones reales en BPF con ejemplos de programas para rastreo del núcleo, luego será el momento para un curso más profundo sobre la arquitectura de BPF, y después, ejemplos de aplicaciones de red y de seguridad de BPF.
Los artículos anteriores de esta serie
Enlaces
— documentación sobre BPF de cilium, más específicamente de Daniel Borkman, uno de los creadores y mantenedores de BPF. Esta es una de las primeras descripciones serias, que se destaca de las demás porque Daniel sabe exactamente de qué está hablando y no hay errores. En particular, en este documento se explica cómo trabajar con programas BPF de tipos XDP y TC usando una utilidad conocida.
ipdel paqueteiproute2.— el archivo original con documentación sobre BPF clásico y luego sobre BPF extendido. Es útil de leer si quieres profundizar en el asm y los detalles técnicos de la arquitectura.
. Se actualiza raramente, pero de manera acertada, ya que escriben allí Alexei Starovoitov (autor de eBPF) y Andrii Nakryiko — (mantenedor
libbpf).. Un hilo de Twitter interesante de Quentin Monnet con ejemplos y secretos sobre el uso de bpftool.
. Una lista gigantesca (y aún mantenida) de enlaces a la documentación sobre BPF de Quentin Monnet.
Fuente: habr.com
