

Al tratar con un producto que ha estado en desarrollo durante más de una década, no es sorprendente encontrarse con tecnologías obsoletas. Pero, ¿qué pasa si dentro de seis meses debes soportar una carga diez veces mayor y el costo de las caídas aumenta cientos de veces? En este caso, necesitas un brillante Ingeniero de Highload. Sin embargo, debido a la falta de uno, la solución del problema me fue confiada. En la primera parte del artículo, hablaré sobre cómo migramos de Redis a Redis-cluster, y en la segunda parte, daré consejos sobre cómo comenzar a usar el clúster y qué aspectos tener en cuenta al operarlo.
Selección de tecnología
¿Es tan malo Redis independiente (standalone redis) en una configuración con 1 maestro y N esclavos? ¿Por qué lo llamo una tecnología obsoleta?
No, Redis no es tan malo... Sin embargo, hay algunas fallas que no se pueden ignorar.
En primer lugar, Redis no soporta mecanismos de recuperación ante la caída del maestro. Para solucionar este problema, utilizamos una configuración con conmutación automática de VIP a un nuevo maestro, cambiando el rol de uno de los esclavos y alternando el resto. Este mecanismo funcionó, pero no se podía considerar una solución confiable. En primer lugar, ocurrieron falsos disparos, y en segundo lugar, era una solución temporaria que requería acciones manuales después del disparo.
En segundo lugar, tener solo un maestro llevaba a problemas de particionado. Era necesario crear varios clústeres independientes de "1 maestro y N esclavos", luego distribuir manualmente las bases de datos en estas máquinas y esperar que al día siguiente una de las bases no crezca tanto que tenga que ser trasladada a una instancia separada.
¿Cuáles son las opciones?
- La opción más cara y completa es Redis-Enterprise. Esta es una solución empaquetada con soporte técnico completo. A pesar de que parece ideal desde el punto de vista técnico, no nos sirvió por razones ideológicas.
- Redis-cluster. Esta opción incluye soporte para conmutación por error del maestro y particionado. La interfaz prácticamente no difiere de la versión estándar. Se ve prometedora; hablaremos de las trampas más adelante.
- Tarantool, Memcache, Aerospike y otros. Todas estas herramientas hacen aproximadamente lo mismo. Pero cada una tiene sus desventajas. Decidimos no poner todos los huevos en una sola canasta. Usamos Memcache y Tarantool para otras tareas, y, adelantándome, diré que en nuestra práctica hemos tenido más problemas con ellos.
Especificidad del uso
Veamos qué tareas hemos resuelto históricamente con Redis y qué funcionalidades hemos utilizado:
- Caché antes de solicitudes a servicios remotos como 2GIS | Golang
GET SET MGET MSET "SELECT DB"
- Caché antes de MYSQL | PHP
GET SET MGET MSET SCAN "KEY BY PATTERN" "SELECT DB"
- Almacenamiento principal para el servicio de gestión de sesiones y coordenadas de conductores | Golang
GET SET MGET MSET "SELECT DB" "ADD GEO KEY" "GET GEO KEY" SCAN
Como pueden ver, no hay matemáticas superiores. ¿Cuál es entonces la complejidad? Analicemos cada método por separado.
El método
Descripción
Particularidades de Redis-cluster
Solución
GET SET
Escribir/leer clave
MGET MSET
Escribir/leer varias claves
Las claves estarán en diferentes nodos. Las bibliotecas listas para usar pueden hacer operaciones múltiples solo dentro de un nodo.
Reemplazar MGET por un pipeline de N operaciones GET
SELECT DB
Seleccionar la base de datos con la que vamos a trabajar
No soporta varias bases de datos
Almacenar todo en una sola base. Agregar prefijos a las claves
SCAN
Recorrer todas las claves en la base
Dado que tenemos una sola base, recorrer todas las claves en el clúster es demasiado costoso
Mantener la invariante dentro de una clave y hacer HSCAN por esa clave. O renunciar por completo.
GEO
Operaciones de trabajo con claves geográficas
La clave geográfica no se fragmenta
KEY BY PATTERN
Buscar clave por patrón
Dado que tenemos una sola base, buscaremos en todas las claves del clúster. Es demasiado costoso.
Renunciar o mantener la invariante, como en el caso de SCAN.
Redis vs Redis-cluster
¿Qué perdemos y qué ganamos al pasar a un clúster?
- Desventajas: perdemos la funcionalidad de varias bases de datos.
- Si queremos almacenar datos lógicamente no relacionados en un solo clúster, tendremos que hacer adaptaciones en forma de prefijos.
- Perdemos todas las operaciones "por base", como SCAN, DBSIZE, CLEAR DB, etc.
- Las operaciones múltiples se han vuelto significativamente más complicadas de implementar, ya que puede requerirse acceso a varios nodos.
- Ventajas:
- Tolerancia a fallos en forma de failover del maestro.
- Fragmentación del lado de Redis.
- Movimiento de datos entre nodos de forma atómica y sin interrupciones.
- Adición y redistribución de recursos y cargas sin interrupciones.
Llegaría a la conclusión de que si no necesitas garantizar un alto nivel de disponibilidad, entonces no vale la pena migrar a un clúster, ya que puede ser una tarea no trivial. Pero si inicialmente hay que elegir entre una versión independiente y un clúster, es mejor optar por el clúster, ya que no es en absoluto peor y además te quitará parte del dolor de cabeza.
Preparación para la migración
Comencemos con los requisitos de la migración:
- Debe ser sin interrupciones. No estamos de acuerdo con detener el servicio por completo durante 5 minutos.
- Debe ser lo más seguro y gradual posible. Queremos tener cierto control sobre la situación. No deseamos lanzar todo de golpe y rezar por un botón de reversión.
- Mínimas pérdidas de datos durante la migración. Entendemos que será muy difícil migrar de forma atómica, por lo que permitimos cierta desincronización entre los datos en Redis normal y en el clúster.
Mantenimiento del clúster
Antes de la migración, debemos considerar si podemos mantener el clúster:
- Gráficas. Utilizamos Prometheus y Grafana para gráficos de carga de CPU, memoria ocupada, número de clientes, cantidad de operaciones GET, SET, AUTH, etc.
- Experiencia. Imagina que mañana estarás a cargo de un enorme clúster. Si se rompe, nadie más que tú podrá repararlo. Si comienza a relentizarse, todos vendrán a ti. Si necesitas agregar recursos o redistribuir la carga, volverán a ti. Para no encanecer a los 25, es recomendable prever estos casos y verificar de antemano cómo se comportará la tecnología en tales o cuales acciones. Hablaremos de esto con más detalle en la sección 'Experiencia'.
- Monitoreos y alertas. Cuando se rompe el clúster, queremos enterarnos primero. Aquí nos limitamos a alertar que todos los nodos devuelven la misma información sobre el estado del clúster (sí, a veces es diferente). Y otros problemas se notan más rápidamente a través de las alertas de los servicios clientes de Redis.
Mudanza
Cómo vamos a migrar:
- En primer lugar, es necesario preparar la biblioteca para trabajar con el clúster. Como base para la versión en Go, tomamos go-redis y lo modificamos ligeramente. Implementamos métodos Multi a través de pipelines, y también ajustamos un poco las reglas de repetición de solicitudes. Con la versión para PHP surgieron más problemas, pero al final nos decantamos por php-redis. Recientemente implementaron soporte para clústeres, y a nuestro parecer, luce bien.
- A continuación, necesitamos desplegar el clúster. Esto se hace literalmente en dos comandos basados en el archivo de configuración. Hablaremos más sobre la configuración más adelante.
- Para la transición gradual, utilizamos el modo dry. Como tenemos dos versiones de la biblioteca con la misma interfaz (una para la versión normal y otra para el clúster), no es difícil hacer una envoltura que funcione con la versión separada y que paralelamente duplique todas las solicitudes al clúster, compare las respuestas y registre las discrepancias en los logs (en nuestro caso, en NewRelic). Así, incluso si al desplegar la versión del clúster falla, nuestra producción no se verá afectada.
- Al desplegar el clúster en modo dry, podemos observar tranquilamente el gráfico de discrepancias en las respuestas. Si la tasa de errores avanza lenta pero seguramente hacia alguna constante pequeña, significa que todo está bien. ¿Por qué siguen habiendo discrepancias? Porque la escritura en la versión separada ocurre un poco antes que en el clúster, y debido a un micro-retraso, los datos pueden diferirse. Solo queda revisar los logs de discrepancias, y si todas son explicables por la no atomicidad de la escritura, podemos seguir adelante.
- Ahora podemos alternar el modo dry en sentido inverso. Escribiremos y leeremos del clúster, y duplicaremos en la versión separada. ¿Por qué? Durante la próxima semana queremos observar el funcionamiento del clúster. Si descubrimos que en picos de carga hay problemas, o si hemos pasado por alto algo, siempre tenemos un retroceso de emergencia al código anterior y a los datos actuales gracias al modo dry.
- Solo queda desactivar el modo dry y desmantelar la versión separada.
Examen
Primero, una breve descripción de la estructura del clúster.
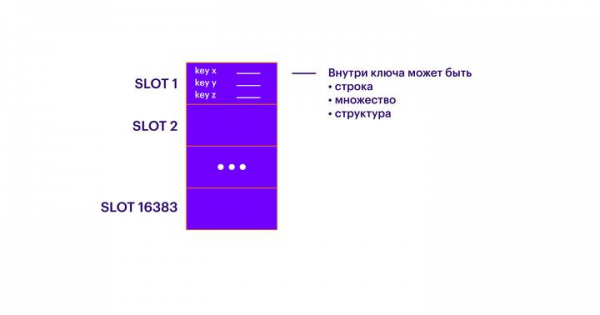
En primer lugar, Redis es un almacenamiento key-value. Se utilizan cadenas arbitrarias como claves. Los valores pueden ser números, cadenas y estructuras enteras. Hay una gran cantidad de estas últimas, pero para entender la estructura general, eso no es importante.
El siguiente nivel de abstracción después de las claves son los slots (SLOTS). Cada clave pertenece a uno de los 16 383 slots. Dentro de cada slot puede haber tantas claves como se desee. Así, todas las claves se dividen en 16 383 conjuntos no superpuestos.
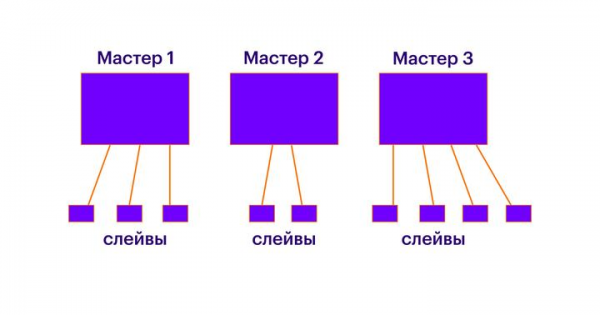
A continuación, debe haber N nodos maestros en el clúster. Cada nodo se puede considerar como una instancia separada de Redis, que conoce todo sobre otros nodos dentro del clúster. Cada nodo maestro contiene una cierta cantidad de slots. Cada slot pertenece únicamente a un nodo maestro. Todos los slots deben distribuirse entre los nodos. Si hay slots no distribuidos, las claves almacenadas en ellos no estarán disponibles. Cada nodo maestro tiene sentido ejecutarlo en una máquina lógica o física separada. También hay que recordar que cada nodo funciona solo en un núcleo, y si desea ejecutar varias instancias de Redis en una misma máquina lógica, asegúrese de que funcionen en núcleos diferentes (no hemos probado esto, pero en teoría debería funcionar). En esencia, los nodos maestros proporcionan un sharding normal, y un mayor número de nodos maestros permite escalar las consultas de escritura y lectura.
Después de que todas las claves se hayan distribuido entre los slots y los slots se hayan esparcido entre los nodos maestros, se pueden agregar a cada nodo maestro una cantidad arbitraria de nodos esclavos. Dentro de cada conjunto de "maestro-esclavo" funcionará una replicación normal. Los esclavos son necesarios para escalar las consultas de lectura y para el failover en caso de que falle el maestro.
Ahora hablemos de las operaciones que sería bueno saber hacer.
Accederemos al sistema a través de Redis-CLI. Dado que Redis no tiene un único punto de entrada, se pueden realizar las siguientes operaciones en cualquiera de los nodos. En cada punto, hago hincapié en la posibilidad de realizar la operación bajo carga.
- Lo primero y más importante que necesitaremos: la operación cluster nodes. Esta devuelve el estado del clúster, muestra la lista de nodos, sus roles, la distribución de slots, etc. Se pueden obtener más detalles mediante cluster info y cluster slots.
- Sería útil poder añadir y eliminar nodos. Para ello existen las operaciones cluster meet y cluster forget. Tenga en cuenta que es necesario aplicar cluster forget a CADA nodo, tanto a los maestros como a las réplicas. Mientras que cluster meet solo se necesita invocar en un nodo. Esta diferencia puede ser desconcertante, por lo que es mejor conocerla antes de poner en producción el clúster. La adición de un nodo se realiza de forma segura en combate y no afecta el funcionamiento del clúster (lo que tiene sentido). Sin embargo, si planea eliminar un nodo del clúster, debe asegurarse de que no queden ranuras en él (de lo contrario, corre el riesgo de perder el acceso a todas las claves en ese nodo). Además, no elimine un maestro que tenga esclavos, de lo contrario, se llevará a cabo una votación innecesaria por un nuevo maestro. Si ya no hay ranuras en los nodos, eso es un pequeño problema, pero ¿por qué deberíamos tener elecciones innecesarias si podemos eliminar primero a los esclavos?
- Si necesita forzar el cambio entre maestro y esclavo, puede usar el comando cluster failover. Al invocarlo en combate, es importante entender que durante la ejecución de la operación, el maestro no estará disponible. Normalmente, el cambio se produce en menos de un segundo, pero no es atómico. Puede esperar que parte de las solicitudes al maestro falle en ese tiempo.
- Antes de eliminar un nodo del clúster, no debería haber slots restantes en él. Es mejor redistribuirlos utilizando el comando cluster reshard. Los slots se trasladarán de un maestro a otro. La operación puede tardar varios minutos, dependiendo del volumen de datos que se transfieren; sin embargo, el proceso de transferencia es seguro y no afecta al funcionamiento del clúster. De este modo, todos los datos pueden trasladarse de un nodo a otro bajo carga, sin preocuparse por su disponibilidad. Sin embargo, hay detalles a considerar. Primero, la transferencia de datos conlleva cierta carga en el nodo receptor y en el emisor. Si el nodo receptor ya está muy cargado en términos de CPU, no debería sobrecargarse más con la recepción de nuevos datos. En segundo lugar, tan pronto como no queden slots en el maestro-emisor, todos sus esclavos pasarán inmediatamente al maestro al que se trasladaron esos slots. Y el problema es que todos esos esclavos querrán sincronizar los datos al mismo tiempo. Y tendrás suerte si se trata de una sincronización parcial en lugar de una completa. Ten esto en cuenta y combina las operaciones de transferencia de slots y de desconexión/transporte de esclavos. O bien, espera que tengas un margen de seguridad suficiente.
- ¿Qué hacer si al trasladar notas te das cuenta de que has perdido slots en algún lugar? Espero que este problema no te afecte, pero si lo hace, hay una operación llamada cluster fix. Esta operación distribuirá los slots entre los nodos de manera aleatoria. Te recomiendo verificar su funcionamiento eliminando previamente del clúster el nodo con los slots distribuidos. Dado que los datos en los slots no distribuidos ya no están disponibles, ya es tarde para preocuparse por los problemas de disponibilidad de esos slots. Por su parte, la operación no afectará a los slots distribuidos.
- Otra operación útil es monitor. Esta permite ver en tiempo real toda la lista de solicitudes que llegan al nodo. Además, se puede utilizar grep para averiguar si hay tráfico necesario.
También vale la pena mencionar el procedimiento de conmutación por error del maestro. En resumen, existe y, en mi opinión, funciona maravillosamente. Sin embargo, no se debe pensar que si se desconecta la máquina del nodo maestro, Redis cambiará instantáneamente y los clientes no notarán la pérdida. En mi experiencia, el cambio tarda unos segundos. Durante este tiempo, parte de los datos no estará disponible: se detecta la falta del maestro, los nodos votan por uno nuevo, los esclavos se cambian, los datos se sincronizan. La mejor manera de asegurarse de que el esquema funciona es realizar simulacros locales. Levante el clúster en su computadora portátil, dé una carga mínima, simule una caída (por ejemplo, bloqueando puertos) y evalúe la velocidad de conmutación. En mi opinión, solo jugando de esta manera durante uno o dos días se puede estar seguro de que la tecnología funciona. O, por lo menos, esperar que el software que usa la mitad de internet funcione sin problemas.
Configuración
A menudo, la configuración es lo primero que se necesita para comenzar a trabajar con la herramienta. Y cuando todo ya está funcionando, no se quiere tocar la configuración. Se requieren ciertos esfuerzos para obligarse a volver a los ajustes y revisarlos a fondo. En mi memoria, hemos tenido al menos dos graves fallos debido a la falta de atención a la configuración. Preste especial atención a los siguientes puntos:
- timeout 0
El tiempo después del cual se cierran las conexiones inactivas (en segundos). 0 significa que no se cierran.
No todas nuestras bibliotecas sabían cerrar correctamente las conexiones. Al desactivar esta configuración, corremos el riesgo de alcanzar el límite de número de clientes. Por otro lado, si hay tal problema, la desconexión automática de conexiones perdidas lo disimulará y podría no notarlo. Además, no se debe activar esta configuración al usar conexiones persistentes. - Save x y & appendonly yes
Guardado de un snapshot RDB.
Los problemas con RDB/AOF los discutiremos en detalle más adelante. - stop-writes-on-bgsave-error no & slave-serve-stale-data yes
Si está activado, cuando hay un fallo en el snapshot RDB, el maestro dejará de aceptar solicitudes de modificación. Si se pierde la conexión con el maestro, el esclavo puede seguir respondiendo a las solicitudes (sí). O puede dejar de responder (no).
No estamos satisfechos con la situación en la que Redis se convierte en una calabaza. - repl-ping-slave-period 5
Después de este período de tiempo, comenzaremos a preocuparnos por la posibilidad de que el maestro haya fallado y que sea hora de realizar el procedimiento de failover.
Tendremos que encontrar manualmente un equilibrio entre las falsas alarmas y el inicio del failover. En nuestra experiencia, esto es 5 segundos. - repl-backlog-size 1024mb & epl-backlog-ttl 0
Exactamente la cantidad de datos que podemos almacenar en el búfer para la réplica caída. Si el búfer se agota, tendremos que sincronizarnos completamente.
La práctica sugiere que es mejor establecer un valor más alto. Las razones por las que la réplica puede comenzar a quedarse atrás son numerosas. Si se queda atrás, lo más probable es que su maestro ya tenga dificultades, y la sincronización completa será la gota que colme el vaso. - maxclients 10000
Número máximo de clientes simultáneos.
Por nuestra experiencia, es mejor establecer un valor más alto. Redis maneja muy bien 10,000 conexiones. Solo asegúrese de que el sistema tenga suficientes sockets. - maxmemory-policy volatile-ttl
Regla bajo la cual se eliminan las claves al alcanzar el límite de memoria disponible.
Aquí lo importante no es la regla en sí, sino comprender cómo va a suceder esto. Hay que elogiar a Redis por su capacidad para funcionar normalmente al alcanzar el límite de memoria.
Problemas de RDB y AOF
Aunque Redis almacena toda la información en la memoria RAM, también hay un mecanismo para guardarla en disco. Más precisamente, hay tres mecanismos:
- RDB-snapshot — un volcado completo de todos los datos. Se establece mediante la configuración SAVE X Y y se lee como 'Guardar un volcado completo de todos los datos cada X segundos, si al menos Y claves han cambiado'.
- Archivo de solo anexado — lista de operaciones en el orden en que se ejecutaron. Agrega las nuevas operaciones llegadas al archivo cada X segundos o cada Y operaciones.
- RDB y AOF — combinación de los dos anteriores.
Todos los métodos tienen sus ventajas y desventajas, no voy a enumerarlas todas, solo señalaré los puntos que me parecen poco obvios.
En primer lugar, para guardar un volcado RDB se requiere llamar a FORK. Si hay muchos datos, esto puede hacer que todo Redis se congele durante un período que va de unos pocos milisegundos a un segundo. Además, el sistema necesita reservar memoria para dicho volcado, lo que lleva a la necesidad de mantener en la máquina lógica un doble suministro de memoria RAM: si Redis tiene asignados 8 GB, entonces en la máquina virtual con él debe haber 16 GB disponibles.
En segundo lugar, hay problemas con la sincronización parcial. En modo AOF, al reconectar el esclavo, en lugar de sincronización parcial puede realizarse una sincronización completa. No he podido entender por qué sucede esto. Pero es importante tenerlo en cuenta.
Estos dos puntos ya nos hacen cuestionar si realmente necesitamos estos datos en disco, dado que ya están duplicados por los esclavos. Solo se pueden perder datos si todos los esclavos fallan, y eso es un problema de nivel "incendio en el centro de datos". Como compromiso, se podría proponer guardar datos solo en los esclavos, pero en ese caso hay que asegurarse de que esos esclavos nunca se conviertan en maestros durante la recuperación de emergencia (para esto hay una configuración de prioridad para los esclavos en su configuración). En cada caso específico, consideramos si es necesario guardar datos en disco, y la mayoría de las veces respondemos "no."
Conclusión
En conclusión, espero haber dado una idea general sobre el funcionamiento de redis-cluster a quienes no lo conocían, así como haber señalado algunos aspectos que pueden no ser obvios para quienes ya lo utilizan desde hace tiempo.
Gracias por su tiempo y, como siempre, se agradecen los comentarios sobre el tema.
Fuente: habr.com
