

El 10 de agosto comenzó en Slerm , en el cual lo analizamos por completo, desde las abstracciones básicas hasta los parámetros de la red.
En este artículo hablaremos sobre la historia de Docker y sus principales abstracciones: Image, CLI, Dockerfile. La conferencia está dirigida a principiantes, por lo que probablemente no interesará a los usuarios experimentados. No habrá sangre, apendicitis ni una profunda inmersión. Solo lo más básico.
¿Qué es Docker?
Veamos la definición de Docker de Wikipedia.
Docker es un software para la automatización del despliegue y la gestión de aplicaciones en entornos compatibles con la contenerización.
De esta definición no se entiende nada. Especialmente no queda claro qué significa «en entornos compatibles con la contenerización». Para entenderlo, volvamos al pasado. Comencemos por la época que llamo 'la era monolítica'.
Era monolítica
La era monolítica es a principios de los 2000, cuando todas las aplicaciones eran monolíticas, con un montón de dependencias. El desarrollo tomaba tiempo. Además, no había tantos servidores, todos los conocíamos por nombre y los monitoreábamos. Hay una comparación divertida:
Las mascotas son animales domésticos. En la era monolítica, tratábamos a nuestros servidores como a mascotas, cuidándolos y mimándolos, soplando el polvo. Para gestionar mejor los recursos, utilizábamos virtualización: tomábamos un servidor y lo dividíamos en varias máquinas virtuales, garantizando así el aislamiento del entorno.
Sistemas de virtualización basados en hipervisores
Seguro que todos han oído hablar de sistemas de virtualización: VMware, VirtualBox, Hyper-V, Qemu KVM, etc. Proporcionan aislamiento de aplicaciones y gestión de recursos, pero también tienen desventajas. Para implementar la virtualización, se necesita un hipervisor. Y el hipervisor implica un sobrecosto de recursos. Además, la máquina virtual suele ser un gran bicho: una imagen pesada, con su sistema operativo, Nginx, Apache, tal vez MySQL. La imagen es grande y es incómodo operar con máquinas virtuales. Como consecuencia, trabajar con virtualizaciones puede ser lento. Para solucionar este problema, se crearon sistemas de virtualización a nivel de núcleo.
Sistemas de virtualización a nivel de núcleo
La virtualización a nivel de núcleo es soportada por sistemas como OpenVZ, Systemd-nspawn, LXC. Un ejemplo destacado de esta virtualización es LXC (Linux Containers).
LXC — un sistema de virtualización a nivel de sistema operativo para ejecutar múltiples instancias aisladas del sistema operativo Linux en un solo nodo. LXC no utiliza máquinas virtuales, sino que crea un entorno virtual con su propio espacio de procesos y pila de red.
Esencialmente, LXC crea contenedores. ¿Cuál es la diferencia entre máquinas virtuales y contenedores?
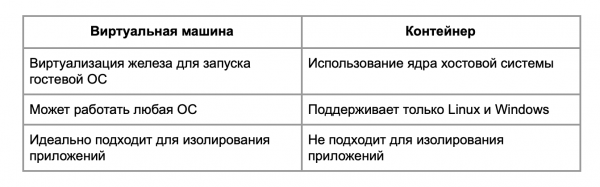
Un contenedor no es adecuado para aislar procesos: en los sistemas de virtualización a nivel de núcleo se encuentran vulnerabilidades que permiten salir del contenedor al host. Por lo tanto, si necesitas aislar algo, es mejor usar una máquina virtual.
Las diferencias entre virtualización y contenedorización se pueden ver en el esquema.
Existen hipervisores de hardware, hipervisores sobre sistemas operativos y contenedores.
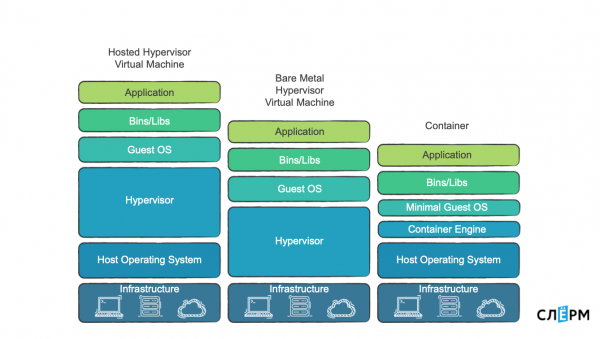
Los hipervisores 'de hierro' son una gran herramienta si realmente quieres aislar algo. Porque hay posibilidad de aislamiento a nivel de páginas de memoria y procesadores.
Existen hipervisores como programas, y hay contenedores, de los cuales vamos a hablar a continuación. En los sistemas de contenedorización no hay hipervisor, sino un Motor de Contenedores que crea y gestiona los contenedores. Esta es una tecnología más ligera, por lo que, gracias a su trabajo con el núcleo, la sobrecarga es menor o no existe en absoluto.
Lo que se utiliza para la contenedorización a nivel de núcleo
Las principales tecnologías que permiten crear un contenedor aislado de otros procesos son Namespaces y Control Groups.
Namespaces: PID, Networking, Mount y User. Hay más, pero para simplicidad nos detendremos en estos.
El Namespace PID limita los procesos. Cuando, por ejemplo, creamos un Namespace PID y colocamos un proceso allí, se convierte en PID 1. Normalmente, en los sistemas PID 1 es systemd o init. Por lo tanto, cuando colocamos un proceso en un nuevo namespace, también recibe PID 1.
El Networking Namespace permite restringir/aislar la red y colocar sus interfaces dentro de él. Mount es la restricción del sistema de archivos. User es la restricción de usuarios.
Control Groups: Memoria, CPU, IOPS, Red — en total hay alrededor de 12 configuraciones. También se les llama Cgroups ("C grupos").
Los Control Groups gestionan los recursos para el contenedor. A través de los Control Groups podemos decir que el contenedor no debe consumir más de cierta cantidad de recursos.
Para que la contenedorización funcione plenamente, se utilizan tecnologías adicionales: Capabilities, Copy-on-write y otras.
Capabilities significa que le decimos al proceso lo que puede hacer y lo que no. A nivel del núcleo, son simplemente mapas de bits con numerosos parámetros. Por ejemplo, el usuario root tiene privilegios completos y puede hacer todo. El servidor de tiempo puede cambiar la hora del sistema: tiene capacidades en Time Capsule, y eso es todo. A través de los privilegios, se pueden configurar restricciones flexibles para los procesos, asegurando así una mayor seguridad.
El sistema Copy-on-write nos permite trabajar con imágenes de Docker de manera más eficiente.
Actualmente, Docker tiene problemas con la compatibilidad de Cgroups v2, por lo que este artículo se centra en Cgroups v1.
Pero volvamos a la historia.
Cuando surgieron los sistemas de virtualización a nivel de núcleo, comenzaron a utilizarse activamente. Se eliminó la sobrecarga en el hipervisor, pero algunos problemas persistieron:
- imágenes grandes: en OpenVZ se empujan sistemas operativos, bibliotecas y un montón de software diverso, y al final la imagen sigue siendo considerablemente grande;
- no hay un estándar adecuado para empaquetar y entregar, por lo que permanece el problema de las dependencias. Hay situaciones en las que dos trozos de código utilizan una biblioteca, pero con versiones diferentes. Puede haber un conflicto entre ellas.
Para resolver todos estos problemas, llegó la siguiente era.
La era de los contenedores
Cuando llegó la Era de los contenedores, cambió la filosofía de trabajo con ellos:
- Un proceso — un contenedor.
- Todas las dependencias necesarias para el proceso se entregan en su contenedor. Esto requiere descomponer monolitos en microservicios.
- Cuanto más pequeña sea la imagen, mejor; menos vulnerabilidades posibles, más rápido se despliega, y así sucesivamente.
- Las instancias se vuelven efímeras.
Recuerden, dije algo sobre mascotas vs ganado? Antes, las instancias eran similares a mascotas, pero ahora son como ganado. Antes había un monolito — una aplicación. Ahora son 100 microservicios, 100 contenedores. Algunos contenedores pueden tener 2-3 réplicas. Ya no es tan importante controlar cada contenedor. Lo que realmente importa es la disponibilidad del servicio en sí: lo que hace este conjunto de contenedores. Esto cambia los enfoques en el monitoreo.
En 2014-2015, se produjo el auge de Docker — la tecnología de la que hablaremos ahora.
Docker ha cambiado la filosofía y estandarizado el empaquetado de aplicaciones. Con Docker, podemos empaquetar una aplicación, enviarla a un repositorio, descargarla de allí y desplegarla.
En un contenedor de Docker incluimos todo lo necesario, por lo que se resuelve el problema de las dependencias. Docker garantiza la reproducibilidad. Creo que muchos se han encontrado con la falta de reproducibilidad: todo funciona bien en tu máquina, lo subes a producción y deja de funcionar. Con Docker, este problema se elimina. Si tu contenedor Docker se inicia y hace lo que debe hacer, hay una alta probabilidad de que funcione en producción y haga lo mismo allí.
Una digresión sobre el overhead
Sobre el overhead hay debates constantes. Algunos consideran que Docker no implica una carga adicional, ya que utiliza el núcleo de Linux y todos sus procesos necesarios para la contenedorización. Dicen que 'si afirmas que Docker es overhead, entonces el núcleo de Linux también lo es'.
Por otro lado, si profundizamos, en Docker hay algunas cosas que, con cierta reticencia, se pueden considerar como overhead.
La primera es el namespace PID. Cuando colocamos un proceso en un namespace, se le asigna el PID 1. Al mismo tiempo, este proceso tiene otro PID que se encuentra en el namespace del host, fuera del contenedor. Por ejemplo, si hemos lanzado Nginx en el contenedor, se convierte en el PID 1 (proceso maestro). Y en el host, su PID es 12623. Es difícil decir cuán significativo es esto como overhead.
La segunda cuestión son los Cgroups. Tomemos los Cgroups de memoria, es decir, la posibilidad de limitar la memoria de un contenedor. Al activarlo, se activan contadores, contabilidad de memoria: el núcleo necesita entender cuántas páginas han sido asignadas y cuántas quedan libres para ese contenedor. Esto podría ser overhead, pero no he encontrado investigaciones precisas sobre cómo afecta al rendimiento, y yo mismo no he notado que una aplicación ejecutándose en Docker de repente pierda rendimiento.
Y un último comentario sobre el rendimiento. Algunos parámetros del núcleo se transfieren del host al contenedor. En particular, algunos parámetros de red. Por lo tanto, si deseas ejecutar algo de alto rendimiento en Docker, por ejemplo, algo que use intensivamente la red, al menos deberías ajustar esos parámetros. Por ejemplo, nf_conntrack.
Sobre el concepto de Docker
Docker consta de varios componentes:
- Docker Daemon — el motor de contenedores; ejecuta contenedores.
- Docker CII — la utilidad para gestionar Docker.
- Dockerfile — instrucciones sobre cómo construir una imagen.
- Imagen — la imagen que se despliega en el contenedor.
- Contenedor.
- Docker registry — almacenamiento de imágenes.
Esquemáticamente, se ve aproximadamente así:
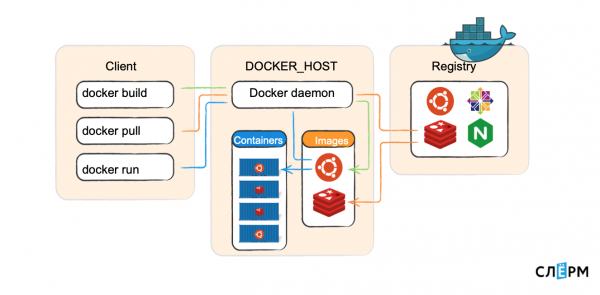
En Docker_host, funciona el daemon de Docker, que lanza contenedores. Hay un cliente que envía comandos: construir imagen, descargar imagen, ejecutar contenedor. El daemon de Docker accede al registry y ejecuta esos comandos. El cliente de Docker puede comunicarse localmente (a través de un socket Unix) y por TCP desde un host remoto.
Vamos a revisar cada componente.
Docker daemon (daemon) — es la parte del servidor, funciona en la máquina host: descarga imágenes y lanza contenedores a partir de ellas, crea redes entre contenedores, recopila registros. Cuando decimos 'crea una imagen', el daemon también se encarga de esto.
Docker CLI — la parte cliente de Docker, una herramienta de línea de comandos para trabajar con el daemon. Repito, puede funcionar no solo localmente, sino también a través de la red.
Comandos básicos:
docker ps — muestra los contenedores que están actualmente en ejecución en el host de Docker.
docker images — muestra las imágenes descargadas localmente.
docker search — busca una imagen en el registry.
docker pull — descarga una imagen del registry a la máquina.
docker build <> — construye una imagen.
docker run — ejecuta el contenedor.
docker rm — elimina el contenedor.
docker logs — registros del contenedor.
docker start/stop/restart — gestionar el contenedor.
Si dominas estos comandos y los usas con confianza, considera que has dominado Docker al 70% a nivel de usuario.
Dockerfile — instrucciones para crear una imagen. Casi cada comando de las instrucciones es una nueva capa. Veamos un ejemplo.
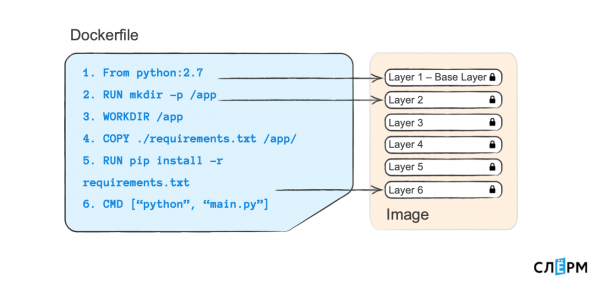
Así es como se ve un Dockerfile: a la izquierda están los comandos, a la derecha — los argumentos. Cada comando que hay (y que se escribe en el Dockerfile) crea una nueva capa en la imagen.
Incluso mirando la parte izquierda, se puede entender aproximadamente lo que está sucediendo. Decimos: 'crea una carpeta' — eso es una capa. 'Haz la carpeta de trabajo' — esa es otra capa, y así sucesivamente. La estructura en capas facilita la vida. Si creo otro Dockerfile y en la última línea cambio algo — ejecutaré no "python" "main.py", sino algo diferente, o instalaré dependencias desde otro archivo — entonces las capas anteriores se reutilizarán, como en caché.
Imagen — es un paquete de contenedor, desde el cual se inician los contenedores. Si vemos Docker desde la perspectiva de un gestor de paquetes (como si estuviéramos trabajando con paquetes deb o rpm), entonces la imagen es esencialmente un paquete rpm. A través de yum install podemos instalar una aplicación, eliminarla, encontrarla en el repositorio, descargarla. Aquí es algo similar: los contenedores se inician desde la imagen, se almacenan en el Docker registry (analogía con yum, en el repositorio), y cada imagen tiene un hash SHA-256, un nombre y una etiqueta.
La imagen se crea según las instrucciones del Dockerfile. Cada instrucción del Dockerfile crea una nueva capa. Las capas pueden ser reutilizadas.
Docker registry — es un repositorio de imágenes Docker. Analogía con los sistemas operativos, Docker tiene un registro estándar público — dockerhub. Pero también se puede construir su propio repositorio, su propio Docker registry.
Contenedor — es lo que se inicia desde la imagen. Se creó la imagen según las instrucciones del Dockerfile, luego la iniciamos desde esta imagen. Este contenedor está aislado de otros contenedores y debe contener todo lo necesario para el funcionamiento de la aplicación. A su vez, un contenedor — un proceso. A veces es necesario crear dos procesos, pero eso contraviene un poco la ideología de Docker.
El requisito "un contenedor — un proceso" está relacionado con el PID Namespace. Cuando un proceso con PID 1 se inicia en un Namespace, si de repente muere, todo el contenedor también muere. Sin embargo, si hay dos procesos en marcha: uno vive y el otro muere, el contenedor seguirá estando vivo. Pero eso se refiere a las Mejoras Prácticas, hablaremos de ellas en otros materiales.
Puedes estudiar en detalle las características y el programa completo del curso en el siguiente enlace: «».
Autor: Marsel Ibraev, administrador de Kubernetes certificado, ingeniero en práctica en la empresa Southbridge, conferencista y desarrollador de cursos Slyrm.
Fuente: habr.com
