

Este artículo recopila algunas plantillas comunes que ayudan a los ingenieros a trabajar con servicios a gran escala que son solicitados por millones de usuarios.
Según la experiencia del autor, esta no es una lista exhaustiva, pero realmente son consejos eficaces. Así que, comencemos.
Traducido con el apoyo de .
Nivel inicial
Las medidas enumeradas a continuación son relativamente simples de implementar, pero brindan altos beneficios. Si nunca las has llevado a cabo, te sorprenderán las mejoras significativas.
Infraestructura como código
La primera parte de los consejos consiste en implementar infraestructuras como código. Esto significa que deberías tener una forma programática de implementar toda la infraestructura. Suena complicado, pero en realidad estamos hablando del siguiente código:
Desplegar 100 máquinas virtuales
- con Ubuntu
- 2 GB de RAM cada una
- tendrán el siguiente código
- con esos parámetros
Puedes rastrear los cambios en la infraestructura y volver rápidamente a ellos mediante un sistema de control de versiones.
El modernista que hay en mí dice que puedes usar Kubernetes/Docker para hacer todo lo mencionado anteriormente, y tiene razón.
Además, puedes lograr la automatización utilizando Chef, Puppet o Terraform.
Integración y entrega continua
Para crear un servicio escalable, es importante tener un canal de construcción y pruebas para cada pull request. Aunque la prueba sea la más sencilla, al menos garantiza que el código que estás desplegando se compila.
En cada etapa, te haces la pregunta: ¿se compilará mi construcción y pasará las pruebas, es válida? Esto puede parecer una meta baja, pero resuelve muchos problemas.
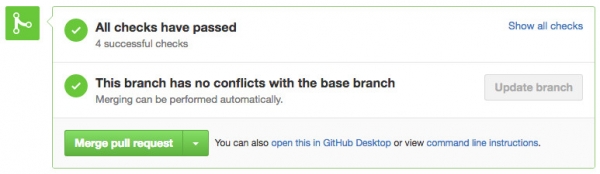
No hay nada más hermoso que ver esas marcas de verificación
Para esta tecnología, puedes considerar Github, CircleCI o Jenkins.
Balanceadores de carga
Así que, queremos lanzar un balanceador de carga para redirigir el tráfico y asegurar una carga equitativa en todos los nodos o el funcionamiento del servicio en caso de falla:
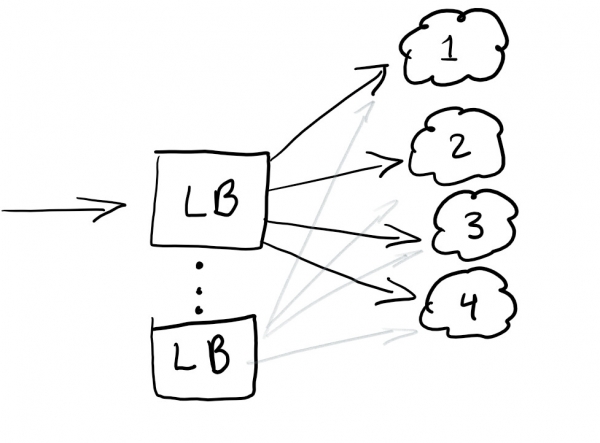
El balanceador de carga suele ayudar a distribuir el tráfico. La mejor práctica es la sobrebalanza, para que no tengas un único punto de fallo.
Por lo general, los balanceadores de carga se configuran en la nube que estés utilizando.
RayID, ID de correlación o UUID para solicitudes
¿Alguna vez te has encontrado con un error en la aplicación que dice algo así? «Algo salió mal. Guarda este id y envíalo a nuestro servicio de soporte»?
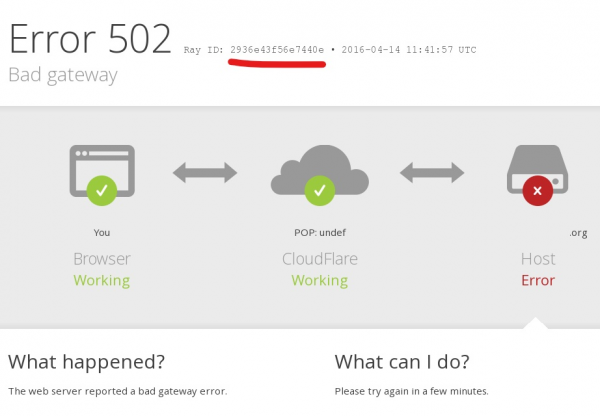
El identificador único, correlation ID, RayID o cualquiera de sus variantes, es un identificador único que permite rastrear una solicitud a lo largo de su ciclo de vida. Esto permite rastrear todo el recorrido de la solicitud en los registros.
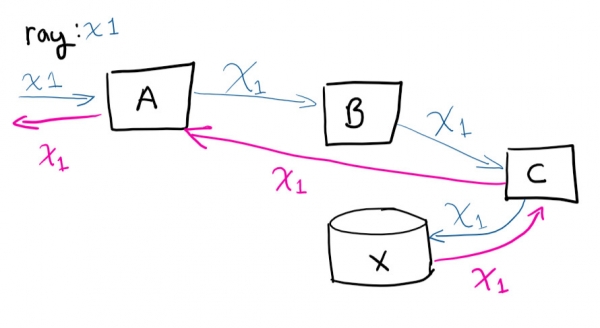
El usuario hace una solicitud al sistema A, luego A se comunica con B, B se comunica con C, guarda en X y después la solicitud regresa a A.
Si te conectaras de forma remota a las máquinas virtuales e intentaras seguir el camino de la solicitud (y manualmente relacionar qué llamadas se están realizando), te volverías loco. Tener un identificador único facilita mucho la vida. Es una de las cosas más simples que se pueden hacer para ahorrar tiempo a medida que el servicio crece.
Nivel medio
Aquí, los consejos son más complejos que los anteriores, pero las herramientas adecuadas facilitan la tarea, proporcionando un retorno de inversión incluso para pequeñas y medianas empresas.
Registro centralizado
¡Felicidades! Has desplegado 100 máquinas virtuales. Al día siguiente, el director general llega y se queja de un error que obtuvo durante las pruebas del servicio. Él proporciona el identificador relevante del que hablamos anteriormente, pero tendrás que revisar los registros de 100 máquinas para encontrar aquella que causó la falla. Y necesitas encontrarla antes de la presentación de mañana.
Aunque suena como una divertida aventura, es mejor asegurarse de que tienes la capacidad de buscar en todos los registros desde un solo lugar. Resolví el problema de la centralización de registros utilizando la funcionalidad integrada del stack ELK: aquí se soporta la recopilación de registros con capacidad de búsqueda. Esto realmente ayudará a resolver el problema de encontrar un registro específico. Como bono, puedes crear gráficos y cosas divertidas similares.
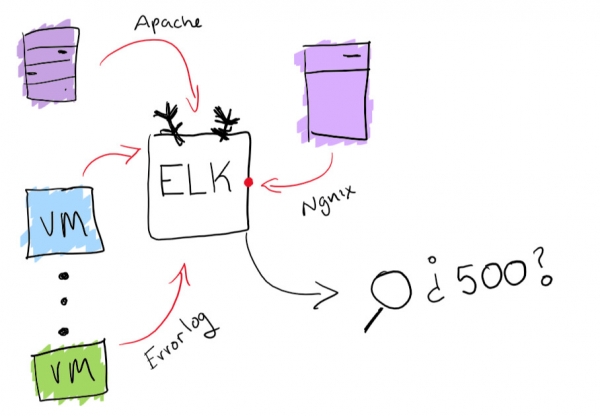
Funcionalidad del stack ELK
Agentes de monitoreo
Ahora que tu servicio está en funcionamiento, debes asegurarte de que funcione sin problemas. La mejor manera de hacerlo es ejecutar varios agentes, que funcionen en paralelo y verifiquen que está operando y que se realizan las operaciones básicas.
En esta etapa, verificas que La versión implementada se siente bien y funciona correctamente.
Para proyectos pequeños y medianos, recomiendo Postman para monitorear y documentar API. Pero en general, solo asegúrese de tener una forma de saber cuándo ocurre un fallo y recibir una alerta oportuna.
Escalado automático según la carga
Es muy sencillo. Si tiene una máquina virtual que atiende solicitudes y se acerca a tener el 80% de la memoria ocupada, puede aumentar sus recursos o añadir más máquinas virtuales al clúster. La automatización de estas operaciones es ideal para ajustar la capacidad en función de la carga. Sin embargo, siempre debe tener cuidado con cuánto gasta y establecer límites razonables.
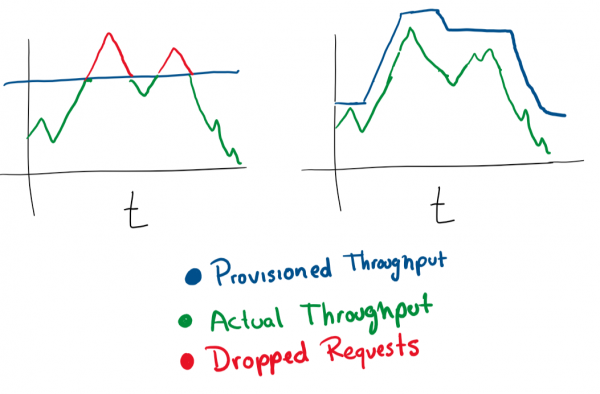
En la mayoría de los servicios en la nube, puede configurar el escalado automático utilizando más servidores o servidores más potentes.
Sistema de experimentos
Una buena forma de desplegar actualizaciones de forma segura es poder probar algo para el 1% de los usuarios durante una hora. Seguro que ha visto estos mecanismos en acción. Por ejemplo, Facebook muestra a parte de su audiencia un color diferente o cambia el tamaño de la fuente para ver cómo perciben los usuarios los cambios. Esto se llama prueba A/B.
Incluso el lanzamiento de una nueva función puede realizarse como un experimento y luego decidir cómo implementarla. Además, tiene la posibilidad de 'revertir' o cambiar la configuración sobre la marcha en función de una función que cause degradación en su servicio.
Nivel avanzado
Aquí hay consejos que son bastante difíciles de implementar. Probablemente necesitará un poco más de recursos, por lo que a una pequeña o mediana empresa le resultará complicado manejarlo.
Despliegues azul-verde
Esto es lo que llamo un método de despliegue ‘erlang’. Erlang se popularizó mucho cuando aparecieron las empresas telefónicas. Se empezaron a utilizar conmutadores de software para la ruta de las llamadas telefónicas. La tarea principal de este software es no cortar las llamadas durante la actualización del sistema. Erlang tiene una excelente manera de cargar un nuevo módulo sin detener el anterior.
Este paso depende de la disponibilidad de un balanceador de carga. Supongamos que tiene la versión N de su software y luego quiere desplegar la versión N+1.
Usted podría simplemente detener el servicio y desplegar la siguiente versión en el momento que considere conveniente para sus usuarios, y obtener algo de tiempo de inactividad. Pero supongamos que tiene realmente condiciones estrictas de SLA. Así, un SLA del 99,99% significa que puede estar fuera de línea solo durante 52 minutos al año.
Si realmente desea alcanzar tales métricas, necesita dos despliegues simultáneos:
- el que tiene en este momento (N);
- la siguiente versión (N+1).
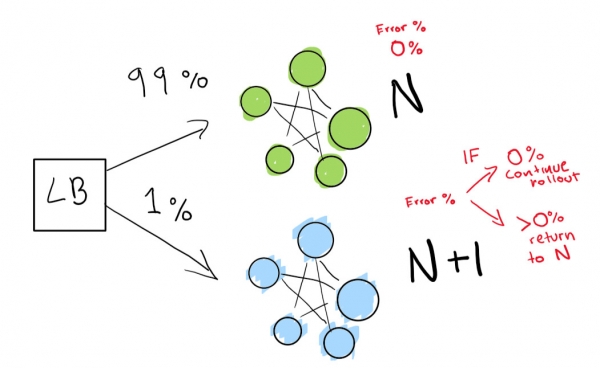
Indica al balanceador de carga que dirija un porcentaje del tráfico a la nueva versión (N+1), mientras tú monitoreas activamente las regresiones.
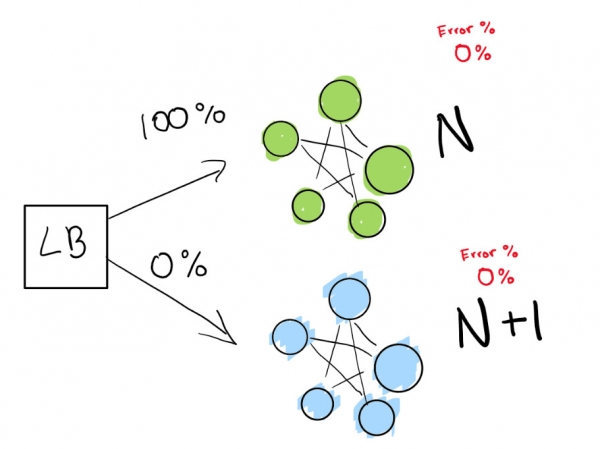
Aquí tenemos un despliegue verde N que funciona normalmente. Estamos tratando de pasar a la siguiente versión de este despliegue
Primero enviamos una prueba realmente pequeña para ver si nuestro despliegue N+1 funciona con una pequeña cantidad de tráfico:
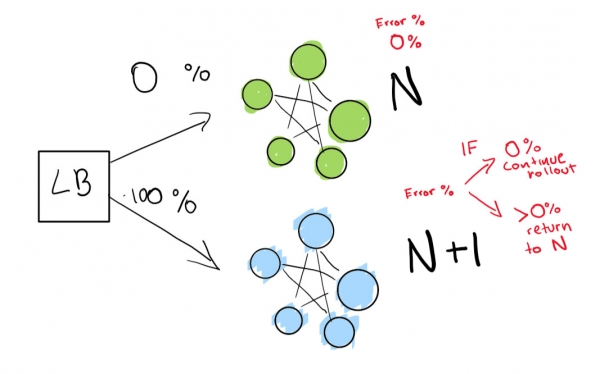
Finalmente, tenemos un conjunto de comprobaciones automáticas que ejecutamos hasta que nuestro despliegue esté completo. Si eres muy, muy cuidadoso, también puedes mantener tu despliegue N para siempre para un retroceso rápido en caso de una mala regresión:
Si quieres llevarlo a un nivel más avanzado, deja que todo en el despliegue azul-verde se realice automáticamente.
Detección de anomalías y mitigación automática
Dado que tiene un registro centralizado y una buena recopilación de logs, ya puede establecer metas más altas. Por ejemplo, predecir proactivamente fallos. En los monitores y logs se rastrean funciones y se construyen diferentes gráficos, y se puede predecir con antelación qué podría salir mal:
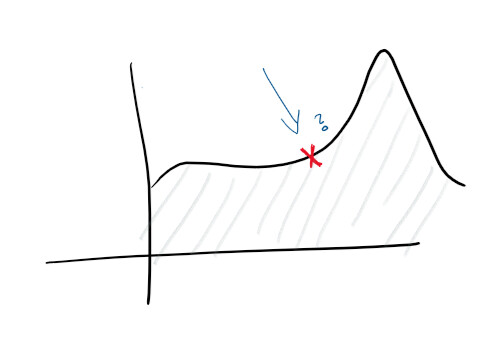
Con la detección de anomalías, comienzas a estudiar algunas pistas que da el servicio. Por ejemplo, un pico de carga en la CPU puede indicar que el disco duro está fallando, mientras que un aumento en la cantidad de solicitudes significa que se necesita escalar. Este tipo de datos estadísticos permite que el servicio sea proactivo.
Al obtener estos datos analíticos, puede escalar en cualquier dimensión, ajustando de manera proactiva y reactiva las características de las máquinas, bases de datos, conexiones y otros recursos.
¡Eso es todo!
Esta lista de prioridades lo liberará de muchos problemas al escalar su servicio en la nube.
El autor del artículo original invita a los lectores a dejar sus comentarios y realizar modificaciones. El artículo se distribuye como código abierto, las solicitudes de extracción se aceptan .
Qué más leer sobre el tema:
Fuente: habr.com
