

Autor: Sergey Lukyanchikov, ingeniero consultor de InterSystems
Desafíos de los cálculos de IA/ML en tiempo real
Comencemos con ejemplos de la práctica de Data Science de InterSystems:
- Un portal de cliente "cargado" está conectado a un sistema de recomendación en línea. Se planea una reestructuración de las promociones a nivel de la red minorista (por ejemplo, en lugar de una línea de promociones "plana", ahora se aplicará una matriz "segmento-táctica"). ¿Qué sucede con los mecanismos de recomendación? ¿Qué sucede con la presentación y actualización de datos en el mecanismo de recomendación (el volumen de datos de entrada ha aumentado 25000 veces)? ¿Qué sucede con la generación de recomendaciones (la necesidad de reducir mil veces el umbral de filtrado de las reglas de recomendación debido a un aumento mil veces en su número y "variedad")?
- Hay un sistema de monitoreo de la probabilidad de desarrollo de defectos en los nodos de equipos. Se conectó un sistema de control automático, que envía miles de parámetros del proceso tecnológico cada segundo. ¿Qué ocurre con el sistema de monitoreo, que anteriormente funcionaba con "muestras manuales" (¿puede proporcionar un monitoreo de probabilidad cada segundo)? ¿Qué pasará si los datos de entrada incluyen un nuevo bloque de varios cientos de columnas con lecturas de sensores recientemente introducidos en el sistema de control automático (¿se necesitará y por cuánto tiempo detener el sistema de monitoreo para incluir en el análisis los datos de nuevos sensores)?
- Se ha creado un complejo de mecanismos de IA/ML (recomendaciones, monitoreo, pronósticos) que utilizan los resultados del trabajo de los demás. ¿Cuántas horas-hombre se necesitan mensualmente para adaptar el funcionamiento de este complejo a los cambios en los datos de entrada? ¿Cuál es la "desaceleración" total al apoyar la toma de decisiones de gestión (la frecuencia con la que surge nueva información de apoyo en relación a la frecuencia de nuevos datos de entrada)?
Resumiendo estos y muchos otros ejemplos, hemos llegado a formular los desafíos que surgen al pasar a utilizar mecanismos de aprendizaje automático e inteligencia artificial en tiempo real:
- ¿Nos satisface la velocidad de creación y adaptación (a la situación cambiante) de los desarrollos de AI/ML en nuestra empresa?
- ¿En qué medida las soluciones de AI/ML que utilizamos apoyan la gestión empresarial en tiempo real?
- ¿Son capaces las soluciones de AI/ML que utilizamos de adaptarse de forma autónoma (sin desarrolladores) a los cambios en los datos y en la práctica de la gestión empresarial?
Nuestro artículo es un análisis exhaustivo de las capacidades de la plataforma InterSystems IRIS en términos de soporte universal para el despliegue de mecanismos de AI/ML, la integración de soluciones de AI/ML y el entrenamiento (pruebas) de soluciones de AI/ML en flujos de datos intensivos. Abordaremos investigaciones de mercado, ejemplos prácticos de soluciones de AI/ML y aspectos conceptuales de lo que llamamos en este artículo plataforma de AI/ML en tiempo real.
Lo que se conoce a partir de las encuestas: aplicaciones en tiempo real
Resultados , realizadas entre alrededor de 800 profesionales de IT en 2019 por Lightbend, hablan por sí solas:
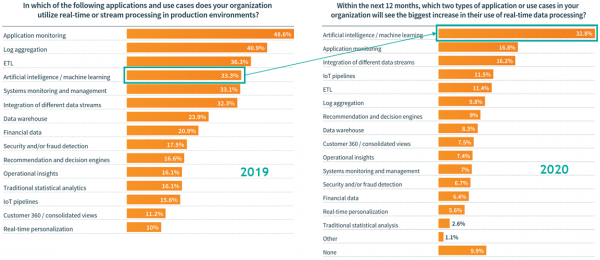
Figura 1 Principales consumidores de datos en tiempo real
Citemos fragmentos importantes del informe sobre los resultados de esta encuesta en nuestra traducción:
«… Las tendencias en la popularidad de las herramientas de integración de flujos de datos y, al mismo tiempo, el apoyo a los cálculos en contenedores ofrecen una respuesta sinérgica a la demanda del mercado de propuestas más rápidas, racionales y dinámicas de soluciones efectivas. Los flujos de datos permiten transmitir información más rápidamente que los datos por lotes tradicionales. Esto se complementa con la capacidad de aplicar rápidamente métodos computacionales, como, por ejemplo, recomendaciones basadas en AI/ML, creando ventajas competitivas a través del aumento de la satisfacción del público cliente. La carrera por la velocidad también impacta en todos los roles dentro del paradigma DevOps, mejorando la eficiencia en el desarrollo y la implementación de aplicaciones. … Ochocientos cuatro especialistas en IT proporcionaron información sobre el uso de flujos de datos en sus organizaciones. Los encuestados se encontraban principalmente en países occidentales (41% en Europa y 37% en América del Norte) y estaban distribuidos casi uniformemente entre empresas pequeñas, medianas y grandes. …
La inteligencia artificial no es una moda. El cincuenta y ocho por ciento de aquellos que ya aplican el procesamiento de flujos de datos en aplicaciones productivas de AI/ML confirman que su uso en AI/ML experimentará el mayor crecimiento el próximo año (en comparación con otras aplicaciones).
- Según la mayoría de los encuestados, la aplicación de flujos de datos en escenarios de AI/ML tendrá el mayor crecimiento el próximo año.
- La aplicación en AI/ML crecerá no solo gracias a tipos de escenarios relativamente nuevos, sino también por escenarios tradicionales en los cuales los datos en tiempo real se utilizan de forma cada vez más intensa.
- Además de AI/ML, el nivel de entusiasmo entre los usuarios de pipelines de datos IoT es impresionante: el 48% de aquellos que ya han integrado datos IoT afirman que la implementación de escenarios basados en esos datos tendrá un crecimiento significativo en un futuro cercano. … »
De esta interesante encuesta se desprende que la percepción de los escenarios de aprendizaje automático e inteligencia artificial como líderes en el consumo de flujos de datos ya está «en camino». Pero una observación igualmente importante es la percepción de AI/ML en tiempo real a través de la óptica de DevOps: aquí ya se puede comenzar a hablar de la transformación de la cultura predominante de «AI/ML desechable con un conjunto de datos completamente accesibles».
El concepto de plataforma de AI/ML en tiempo real
Una de las áreas típicas de aplicación de AI/ML en tiempo real es la gestión de procesos tecnológicos en la producción. A partir de este ejemplo y considerando las reflexiones anteriores, formularemos el concepto de plataforma de AI/ML en tiempo real.
El uso de inteligencia artificial y aprendizaje automático en la gestión de procesos tecnológicos presenta una serie de particularidades:
- Los datos sobre el estado del proceso tecnológico llegan intensamente: con gran frecuencia y a través de un amplio espectro de parámetros (hasta decenas de miles de valores de parámetros transmitidos por segundo desde el sistema de control automático).
- Los datos sobre la detección de defectos, sin mencionar los datos sobre su evolución, por el contrario, son escasos e irregulares, caracterizados por una insuficiencia en la tipificación de defectos y su localización en el tiempo (a menudo, representan registros en papel).
- Desde un punto de vista práctico, para el entrenamiento y la aplicación de modelos, solo está disponible la «ventana de relevancia» de los datos de origen, que refleja la dinámica del proceso tecnológico durante un intervalo deslizante razonable, que termina con los últimos valores leídos de los parámetros del proceso.
Estas características nos obligan, además de recibir y procesar de manera básica en tiempo real la intensa «señal de entrada de banda ancha» del proceso tecnológico, a realizar (paralelamente) la aplicación, el entrenamiento y el control de calidad de los resultados del trabajo de modelos AI/ML, también en tiempo real. El «cuadro» que nuestros modelos «ven» en la ventana de relevancia cambia constantemente, y con ello también lo hace la calidad de los resultados obtenidos por los modelos AI/ML, que fueron entrenados en uno de esos «cuadros» en el pasado. Cuando la calidad de los resultados obtenidos por los modelos AI/ML se deteriora (por ejemplo: el valor del error de clasificación «alarma-norma» supera los límites que hemos establecido), se debe iniciar automáticamente el reentrenamiento de los modelos en un «cuadro» más relevante, y la elección del momento para iniciar el reentrenamiento debe considerar tanto la duración del mismo como la dinámica de la degradación de la calidad del actual versión de los modelos (ya que las versiones actuales de los modelos continúan aplicándose mientras los modelos se entrenan, y hasta que se formen sus versiones «reentrenadas»).
InterSystems IRIS cuenta con capacidades clave de plataforma para garantizar el funcionamiento de soluciones AI/ML en la gestión de procesos tecnológicos en tiempo real. Estas capacidades se pueden dividir en tres grupos principales:
- Despliegue continuo (Continuous Deployment/Delivery, CD) de nuevos mecanismos AI/ML adaptados o existentes en una solución productiva que funcione en tiempo real en la plataforma InterSystems IRIS.
- Integración continua (Continuous Integration, CI) de los flujos de datos de entrada del proceso tecnológico en una solución productiva única, colas de datos para la aplicación/entrenamiento/control de calidad de los mecanismos AI/ML, y el intercambio de datos/código/efectos de control con entornos de modelado matemático, cuya orquestación es realizada en tiempo real por la plataforma InterSystems IRIS.
- El entrenamiento continuo (auto-) de mecanismos AI/ML, llevado a cabo en entornos de modelado matemático utilizando datos, código y controles («decisiones tomadas»), es proporcionado por la plataforma InterSystems IRIS.
La clasificación de las capacidades de la plataforma en relación con el aprendizaje automático y la inteligencia artificial no es casual y se basa en grupos específicos. Citamos la metodología de la empresa Google, que establece la base conceptual para esta clasificación, en nuestra traducción:
«… El concepto de DevOps, popular en la actualidad, abarca el desarrollo y la operación de sistemas de información a gran escala. Las ventajas de implementar este concepto incluyen la reducción de la duración de los ciclos de desarrollo, el aceleramiento de la implementación de desarrollos y la flexibilidad en la planificación de lanzamientos. Para obtener estas ventajas, DevOps requiere la implementación de al menos dos prácticas:
- Integración Continua (CI)
- Entrega Continua (CD)
Estas prácticas también son aplicables a las plataformas AI/ML, con el objetivo de garantizar la creación confiable y productiva de soluciones AI/ML.
Las plataformas AI/ML se diferencian de otros sistemas de información en los siguientes aspectos:
- Competencias del equipo: al desarrollar una solución AI/ML, el equipo generalmente incluye científicos de datos o expertos 'académicos' en el campo de la investigación de datos, quienes llevan a cabo el análisis de datos, el desarrollo y la validación de modelos. Estos miembros del equipo pueden o no ser programadores profesionales de código productivo.
- Desarrollo: los mecanismos AI/ML son experimentales por su naturaleza. Para resolver un problema de la manera más eficiente, es necesario explorar diferentes combinaciones de variables de entrada, algoritmos, métodos de modelado y parámetros del modelo. La complejidad de este proceso radica en trazar 'qué funcionó/no funcionó', garantizar la reproducibilidad de los episodios y generalizar los desarrollos para implementaciones repetitivas.
- Pruebas: las pruebas de los mecanismos AI/ML requieren un espectro más amplio de pruebas que la mayoría de los otros desarrollos. Además de las pruebas modulares y de integración estándar, se evalúan la validez de los datos y la calidad de los resultados de la aplicación del modelo a conjuntos de datos de entrenamiento y de control.
- Despliegue: el despliegue de soluciones de AI/ML no se limita a servicios predictivos que utilizan un modelo entrenado una sola vez. Las soluciones de AI/ML se construyen en torno a canalizaciones de múltiples etapas que realizan el aprendizaje automatizado y la aplicación de modelos. El despliegue de estas canalizaciones implica la automatización de acciones no triviales que tradicionalmente realizaban manualmente los data scientists para poder entrenar y probar modelos.
- Productividad: los mecanismos de AI/ML pueden carecer de rendimiento no solo debido a programación ineficiente, sino también debido a la naturaleza en constante cambio de los datos de entrada. En otras palabras, el rendimiento de los mecanismos de AI/ML puede degradarse por una variedad más amplia de razones que el rendimiento de desarrollos convencionales. Esto lleva a la necesidad de monitorear (en tiempo real) el rendimiento de nuestros mecanismos de AI/ML, así como de enviar alertas o descartar resultados si las métricas de rendimiento no cumplen con las expectativas.
Las plataformas de AI/ML son similares a otros sistemas de información en que ambos requieren integración continua de código con control de versiones, pruebas modulares, pruebas de integración y despliegue continuo de desarrollos. Sin embargo, en el caso de AI/ML, hay algunas diferencias importantes:
- CI (Integración Continua) ya no se limita a la prueba y validación del código de los componentes desplegados; también incluye la prueba y validación de datos y modelos de AI/ML.
- CD (Entrega/Despliegue Continuo) no se limita a la escritura y lanzamiento de paquetes o servicios, sino que implica una plataforma para la composición, entrenamiento y aplicación de soluciones de AI/ML.
- CT (Entrenamiento Continuo) es un nuevo elemento [nota del autor: un nuevo elemento en relación con el concepto tradicional de DevOps, en el que CT generalmente se refiere a Pruebas Continuas], característico de las plataformas de AI/ML, que se encarga de la gestión autónoma de los mecanismos de entrenamiento y aplicación de modelos de AI/ML.
Podemos afirmar que el aprendizaje automático y la inteligencia artificial, que trabajan con datos en tiempo real, requieren un conjunto más amplio de herramientas y competencias (desde el desarrollo de código hasta la orquestación de entornos de modelado matemático), una integración más estrecha entre todas las áreas funcionales y temáticas, y una organización más eficiente de los recursos humanos y de máquina.
Escenario en tiempo real: reconocimiento del desarrollo de defectos en bombas de nutrientes
Continuando con el ejemplo del campo de control de procesos tecnológicos, consideremos una tarea específica (ya mencionada al principio): se requiere asegurar el monitoreo en tiempo real del desarrollo de defectos en las bombas basado en el flujo de valores de los parámetros del proceso tecnológico y los informes del personal de mantenimiento sobre los defectos encontrados.
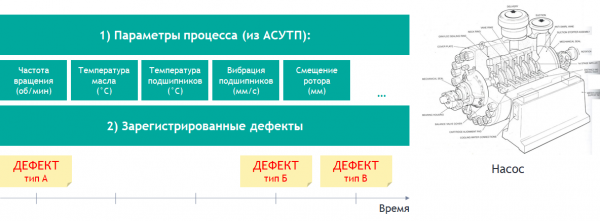
Figura 2 Formulación de la tarea de monitoreo del desarrollo de defectos
La característica de la mayoría de las tareas planteadas de esta manera en la práctica es que la regularidad y la puntualidad de la llegada de datos (Sistemas de Control de Procesos Automatizados) deben considerarse en el contexto de la episodicidad y la irregularidad de la aparición (y registro) de defectos de varios tipos. En otras palabras: los datos de los Sistemas de Control de Procesos Automatizados llegan cada segundo de manera correcta y precisa, mientras que sobre los defectos se hacen anotaciones con lápiz químico indicando la fecha en un cuaderno general en el taller (por ejemplo: "12.01 – fuga en la tapa del lado del tercer rodamiento").
Así, se puede complementar la formulación de la tarea con esta importante restricción: la "etiqueta" de un defecto de un tipo específico es única para nosotros (es decir, el ejemplo de un defecto de un tipo específico está representado por datos del Sistema de Control de Procesos Automatizados en una fecha concreta – y no tenemos más ejemplos de un defecto de este tipo). Esta restricción nos saca de los límites del aprendizaje automático clásico (aprendizaje supervisado), para el cual debe haber muchas "etiquetas".
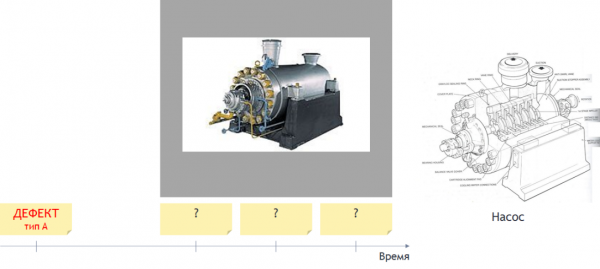
Figura 3 Aclaración de la tarea de monitoreo del desarrollo de defectos
¿Podemos de alguna manera "multiplicar" la única "etiqueta" que tenemos a nuestra disposición? Sí, podemos. El estado actual de la bomba se caracteriza por el grado de similitud con los defectos registrados. Incluso sin aplicar métodos cuantitativos, a simple vista, al observar la dinámica de los valores de los datos que llegan de la ASUTP, ya se puede extraer mucha información:
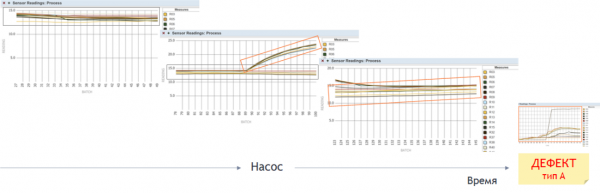
Figura 4 Dinámica del estado de la bomba en relación con la "etiqueta" del defecto del tipo especificado
Pero la percepción visual (al menos por ahora) no es el generador más adecuado de "etiquetas" en nuestro escenario en rápida evolución. Vamos a evaluar la similitud del estado actual de la bomba con los defectos registrados mediante una prueba estadística.
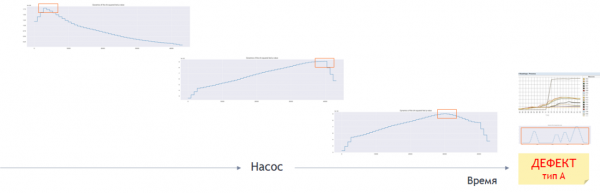
Figura 5 Aplicación de la prueba estadística a los datos entrantes en relación con la "etiqueta" del defecto
La prueba estadística determina la probabilidad de que los registros con valores de los parámetros del proceso tecnológico en el "flujo-paquete" obtenido de la ASUTP sean similares a los registros de la "etiqueta" del defecto de un tipo específico. El valor de probabilidad calculado como resultado de la aplicación de la prueba estadística se transforma en un valor de 0 o 1, convirtiéndose en una "etiqueta" para el aprendizaje automático en cada registro específico en el paquete bajo investigación. Es decir, después de procesar un nuevo paquete de registros del estado de la bomba mediante la prueba estadística, tenemos la posibilidad de (a) añadir este paquete al conjunto de entrenamiento para entrenar el modelo de AI/ML y (b) llevar a cabo el control de calidad del funcionamiento de la versión actual del modelo al aplicarlo a este paquete.
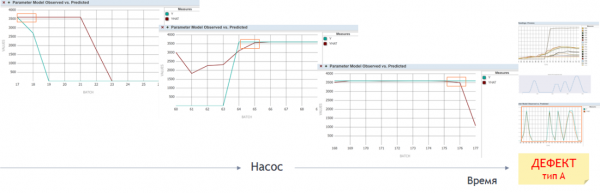
Figura 6 Aplicación del modelo de aprendizaje automático a los datos entrantes en relación con la "etiqueta" del defecto
En uno de nuestros seminarios web anteriores Mostramos y explicamos cómo la plataforma InterSystems IRIS permite realizar cualquier mecanismo de IA/ML en forma de procesos de negocio ejecutados continuamente, los cuales llevan a cabo el control de la veracidad de los resultados de la simulación y adaptan los parámetros de los modelos. Al implementar el prototipo de nuestro escenario con bombas, utilizamos toda la funcionalidad presentada durante el seminario web de InterSystems IRIS, implementando en el procesador de análisis en nuestro solución no un aprendizaje supervisado clásico, sino más bien un aprendizaje por refuerzo (reinforcement learning), que gestiona automáticamente la selección para el entrenamiento de modelos. En la muestra para el entrenamiento se incluyen registros donde se produce un «consenso de detección» tras aplicar tanto la prueba estadística como la versión actual del modelo, es decir, tanto la prueba estadística (después de transformar el índice de similaridad a 0 o 1) como el modelo dieron un resultado de 1 en esos registros. Al nuevo entrenar el modelo, durante su validación (el modelo reentrenado se aplica a su propia muestra de entrenamiento, con la aplicación previa de la prueba estadística), se eliminan de la muestra de entrenamiento los registros que «no retuvieron» el resultado de 1 después de ser procesados por la prueba estadística (debido a la presencia constante de registros de la «etiqueta» de defecto original), y la nueva versión del modelo se entrena sobre la «etiqueta» de defecto más sobre los registros que se «retuvieron» del flujo.
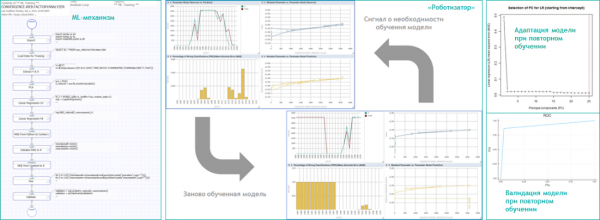
Figura 7 Robotización de cálculos de IA/ML en InterSystems IRIS
En caso de que haya necesidad de un «segundo criterio» sobre la calidad de la detección obtenida durante los cálculos locales en InterSystems IRIS, se crea un proceso-consejero para llevar a cabo la capacitación-aplicación de modelos en un conjunto de datos de control mediante servicios en la nube (por ejemplo, Microsoft Azure, Amazon Web Services, Google Cloud Platform, etc.):
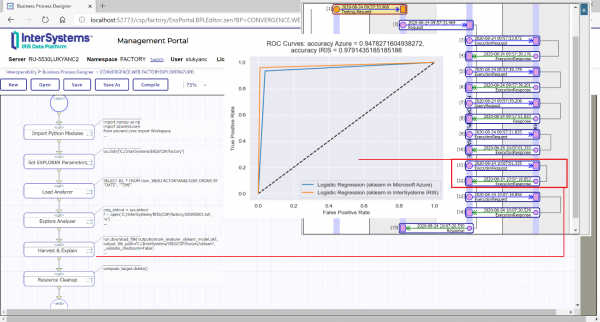
Figura 8 «Segundo criterio» de Microsoft Azure bajo la orquestación de InterSystems IRIS
El prototipo de nuestro escenario en InterSystems IRIS se presenta como un sistema agente de procesos analíticos que interactúan con el objeto de equipo (bomba), entornos de modelado matemático (Python, R y Julia), y asegurando el autoaprendizaje de todos los mecanismos de IA/ML involucrados, en flujos de datos en tiempo real.
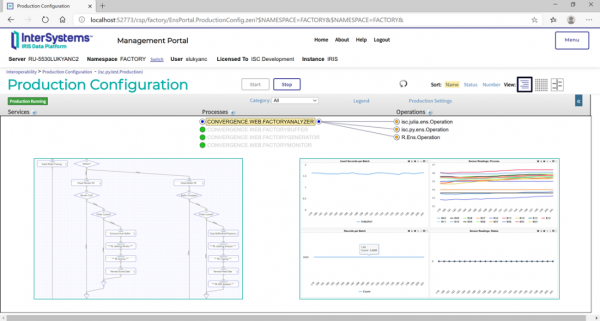
Figura 9 Funcionalidad principal de la solución de IA/ML en tiempo real en InterSystems IRIS
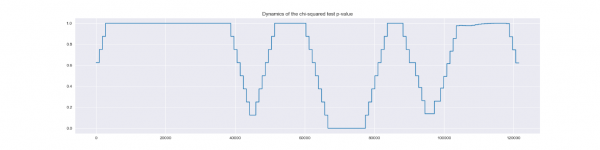
Resultado práctico del trabajo de nuestro prototipo:
- Ejemplo de defecto reconocido por el modelo (12 de enero):
- Defecto en desarrollo reconocido por el modelo, no incluido en el ejemplo (11 de septiembre; el defecto fue confirmado por el equipo de reparación solo dos días después, el 13 de septiembre):
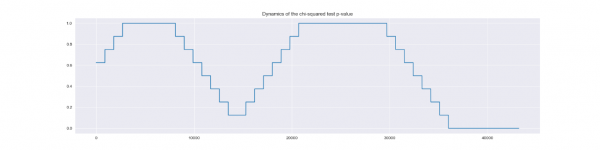
La simulación con datos reales que contienen varios episodios del mismo defecto mostró que nuestra solución, implementada en la plataforma InterSystems IRIS, permite detectar el desarrollo de defectos de este tipo varios días antes de que sean descubiertos por el equipo de reparación.
InterSystems IRIS - plataforma universal de cálculos en tiempo real de AI/ML
La plataforma InterSystems IRIS simplifica el desarrollo, implementación y operación de soluciones en datos en tiempo real. InterSystems IRIS puede realizar simultáneamente procesamiento transaccional y analítico de datos; mantener vistas de datos sincronizadas de acuerdo a múltiples modelos (incluyendo relacional, jerárquico, de objetos y documental); actuar como una plataforma de integración de una amplia variedad de fuentes de datos y aplicaciones individuales; y proporcionar capacidades analíticas avanzadas en tiempo real sobre datos estructurados y no estructurados. InterSystems IRIS también ofrece mecanismos para aplicar herramientas analíticas externas, lo que permite combinar flexiblemente el despliegue en la nube con servidores locales.
Las aplicaciones construidas sobre la plataforma InterSystems IRIS se han implementado en diversas industrias, ayudando a las empresas a obtener un efecto económico significativo en perspectivas estratégicas y operativas, mejorando la toma de decisiones informadas y eliminando los "gaps" entre el evento, el análisis y la acción.
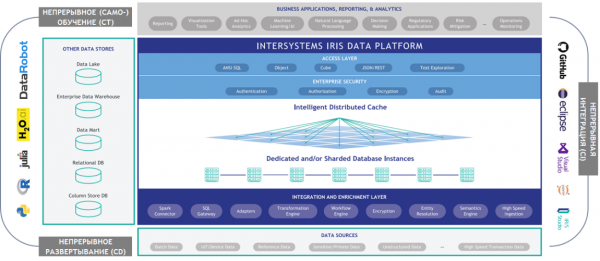
Figura 10 Arquitectura de InterSystems IRIS en el contexto de AI/ML en tiempo real
Al igual que el diagrama anterior, el siguiente diagrama combina un nuevo "sistema de coordenadas" (CD/CI/CT) con el esquema de flujos de información entre los elementos operativos de la plataforma. La visualización comienza con el macro-mecanismo CD y continúa con los macro-mecanismos CI y CT.
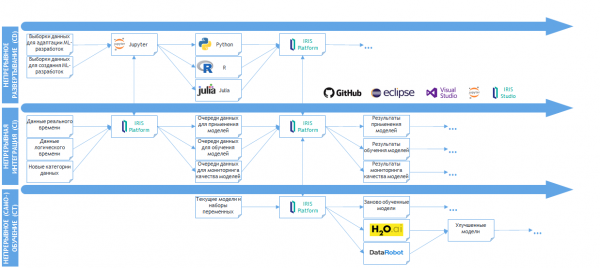
Figura 11 Esquema de flujos de información entre los elementos de AI/ML de la plataforma InterSystems IRIS
La esencia del mecanismo CD en InterSystems IRIS: los usuarios de la plataforma (desarrolladores de soluciones de AI/ML) adaptan las implementaciones existentes y/o crean nuevos desarrollos de AI/ML utilizando un editor de código especializado para mecanismos de AI/ML: Jupyter (nombre completo: Jupyter Notebook; también, por brevedad, los documentos creados en este editor se conocen comúnmente como tal). En Jupyter, el desarrollador tiene la posibilidad de escribir, depurar y asegurarse de que una implementación específica de AI/ML funcione correctamente (incluyendo el uso de gráficos) antes de su despliegue en InterSystems IRIS. Es evidente que la nueva implementación creada de este modo recibirá solo un ajuste básico (dado que, en particular, Jupyter no trabaja con flujos de datos en tiempo real) - esto es normal, ya que el resultado principal del desarrollo en Jupyter es confirmar la viabilidad conceptual de un mecanismo de AI/ML específico ("muestra el resultado esperado en una muestra de datos"). De manera similar, un mecanismo ya implementado en la plataforma (ver los siguientes macro-mecanismos) puede necesitar un "rollback" a una forma "previa a la plataforma" antes de ser depurado en Jupyter (lectura de datos desde archivos, trabajo con datos a través de xDBC en lugar de tablas, interacción directa con globales - arreglos multidimensionales de datos en InterSystems IRIS - etc.).
Un aspecto importante de la implementación de CD precisamente en InterSystems IRIS: existe una integración bidireccional entre la plataforma y Jupyter que permite trasladar a la plataforma (y posteriormente procesar en la plataforma) contenido en los lenguajes Python, R y Julia (los tres son lenguajes de programación en los respectivos principales entornos de código abierto de modelado matemático). Así, los desarrolladores de contenido de AI/ML pueden llevar a cabo un "despliegue continuo" de este contenido en la plataforma, trabajando en su editor Jupyter familiar, con las bibliotecas habituales disponibles en Python, R, Julia, y realizando la depuración básica (si es necesario) fuera de la plataforma.
Pasamos al macro-mecanismo CI en InterSystems IRIS. En el diagrama se ilustra el macro-proceso de funcionamiento del "robotizador en tiempo real" (un conjunto de estructuras de datos, procesos de negocio y fragmentos de código orquestados en lenguajes medio-matemáticos y en ObjectScript, el lenguaje de desarrollo nativo de InterSystems IRIS). La tarea de este macro-proceso es mantener las colas de datos necesarias para el funcionamiento de los mecanismos de AI/ML (basadas en flujos de datos transmitidos a la plataforma en tiempo real), tomar decisiones sobre la secuencia de aplicación y la "variedad" de mecanismos de AI/ML (también llamados "algoritmos matemáticos", "modelos", etc. – pueden denominarse de diversas maneras dependiendo de la especificidad de la implementación y de las preferencias terminológicas), y mantener actualizadas las estructuras de datos para el análisis de los resultados de los mecanismos de AI/ML (cubos, tablas, arreglos multidimensionales, etc. – para informes, paneles de control, etc.).
Un aspecto importante de la implementación de CI en InterSystems IRIS: entre la plataforma y los entornos de modelado matemático se realiza una integración bidireccional que permite ejecutar el contenido alojado en la plataforma en los lenguajes Python, R y Julia en sus respectivos entornos, obteniendo de vuelta los resultados de la ejecución. Esta integración se realiza tanto en "modo terminal" (es decir, el contenido de AI/ML se formula como código en ObjectScript que realiza llamadas a entornos matemáticos) como en "modo proceso de negocio" (es decir, el contenido de AI/ML se formula como un proceso de negocio mediante un editor gráfico, o a veces utilizando Jupyter, o mediante IDE – IRIS Studio, Eclipse, Visual Studio Code). La disponibilidad de procesos de negocio para editar en Jupyter se refleja mediante una conexión entre IRIS a nivel de CI y Jupyter a nivel de CD. A continuación, se ofrece un análisis más detallado de la integración con los entornos de modelado matemático. En esta etapa, creemos que hay suficientes razones para afirmar que la plataforma cuenta con todas las herramientas necesarias para llevar a cabo la "integración continua" de los desarrollos de AI/ML (provenientes del "despliegue continuo") en soluciones de AI/ML en tiempo real.
Y el mecanismo macro principal: CT. Sin él, no será posible tener plataformas de IA/ML (aunque el "tiempo real" se implementará a través de CD/CI). La esencia de CT es el trabajo de la plataforma con los "artefactos" de aprendizaje automático e inteligencia artificial directamente en sesiones de trabajo en entornos de modelado matemático: modelos, tablas de distribuciones, vectores-matrices, capas de redes neuronales, etc. Este "trabajo", en la mayoría de los casos, consiste en la creación de los mencionados artefactos en entornos (en el caso de los modelos, por ejemplo, la "creación" consiste en establecer la especificación del modelo y la posterior selección de los valores de sus parámetros, el llamado "entrenamiento" del modelo), su aplicación (para los modelos: el cálculo utilizando ellos de los valores "modelados" de las variables objetivo, como pronósticos, pertenencia a una categoría, probabilidad de que ocurra un evento, etc.) y la mejora de los artefactos ya creados y aplicados (por ejemplo, redefinir el conjunto de variables de entrada del modelo basándose en los resultados de la aplicación, con el fin de aumentar la precisión de la predicción, como variante). Un punto clave para entender el papel de CT es su "abstracción" de las realidades de CD y CI: CT implementará todos los artefactos, orientándose en la especificidad computacional y matemática de la solución de IA/ML dentro de las capacidades proporcionadas por los entornos concretos. La responsabilidad por el "suministro de datos de entrada" y la "entrega de resultados" recaerá en CD y CI.
Un aspecto importante de la implementación de CT en InterSystems IRIS: aprovechando la integración mencionada anteriormente con entornos de modelado matemático, la plataforma tiene la capacidad de extraer de las sesiones de trabajo que se desarrollan bajo su gestión en entornos matemáticos, los artefactos y (lo más importante) convertirlos en objetos de datos de la plataforma. Por ejemplo, una tabla de distribución que se creó recientemente en una sesión de trabajo de Python puede ser (sin detener la sesión en Python) transferida a la plataforma en forma de, por ejemplo, un global (arreglo multidimensional de datos de InterSystems IRIS), y ser utilizada para cálculos en otro mecanismo de AI/ML (implementado ya en el lenguaje de otro entorno, como R) – o como una tabla virtual. Otro ejemplo: en paralelo con el "modo normal" de operación del modelo (en la sesión de trabajo de Python), en sus datos de entrada se realiza un "auto-ML": selección automática de las variables de entrada óptimas y valores de parámetros. Y junto con el entrenamiento "normal", el modelo productivo en tiempo real recibe también una "sugerencia de optimización" de su especificación – en la que cambia el conjunto de variables de entrada, los valores de los parámetros (ya no como resultado del entrenamiento en Python, sino como resultado del entrenamiento de una "versión alternativa" de sí mismo, por ejemplo, en la pila H2O), permitiendo que la solución AI/ML en general haga frente de forma autónoma a cambios imprevistos en la naturaleza de los datos de entrada y los fenómenos modelados.
Conozcamos más a fondo la funcionalidad AI/ML de la plataforma InterSystems IRIS, a través de un prototipo que realmente existe.
En el diagrama a continuación, en la parte izquierda de la diapositiva se encuentra la sección del proceso empresarial que implementa la ejecución de scripts en Python y R. En la parte central están los registros visuales de la ejecución de algunos de estos scripts, correspondientes a Python y R. Justo después, se presentan ejemplos de contenido en ambos lenguajes, enviados para su ejecución en sus respectivas plataformas. Al final, a la derecha, se pueden ver visualizaciones basadas en los resultados de la ejecución de los scripts. Las visualizaciones en la parte superior se realizaron en IRIS Analytics (los datos fueron tomados de Python y enviados a la plataforma de datos InterSystems IRIS y mostrados en el panel mediante las herramientas de la plataforma), mientras que las de abajo se hicieron directamente en la sesión de trabajo de R y se exportaron a archivos gráficos. Un aspecto importante: el fragmento presentado en el prototipo está destinado al entrenamiento del modelo (clasificación de los estados del equipo) utilizando datos que llegan en tiempo real desde el proceso simulador de equipos, mediante una orden del proceso de monitoreo de la calidad de clasificación, observado durante la aplicación del modelo. Hablaremos más adelante sobre la implementación de una solución AI/ML en forma de un conjunto de procesos interactuantes ('agentes').
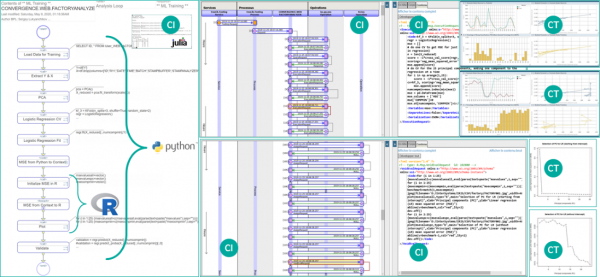
Figura 12 Interacción con Python, R y Julia en InterSystems IRIS
Los procesos de plataforma (también conocidos como 'procesos de negocio', 'procesos analíticos', 'pipelines', etc. – dependiendo del contexto) se editan principalmente en el editor gráfico de procesos empresariales dentro de la misma plataforma, de tal manera que se crean simultáneamente tanto su diagrama de bloques como el correspondiente mecanismo AI/ML (código programático). Al referirnos a que se 'obtiene un mecanismo AI/ML', inicialmente implicamos hibridación (dentro de un mismo proceso): el contenido en lenguajes de entornos de modelado matemático coexiste con contenido en SQL (incluidas sus extensiones de ), en InterSystems ObjectScript, con otros lenguajes compatibles. Además, el proceso de la plataforma ofrece amplias oportunidades para «dibujo» en forma de fragmentos jerárquicamente anidados (como se muestra en el ejemplo de la siguiente diagrama), lo que permite organizar de manera eficiente incluso contenido bastante complejo, sin «salirse» del formato gráfico (en métodos/clases/procedimientos «no gráficos», etc.). Es decir, cuando sea necesario (lo cual se anticipa en la mayoría de los proyectos), toda la solución AI/ML puede ser implementada en un formato gráfico autodocumentado. Cabe destacar que en la parte central de la diagrama de abajo, donde se presenta un «nivel de anidación» más alto, se puede ver que, además del trabajo en el entrenamiento del modelo (con Python y R), se añade el análisis de la llamada curva ROC del modelo entrenado, lo que permite evaluar visualmente (y también computacionalmente) la calidad del entrenamiento – y este análisis se realiza en el lenguaje Julia (se ejecuta, respectivamente, en el entorno de Julia).
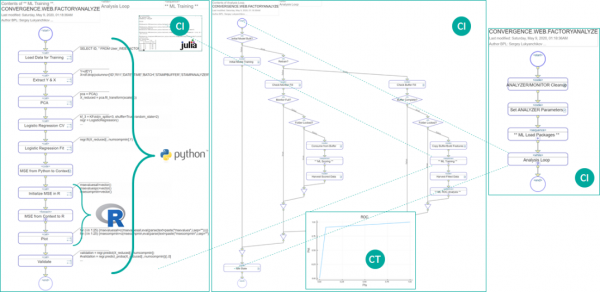
Figura 13 Entorno visual de composición de soluciones AI/ML en InterSystems IRIS
Como se mencionó anteriormente, el desarrollo inicial y (en algunos casos) la adaptación de mecanismos AI/ML ya implementados en la plataforma se llevará a cabo/puede llevarse a cabo fuera de la plataforma en el editor Jupyter. En la siguiente diagrama, vemos un ejemplo de adaptación de un proceso existente en la plataforma (el mismo que en la diagrama anterior) – así se ve en Jupyter el fragmento responsable del entrenamiento del modelo. El contenido en Python está disponible para edición, depuración, y salida gráfica directamente en Jupyter. Los cambios (si es necesario) pueden realizarse con sincronización inmediata en el proceso de la plataforma, incluida su versión productiva. De manera similar, nuevo contenido puede ser transferido a la plataforma (se genera automáticamente un nuevo proceso de plataforma).
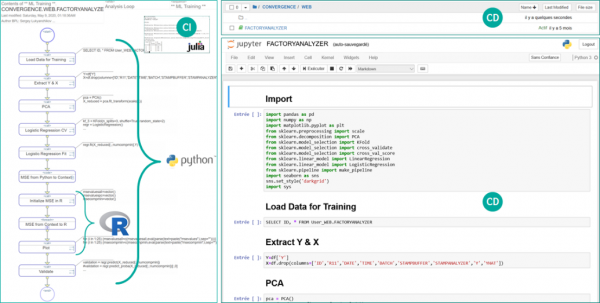
Figura 14 Uso de Jupyter Notebook para editar el mecanismo AI/ML en la plataforma InterSystems IRIS
La adaptación del proceso de la plataforma no solo se puede realizar en un formato gráfico o portátil, sino también en un formato IDE "total" (Entorno de Desarrollo Integrado). Estas IDE incluyen IRIS Studio (el estudio nativo de IRIS), Visual Studio Code (la extensión de InterSystems IRIS para VSCode) y Eclipse (el plugin Atelier). En algunos casos, es posible que el equipo de desarrollo use simultáneamente las tres IDE. En el diagrama a continuación se muestra un ejemplo de edición del mismo proceso en el estudio IRIS, Visual Studio Code y Eclipse. Todo el contenido está disponible para editar: Python/R/Julia/SQL, ObjectScript y el proceso de negocio.
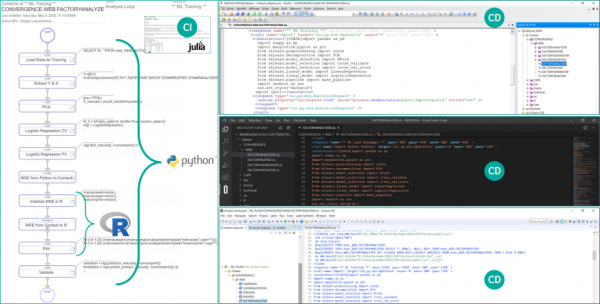
Figura 15 Desarrollo del proceso de negocio de InterSystems IRIS en diferentes IDE
Merece una mención especial las herramientas para describir y ejecutar procesos de negocio de InterSystems IRIS en el lenguaje Business Process Language (BPL). BPL permite utilizar en los procesos de negocio "componentes de integración listos" (activities), lo que, de hecho, proporciona una base sólida para afirmar que en InterSystems IRIS se implementa la "integración continua". Los componentes listos del proceso de negocio (actividades y las conexiones entre ellas) son un potente acelerador para la construcción de soluciones de AI/ML. Y no solo para la construcción: gracias a las actividades y a las conexiones entre ellas, sobre los desarrollos y mecanismos de AI/ML separados surge una "capa de gestión autónoma" capaz de tomar decisiones según la situación, en tiempo real.
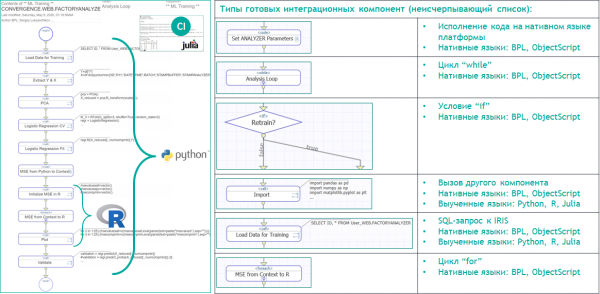
Figura 16 Componentes listos de procesos de negocio para la integración continua (CI) en la plataforma InterSystems IRIS
El concepto de sistemas de agentes (también conocidos como "sistemas multiagente") tiene una sólida posición en la robotización, y la plataforma InterSystems IRIS lo apoya orgánicamente a través del constructo "producto-proceso". Además de las ilimitadas posibilidades para "dotar" cada proceso con las funcionalidades necesarias para una solución global, dotar a la plataforma de procesos del sistema con la propiedad de "agencialidad" permite crear soluciones eficaces para fenómenos modelados extremadamente inestables (comportamiento de sistemas sociales/bio-sistemas, procesos tecnológicos parcialmente observables, etc.).
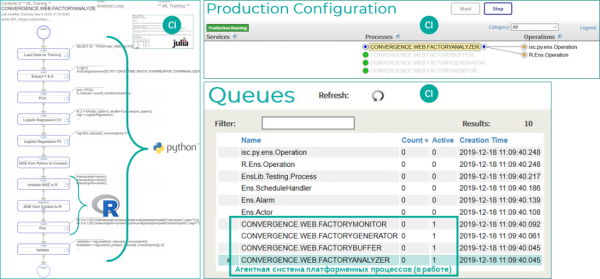
Figura 16 Funcionamiento de la solución AI/ML en forma de un sistema de agentes de procesos de negocio en InterSystems IRIS
Continuamos nuestra revisión de InterSystems IRIS con un relato sobre la aplicación de la plataforma para resolver clases enteras de problemas en tiempo real (una introducción bastante detallada a algunas de las mejores prácticas de AI/ML en InterSystems IRIS se encuentra en uno de nuestros anteriores ).
Siguiendo los pasos del diagrama anterior, a continuación se presenta un diagrama más detallado del sistema de agentes. El diagrama muestra el mismo prototipo, con los cuatro procesos-agentes claramente representados y las relaciones entre ellos: GENERADOR – se encarga de la creación de datos por los sensores del equipo, BUFFER – gestiona las colas de datos, ANALIZADOR – realiza el aprendizaje automático, MONITOR – controla la calidad del aprendizaje automático y emite señales sobre la necesidad de volver a entrenar el modelo.
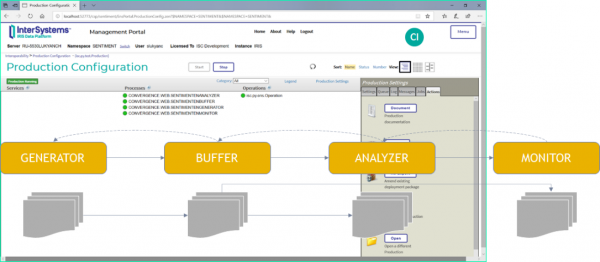
Figura 17 Composición de la solución AI/ML en forma de un sistema de agentes de procesos de negocio en InterSystems IRIS
En el diagrama a continuación se ilustra el funcionamiento autónomo de otro prototipo robótico (reconocimiento de la carga emocional de los textos) durante un período de tiempo. En la parte superior – la evolución del indicador de calidad del aprendizaje del modelo (la calidad está aumentando), en la parte inferior – la dinámica del indicador de calidad de la aplicación del modelo y los hechos de reentrenamiento (bandas rojas). Como se puede ver, la solución se ha autoentrenado de manera efectiva y autónoma, y opera en el nivel de calidad establecido (los valores del indicador de calidad no caen por debajo del 80%).
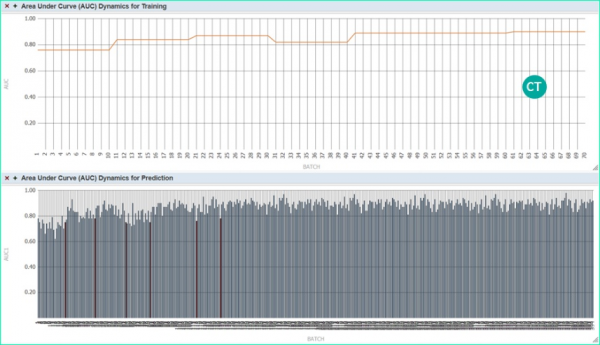
Figura 18 Aprendizaje continuo (auto-) en la plataforma InterSystems IRIS
Hemos mencionado el «auto-ML» anteriormente, pero en el diagrama a continuación se muestra la aplicación de esta funcionalidad en detalle a través de otro prototipo. En el esquema gráfico del fragmento del proceso de negocio se muestra la actividad que inicia la modelización en la pila H2O, se presentan los resultados de esa modelización (el dominio manifiesto del modelo obtenido sobre los modelos «artesanales», según el diagrama comparativo de curvas ROC, así como la identificación automatizada de las «variables más influyentes» de las disponibles en el conjunto de datos original). Un punto importante aquí es el ahorro de tiempo y recursos expertales que se logra a través del «auto-ML»: lo que nuestro proceso de plataforma logra en medio minuto (encontrar y entrenar el modelo óptimo), a un experto puede llevarle de una semana a un mes.
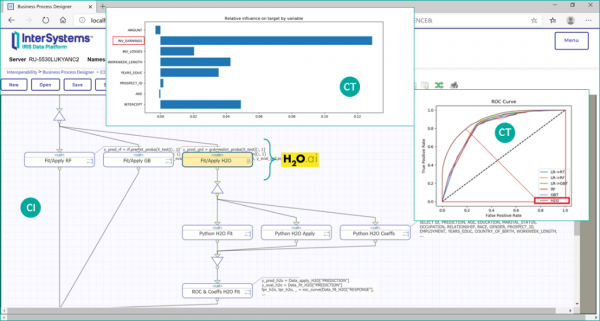
Figura 19 Integración de «auto-ML» en la solución de AI/ML en la plataforma InterSystems IRIS
El diagrama a continuación un poco «desvía la culminación», pero es una buena manera de concluir la charla sobre las clases de problemas resueltos en tiempo real: recordamos que a pesar de todas las capacidades de la plataforma InterSystems IRIS, el entrenamiento de modelos bajo su gestión no es obligatorio. La plataforma puede recibir externamente una especificación PMML de un modelo, entrenado en una herramienta que no está bajo la gestión de la plataforma, y aplicar este modelo en tiempo real desde el momento de su importación. . Es importante tener en cuenta que no todos los artefactos de AI/ML pueden ser reducidos a una especificación PMML, incluso si la mayoría de los artefactos más comunes lo permiten. Así, la plataforma InterSystems IRIS tiene un «contorno abierto» y no implica un «esclavitud de plataforma» para los usuarios.
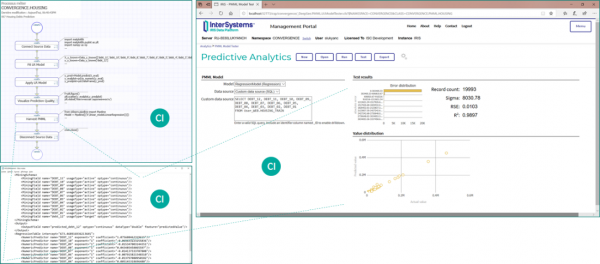
Figura 20 Integración de «auto-ML» en la solución de AI/ML en la plataforma InterSystems IRIS
Enumeremos las ventajas adicionales de la plataforma InterSystems IRIS (para ilustrar, aplicadas a la gestión de procesos tecnológicos), que son de gran importancia para la automatización de inteligencia artificial y aprendizaje automático en tiempo real:
- Desarrolladas herramientas de integración con cualquier fuente y consumidores de datos (SCADA/PLC, equipos, mantenimiento y reparación, ERP, etc.)
- Incorporado para el procesamiento transaccional-analítico de alto rendimiento (Hybrid Transaction/Analytical Processing, HTAP) de cualquier volumen de datos de procesos tecnológicos.
- Herramientas de desarrollo para el despliegue continuo de mecanismos de IA/ML de soluciones en tiempo real basadas en Python, R, Julia.
- Procesos de negocio adaptativos para la integración continua y el (auto)aprendizaje de mecanismos de soluciones IA/ML en tiempo real.
- Herramientas integradas de Business Intelligence para la visualización de datos de procesos tecnológicos y resultados de soluciones IA/ML.
- para la entrega de resultados de soluciones IA/ML a sistemas de automatización y control de procesos SCADA, sistemas de información y análisis, notificaciones, etc.
Las soluciones IA/ML en la plataforma InterSystems IRIS se integran fácilmente en la infraestructura de TI existente. La plataforma InterSystems IRIS garantiza una alta fiabilidad de las soluciones IA/ML al admitir configuraciones a prueba de fallos y de recuperación ante desastres, así como un despliegue flexible en entornos virtuales, en servidores físicos, en nubes privadas y públicas, y en contenedores Docker.
Así, InterSystems IRIS es una plataforma universal para cálculos IA/ML en tiempo real. La versatilidad de nuestra plataforma se confirma en la práctica por la ausencia de limitaciones de facto en la complejidad de los cálculos implementables, la capacidad de InterSystems IRIS para combinar (en tiempo real) el procesamiento de escenarios de diversas industrias, y la excepcional adaptabilidad de cualquier función y mecanismo de la plataforma a las necesidades específicas de los usuarios.
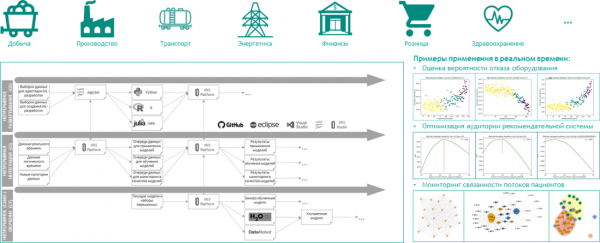
Figura 21 InterSystems IRIS — plataforma universal para cálculos IA/ML en tiempo real.
Para una interacción más concreta con aquellos de nuestros lectores que están interesados en el material presentado aquí, recomendamos no limitarse a su lectura y continuar el diálogo "en vivo". Estaremos encantados de ofrecer apoyo en la formulación de escenarios IA/ML en tiempo real aplicables a la especificidad de su empresa, llevaremos a cabo la prototipación conjunta en la plataforma InterSystems IRIS, y elaboraremos e implementaremos en la práctica una hoja de ruta para la implementación de inteligencia artificial y aprendizaje automático en sus procesos de producción y gestión. La dirección de correo electrónico de nuestro grupo de expertos en IA/ML es .
Fuente: habr.com
