

Hola, habitantes de Habr. Como ya hemos mencionado, este mes OTUS lanza dos cursos sobre aprendizaje automático, a saber, y . En este sentido, seguimos compartiendo material útil.
El objetivo de este artículo es relatar nuestra primera experiencia utilizando .
Comenzaremos la revisión con su servidor de seguimiento y registraremos todas las iteraciones de la investigación. Luego compartiremos la experiencia de conectar Spark con MLflow mediante UDF.
Contexto
En utiliza aprendizaje automático e inteligencia artificial para permitir a las personas cuidar de su salud y bienestar. Por eso, los modelos de aprendizaje automático son la base de nuestros productos de procesamiento de datos, y es por eso que MLflow ha llamado nuestra atención: una plataforma de código abierto que abarca todos los aspectos del ciclo de vida del aprendizaje automático.
MLflow.
El objetivo principal de MLflow es proporcionar una capa adicional sobre el aprendizaje automático que permita a los especialistas en ciencia de datos trabajar prácticamente con cualquier biblioteca de aprendizaje automático (, , , , y ), elevando su desempeño a un nuevo nivel.
MLflow proporciona tres componentes:
- Seguimiento – grabación y consultas sobre experimentos: código, datos, configuración y resultados. Es muy importante seguir el proceso de creación del modelo.
- Projects – Formato de empaquetado para ejecutar en cualquier plataforma (por ejemplo, )
- Modelos – un formato común para enviar modelos a diversas herramientas de implementación.
MLflow (en el momento de escribir este artículo en versión alfa) es una plataforma de código abierto que permite gestionar el ciclo de vida del aprendizaje automático, incluidos los experimentos, la reutilización y la implementación.
Configuración de MLflow
Para usar MLflow, primero hay que configurar todo el entorno Python, para ello utilizaremos (para instalar Python en Mac, ve a ). Así podremos crear un entorno virtual donde instalaremos todas las bibliotecas necesarias para la ejecución.
```
pyenv install 3.7.0
pyenv global 3.7.0 # Usar Python 3.7
mkvirtualenv mlflow # Crear un entorno virtual con Python 3.7
workon mlflow
```
Instalemos las bibliotecas requeridas.
```
pip install mlflow==0.7.0
            Cython==0.29
            numpy==1.14.5
            pandas==0.23.4
            pyarrow==0.11.0
```
Nota: estamos utilizando PyArrow para ejecutar modelos como UDF. Las versiones de PyArrow y Numpy debían corregirse, ya que las últimas versiones presentaban conflictos entre sí.
Iniciamos la interfaz de usuario de seguimiento
MLflow Tracking nos permite registrar y hacer consultas sobre experimentos utilizando Python y API. Además, se puede definir dónde almacenar los artefactos del modelo (localhost, , , o ). Como en Alpha Health utilizamos AWS, S3 será el almacenamiento de artefactos.
# Running a Tracking Server
mlflow server
    --file-store /tmp/mlflow/fileStore
    --default-artifact-root s3://<bucket>/mlflow/artifacts/
    --host localhost
    --port 5000
MLflow recomienda usar un almacenamiento de archivos persistente. El almacenamiento de archivos es donde el servidor almacenará los metadatos de las ejecuciones y experimentos. Al iniciar el servidor, asegúrate de que esté apuntando a un almacenamiento de archivos persistente. Para este experimento, simplemente usaremos /tmp.
Recuerda que si queremos usar el servidor mlflow para ejecutar experimentos anteriores, deben estar presentes en el almacenamiento de archivos. Sin embargo, incluso sin esto podríamos usarlos en UDF, ya que solo necesitamos la ruta hasta el modelo.
Nota: Ten en cuenta que la UI de Tracking y el cliente del modelo deben tener acceso a la ubicación del artefacto. Es decir, independientemente de que la UI de Tracking esté en una instancia de EC2, al ejecutar MLflow localmente, la máquina debe tener acceso directo a S3 para escribir los modelos de artefactos.
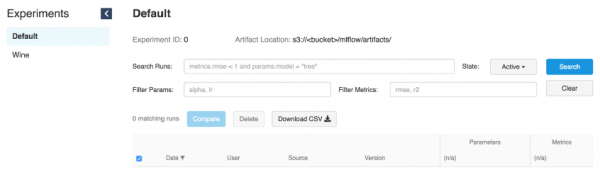
La UI de Tracking almacena artefactos en un bucket S3
Ejecución de modelos
Una vez que el servidor de Tracking esté funcionando, se puede comenzar a entrenar modelos.
Como ejemplo, utilizaremos la modificación de wine del ejemplo de MLflow en .
MLFLOW_TRACKING_URI=http://localhost:5000 python wine_quality.py
  --alpha 0.9
  --l1_ratio 0.5
  --wine_file ./data/winequality-red.csv
Como ya mencionamos, MLflow permite registrar parámetros, métricas y artefactos de modelos para que se pueda rastrear cómo evolucionan a lo largo de las iteraciones. Esta función es extremadamente útil, ya que así podemos reproducir el mejor modelo consultando al servidor de Tracking o entendiendo qué código ejecutó la iteración necesaria, utilizando los registros de los hashes de commit de git.
with mlflow.start_run():

    ... model ...

    mlflow.log_param("source", wine_path)
    mlflow.log_param("alpha", alpha)
    mlflow.log_param("l1_ratio", l1_ratio)

    mlflow.log_metric("rmse", rmse)
    mlflow.log_metric("r2", r2)
    mlflow.log_metric("mae", mae)

    mlflow.set_tag('domain', 'wine')
    mlflow.set_tag('predict', 'quality')
mlflow.sklearn.log_model(lr, "model") 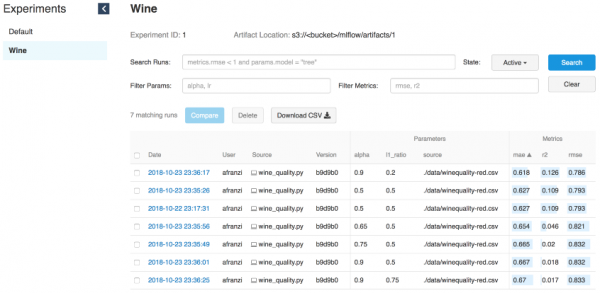
Iteraciones de wine
La parte del servidor para el modelo
El servidor de seguimiento MLflow, iniciado con el comando “mlflow server”, tiene una API REST para rastrear ejecuciones y registrar datos en el sistema de archivos local. Puede especificar la dirección del servidor de seguimiento mediante la variable de entorno «MLFLOW_TRACKING_URI» y la API de seguimiento de MLflow se comunicará automáticamente con el servidor de seguimiento en esta dirección para crear/obtener información sobre la ejecución, métricas de registros, etc.
Fuente:
Para proporcionar un servidor a la modelo, necesitaremos un servidor de seguimiento en funcionamiento (ver interfaz de inicio) y el ID de ejecución del modelo.
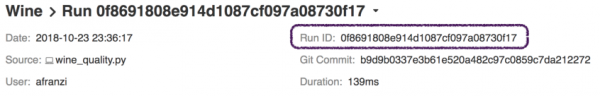
ID de ejecución
# Serve a sklearn model through 127.0.0.0:5005
MLFLOW_TRACKING_URI=http://0.0.0.0:5000 mlflow sklearn serve
  --port 5005
  --run_id 0f8691808e914d1087cf097a08730f17
  --model-path model
Para servir modelos con la funcionalidad de MLflow serve, necesitaremos acceso a la interfaz de seguimiento, para obtener información sobre el modelo simplemente especificando --run_id.
Una vez que el modelo se conecta al servidor de seguimiento, podemos obtener un nuevo punto final del modelo.
# Query Tracking Server Endpoint
curl -X POST
  http://127.0.0.1:5005/invocations
  -H 'Content-Type: application/json'
  -d '[
	{
		"fixed acidity": 3.42,
		"volatile acidity": 1.66,
		"citric acid": 0.48,
		"residual sugar": 4.2,
		"chloridessssss": 0.229,
		"free sulfur dsioxide": 19,
		"total sulfur dioxide": 25,
		"density": 1.98,
		"pH": 5.33,
		"sulphates": 4.39,
		"alcohol": 10.8
	}
]'

> {"predictions": [5.825055635303461]}
Ejecutando modelos desde Spark
Aunque el servidor de seguimiento es lo suficientemente potente para servir modelos en tiempo real, su entrenamiento y uso de la funcionalidad serve (fuente: ), utilizar Spark (por lotes o en streaming) es una solución aún más potente gracias a la distribución.
Imagina que acabas de realizar un entrenamiento fuera de línea y luego aplicaste el modelo resultante a todos tus datos. Aquí es donde Spark y MLflow se destacan.
Instalando PySpark + Jupyter + Spark
Fuente:
Para mostrar cómo aplicamos los modelos de MLflow a los DataFrames de Spark, necesitamos configurar la colaboración de los notebooks de Jupyter con PySpark.
Comienza instalando la última versión estable :
cd ~/Downloads/
tar -xzf spark-2.4.3-bin-hadoop2.7.tgz
mv ~/Downloads/spark-2.4.3-bin-hadoop2.7 ~/
ln -s ~/spark-2.4.3-bin-hadoop2.7 ~/spark
Instala PySpark y Jupyter en un entorno virtual:
pip install pyspark jupyterConfigura las variables de entorno:
export SPARK_HOME=~/spark
export PATH=$SPARK_HOME/bin:$PATH
export PYSPARK_DRIVER_PYTHON=jupyter
export PYSPARK_DRIVER_PYTHON_OPTS="notebook --notebook-dir=${HOME}/Projects/notebooks"
Definiendo notebook-dir, podremos almacenar nuestros notebooks en la carpeta deseada.
Iniciamos Jupyter desde PySpark
Dado que hemos podido configurar Jupyter como el controlador de PySpark, ahora podemos iniciar el notebook de Jupyter en el contexto de PySpark.
(mlflow) afranzi:~$ pyspark
[I 19:05:01.572 NotebookApp] ¡Extensión sparkmagic habilitada!
[I 19:05:01.573 NotebookApp] Sirviendo cuadernos desde el directorio local: /Users/afranzi/Projects/notebooks
[I 19:05:01.573 NotebookApp] El Jupyter Notebook se está ejecutando en:
[I 19:05:01.573 NotebookApp] http://localhost:8888/?token=c06252daa6a12cfdd33c1d2e96c8d3b19d90e9f6fc171745
[I 19:05:01.573 NotebookApp] Usa Control-C para detener este servidor y cerrar todos los núcleos (dos veces para omitir la confirmación).
[C 19:05:01.574 NotebookApp]

    Copia/pega esta URL en tu navegador cuando te conectes por primera vez,
    para iniciar sesión con un token:
http://localhost:8888/?token=c06252daa6a12cfdd33c1d2e96c8d3b19d90e9f6fc171745 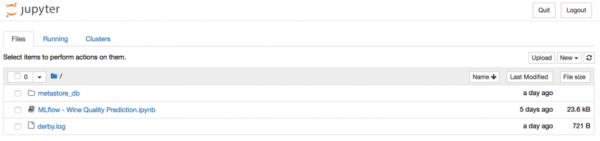
Como se mencionó anteriormente, MLflow proporciona la función de registro de artefactos de modelo en S3. Una vez que tenemos el modelo seleccionado, podemos importarlo como UDF usando el módulo mlflow.pyfunc.
import mlflow.pyfunc

model_path = 's3:///mlflow/artifacts/1/0f8691808e914d1087cf097a08730f17/artifacts/model'
wine_path = '/Users/afranzi/Projects/data/winequality-red.csv'
wine_udf = mlflow.pyfunc.spark_udf(spark, model_path)

df = spark.read.format("csv").option("header", "true").option('delimiter', ';').load(wine_path)
columns = [ "fixed acidity", "volatile acidity", "citric acid",
            "residual sugar", "chlorides", "free sulfur dioxide",
            "total sulfur dioxide", "density", "pH",
            "sulphates", "alcohol"
          ]

df.withColumn('prediction', wine_udf(*columns)).show(100, False) 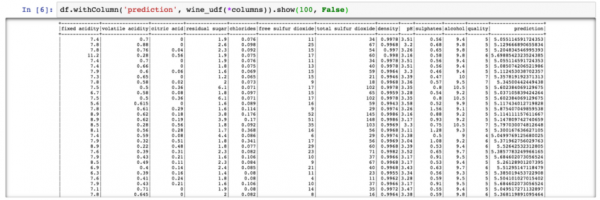
PySpark – Salida de la predicción de calidad del vino
Hasta este momento hemos hablado sobre cómo usar PySpark con MLflow, ejecutando la predicción de calidad del vino en todo el conjunto de datos de vino. Pero, ¿qué hacer si necesitas usar módulos de Python de MLflow desde Scala Spark?
Hemos probado esto, dividiendo el contexto de Spark entre Scala y Python. Es decir, registramos el UDF de MLflow en Python y lo usamos desde Scala (sí, puede que no sea la mejor solución, pero es lo que tenemos).
Scala Spark + MLflow
Para este ejemplo, añadiremos en el Jupyter existente.
Instalamos Spark + Toree + Jupyter
pip install toree
jupyter toree install --spark_home=${SPARK_HOME} --sys-prefix
jupyter kernelspec list
```
```
Kernels disponibles:
  apache_toree_scala    /Users/afranzi/.virtualenvs/mlflow/share/jupyter/kernels/apache_toree_scala
  python3               /Users/afranzi/.virtualenvs/mlflow/share/jupyter/kernels/python3
```
Como se puede ver en el cuaderno adjunto, el UDF se utiliza junto con Spark y PySpark. Esperamos que esta parte sea útil para aquellos que aman Scala y quieren implementar modelos de machine learning en producción.
import org.apache.spark.sql.functions.col
import org.apache.spark.sql.types.StructType
import org.apache.spark.sql.{Column, DataFrame}
import scala.util.matching.Regex

val FirstAtRe: Regex = "^_".r
val AliasRe: Regex = "[\s_.:@]+".r

def getFieldAlias(field_name: String): String = {
    FirstAtRe.replaceAllIn(AliasRe.replaceAllIn(field_name, "_"), "")
}

def selectFieldsNormalized(columns: List[String])(df: DataFrame): DataFrame = {
    val fieldsToSelect: List[Column] = columns.map(field =>
        col(field).as(getFieldAlias(field))
    )
    df.select(fieldsToSelect: _*)
}

def normalizeSchema(df: DataFrame): DataFrame = {
    val schema = df.columns.toList
    df.transform(selectFieldsNormalized(schema))
}

FirstAtRe = ^_
AliasRe = [s_.:@]+

getFieldAlias: (field_name: String)String
selectFieldsNormalized: (columns: List[String])(df: org.apache.spark.sql.DataFrame)org.apache.spark.sql.DataFrame
normalizeSchema: (df: org.apache.spark.sql.DataFrame)org.apache.spark.sql.DataFrame
Out[1]:
[s_.:@]+
In [2]:
val winePath = "~\/Research\/mlflow-workshop\/examples\/wine_quality\/data\/winequality-red.csv"
val modelPath = "\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model"

winePath = ~\/Research\/mlflow-workshop\/examples\/wine_quality\/data\/winequality-red.csv
modelPath = \/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model
Out[2]:
\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model
In [3]:
val df = spark.read
              .format("csv")
              .option("header", "true")
              .option("delimiter", ";")
              .load(winePath)
              .transform(normalizeSchema)

df = [fixed_acidity: string, volatile_acidity: string ... 10 more fields]
Out[3]:
[fixed_acidity: string, volatile_acidity: string ... 10 more fields]
In [4]:
%%PySpark
import mlflow
from mlflow import pyfunc

model_path = "\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model"
wine_quality_udf = mlflow.pyfunc.spark_udf(spark, model_path)

spark.udf.register("wineQuality", wine_quality_udf)
Out[4]:
<function spark_udf..predict at 0x1116a98c8>
In [6]:
df.createOrReplaceTempView("wines")
In [10]:
%%SQL
SELECT
    quality,
    wineQuality(
        fixed_acidity,
        volatile_acidity,
        citric_acid,
        residual_sugar,
        chlorides,
        free_sulfur_dioxide,
        total_sulfur_dioxide,
        density,
        pH,
        sulphates,
        alcohol
    ) AS prediction
FROM wines
LIMIT 10
Out[10]:
+-------+------------------+
|quality|        prediction|
+-------+------------------+
|      5| 5.576883967129615|
|      5|  5.50664776916154|
|      5| 5.525504822954496|
|      6| 5.504311247097457|
|      5| 5.576883967129615|
|      5|5.5556903912725755|
|      5| 5.467882654744997|
|      7| 5.710602976324739|
|      7| 5.657319539336507|
|      5| 5.345098606538708|
+-------+------------------+

In [17]:
spark.catalog.listFunctions.filter('name like "%wineQuality%").show(20, false)

+-----------+--------+-----------+---------+-----------+
|name       |database|description|className|isTemporary|
+-----------+--------+-----------+---------+-----------+
|wineQuality|null    |null       |null     |true       |
+-----------+--------+-----------+---------+-----------+
Próximos pasos
A pesar de que en el momento de escribir este artículo, MLflow se encuentra en versión Alpha, tiene un gran potencial. La posibilidad de ejecutar múltiples marcos de trabajo de aprendizaje automático y utilizarlos desde un único punto final lleva los sistemas de recomendación a un nuevo nivel.
Además, MLflow une a los ingenieros de datos y a los especialistas en ciencia de datos, estableciendo una capa común entre ellos.
Después de esta investigación de MLflow, estamos seguros de que iremos más allá y lo utilizaremos para nuestros pipelines de Spark y en sistemas de recomendación.
Sería bueno sincronizar el almacenamiento de archivos con la base de datos, en lugar de con el sistema de archivos. De este modo, deberíamos obtener varios puntos finales que puedan utilizar el mismo almacenamiento de archivos. Por ejemplo, usar varias instancias y con el mismo Glue metastore.
En resumen, queremos agradecer a la comunidad de MLFlow por hacer que nuestro trabajo con datos sea más interesante.
Si estás experimentando con MLflow, no dudes en escribirnos y contarnos cómo lo utilizas, y mucho más si lo usas en producción.
Obtén más información sobre los cursos:
Leer más:
Fuente: habr.com
