

Vivimos en un tiempo sorprendente, donde es posible conectar rápidamente y fácilmente varias herramientas de código abierto, configurarlas con un «cerebro desconectado» siguiendo los consejos de stackoverflow, sin profundizar en «palabras complicadas», y ponerlas en funcionamiento comercial. Y cuando sea necesario actualizarse/ampliarse o alguien reinicie accidentalmente un par de máquinas, uno se da cuenta de que ha comenzado una pesadilla molesta en la vida real, todo se complicó drásticamente, no hay vuelta atrás, el futuro es incierto y más seguro, en lugar de programar, criar abejas y hacer queso.
No es de extrañar que los colegas más experimentados, con cabezas canosas llenas de bugs, observando el increíblemente rápido despliegue de montones de «contenedores» en «cubos» en decenas de servidores en «lenguajes de moda» con soporte incorporado para entrada/salida asíncrona y no bloqueante, sonríen modestamente. Y silenciosamente continúan releyendo «man ps», profundizando hasta que les sangran los ojos en el código fuente de «nginx» y escribiendo-escribiendo-escribiendo pruebas unitarias. Los colegas saben que lo más interesante está por venir, cuando «todo esto» un día se convierta en un dolor de cabeza bajo el árbol de Navidad. Y solo un profundo entendimiento de la naturaleza de unix, la tabla de estados de TCP/IP y los algoritmos básicos de ordenamiento-búsqueda les ayudará a devolver el sistema a la vida con el sonido de las campanas.
Ah, sí, me he desviado un poco, pero espero haber transmitido el estado de anticipación.
Hoy quiero compartir nuestra experiencia en el despliegue de una pila conveniente y económica para DataLake, que resuelve la mayoría de las tareas analíticas de la empresa para diferentes departamentos.
Hace algún tiempo, llegamos a la conclusión de que las empresas necesitan cada vez más los frutos tanto de la analítica de productos como de la técnica (sin mencionar las cerezas en el pastel como el machine learning) y para entender las tendencias y riesgos, es necesario recolectar y analizar cada vez más métricas.
Analítica técnica básica en «Bitrix24»
Hace varios años, al mismo tiempo que lanzamos el servicio 'Bitrix24', invertimos activamente tiempo y recursos en crear una plataforma analítica simple y confiable que ayudara a identificar rápidamente problemas en la infraestructura y planificar el próximo paso. Por supuesto, era deseable utilizar herramientas que fueran listas, simples y comprensibles. Como resultado, se eligió Nagios para la supervisión y Munin para el análisis y la visualización. Ahora tenemos miles de verificaciones en Nagios, cientos de gráficos en Munin y los colegas los utilizan diariamente con éxito. Las métricas son claras, los gráficos son comprensibles, el sistema ha funcionado de manera confiable durante varios años y se añaden regularmente nuevas pruebas y gráficos: cuando introducimos un nuevo servicio en operación, agregamos varias pruebas y gráficos. Buen camino.
Manos al pulso — análisis técnico avanzado
El deseo de recibir información sobre problemas 'lo más rápido posible' nos llevó a experimentar activamente con herramientas simples y comprensibles — Pinba y XHProf.
Pinba nos enviaba en paquetes UDP estadísticas sobre la velocidad de funcionamiento de las partes de las páginas web en PHP y se podía ver en tiempo real en el almacenamiento MySQL (Pinba tiene su propio motor MySQL para un análisis rápido de eventos) una lista corta de problemas y reaccionar a ellos. Y XHProf, de forma automática, permitía recopilar gráficos de ejecución de las páginas PHP más lentas de los clientes y analizar qué pudo llevar a ello — tranquilamente, sirviendo té o algo más fuerte.
Hace un tiempo, el conjunto de herramientas se amplió con otro motor bastante simple y comprensible basado en un algoritmo de índice inverso, implementado a la perfección en la legendaria biblioteca Lucene — Elastic/Kibana. La simple idea de almacenar documentos multihilo en el índice inverso de Lucene a partir de eventos en logs y una búsqueda rápida a través de ellos utilizando división de facetas resultó ser verdaderamente útil.
A pesar del aspecto técnico bastante de las visualizaciones en Kibana con conceptos de bajo nivel como 'bucket' y un lenguaje de álgebra relacional reinventado, el instrumento nos ha ayudado mucho en las siguientes tareas:
- ¿Cuántos errores de PHP tuvo el cliente de Bitrix24 en el portal p1 en la última hora y cuáles fueron? Entender, perdonar y corregir rápidamente.
- ¿Cuántas videollamadas se realizaron en los portales de Alemania en las últimas 24 horas, con qué calidad y hubo problemas con el canal/red?
- ¿Qué tan bien funciona la función del sistema (nuestra extensión en C para PHP), compilada desde el código fuente en la última actualización del servicio y desplegada a los clientes? ¿No hay segfaults?
- ¿Los datos de los clientes se almacenan en la memoria de PHP? ¿No hay errores de exceso de memoria asignada a los procesos: 'out of memory'? Necesitamos encontrar y neutralizar.
Aquí hay un ejemplo concreto. A pesar de las pruebas exhaustivas y multicapas, el cliente experimentó un error frustrante e inesperado con un caso muy atípico y datos de entrada dañados, sonó la alarma y comenzó el proceso de corrección rápida:
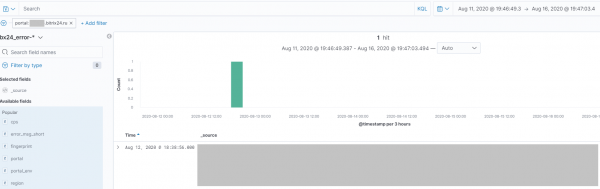
Además, Kibana permite organizar notificaciones para eventos específicos y en poco tiempo, decenas de empleados de diferentes departamentos comenzaron a usar la herramienta, desde soporte técnico y desarrollo hasta QA.
La actividad de cualquier departamento dentro de la empresa se puede rastrear y medir fácilmente; en lugar de analizar manualmente los registros en los servidores, basta con configurar una vez el análisis de registros y su envío a un clúster Elastic para disfrutar, por ejemplo, observando en el dashboard de Kibana la cantidad de gatitos de dos cabezas impresos en 3D vendidos durante el último mes lunar.
Análisis empresarial básico
Todos saben que a menudo el análisis empresarial en las empresas comienza con el uso extremadamente activo de, sí, sí, Excel. Pero, lo más importante, es que no termine ahí. El aceite en el fuego lo agrega todavía más el Google Analytics en la nube: rápidamente te acostumbras a lo bueno.
En nuestra empresa en armonioso desarrollo, empezaron a aparecer de vez en cuando 'profetas' de un trabajo más intensivo con datos más grandes. Las necesidades de informes más profundos y multifacéticos empezaron a surgir regularmente, y gracias a los esfuerzos de personas de diferentes departamentos, hace un tiempo se organizó una solución simple y práctica: la combinación de ClickHouse y PowerBI.
Durante bastante tiempo, esta solución flexible ayudó muy bien, pero poco a poco se comprendió que ClickHouse no es elástico y no se puede abusar de él.
Es importante entender bien que ClickHouse, al igual que Druid, Vertica y Amazon RedShift (que se basa en Postgres), son motores analíticos optimizados para un análisis bastante cómodo (sumas, agregaciones, mínimo-máximo por columna y se puede hacer algo de join), ya que están organizados para un almacenamiento eficiente de columnas de tablas relacionales, a diferencia de lo que conocemos como MySQL y otras bases de datos (orientadas a filas).
En esencia, ClickHouse es solo una «base» de datos más espaciosa, con una inserción puntual no muy cómoda (así está diseñado, está bien), pero con un análisis agradable y un conjunto de poderosas funciones interesantes para trabajar con los datos. Sí, incluso se puede crear un clúster, pero usted entiende que clavar un clavo con un microscopio no es del todo correcto y comenzamos a buscar otras soluciones.
Demanda de python y analistas
En nuestra empresa hay muchos desarrolladores que escriben código casi todos los días durante 10-20 años en PHP, JavaScript, C#, C/C++, Java, Go, Rust, Python y Bash. También hay muchos administradores de sistemas experimentados que han sobrevivido a más de una catástrofe increíble, que no se ajusta a las leyes de la estadística (por ejemplo, cuando se destruyen la mayoría de los discos en un raid-10 por un fuerte rayo). En tales condiciones, durante mucho tiempo fue incomprensible qué es un «analista en python». Python es como PHP, solo que el nombre es un poco más largo y hay menos huellas de sustancias que alteran la conciencia en el código fuente del intérprete. Sin embargo, a medida que se crean informes analíticos nuevos y nuevos, los desarrolladores experimentados comenzaron a darse cuenta más profundamente de la importancia de la especialización en herramientas como numpy, pandas, matplotlib y seaborn.
El papel decisivo, probablemente, lo jugaron los desmayos repentinos de los empleados ante la combinación de las palabras «regresión logística» y la demostración de un informe efectivo construido sobre grandes volúmenes de datos, sí, sí, con pyspark.
Apache Spark, su paradigma funcional, sobre el que se basa la álgebra relacional y las posibilidades, impresionó tanto a los desarrolladores acostumbrados a MySQL que la necesidad de reforzar las filas con analistas experimentados se volvió clara como el día.
Los intentos posteriores de Apache Spark/Hadoop de despegar y lo que salió no fue del todo según lo planeado.
Sin embargo, pronto quedó claro que con Spark, aparentemente, algo no estaba bien sistemáticamente o simplemente había que lavarse mejor las manos. Si el stack Hadoop/MapReduce/Lucene es desarrollado por programadores bastante experimentados, lo que es obvio si se revisan detenidamente los códigos fuente en Java o las ideas de Doug Cutting en Lucene, de repente, Spark, está escrito en un lenguaje exótico muy cuestionable desde el punto de vista práctico y actualmente no en desarrollo, llamado Scala. Además, el frecuente fallo de los cálculos en el clúster de Spark debido al funcionamiento ilógico y poco claro de la asignación de memoria para las operaciones de reducción (se manejan muchos claves a la vez) ha creado a su alrededor un aura de algo que tiene mucho por mejorar. También se agravaba la situación con la gran cantidad de puertos abiertos extraños, archivos temporales que crecían en los lugares más inesperados y un montón de dependencias de jars, lo que provocaba en los administradores de sistemas una conocida sensación de odio profundo (quizás era necesario lavarse las manos con jabón).
Como resultado, hemos "sobrevivido" a varios proyectos analíticos internos que utilizan activamente Apache Spark (incluyendo Spark Streaming, Spark SQL) y el ecosistema Hadoop (etc.). A pesar de que con el tiempo aprendimos a "prepararlo" y monitorearlo bastante bien, y "prácticamente dejó de caer repentinamente" debido a cambios en la naturaleza de los datos y el desbalanceo de hashing uniforme de RDD, el deseo de tener algo ya preparado, actualizable y administrado en la nube creció cada vez más. Justo en ese momento, probamos usar una solución en la nube lista de Amazon Web Services — y, posteriormente, intentamos resolver tareas sobre ella. EMR es la versión de Apache Spark preparada por Amazon con software adicional del ecosistema, aproximadamente como los paquetes de Cloudera/Hortonworks.
Un almacenamiento de archivos "flexible" para análisis — una necesidad urgente
La experiencia de "preparar" Hadoop/Spark con quemaduras en diferentes partes del cuerpo no fue en vano. Se hizo cada vez más evidente la necesidad de crear un único almacenamiento de archivos económico y fiable, que sea resistente a fallos de hardware y que permita almacenar archivos en diferentes formatos de diferentes sistemas y realizar consultas de manera eficiente y en un tiempo razonable para informes.
También quería que la actualización del software de esta plataforma no se convirtiera en una pesadilla de Nochevieja, leyendo pistas de Java de 20 páginas y analizando kilómetros de registros detallados del funcionamiento del clúster con la ayuda del Spark History Server y una lupa con luz. Deseaba tener una herramienta simple y transparente que no requiriera bucear regularmente bajo el capó, si el desarrollador dejaba de ejecutar la consulta estándar de MapReduce debido a la pérdida de memoria en el trabajo de los datos de reducción por un algoritmo de particionado de datos de entrada no muy bien elegido.
¿Amazon S3, un candidato para DataLake?
La experiencia con Hadoop/MapReduce me enseñó que se necesita un sistema de archivos escalable y confiable, y sobre él, trabajadores escalables que 'se acerquen' a los datos, para no estar moviendo datos por la red. Los trabajadores deben ser capaces de leer datos en diferentes formatos, pero, idealmente, no leer información adicional y poder almacenar datos con antelación en formatos convenientes para los trabajadores.
Una vez más, la idea principal. No hay deseo de 'subir' grandes datos a un único motor analítico en clúster, que de todos modos se ahogará tarde o temprano y habrá que fragmentarlo de manera poco decorosa. Quiero almacenar archivos, simples archivos, en un formato comprensible y ejecutar consultas analíticas eficientes sobre ellos con diferentes, pero comprensibles herramientas. Y habrá cada vez más archivos en diferentes formatos. Y es mejor fragmentar no el motor, sino los datos de origen. Necesitamos un DataLake escalable y versátil, así decidimos...
¿Y si almacenamos archivos en el conocido y escalable almacenamiento en la nube Amazon S3, sin tener que preparar nuestra propia comida de Hadoop?
Está claro, los datos personales 'no se pueden', pero ¿qué pasa con otros datos si los sacamos y los 'procesamos eficazmente'?
El ecosistema de análisis de big data en clúster de Amazon Web Services, en palabras muy simples.
Según nuestra experiencia con AWS, hace tiempo que se utiliza Apache Hadoop/MapReduce bajo diferentes circunstancias, por ejemplo, en el servicio DataPipeline (envidio a mis colegas, han aprendido a prepararlo correctamente). Aquí configuramos copias de seguridad de diferentes servicios a partir de tablas de DynamoDB:
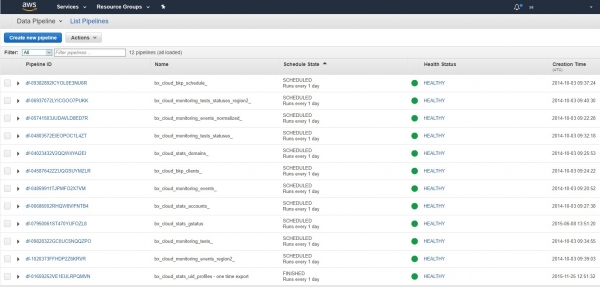
Y se ejecutan de manera continua en clusters de Hadoop/MapReduce como un reloj desde hace varios años. 'Lo configuré y lo olvidé':
Además, se puede realizar un datascattering de manera eficiente, levantando notebooks de Jupiter en la nube para los analistas y utilizando AWS SageMaker para el entrenamiento y despliegue de modelos de IA. Así es como se ve en nuestra empresa:
Y sí, se puede levantar un notebook en la nube o un notebook para un analista y conectarlo a un clúster de Hadoop/Spark, realizar los cálculos y luego «archivarlo» todo:
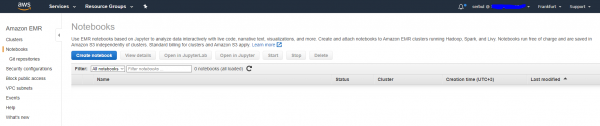
Es realmente conveniente para proyectos analíticos individuales y en algunos casos hemos utilizado con éxito el servicio EMR para cálculos y análisis a gran escala. ¿Y qué hay de una solución sistémica para DataLake, será posible? En ese momento estábamos al borde de la esperanza y la desesperación y continuamos con la búsqueda.
AWS Glue es Apache Spark «en esteroides»
Resultó que AWS tiene su propia versión del stack «Hive/Pig/Spark». El rol de Hive, es decir, el catálogo de archivos y sus tipos en DataLake, es desempeñado por el servicio «Data catalog», que no oculta su compatibilidad con el formato Apache Hive. En este servicio, hay que añadir información sobre dónde están tus archivos y en qué formato están. Los datos pueden estar no solo en s3, sino también en una base de datos, aunque de eso no trata esta publicación. Así es como organizamos el catálogo de datos de DataLake:
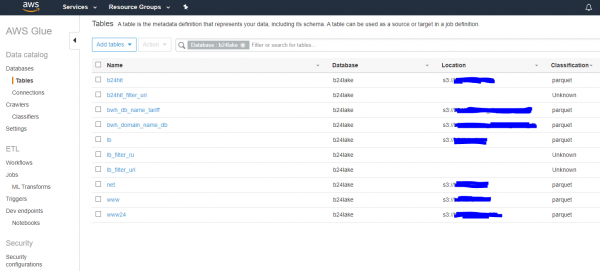
Los archivos están registrados, excelente. Si los archivos se actualizan, lanzamos manualmente o programamos crawlers que actualizarán la información sobre ellos desde el lago y la guardarán. Luego, los datos del lago se pueden procesar y los resultados exportar a algún lugar. En el caso más simple, exportamos también a s3. El procesamiento de datos se puede realizar en cualquier lugar, pero se sugiere configurar el proceso de procesamiento en un clúster de Apache Spark utilizando las capacidades avanzadas a través de la API de AWS Glue. En esencia, puedes tomar el viejo y conocido código en python utilizando la librería pyspark y configurar su ejecución en N nodos de un clúster de cierta capacidad con monitoreo, sin tener que hurgar en lo más profundo de Hadoop y arrastrar contenedores de Docker, así como eliminar conflictos de dependencias.
Una vez más: una idea simple. No es necesario configurar Apache Spark, solo hay que escribir el código en python para pyspark, probarlo localmente en el escritorio y luego ejecutarlo en un gran clúster en la nube, indicando dónde están los datos de origen y dónde colocar el resultado. A veces es necesario y útil, y así es como lo tenemos configurado:
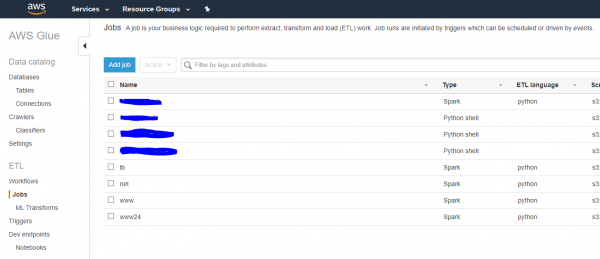
Por lo tanto, si necesitas realizar cálculos en un clúster de Spark con datos en s3, escribimos el código en python/pyspark, probamos y ¡rumbo a la nube!
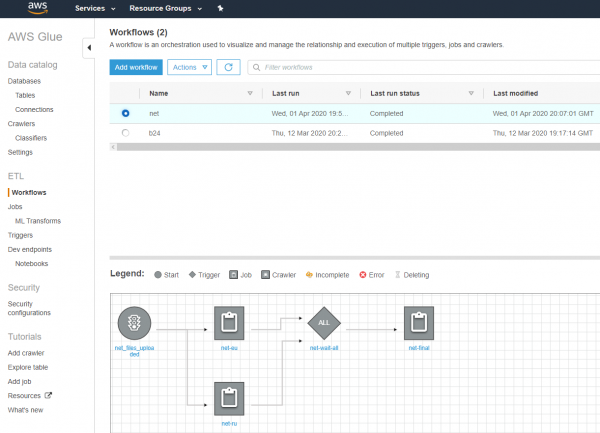
¿Y qué pasa con la orquestación? ¿Y si una tarea falla y desaparece? Sí, se propone crear un pipeline bonito al estilo de Apache Pig y realmente lo intentamos, pero decidimos seguir utilizando nuestra orquestación altamente personalizada en PHP y JavaScript (entiendo que esto puede causar disonancia cognitiva, pero funciona, lleva años haciéndolo y sin errores).
El formato de los archivos almacenados en el lago es clave para el rendimiento
Es muy, muy importante entender dos puntos clave más. Para que las solicitudes de datos de los archivos en el lago se realicen lo más rápido posible y el rendimiento no se degrade al añadir nueva información, se necesita:
- Almacenar las columnas de los archivos por separado (para que no se necesite leer todas las filas para entender qué hay en las columnas). Para esto, utilizamos el formato parquet con compresión.
- Es muy importante shardear los archivos en carpetas de la forma: idioma, año, mes, día, semana. Los motores que entienden este tipo de sharding solo buscarán en las carpetas necesarias, sin tener que procesar todos los datos a la vez.
En esencia, de esta manera, se presentan los datos originales en la forma más efectiva para los motores analíticos que pueden entrar selectivamente en las carpetas shardadas y leer solo las columnas necesarias de los archivos. No es necesario 'subir' los datos en ningún lado (el almacenamiento simplemente colapsaría) — simplemente colócalos de manera razonable en el sistema de archivos en el formato correcto. Por supuesto, debe quedar claro que almacenar un enorme archivo csv en DataLake, que necesita ser leído línea por línea por un clúster para extraer columnas, no es muy práctico. Reflexiona sobre los dos puntos mencionados anteriormente de nuevo si aún no comprendes por qué es necesario.
AWS Athena — "el genio de la lámpara"
Y aquí, al crear el lago, nos encontramos, casi por casualidad, con Amazon Athena. De repente, resultó que al organizar nuestros enormes archivos de registro en el formato columnar correcto (parquet) por shards-carpeta, se pueden hacer selecciones sumamente informativas y construir informes MUY rápido, SIN necesidad de un clúster de Apache Spark/Glue.
El motor de Athena, que trabaja con datos en s3, se basa en el legendario — representante de la familia de enfoques MPP (procesamiento paralelo masivo) para el manejo de datos, que obtiene información donde se encuentra, desde S3 y Hadoop hasta Cassandra y archivos de texto ordinarios. Solo hay que solicitar a Athena que ejecute una consulta SQL, y luego todo "funciona rápido y solo". Es importante señalar que Athena es "inteligente", solo accede a las carpetas fragmentadas necesarias y lee solo las columnas que se solicitan.
Los costos de las consultas a Athena también son interesantes. Pagamos por . Es decir, no por el número de máquinas en el clúster por minuto, sino... por los datos realmente escaneados en 100-500 máquinas, solo los necesarios para ejecutar la consulta.
Al solicitar solo las columnas necesarias de las carpetas adecuadamente fragmentadas, resultó que el servicio de Athena nos cuesta decenas de dólares al mes. ¡Es genial, casi gratis, en comparación con la analítica en clústeres!
Aquí, por cierto, cómo fragmentamos nuestros datos en S3:
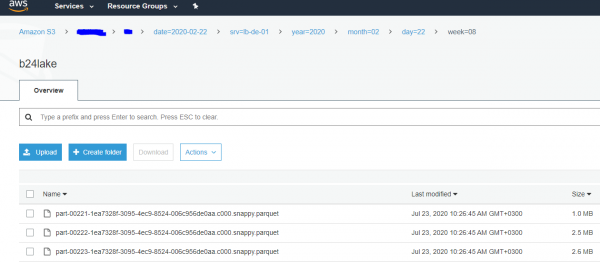
Como resultado, en poco tiempo, diferentes departamentos de la empresa, desde seguridad de la información hasta analítica, comenzaron a hacer consultas a Athena de manera activa y a recibir respuestas útiles de los "grandes" datos en segundos para períodos bastante largos: meses, medio año, etc.
Pero fuimos más allá y empezamos a buscar respuestas en la nube : el analista en la consola habitual escribe una consulta SQL, que en 100-500 máquinas "por centavos" busca datos en S3 y devuelve la respuesta generalmente en cuestión de segundos. Conveniente. Y rápido. Todavía cuesta creerlo.
Al final, al decidir almacenar datos en S3 en un formato de columna eficiente y con una fragmentación razonable de datos por carpetas... obtuvimos un DataLake y un motor analítico rápido y barato — gratis. Y se volvió muy popular en la empresa, ya que entiende SQL y funciona muchas veces más rápido que mediante el arranque/parada/configuración de clústeres. "Y si el resultado es el mismo, ¿por qué pagar más?"
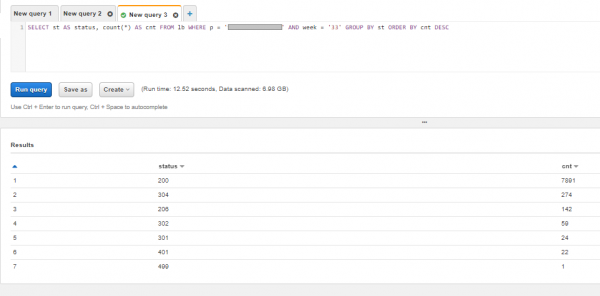
Una consulta a Athena se ve aproximadamente así. Si se desea, por supuesto, se puede formar una consulta SQL bastante , pero nos limitaremos a una simple agrupación. Veremos qué códigos de respuesta tuvo el cliente hace varias semanas en los registros del trabajo del servidor web y nos aseguraremos de que no haya errores:
Conclusiones
Tras un camino que no se puede decir que haya sido largo, pero sí doloroso, evaluando constantemente los riesgos, el nivel de dificultad y el costo de soporte, encontramos una solución para DataLake y analítica que sigue complaciéndonos tanto por su velocidad como por su costo de propiedad.
Resulta que construir un DataLake eficiente, rápido y de bajo costo operativo para las necesidades de distintos departamentos de la empresa está al alcance incluso de desarrolladores experimentados que nunca han trabajado como arquitectos y que no saben dibujar cuadros con flechas ni conocen 50 términos de la ecosistema Hadoop.
Al comienzo, la cabeza estallaba con la multitud de locos zoológicos de software abierto y cerrado y la carga de responsabilidad hacia las futuras generaciones. Simplemente comienza a construir tu DataLake con herramientas simples: nagios/munin -> elastic/kibana -> Hadoop/Spark/s3..., recopilando retroalimentación y comprendiendo profundamente la física de los procesos en marcha. Deja todo lo complicado y confuso para los enemigos y competidores.
Si no quieres ir a la nube y prefieres mantener, actualizar y parchear proyectos abiertos, puedes construir una esquema similar a la nuestra de manera local, en máquinas de oficina económicas con Hadoop y Presto encima. Lo principal es no detenerse y avanzar, contar, buscar soluciones simples y claras, ¡y todo saldrá bien! ¡Buena suerte a todos y hasta la próxima!
Fuente: habr.com
