

Veamos el concepto de monitoreo de Kubernetes, conozcamos la herramienta Prometheus y hablemos sobre alertas.
El tema del monitoreo es amplio y no se puede abarcar en un solo artículo. El objetivo de este texto es ofrecer una visión general sobre las herramientas, conceptos y enfoques.
El material del artículo es un resumen de . Si deseas recibir una formación completa, inscribirte en el curso sobre .
Qué se monitoriza en un clúster de Kubernetes
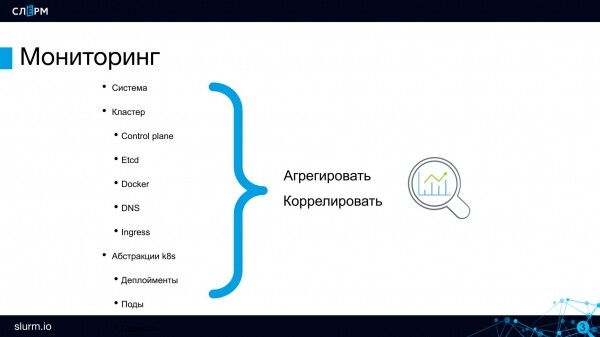
Servidores físicos. Si el clúster de Kubernetes está desplegado en tus propios servidores, es necesario supervisar su estado. Esta tarea es manejada por Zabbix; si ya trabajas con él, no es necesario renunciar, no habrá conflictos. Precisamente Zabbix se encarga de monitorear el estado de nuestros servidores.
Pasemos a la supervisión a nivel de clúster.
Componentes del Control Plane: API, Scheduler y otros. Como mínimo, hay que asegurarse de que haya más de 0 servidores API o etcd. Etcd puede proporcionar muchas métricas: sobre los discos en los que está funcionando, sobre la salud de su propio clúster etcd y otros.
Docker existe desde hace tiempo y sus problemas son bien conocidos: numerosos contenedores generan bloqueos y otros problemas. Por lo tanto, también vale la pena controlar Docker como sistema, al menos en términos de disponibilidad.
DNS. Si el DNS en el clúster falla, todo el servicio de descubrimiento también fallará y las solicitudes entre pods dejarán de funcionar. En mi experiencia, no he tenido problemas similares, pero eso no significa que no debamos supervisar el estado del DNS. Se pueden rastrear retrasos en las solicitudes y algunas otras métricas en CoreDNS.
Ingress. Es necesario controlar la disponibilidad de los ingress (incluido el Ingress Controller) como puntos de entrada en el proyecto.
Ya hemos analizado los componentes principales del clúster; ahora bajemos a un nivel de abstracción más bajo.
Aparentemente, las aplicaciones se ejecutan en los pods, por lo que deberían ser monitoreadas, pero en realidad no es así. Los pods son efímeros: hoy están en un servidor, mañana en otro; hoy hay 10, mañana 2. Por lo tanto, simplemente nadie monitorea los pods. En una arquitectura de microservicios, es más importante controlar la disponibilidad de la aplicación en su conjunto. En particular, verificar la disponibilidad de los endpoints del servicio: ¿está funcionando algo? Si la aplicación es accesible, lo que sucede detrás de ella y cuántas réplicas hay en ese momento son cuestiones de segundo orden. No es necesario hacer un seguimiento de instancias individuales.
En el nivel más alto, es necesario controlar el funcionamiento de la aplicación misma, capturar métricas de negocio: cantidad de pedidos, comportamiento de los usuarios, entre otros.
Prometheus
El mejor sistema para monitorear un clúster es . No conozco ninguna herramienta que pueda compararse con Prometheus en calidad y facilidad de uso. Es ideal para una infraestructura flexible, por lo que cuando se habla de "monitoreo de Kubernetes", generalmente se refiere a Prometheus.
Hay un par de formas de empezar a trabajar con Prometheus: se puede instalar Prometheus normal o Prometheus Operator usando Helm.
- Prometheus normal. Todo está bien, pero es necesario configurar ConfigMap, esencialmente escribiendo archivos de configuración en texto, como hacíamos antes de la arquitectura de microservicios.
- Prometheus Operator es un poco más complejo en su lógica interna, pero es más fácil de trabajar: hay objetos separados, las abstracciones se agregan al clúster, por lo que son mucho más cómodas de controlar y configurar.
Para familiarizarse con el producto, recomiendo primero instalar Prometheus normal. Tendrás que configurarlo todo a través del archivo de configuración, pero te será útil: entenderás cómo se relaciona todo y cómo se configura. Con Prometheus Operator, subes de inmediato a una abstracción superior, aunque si deseas profundizar, también será posible.
Prometheus está bien integrado con Kubernetes: puede comunicarse con el API Server e interactuar con él.
Prometheus es popular, por lo que cuenta con el soporte de una gran cantidad de aplicaciones y lenguajes de programación. Es necesario el soporte, ya que Prometheus tiene su propio formato de métricas, y para su transmisión se necesita ya sea una biblioteca dentro de la aplicación o un exportador ya preparado. Y hay muchos exportadores. Por ejemplo, existe PostgreSQL Exporter: toma datos de PostgreSQL y los convierte al formato de Prometheus para que Prometheus pueda trabajar con ellos.
La arquitectura de Prometheus
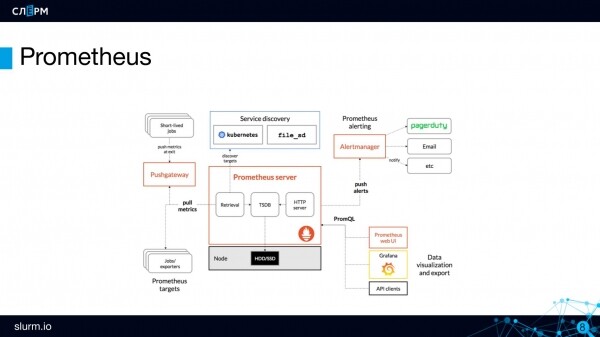
Servidor Prometheus — es la parte del servidor, el cerebro de Prometheus. Aquí se almacenan y procesan las métricas.
Las métricas son almacenadas por una base de datos de series temporales (TSDB). TSDB no es una base de datos separada, sino un paquete en lenguaje Go que está incrustado en Prometheus. En términos generales, todo se encuentra en un solo binario.
No almacenes datos en TSDB por mucho tiempo.
La infraestructura de Prometheus no es adecuada para el almacenamiento prolongado de métricas. Por defecto, el período de retención es de 15 días. Se puede sobrepasar este límite, pero hay que tener en cuenta que cuanto más datos almacenes en TSDB y cuanto más tiempo lo hagas, más recursos consumirá. Almacenar datos históricos en Prometheus se considera una mala práctica.
Si tienes un gran volumen de tráfico, con cientos de miles de métricas por segundo, es mejor limitar su almacenamiento en función del espacio en disco o del tiempo. Normalmente se almacenan en TSDB los "datos calientes", métricas que se generan literalmente en unas pocas horas. Para almacenamiento a largo plazo, se utilizan almacenes externos en bases de datos que realmente son adecuadas para esto, como InfluxDB, ClickHouse, etc. He visto más buenas opiniones sobre ClickHouse.
El servidor de Prometheus opera bajo el modelo pull: busca las métricas en los endpoints que le hemos proporcionado. Se le indica: "busca en API Server" y cada n segundos accede a ese lugar y recoge las métricas.
Para objetos con una vida útil corta (job o cron job), que pueden surgir entre períodos de recopilación, hay un componente Pushgateway. Las métricas de objetos a corto plazo se envían al Pushgateway: el job se inicia, realiza su acción, envía las métricas al Pushgateway y finaliza. Después de un tiempo, Prometheus, a su propio ritmo, accede y recupera estas métricas del Pushgateway.
Para la configuración de notificaciones en Prometheus, hay un componente separado — Alertmanager. Y las reglas de alerta — alerting rules. Por ejemplo, se necesita crear una alerta en caso de que los servidores API estén en 0. Cuando el evento se desencadena, la alerta se envía al alert manager para su posterior envío. El alert manager tiene configuraciones de enrutamiento bastante flexibles: un grupo de alertas puede enviarse a un chat de Telegram para administradores, otro al chat de desarrolladores, y otro al chat de responsables de infraestructura. Las notificaciones pueden llegar a Slack, Telegram, correo electrónico y otros canales.
Finalmente, hablaré sobre la característica destacada de Prometheus — Discovering. Al trabajar con Prometheus no es necesario especificar direcciones concretas de los objetos a monitorear, solo es suficiente definir su tipo. Es decir, no es necesario escribir "aquí está la dirección IP, aquí el puerto — monitorea", en su lugar, hay que determinar sobre qué principios encontrar estos objetos (targets — objetivos). Prometheus se encarga automáticamente, dependiendo de qué objetos estén activos en ese momento, de añadirlos a la monitorización.
Este enfoque se adapta bien a la estructura de Kubernetes, donde todo es cambiante: hoy 10 servidores, mañana 3. Para no tener que especificar la dirección IP de un servidor cada vez, se establece una única forma de encontrarla, y Discovering se encargará de ello.
El lenguaje de Prometheus se llama PromQL. Con este lenguaje se pueden obtener valores de métricas específicas y luego transformarlos, construyendo análisis a partir de ellos.
https://prometheus.io/docs/prometheus/latest/querying/basics/

Consulta simple

    container_memory_usage_bytes

Operaciones matemáticas

    container_memory_usage_bytes / 1024 / 1024

Funciones integradas

    sum(container_memory_usage_bytes) / 1024 / 1024

Aclaración de la consulta

    100 - avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m]) * 100)
Interfaz web de Prometheus
Prometheus tiene su propia interfaz web, bastante minimalista. Solo es adecuada para depuración o demostración.
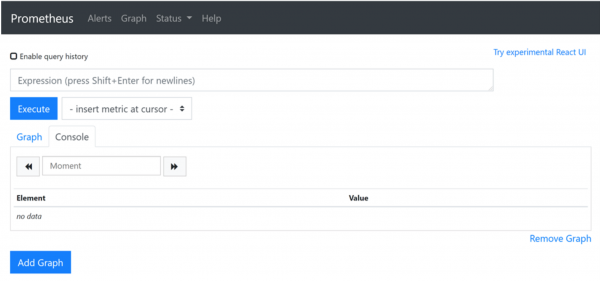
En la línea de Expression se puede escribir una consulta en el lenguaje PromQL.
En la pestaña Alerts se encuentran las reglas de alerta — alerting rules, y tienen tres estados:
- inactivo — si en este momento la alerta no está activa, es decir, que todo está bien y no se ha activado;
- pendiente — esto ocurre si la alerta se activó, pero el envío aún no ha tenido lugar. Se establece un retraso para compensar las fluctuaciones de la red: si un servicio está activo durante un minuto, no hay necesidad de disparar la alarma todavía;
- activada — este es el tercer estado, cuando la alerta se activa y envía mensajes.
En el menú Status encontrarás acceso a información sobre lo que representa Prometheus. También hay un enlace a los objetivos (targets) de los que hablamos anteriormente.
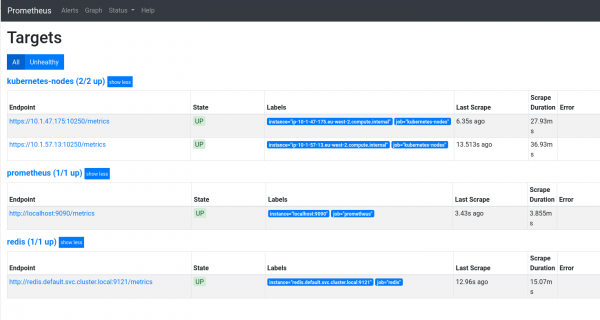
Para una revisión más detallada de la interfaz de Prometheus, consulta .
Integración con Grafana
En la interfaz web de Prometheus no encontrarás gráficos bonitos y claros que te permitan hacer conjeturas sobre el estado del clúster. Para generarlos, se integra Prometheus con Grafana. Así se crean estos tableros.
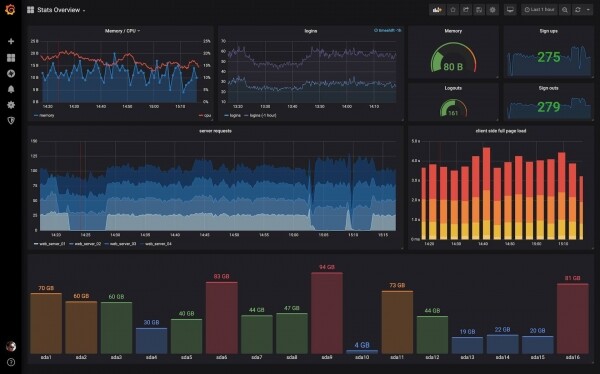
Configurar la integración de Prometheus y Grafana no es complicado, puedes encontrar instrucciones en la documentación: , y con esto concluiré.
En los próximos artículos continuaremos con el tema de la monitorización: hablaremos sobre la recolección y el análisis de registros utilizando Grafana Loki y herramientas alternativas.
Autor: Marcel Ibraev, administrador certificado de Kubernetes, ingeniero en la empresa , ponente y desarrollador de los cursos de Slyrm.
Fuente: habr.com
