

Introducción
Hace un tiempo, se me planteó la tarea de desarrollar un clúster de alta disponibilidad para , que funcione en varios centros de datos interconectados por fibra óptica dentro de una misma ciudad, y que sea capaz de soportar la falla (por ejemplo, un corte de energía) de un centro de datos. Como software que garantiza la alta disponibilidad, elegí , porque es la solución oficial de RedHat para crear clústeres de alta disponibilidad. Es ventajoso porque RedHat lo respalda, y porque esta solución es universal (modular). Con su ayuda, se podrá asegurar la alta disponibilidad no solo de PostgreSQL, sino también de otros servicios, ya sea utilizando módulos estándar o creando módulos para necesidades específicas.
A esta solución surgió la pregunta razonable: ¿qué tan tolerante a fallos será el clúster de alta disponibilidad? Para investigar esto, desarrollé un banco de pruebas que simula diversas fallas en los nodos del clúster, espera la recuperación de la operatividad, recupera el nodo fallido y continúa las pruebas en un ciclo. Originalmente, este proyecto se llamaba hapgsql, pero con el tiempo, me aburrí del nombre, que solo contenía una vocal. Por lo tanto, comencé a llamar a las bases de datos de alta disponibilidad (y la IP flotante que las apunta) krogan (un personaje de un videojuego que tiene todos sus órganos vitales duplicados), y los nodos, los clústeres y el propio proyecto — tuchanka (el planeta donde viven los kroganes).
Ahora la dirección ha permitido . El README será traducido al inglés en breve (porque se espera que los principales consumidores sean los desarrolladores de Pacemaker y PostgreSQL), y decidí presentar la antigua versión en ruso del README (parcialmente) en esta artículo.
Los clústeres se desplegarán en máquinas virtuales . Se desplegarán un total de 12 máquinas virtuales (en total 36GiB), que formarán 4 clústeres de alta disponibilidad (diferentes variantes). Los primeros dos clústeres constan de dos servidores PostgreSQL, que se encuentran en diferentes centros de datos, y un servidor general witness c quorum device (ubicado en una máquina virtual barata en el tercer centro de datos), que resuelve la incertidumbre 50%/50%, otorgando su voto a una de las partes. El tercer clúster está en tres centros de datos: un maestro, dos esclavos, sin quorum device. El cuarto clúster consta de cuatro servidores PostgreSQL, dos por centro de datos: uno maestro y los otros réplicas, y también utiliza witness c quorum device. El cuarto soporta la falla de dos servidores o de un centro de datos. Esta solución puede ser escalada a un mayor número de réplicas si es necesario.
Servicio de tiempo preciso también ha sido reconfigurado para la alta disponibilidad, pero utiliza el método más ntpd (orphan mode). El servidor general witness actúa como el servidor NTP central, distribuyendo su tiempo a todos los clústeres, sincronizando así todos los servidores entre sí. Si witness se desconecta o se encuentra aislado, entonces uno de los servidores del clúster comenzará a distribuir su propio tiempo (dentro del clúster). Un proxy de caché auxiliar HTTP proxy también se ha levantado en witness, mediante el cual las demás máquinas virtuales tienen acceso a los repositorios de Yum. En la realidad, servicios como el tiempo preciso y el proxy, seguramente estarán alojados en servidores dedicados, pero en esta configuración están ubicados en witness solo para ahorrar en el número de máquinas virtuales y espacio.
Versiones
v0. Funciona con CentOS 7 y PostgreSQL 11 en VirtualBox 6.1.
Estructura de los clústeres
Todos los clústeres están destinados a ubicarse en múltiples centros de datos, unidos en una sola red plana y deben soportar la falla o aislamiento de red de un centro de datos. Por lo tanto, no es posible se utiliza para proteger contra split-brain la tecnología estándar de Pacemaker, que se llama STONITH (Shoot The Other Node In The Head) o fencing. Su esencia: si los nodos en el clúster comienzan a sospechar que algo está mal con algún nodo, no responde o se comporta incorrectamente, lo desconectan forzosamente a través de dispositivos “externos”, como una tarjeta de control IPMI o un UPS. Pero esto solo funcionará en casos donde, tras la falla de un servidor, el IPMI o el UPS continúan funcionando. Aquí se planea proteger contra una falla mucho más catastrófica, cuando falla (por ejemplo, se corta la energía) todo el centro de datos. Y en tal caso todos los dispositivos stonith(IPMI, UPS, etc.) tampoco funcionarán.
En su lugar, el sistema se basa en la idea de quorum. Todos los nodos tienen voz, y solo pueden funcionar aquellos que pueden ver más de la mitad de todos los nodos. Esta cantidad “mitad+1” se llama quórum. Si no se alcanza quorum, el nodo decide que está en aislamiento de red y debe desconectar sus recursos, es decir, es una protección contra split-brainSi el software que controla este comportamiento no funciona, debe activarse un watchdog, por ejemplo, basado en IPMI.
Si el número de nodos es par (clúster en dos centros de datos), puede surgir lo que se llama una indeterminación. 50%/50% (cincuenta-cincuenta), cuando la aislamiento de red divide el clúster exactamente por la mitad. Por lo tanto, para un número par de nodos se añade quorum device — un demonio sin requerimientos, que puede ejecutarse en la virtualización más barata de un tercer centro de datos. Este emite su voto a uno de los segmentos (que puede ver), resolviendo así la indeterminación 50%/50%. El servidor en el que se ejecutará el dispositivo de quorum lo llamé witness (terminología de repmgr, me gustó).
Los recursos pueden moverse de un lugar a otro, por ejemplo, de servidores defectuosos a servidores operativos, o por orden de los administradores de sistemas. Para que los clientes sepan dónde están los recursos que necesitan (¿a dónde deben conectarse?), se utilizan IPs flotantes (float IP). Estas son IPs que Pacemaker puede mover entre los nodos (todo está en una red plana). Cada una simboliza un recurso (servicio) y estará donde se necesita conectarse para acceder a este servicio (en nuestro caso, la base de datos).
Tuchanka1 (esquema con compresión)
Estructura
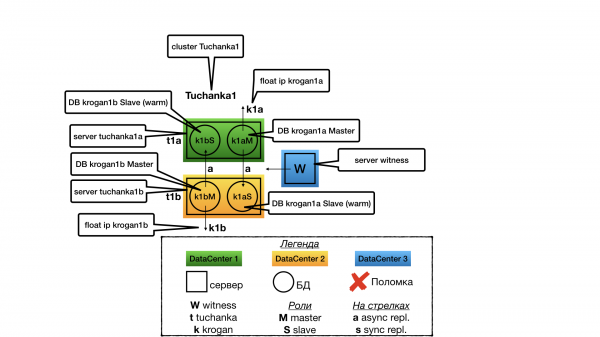
La idea era que tuviéramos muchas bases de datos pequeñas con baja carga, para las cuales no es rentable mantener un servidor esclavo dedicado en modo hot standby para transacciones solo de lectura (no hay necesidad de tal despilfarro de recursos).
En cada centro de datos hay un servidor. Cada servidor tiene dos instancias de PostgreSQL (en la terminología de PostgreSQL se llaman clústeres, pero para evitar confusiones los llamaré instancias (por analogía con otras bases de datos), y reservaré el término clúster para los clústeres de Pacemaker). Una instancia opera en modo maestro, y solo ella presta servicios (solo en ella se dirige la IP flotante). La segunda instancia funciona como esclavo para el segundo centro de datos, y solo prestará servicios si su maestro falla. Dado que la mayor parte del tiempo solo una de las dos instancias (el maestro) prestará servicios (realizará consultas), todos los recursos del servidor se optimizan para el maestro (se asigna memoria para caché shared_buffers, etc.), pero asegurando que la segunda instancia también disponga de recursos (aunque sea para un funcionamiento no óptimo a través de la caché del sistema de archivos) en caso de que falle uno de los centros de datos. El esclavo no presta servicios (no ejecuta consultas de solo lectura) durante el funcionamiento normal del clúster, para evitar la competencia por recursos con el maestro en la misma máquina.
En el caso de dos nodos, la tolerancia a fallos solo es posible con replicación asíncrona, ya que con replicación síncrona la falla del esclavo provocará la detención del maestro.
Fallo witness
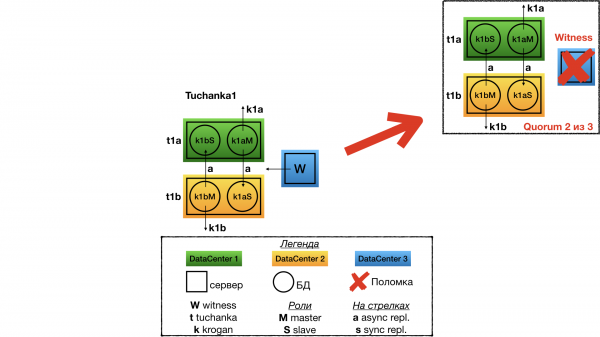
Fallo witness (quorum device) lo consideraré solo para el clúster Tuchanka1, con todos los demás sucederá lo mismo. Con la falla del witness, la estructura del clúster no cambiará, todo seguirá funcionando como lo hacía. Pero el quórum será igual a 2 de 3, y por lo tanto cualquier siguiente falla será fatal para el clúster. Tendremos que arreglarlo de inmediato.
Fallo Tuchanka1
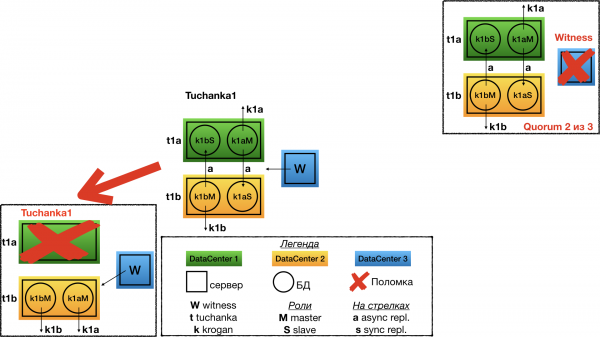
Fallo de uno de los centros de datos para Tuchanka1. En este caso witness da su voto al segundo nodo en el segundo centro de datos. Allí, el anterior esclavo se convierte en maestro, resultando que en un servidor operan ambos maestros y ambos poseen sus IP flotantes.
Tuchanka2 (clásica)
Estructura
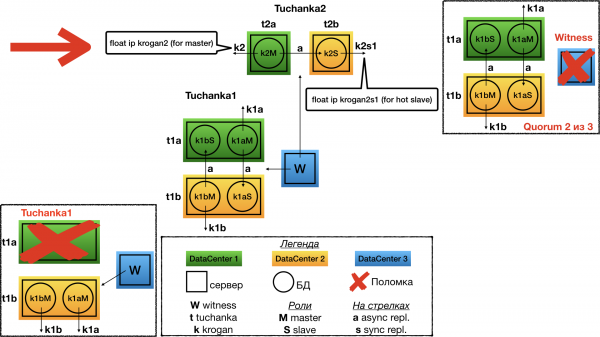
Esquema clásico de dos nodos. Uno opera como maestro, el otro como esclavo. Ambos pueden realizar consultas (el esclavo solo en modo de solo lectura), por lo que ambos tienen IP flotantes: krogan2 — para el maestro, krogan2s1 — para el esclavo. La tolerancia a fallos existirá tanto en el maestro como en el esclavo.
En el caso de dos nodos, la tolerancia a fallos solo es posible con replicación asíncrona, porque con replicación síncrona la falla del esclavo provocará la detención del maestro.
Fallo Tuchanka2
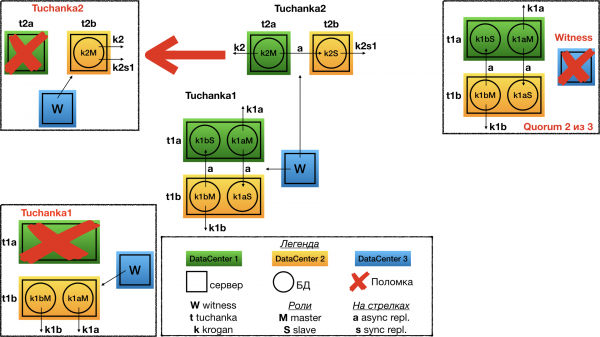
Con la falla de uno de los centros de datos witness vota por el segundo. En el único centro de datos funcionando se levantará el maestro, y ambos IP flotantes: el maestro y el esclavo apuntarán a él. Por supuesto, la instancia debe estar configurada de tal manera que tenga suficientes recursos (límites de conexión, etc.) para aceptar simultáneamente todas las conexiones y solicitudes tanto del IP flotante maestro como del esclavo. Así que en condiciones normales, debe haber un margen suficiente en los límites.
Tuchanka4 (muchos esclavos)
Estructura
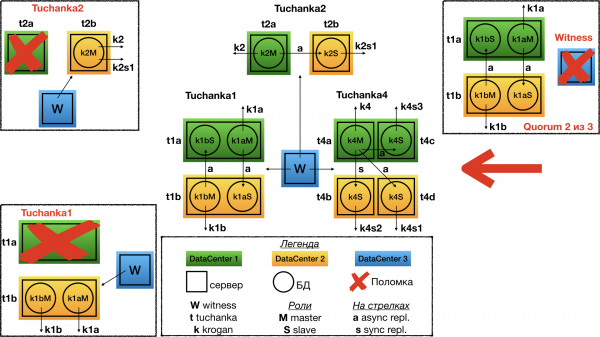
Ya es otro extremo. Hay bases de datos a las que llegan muchas solicitudes de solo lectura (un caso típico de un sitio web altamente demandado). Tuchanka4 es una situación en la que puede haber tres o más esclavos para manejar tales solicitudes, pero aún no demasiados. Con un número muy elevado de esclavos, se necesitará inventar un sistema de replicación jerárquico. En el caso mínimo (en la imagen), hay dos servidores en cada uno de los dos centros de datos, cada uno con una instancia de PostgreSQL.
Otra característica de este esquema es que aquí ya se puede organizar una replicación síncrona. Está configurada para replicar, siempre que sea posible, en otro centro de datos, y no en la réplica en el mismo centro de datos donde está el maestro. Tanto el maestro como cada esclavo apuntan a un IP flotante. Idealmente, se debería hacer balanceo de solicitudes entre los esclavos con algún tipo de proxy sql, por ejemplo, del lado del cliente. Diferentes tipos de clientes pueden requerir diferentes tipos proxy sql, y solo los desarrolladores de los clientes saben quién necesita qué. Esta funcionalidad puede ser implementada tanto por un demonio externo, como por una biblioteca del cliente (pool de conexiones), etc. Todo esto está más allá del tema de un clúster de base de datos tolerante a fallos (la tolerancia a fallos proxy SQL se podrá implementar de manera independiente, junto con la tolerancia a fallos del cliente).
Fallo de Tuchanka4
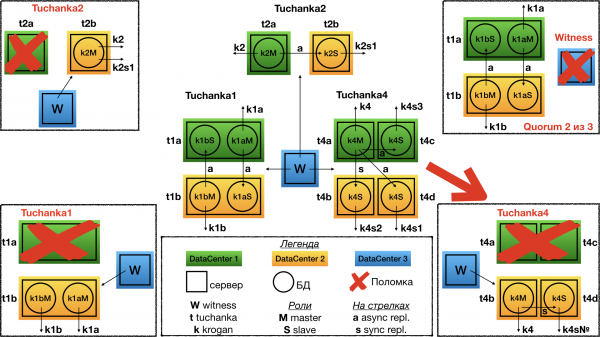
En caso de fallo de un centro de datos (es decir, de los dos servidores), el testigo vota por el segundo. Como resultado, en el segundo centro de datos funcionan dos servidores: en uno está el maestro, y apunta al IP flotante maestro (para recibir solicitudes de lectura y escritura); y en el segundo servidor funciona un esclavo con replicación síncrona, y a él apunta uno de los IP flotantes esclavos (para solicitudes de solo lectura).
Lo primero que hay que señalar es que no todos los IP flotantes esclavos serán operativos, sino solo uno. Y para su correcto funcionamiento será necesario que proxy sql redirige todas las solicitudes al único IP flotante restante; y si no, proxy sql se pueden enumerar todos los IP flotantes de esclavos separados por comas en la URL para la conexión. En tal caso, libpq la conexión será al primer IP funcional, así está hecho en el sistema de pruebas automáticas. Es posible que en otras bibliotecas, como JDBC, no funcione de esta manera y sea necesario proxy sql. Esto se debe a que los IP flotantes de los esclavos tienen prohibido levantarse simultáneamente en un mismo servidor, para que se distribuyan equitativamente entre los servidores esclavos si hay varios funcionando.
Segundo: incluso en caso de falla del centro de datos, se mantendrá la replicación sincrónica. E incluso si ocurre una falla secundaria, es decir, si uno de los dos servidores en el centro de datos restante falla, el clúster, aunque dejará de ofrecer servicios, aún conservará la información de todas las transacciones confirmadas, para las que ha dado confirmación de commit (no habrá pérdida de información en caso de falla secundaria).
Tuchanka3 (3 centros de datos)
Estructura
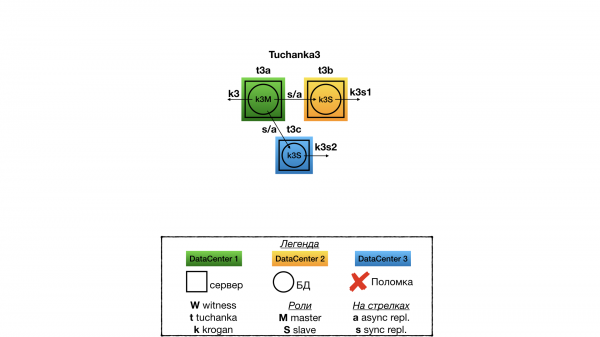
Este es un clúster para situaciones en las que hay tres centros de datos completamente operativos, en cada uno de los cuales hay un servidor de base de datos completamente funcional. En este caso, quorum device no es necesario. En un centro de datos opera el maestro, en los otros dos — esclavos. La replicación es sincrónica, del tipo ANY (slave1, slave2), es decir, el cliente recibirá la confirmación de commit cuando cualquiera de los esclavos responda primero que ha aceptado el commit. Un solo IP flotante señala para el maestro y dos para los esclavos. A diferencia de Tuchanka4, los tres IP flotantes son tolerantes a fallos. Para equilibrar las consultas SQL de solo lectura se puede usar proxy sql (con tolerancia a fallos separada), o asignar un IP flotante de esclavo a la mitad de los clientes, y el segundo a la otra mitad.
Fallo de Tuchanka3
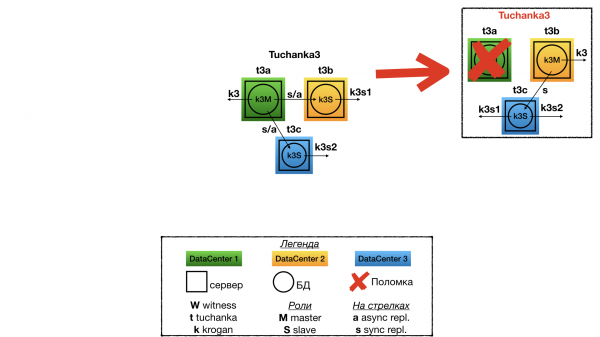
En caso de fallo de uno de los centros de datos, quedan dos. En uno está levantado el maestro y el IP flotante del maestro, en el segundo — un esclavo y ambos IP flotantes de esclavos (el instancia debe tener un doble suministro de recursos para aceptar todas las conexiones de ambos IP flotantes de esclavos). Entre el maestro y el esclavo hay replicación sincrónica. Además, el clúster conservará la información sobre las transacciones confirmadas y verificadas (no habrá pérdida de información) en caso de destrucción de dos centros de datos (si no son destruidos al mismo tiempo).
He decidido no incluir una descripción detallada de la estructura de archivos y la implementación. Quien quiera experimentar, puede leer todo eso en el README. Solo presento una descripción de las pruebas automáticas.
Sistema de pruebas automáticas
Se ha creado un sistema de pruebas automáticas para verificar la resistencia del clúster simulando diversas fallas. Se ejecuta mediante un script test/failure. El script puede aceptar como parámetros los números de los clústeres que se desean probar. Por ejemplo, este comando:
test/failure 2 3probará solamente el segundo y el tercer clúster. Si no se especifican parámetros, se probarán todos los clústeres. Todos los clústeres se prueban en paralelo, y el resultado se muestra en la consola de tmux. Tmux utiliza un servidor tmux dedicado, por lo que el script puede ejecutarse desde el tmux predeterminado, resultando en un tmux anidado. Recomiendo usar una terminal en una ventana grande y con una fuente pequeña. Antes de comenzar las pruebas, todas las máquinas virtuales se restauran a un snapshot que coincide con el momento en que finalizó el script. configuración.
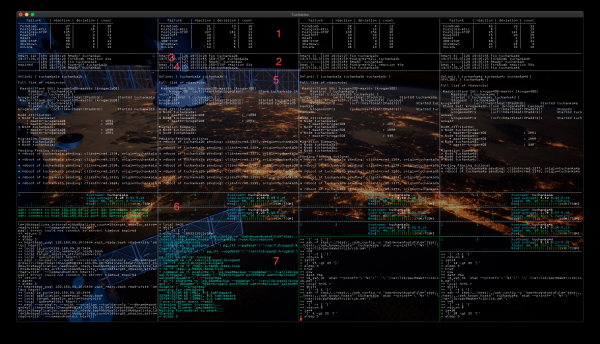
La terminal se divide en columnas según el número de clústeres en prueba, que por defecto (en la captura de pantalla) son cuatro. Describiré el contenido de las columnas usando Tuchanka2 como ejemplo. Los paneles de la captura de pantalla están numerados:
- Aquí se muestra la estadística de las pruebas. Columnas:
- failure — el nombre de la prueba (funciones en el script) que simula la falla.
- reaction — el tiempo promedio en segundos que el clúster tardó en recuperar su operatividad. Se mide desde el inicio del script que simula la falla hasta el momento en que el clúster recupera su capacidad operativa y puede seguir prestando servicios. Si el tiempo es muy corto, por ejemplo, seis segundos (esto ocurre en clústeres con múltiples esclavos (Tuchanka3 y Tuchanka4)), esto indica que la falla ocurrió en un esclavo asincrónico y no afectó la operatividad, no hubo cambios en el estado del clúster.
- deviation — muestra la dispersión (precisión) del valor reaction a través del método de «desviación estándar».
- count — cuántas veces se ha realizado esta prueba.
- El registro resumido permite evaluar qué está haciendo el clúster en ese momento. Se muestra el número de iteración (prueba), un timestamp y el nombre de la operación. Una ejecución demasiado larga (> 5 minutos) indica algún problema.
- heart (corazón) — tiempo actual. Para la evaluación visual del funcionamiento maestro en su tabla se escribe constantemente el tiempo actual usando el IP flotante del maestro. En caso de éxito, el resultado se muestra en este panel.
- latido (pulso) — "tiempo actual", que había sido grabado anteriormente por el script heart en el maestro, ahora se lee desde esclavo a través de su IP flotante. Permite evaluar visualmente el funcionamiento del esclavo y la replicación. En Tuchanka1 no hay esclavos con IP flotante (no hay esclavos que brinden servicios), pero hay dos instancias (BD), por lo que aquí no se mostrará el latido, y heart segunda instancia.
- Supervisión del estado del clúster utilizando la herramienta
pcs mon. Muestra la estructura, la distribución de recursos entre los nodos y otra información útil. - Aquí se muestra la monitorización del sistema de cada máquina virtual del clúster. Puede haber más de estos paneles — tantas como máquinas virtuales haya en el clúster. Dos gráficos Carga de CPU (en las máquinas virtuales hay dos procesadores), nombre de la máquina virtual, Carga del sistema (denominado como Promedio de Carga, porque está promediado durante 5, 10 y 15 minutos), datos sobre los procesos y distribución de memoria.
- Rastreo del script que realiza las pruebas. En caso de mal funcionamiento — interrupción repentina del trabajo o ciclo de espera infinito — aquí se podrá ver la causa de ese comportamiento.
Las pruebas se realizan en dos etapas. Primero, el script recorre todas las variedades de pruebas, eligiendo aleatoriamente la máquina virtual a la que se aplicará esta prueba. Luego se ejecuta un ciclo infinito de pruebas, eligiendo aleatoriamente máquinas virtuales y fallos cada vez. La finalización repentina del script de prueba (panel inferior) o un ciclo de espera infinito de algo (> 5 minutos de tiempo de ejecución de una operación, esto se ve en el rastreo) indica que alguna de las pruebas en este clúster ha fallado.
Cada prueba consiste en las siguientes operaciones:
- Inicio de una función que emula un fallo.
- ¿Listo? — espera la restauración del funcionamiento del clúster (cuando se restablecen todos los servicios).
- Se muestra el tiempo de espera para la restauración del clúster (reaction).
- Reparar — el clúster "se repara". Después, debe volver a un estado completamente operativo y listo para el siguiente fallo.
Aquí está la lista de pruebas con una descripción de lo que hacen:
- ForkBomb: crea "Sin memoria" con una bomba de fork.
- Sin espacio: llena el disco duro. Sin embargo, la prueba es más bien simbólica, dado que la carga que se genera durante la prueba es insignificante, y normalmente no ocurre una falla de PostgreSQL al llenar el disco duro.
- Postgres-KILL: termina PostgreSQL con el comando
killall -KILL postgres. - Postgres-STOP: suspende PostgreSQL con el comando
killall -STOP postgres. - PowerOff: «apaga» la máquina virtual con el comando
VBoxManage controlvm "máquina virtual" poweroff. - Reset: reinicia la máquina virtual con el comando
VBoxManage controlvm "máquina virtual" reset. - SBD-STOP: suspende el demonio SBD con el comando
killall -STOP sbd. - ShutDown: envía a la máquina virtual el comando a través de SSH
systemctl poweroff, el sistema se apaga correctamente. - UnLink: aislamiento de red, comando
VBoxManage controlvm "máquina virtual" setlinkstate1 off.
Finalización de la prueba ya sea con el comando estándar de tmux "kill-window" Ctrl-b &, o con el comando "detach-client" Ctrl-b d: en este caso, la prueba se completa, tmux se cierra, las máquinas virtuales se apagan.
Problemas detectados durante la prueba
En este momento demonio watchdog sbd maneja la detención de los demonios supervisados, pero no su congelación. Y, como consecuencia, las fallas que llevan a el bloqueo solo son manejadas incorrectamente Corosync y Pacemaker, pero que no cuelgan sbd. Para verificar Corosync ya hay , aceptado en la rama master. Prometieron (en PR#83) que habría algo similar para Pacemaker, espero que para RedHat 8 lo hagan. Pero tales «fallos» son teóricos, se pueden simular fácilmente artificialmente mediante, por ejemplo,
killall -STOP corosync, pero nunca ocurren en la vida real.En Pacemaker en la versión para CentOS 7 se configuró incorrectamente sync_timeout sa-logic-subsets-canary-vs.yaml quorum device, como resultado , al cual debería haber migrado el maestro. Se resolvió aumentando sync_timeout sa-logic-subsets-canary-vs.yaml quorum device durante el despliegue (en el script
setup/setup1). Esta corrección no fue aceptada por los desarrolladores Pacemaker, en su lugar, prometieron rehacer la infraestructura de tal manera (en algún futuro indeterminado) que este timeout se calculara automáticamente.Si al configurar la base de datos se indica que en
LC_MESSAGES(mensajes de texto) se puede usar Unicode, por ejemplo,ru_RU.UTF-8, al iniciar postgres en un entorno donde locale no sea UTF-8, supongamos, en un entorno vacío (aquí pacemaker+pgsqlms(paf) inicia postgres), entonces . Los desarrolladores de PostgreSQL aún no han acordado qué hacer en este caso. Se soluciona, hay que configurarLC_MESSAGES=en_US.UTF-8Al configurar (creando) una instancia de base de datos.Si se establece wal_receiver_timeout (que por defecto es de 60s), durante la prueba de PostgreSQL-STOP en los maestros de los clústeres tuchanka3 y tuchanka4 . La replicación ahí es sincrónica, por lo que se detiene no solo el esclavo, sino también el nuevo maestro. Se puede sortear estableciendo wal_receiver_timeout=0 al configurar PostgreSQL.
Ocasionalmente se ha observado que la replicación de PostgreSQL se bloquea en la prueba ForkBomb (desbordamiento de memoria). . Esto solo lo he encontrado en los clústeres tuchanka3 y tuchanka4, donde, debido a que la replicación es sincrónica, se bloqueaba el maestro. El problema se resolvía solo, después de un tiempo prolongado (alrededor de dos horas). Se requiere una investigación adicional para corregir esto. Los síntomas son similares a un error anterior, que es causado por otra razón, pero con consecuencias idénticas.
La imagen del krogan se toma de con el permiso del autor:
Fuente: habr.com
