

Analizaremos los fundamentos del registro en Docker y Kubernetes, y luego examinaremos dos herramientas que se pueden utilizar sin reservas en producción: Grafana Loki y el stack EFK (Elasticsearch + Fluent Bit + Kibana).
El material del artículo es un resumen de Si hay interés y, aún más, la necesidad productiva, se puede completar la formación; inscríbase en el curso sobre .
Registro en Docker
A nivel de Kubernetes, las aplicaciones se ejecutan en pods, pero a un nivel más bajo, de hecho, funcionan normalmente en Docker. Por lo tanto, es necesario configurar el registro de tal manera que se recojan los registros de los contenedores. Los contenedores son iniciados por Docker, por lo que debemos entender cómo se estructura el registro a nivel de Docker.
Espero que cada lector sepa que los registros de la aplicación deben escribirse en stdout/stderr, y no dentro del contenedor. Docker Daemon agrega los registros, y trabaja precisamente con aquellos registros que se envían a stdout/stderr. Además, escribir registros dentro del contenedor conlleva problemas: el contenedor se hincha con el registro creciente (ya que probablemente no hay Logrotate dentro del contenedor), y Docker Daemon no está al tanto de este registro.
Docker tiene varios controladores de registro o complementos para la recolección de registros de los contenedores. En la versión gratuita de Docker Community Edition (CE), hay menos controladores de registro que en la edición comercial Docker Enterprise Edition (EE).
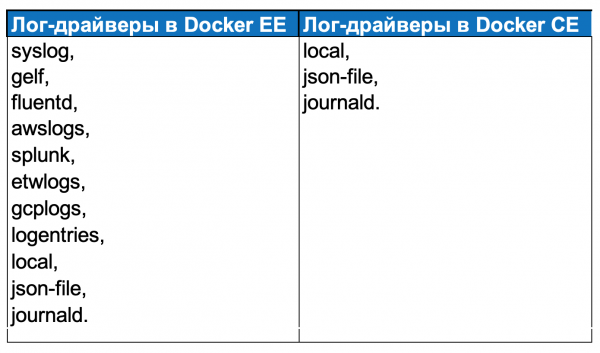
No he utilizado Docker EE en la práctica: en Southbridge intentamos adherirnos a soluciones de código abierto, y a los clientes la mayoría de las características adicionales de Docker EE no les son necesarias.
Controladores de registro en Docker CE:
local — registro de registros en archivos internos de Docker Daemon;
json-file — creación de un json-log en la carpeta de cada contenedor;
journald — envío de registros a journald.
Los ajustes de registro en Docker se encuentran en el archivo daemon.json.
En el campo “log-driver” se indica el complemento y en el campo “log-opts” sus configuraciones. En el ejemplo anterior, se ha indicado el complemento “json-file”, el límite de tamaño del registro es “max-size”: “10m”; el límite en la cantidad de archivos (configuraciones de rotación) es “max-file”: “3”; así como los valores que se adjuntarán a los registros.
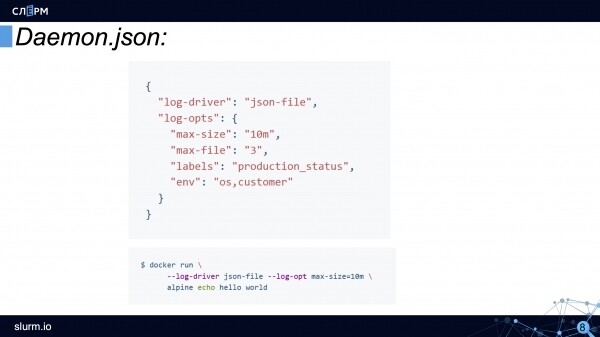
Algunas configuraciones del controlador de registro se pueden establecer a través de la utilidad de línea de comando. Esto es útil si es necesario iniciar un contenedor separado con otro controlador de registro.
Así es como se ve el esquema de registro en Docker:
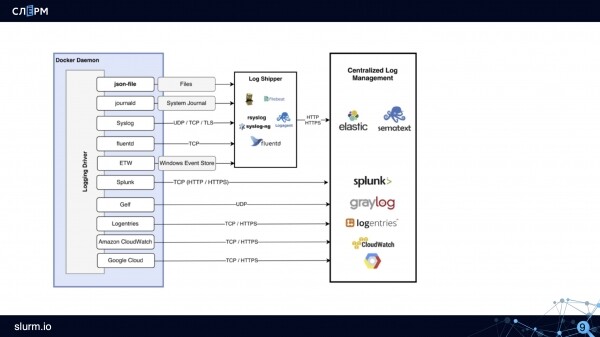
Cómo funciona el esquema: un controlador de logs, como json-file, crea archivos. Los recolectores de logs (Rsyslog, Fluentd, Logagent y otros) recogen estos archivos y los envían a almacenamiento en Elastic, Sematext u otros repositorios.
Características del registro en Kubernetes
Simplificando, el esquema de registro en Kubernetes se ve así: hay un pod, en el cual se ejecuta un contenedor, que envía logs a stdout/stderr. Luego Docker crea un archivo y registra los logs, que a su vez puede rotar.
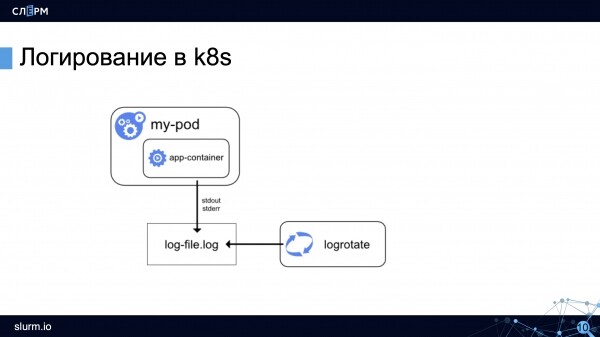
Analicemos las características del registro en Kubernetes.
Conservar logs entre despliegues. Esta es una condición imprescindible para la correcta configuración del registro. Si no se conservan los logs entre descargas, al lanzar una nueva versión de la aplicación, los logs anteriores serán sobrescritos, y reiniciar el contenedor también resultará en la pérdida de logs. Kubernetes tiene una opción: —previous, que permite ver los logs de la aplicación antes del último reinicio del Pod, pero no más allá de eso.
Agregando logs de todas las instancias. Si los microservicios están alojados en la nube, el proveedor de la nube es responsable del control del sistema. Si los microservicios están en hardware propio, además de los logs de los contenedores, también es necesario recolectar los logs del sistema.
Antes no había herramientas adecuadas para recolectar logs tanto del sistema como de los microservicios. Por lo general, una herramienta recopilaba logs del sistema (por ejemplo, Rsyslog), y otra, los logs de Docker (como journal-bit con la configuración del controlador de logs de Docker en journald). Intentamos usar journal-bit para recolectar logs tanto de los contenedores (en el controlador de logs de Docker se indicaba que era necesario escribir logs en journald) como del sistema (en CentOS 7 ya existen systemd y journald). Es una solución funcional, pero no ideal. Si hay muchos logs, journal-bit comienza a tener lag, y se pierden mensajes.
Los experimentos continuaron, y se encontró otro método. En CentOS 7, los logs del sistema principales (messages, audit, secure) se duplican en var-log en forma de archivos. También se puede configurar Docker para que los logs se guarden en archivos json. Por lo tanto, se pueden recolectar juntos estos archivos de CentOS 7 y Docker.
Con el tiempo, la solución ELK Stack se volvió popular. Es una combinación de varias herramientas: Elasticsearch, Logstash y Kibana.
Elasticsearch almacena logs de contenedores, Logstash recolecta logs de las instancias, Kibana permite procesar los logs recibidos y crear gráficos a partir de ellos. Durante un tiempo, se utilizó activamente ELK Stack, pero, en mi opinión, su tiempo está pasando. Más adelante explicaré por qué.
Agregar metadatos. Los pods, aplicaciones y contenedores pueden ejecutarse en cualquier lugar. Además, una aplicación puede tener múltiples instancias. Los registros se escriben en un formato único, y necesitamos entender qué réplica concreta está escribiendo, qué Pod lo está haciendo y en qué namespace se encuentra. Por eso es necesario agregar metadatos a los registros.
Analizar registros. Es curioso, pero los costos de soporte del sistema de registro y monitoreo pueden superar los gastos de la aplicación principal. Cuando tienes decenas y cientos de miles de registros por segundo, esto parece lógico, pero aún así hay que conocer el límite. Una de las formas de encontrar ese límite es mediante el análisis de registros.
Generalmente, no es necesario recopilar y almacenar todos los registros; solo se debe enviar al almacenamiento una parte, por ejemplo, los registros con estado «warning» o «error». En el caso de registros de nginx o controladores de ingreso, solo se deben almacenar aquellos cuyo estado es diferente de 200. Pero este no es un consejo universal: si estás construyendo de alguna manera un análisis basado en los registros de Nginx, evidentemente vale la pena recopilarlos.
No se recomienda filtrar registros sin pensar, porque los datos filtrados pueden ser insuficientes para un análisis adecuado. Por otro lado, tal vez el análisis debería realizarse no a nivel de registro, sino a nivel de recopilación de métricas. Así no tendrás que almacenar cientos de miles de líneas con código 200. Uno de los enfoques es obtener información sobre el tráfico y errores desde las métricas de los controladores de ingreso.
En general, aquí hay que pensar bien: qué quieres almacenar y durante cuánto tiempo, porque de lo contrario surgiría una situación en la que el sistema de registro consume más recursos que el proyecto principal.
Aún no hay una solución estándar para el registro. A diferencia del monitoreo, donde hay una solución predominante conocida como Prometheus, no existe un estándar en el registro.
En esta conferencia vamos a ver dos herramientas: una popular y la otra que está ganando popularidad. Además de ellas, hay otras, pero no las abordaremos en este artículo.
Teniendo en cuenta todas las características mencionadas anteriormente, el registro en Kubernetes se puede representar ahora en el siguiente esquema:
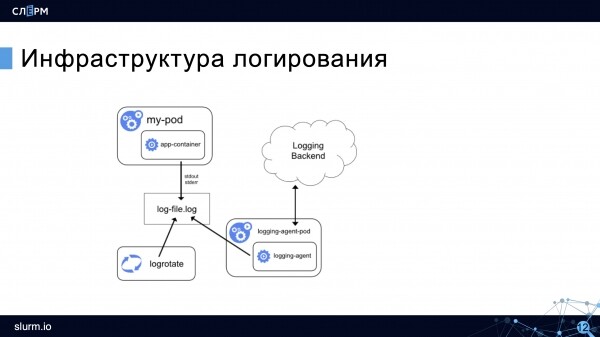
Queda el registro del contenedor, la rotación, pero aparece un agente recolector que recoge los registros y los envía para almacenamiento (en el esquema — en la Logging Backend). El agente funciona en cada nodo y, por lo general, está ejecutándose en Kubernetes.
Ahora, analicemos las herramientas para la gestión de registros.
Grafana Loki
ha aparecido recientemente, pero ya se ha vuelto bastante conocido. Sus ventajas: se instala fácilmente, consume pocos recursos, no requiere la instalación de Elasticsearch, ya que almacena datos en una base de datos TSDB (base de datos de series temporales). En el artículo anterior mencioné que Prometheus almacena datos en este tipo de base de datos, y esta es una de las numerosas similitudes entre ambos productos. Los desarrolladores incluso afirman que Loki es "Prometheus para el mundo del registro".
Una breve digresión sobre TSDB para quienes no leyeron : TSDB se maneja muy bien para almacenar grandes cantidades de datos y series temporales, pero no está diseñado para almacenamiento a largo plazo. Si por alguna razón necesitas conservar los registros por más de dos semanas, es mejor configurar su transferencia a otra base de datos.
Otra ventaja de Loki es que utiliza Grafana para la visualización de datos. Es muy conveniente: en Grafana podemos ver los datos de monitoreo y también, al conectar Loki, visualizar los registros. Se pueden crear gráficos a partir de los registros.
La arquitectura de Loki se ve aproximadamente así:
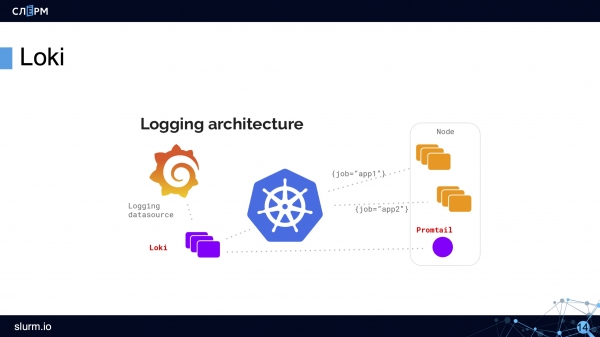
Con DaemonSet se despliega un agente en todos los servidores del clúster: Promtail o Fluent Bit. El agente recoge los registros. Loki los recoge y los almacena en su TSDB. A los registros se les añaden automáticamente metadatos, lo que es conveniente: se pueden filtrar por Pods, namespaces, nombres de contenedores e incluso por etiquetas.
Loki funciona en la interfaz familiar de Grafana. Loki incluso tiene su propio lenguaje de consultas, llamado LogQL, que por su nombre y sintaxis se asemeja a PromQL en Prometheus. En la interfaz de Loki hay sugerencias para las consultas, por lo que no es necesario memorizarlas.
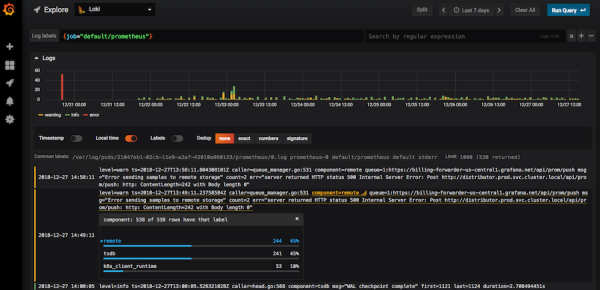
Loki en la interfaz de Grafana
Utilizando filtros, en Loki se pueden encontrar códigos (“400”, “404” y cualquier otro); ver registros de toda la nodo; filtrar todos los registros que contengan la palabra “error”. Si haces clic en un registro, se abrirá una tarjeta con toda la información sobre el evento.
Loki cuenta con suficientes herramientas que permiten extraer los registros necesarios, aunque, sinceramente, técnicamente podrían ser más. Actualmente, Loki se está desarrollando activamente y ganando popularidad.
Elastic + Fluent Bit + Kibana (EFK Stack)
El stack EFK es una herramienta de registro más clásica y, a su vez, no menos popular.
Al principio del artículo se mencionaba ELK (Elasticsearch + Logstash + Kibana), pero este stack ha quedado obsoleto debido a un Logstash que no es muy eficiente y que además consume muchos recursos. En su lugar, se comenzó a usar el más liviano y eficiente Fluentd, y después de un tiempo, se le unió — un agente recolector aún más liviano y más eficiente.
Si los desarrolladores son de fiar, Fluent Bit es más de 100 veces mejor en rendimiento que Fluentd: «donde Fluentd consume 20 MB de RAM, Fluent Bit consumirá 150 KB» — cita directa de la documentación. Con esto en mente, Fluent Bit ha comenzado a ser más utilizado.
Fluent Bit tiene menos capacidades que Fluentd, pero satisface las necesidades principales, por lo que principalmente utilizamos Fluent Bit.
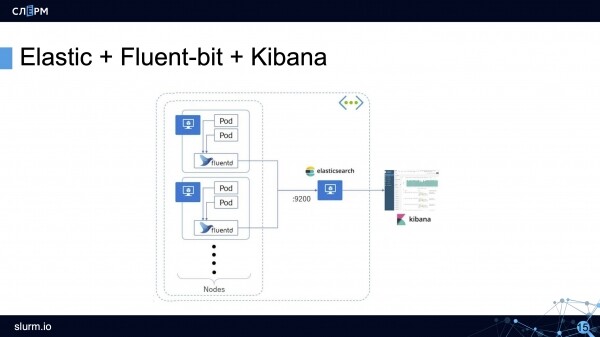
El esquema de trabajo del stack EFK: el agente recolecta logs de todos los pods (generalmente, es un DaemonSet que se ejecuta en todos los servidores del clúster) y los envía al almacenamiento (Elasticsearch, PostgreSQL o Kafka). Kibana se conecta al almacenamiento y extrae toda la información necesaria.
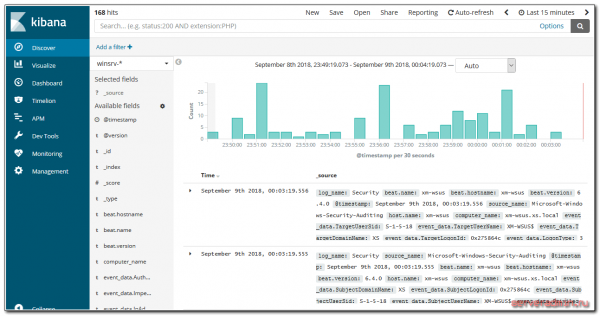
presenta la información en una interfaz web conveniente. Hay gráficos, filtros y mucho más.
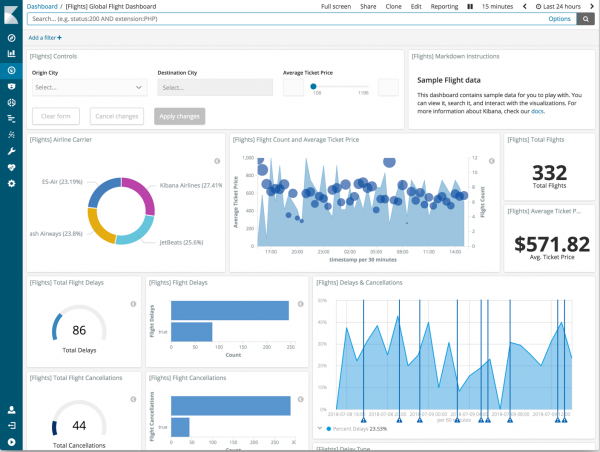
Con los logs se pueden crear completos dashboards.
Capacidades de Fluent Bit
Dado que generalmente se ha oído menos sobre Fluent Bit que sobre Logstash, lo examinaremos con más detalle. Fluent Bit se puede dividir lógicamente en 6 módulos, a algunos de los cuales se les pueden añadir plugins que amplían las capacidades de Fluent Bit.
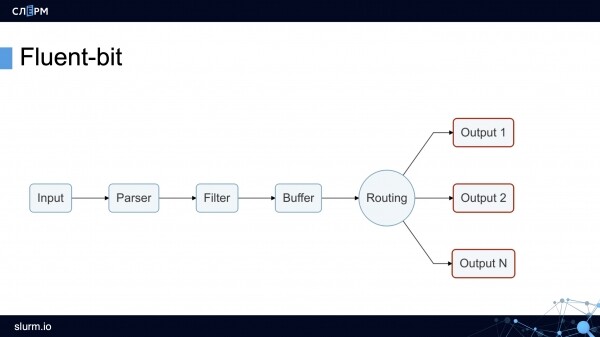
Módulo Input recolecta logs de archivos, servicios systemd e incluso de tcp-socket (solo hay que indicar el endpoint, y Fluent Bit empezará a acceder a él). Estas capacidades son suficientes para recolectar logs tanto del sistema como de contenedores.
En producción, usamos más a menudo los plugins (se puede dirigir a una carpeta con logs) y (se puede especificar de qué servicios recolectar logs).
Módulo Parser convierte los logs a un formato uniforme. Por defecto, los logs de Nginx son cadenas. Con un plugin, se puede transformar esta cadena en JSON: definir campos y sus valores. Trabajar con JSON es mucho más fácil que con logs en texto plano, ya que permite una mayor flexibilidad en la clasificación.
Módulo Filter. En este nivel, se filtran los logs innecesarios. Por ejemplo, solo se envían a almacenamiento los logs con el valor "warning" o con ciertas etiquetas. Los logs seleccionados se envían al búfer.
Módulo Buffer. Fluent Bit tiene dos tipos de búfer: búfer en memoria y búfer en disco. El búfer es un almacenamiento temporal para registros, necesario en caso de errores o fallos. A todos les gustaría ahorrar en RAM, por lo que generalmente se elige el búfer en disco. Pero hay que tener en cuenta que antes de ser enviados al disco, los registros se cargan en memoria.
Módulo Routing/Output contiene reglas y direcciones para enviar registros. Como se mencionó anteriormente, los registros se pueden enviar a Elasticsearch, PostgreSQL o, por ejemplo, Kafka.
Es interesante que desde Fluent Bit se pueden enviar registros a Fluentd. Dado que el primero es más ligero y menos funcional, se pueden recopilar registros y enviarlos a Fluentd, y allí, utilizando complementos adicionales, se pueden procesar y enviar a almacenes.
Si planeas usar Elasticsearch...
Por último, dos consejos para aquellos que planean usar Elasticsearch como almacenamiento de registros en producción.
- Configura alertas usando . Este programa extrae de la corriente general de registros los mensajes importantes y genera alertas por email u otro canal. Sin embargo, no hace mucho se conoció .
- Rotea los registros usando la aplicación o mediante la API de Elasticsearch. Elastic, en general, está haciendo pasos significativos ahora para gestionar el ciclo de vida de los índices sin herramientas externas. En general, no tiene sentido mantener registros durante mucho tiempo: probablemente no se necesitará un registro después de dos semanas; si es realmente crítico, definitivamente habrá sido procesado en ese tiempo. Como último recurso, los registros antiguos se pueden archivar y enviar a algún lugar para almacenamiento a largo plazo. He escuchado sobre registros especiales que deben ser almacenados por ley durante hasta 5 años. Personalmente, no me he encontrado con eso, pero no consideraría esa información equivalente a los registros normales, y posiblemente incluso los almacenaría por separado.
Continuará...
Autor: Marcel Ibraev, administrador certificado de Kubernetes, ingeniero en la empresa , orador y desarrollador de cursos .
Fuente: habr.com
