

¡Hola!
Me llamo Mijaíl, soy el director adjunto de TI en la empresa 'Sportmaster'. Quiero compartir una historia sobre cómo enfrentamos las dificultades surgidas durante la pandemia.
En los primeros días de las nuevas realidades, el formato de venta offline habitual de 'Sportmaster' se detuvo, y la carga en nuestro canal online, especialmente en la parte de entrega a domicilio, aumentó 10 veces. En unas pocas semanas transformamos un gigantesco negocio offline en online, adaptando el servicio a las necesidades de nuestros clientes.
En resumen, lo que esencialmente era nuestra operación secundaria se convirtió en el negocio principal. La importancia de cada pedido por internet aumentó de manera extrema. Teníamos que conservar cada rublo que el cliente traía a la empresa.
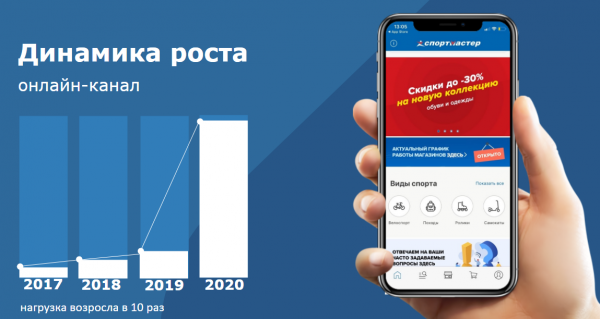
Para reaccionar rápidamente a las solicitudes de los clientes, abrimos un centro de contacto adicional en la oficina central de la empresa, y ahora podemos recibir alrededor de 285 000 llamadas a la semana. Al mismo tiempo, transformamos 270 tiendas en un nuevo formato de trabajo sin contacto y seguro, lo que permitió a los clientes recibir sus pedidos y a los empleados conservar sus puestos de trabajo.
Durante el proceso de transformación, nos encontramos con dos problemas principales. Primero, aumentó significativamente la carga en nuestros recursos online (cómo afrontamos esto, lo explicará Serguéi). Segundo, el flujo de operaciones raras (antes de COVID) se multiplicó, lo que, a su vez, requirió una gran cantidad de automatización rápida. Para resolver este problema, tuvimos que reasignar rápidamente recursos de las áreas que antes eran principales. Cómo nos las arreglamos con esto lo explicará Elena.
Explotación de servicios online
Serguéi Kolesnikov, responsable de la explotación de la tienda online y microservicios
Desde el momento en que nuestras tiendas minoristas comenzaron a cerrar para los visitantes, comenzamos a registrar un aumento en métricas como el número de usuarios, el número de pedidos realizados en nuestra aplicación, el número de solicitudes a las aplicaciones.
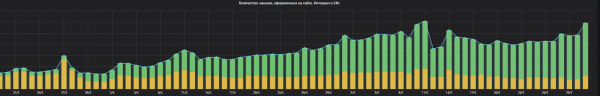 Número de pedidos del 18 al 31 de marzo
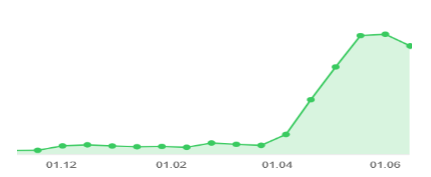 Número de solicitudes a microservicios de pago online
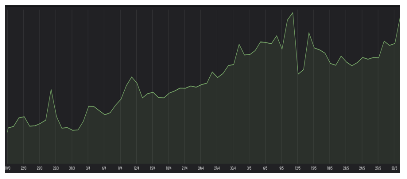 Número de pedidos realizados en el sitio web
En el primer gráfico vemos que el aumento fue de aproximadamente 14 veces, en el segundo — 4 veces. Consideramos que la métrica más representativa es el tiempo de respuesta de nuestras aplicaciones.
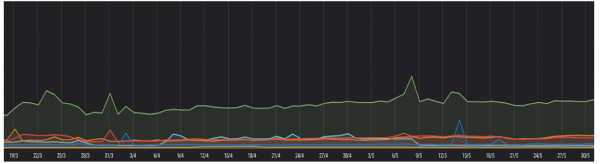
En este gráfico vemos la respuesta de los frontales y aplicaciones, y para nosotros hemos determinado que no hemos observado un crecimiento notable.
En primer lugar, esto se debe a que comenzamos los trabajos preparatorios a finales de 2019. Ahora nuestros servicios están reservados, garantizando la tolerancia a fallos a nivel de servidores físicos, sistemas de virtualización, contenedores y servicios en ellos. Al mismo tiempo, la capacidad de nuestros recursos de servidor permite soportar cargas múltiples.
La principal herramienta que nos ayudó en toda esta historia fue nuestro sistema de monitoreo. Sin embargo, hasta hace poco no teníamos un sistema unificado que permitiera recopilar métricas en todos los niveles, desde el hardware físico hasta métricas empresariales.
Formalmente, la monitorización existía en la empresa, pero generalmente estaba dispersa y bajo la responsabilidad de departamentos específicos. De hecho, cuando ocurría algún incidente, casi nunca teníamos una comprensión unificada de lo que había sucedido, no había información adecuada, y a menudo esto conducía a dar vueltas en busca de localizar el problema para su posterior solución.
En cierto momento pensamos y decidimos que ya era suficiente — necesitábamos un sistema unificado para ver el panorama completo. Las principales tecnologías que forman parte de nuestra pila son Zabbix como centro de alertas y almacenamiento de métricas, Prometheus para la recopilación y almacenamiento de métricas de aplicaciones, Stack ELK para la registración y almacenamiento de datos de todo el sistema de monitoreo, así como Grafana para la visualización, Swagger, Docker y otras herramientas útiles y familiares para ustedes.
Además, no solo utilizamos tecnologías disponibles en el mercado, sino que también desarrollamos algunas cosas por nuestra cuenta. Por ejemplo, creamos servicios para integrar sistemas entre sí, es decir, una API para la recopilación de métricas. También estamos trabajando en nuestros propios sistemas de monitoreo: a nivel de métricas empresariales, utilizamos pruebas de interfaz de usuario. Y también un bot en Telegram para notificar a los equipos.
Y también nos esforzamos por hacer que el sistema de monitoreo sea accesible para los equipos, para que puedan almacenar sus métricas de forma independiente y trabajar con ellas, incluida la configuración de alertas en métricas específicas que no tienen un uso muy amplio.
En toda la sistema, nos esforzamos por ser proactivos y localizando incidentes lo más rápido posible. Además, la cantidad de nuestros microservicios y sistemas ha crecido significativamente en los últimos tiempos, lo que ha incrementado el número de integraciones. En el marco de la optimización del proceso de diagnóstico de incidentes a nivel de integración, estamos desarrollando un sistema que permite realizar verificaciones entre sistemas y obtener resultados, lo que permite identificar los problemas principales relacionados con las importaciones y la interacción entre sistemas.
Por supuesto, todavía tenemos mucho por crecer y desarrollarnos en cuanto a la explotación de sistemas, y estamos trabajando activamente en ello. Puedes leer más sobre nuestro sistema de monitoreo. .
Pruebas técnicas
Sergio Orlov, dirige el centro de competencia en desarrollo web y móvil
Desde el inicio del cierre de tiendas físicas, nos hemos enfrentado a varios desafíos en términos de desarrollo. En primer lugar, el aumento de la carga como tal. Es evidente que si no se toman las medidas adecuadas, al someter al sistema a una alta carga, puede convertirse en una calabaza con un triste estallido, o degradar completamente su rendimiento, o incluso perder su operatividad por completo.
El segundo aspecto, un poco menos obvio, es que el sistema bajo alta carga necesitaba ser modificado muy rápidamente, adaptándose a los cambios en los procesos comerciales. A veces, varias veces al día. En muchas empresas hay una regla que dice que durante grandes actividades de marketing no se deben hacer cambios en el sistema. Absolutamente ninguno, que siga funcionando, ya que funciona.
Y para nosotros, en esencia, fue un Black Friday infinito, durante el cual aún necesitábamos cambiar el sistema. Cualquier error, problema o fallo en el sistema podría resultar muy costoso para el negocio.
Anticipándome, diré que logramos enfrentar estos desafíos, todos los sistemas soportaron la carga, se escalaron fácilmente y no tuvimos fallos técnicos globales.
Existen cuatro pilares sobre los cuales se sostiene la capacidad del sistema para soportar cargas altamente variables. El primero de ellos es la monitorización, de la que has leído un poco más arriba. Sin un sistema de monitorización bien estructurado, es prácticamente imposible identificar los cuellos de botella del sistema. Un buen sistema de monitorización es como ropa cómoda en casa, debe ser conveniente y adaptado a ti.
El segundo aspecto es la prueba. Tomamos este tema muy en serio: escribimos pruebas unitarias clásicas, pruebas de integración, pruebas de carga y muchas otras para cada sistema. También redactamos una estrategia de pruebas, y nos esforzamos por llevar el nivel de pruebas a un punto en el que las comprobaciones manuales ya no sean necesarias.
El tercer pilar es el CI/CD Pipeline. Los procesos de construcción, prueba y despliegue de la aplicación deben estar lo más automatizados posible, no debe haber intervención manual. El tema del CI/CD Pipeline es bastante profundo, y solo lo tocaré de manera superficial. Solo cabe mencionar que tenemos una lista de verificación del CI/CD Pipeline, por la cual cada equipo de producto pasa con la ayuda de los centros de competencia.
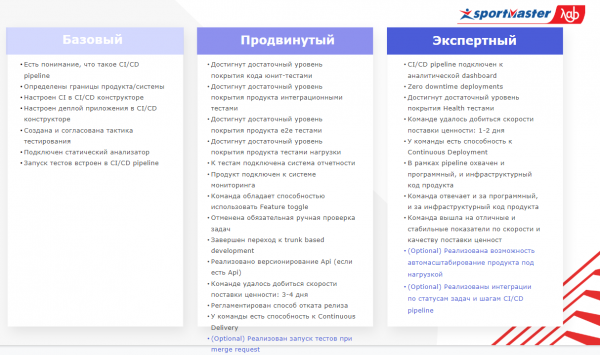 Aquí está la lista de verificación
De esta manera, se logran muchos objetivos. Esto incluye la versionado del API, y el feature toggle, para evitar un aluvión de lanzamientos, así como alcanzar un nivel de cobertura de pruebas que permita una automatización completa de las pruebas, despliegues sin costuras, entre otros.
El cuarto pilar son los principios arquitectónicos y las soluciones técnicas. Se puede hablar mucho y largo sobre arquitectura, pero quiero destacar un par de principios a los que me gustaría llamar la atención.
En primer lugar, hay que elegir herramientas especializadas para tareas concretas. Sí, suena obvio, y es evidente que es mejor clavar clavos con un martillo y desmontar relojes de pulsera con destornilladores especiales. Pero en nuestra época, muchas herramientas tienden a la universalización para abarcar el máximo segmento de usuarios: bases de datos, cachés, marcos y demás. Por ejemplo, si tomamos la base de datos MongoDB, funciona con transacciones mult-documentos, mientras que la base de datos Oracle opera con JSON. Y podría parecer que todo se puede usar para todo. Pero si abogamos por el rendimiento, debemos entender claramente las fortalezas y debilidades de cada herramienta y utilizar las que correspondan a nuestra clase de tareas.
En segundo lugar, al diseñar sistemas, cada aumento de complejidad debe estar justificado. Debemos tener esto en mente de forma constante; el principio de bajo acoplamiento es bien conocido. Creo que debe aplicarse tanto a nivel de servicio específico como a nivel del sistema completo y del paisaje arquitectónico. También es importante la capacidad de escalado horizontal de cada componente del sistema según la carga. Si se cuenta con esta capacidad, la escalabilidad no presentará ninguna dificultad.
En cuanto a las soluciones técnicas, hemos pedido a los equipos de producto que preparen un nuevo conjunto de recomendaciones, ideas y soluciones que hayan implementado en el proceso de preparación para la próxima ola de carga.
Cachés
Hay que ser consciente al elegir cachés locales y distribuidos. A veces, tiene sentido usar ambos en un mismo sistema. Por ejemplo, tenemos sistemas en los que parte de los datos es, en esencia, un caché de exhibición, lo que significa que la fuente de actualizaciones está fuera del propio sistema, y el sistema no cambia esos datos. Para este enfoque, usamos el Caffeine Cache local.
Pero hay datos que el sistema modifica activamente durante su funcionamiento, y aquí aplicamos un caché distribuido con Hazelcast. Este enfoque nos permite aprovechar las ventajas del caché distribuido donde realmente se necesitan y minimizar los costos de servicio por la circulación de datos en el clúster de Hazelcast donde podemos prescindir de ello. Hemos escrito mucho sobre cachés. y .
Además, el cambio del serializador a Kryo en Hazelcast nos proporcionó un aumento notable. Y la transición de ReplicatedMap a IMap + Near Cache en Hazelcast nos permitió minimizar el movimiento de datos a través del clúster.
Un pequeño consejo: al invalidar masivamente la caché, a veces es aplicable la táctica de precalentar una segunda caché y luego cambiar a ella. Aparentemente, con este enfoque deberíamos obtener un doble consumo de memoria, pero en la práctica, en aquellos sistemas donde se ha practicado esto, el consumo de memoria se ha reducido.
Pila reactiva
Utilizamos la pila reactiva en una cantidad considerable de sistemas. En nuestro caso, se trata de Webflux o Kotlin con corrutinas. La pila reactiva funciona especialmente bien donde esperamos operaciones de entrada-salida lentas. Por ejemplo, en llamadas a servicios lentos, operaciones con el sistema de archivos o sistemas de almacenamiento.
El principio más importante es evitar llamadas bloqueantes. Detrás de los marcos reactivos hay un número reducido de hilos de servicio activos. Si, por descuido, permitimos una llamada directa bloqueante, como hacer una llamada a un controlador JDBC, el sistema simplemente se detendrá.
Procuremos convertir errores en nuestras propias excepciones en tiempo de ejecución. El flujo de ejecución real del programa se desvía hacia los marcos reactivos, haciendo que la ejecución del código sea no lineal. Como consecuencia, es muy difícil diagnosticar problemas a partir de las trazas de pila. La solución aquí será crear excepciones en tiempo de ejecución claras y objetivas para cada error.
Elasticsearch
Al utilizar Elasticsearch, no seleccione datos no utilizados. Este es, en esencia, un consejo muy simple, pero a menudo esto se olvida. Si necesita seleccionar más de 10,000 registros a la vez, debe utilizar Scroll. En términos analógicos, es un poco como un cursor en una base de datos relacional.
No utilice postfilter innecesariamente. Con grandes volúmenes de datos en la selección principal, esta operación carga enormemente la base de datos.
Utilice operaciones bulk donde sea aplicable.
API
Al diseñar APIs, considere los requisitos para minimizar los datos transferidos. Esto es especialmente relevante en la conexión con el frontend: es en esta intersección donde salimos de los canales de nuestros centros de datos y comenzamos a operar en el canal que conecta con el cliente. Si hay algún problema, un tráfico demasiado alto provoca una experiencia de usuario negativa.
Y, por último, no arrojen toda la pila de datos, aborden claramente el contrato entre consumidores y proveedores.
Transformación organizativa
Yelena Yeroshkina, directora adjunta de TI
En el momento en que ocurrió la cuarentena y surgió la necesidad de aumentar rápidamente el desarrollo en línea e implementar servicios omnicanales, ya estábamos en el proceso de transformación organizativa.
Parte de nuestra estructura se trasladó a trabajar bajo los principios y prácticas del enfoque de producto. Se formaron equipos que ahora son responsables del funcionamiento y desarrollo de cada producto. Los empleados en estos equipos están completamente comprometidos y organizan su trabajo siguiendo Scrum o Kanban, según lo que les resulte más preferible, configurando el proceso de implementación, implementando prácticas técnicas, prácticas de aseguramiento de calidad y mucho más.
Por pura casualidad, la mayor parte de esos equipos de producto estaban en el área de servicios en línea y omnicanales. Esto nos permitió, en un corto período de tiempo (de verdad, en solo dos días), pasar a un modo de trabajo remoto sin pérdida de efectividad. El proceso configurado nos permitió adaptarnos rápidamente a las nuevas condiciones de trabajo y mantener un ritmo alto de entrega de nueva funcionalidad.
Además, surgió la necesidad de reforzar aquellos equipos que están en la primera línea del negocio en línea. En ese momento quedó claro que solo podíamos hacerlo con recursos internos. Aproximadamente 50 personas cambiaron su área de trabajo en dos semanas y se integraron en el trabajo sobre un nuevo producto para ellos.
Para esto no se requirieron esfuerzos gerenciales especiales, porque además de organizar nuestro propio proceso, enfocar el perfeccionamiento técnico del producto y practicar el aseguramiento de calidad, enseñamos a nuestros equipos la autoorganización: gestionar su propio proceso de producción sin necesidad de recursos administrativos.
El recurso de gestión se pudo enfocar precisamente donde era necesario en ese momento: en la coordinación con el negocio. ¿Qué es lo que realmente importa para nuestro cliente en este momento? ¿Qué funcionalidades deben implementarse primero? ¿Qué se debe hacer para aumentar nuestra capacidad de entrega y procesamiento de pedidos? Todo esto, junto con un modelo de roles claro, permitió durante este periodo dirigir nuestros flujos de producción de creación de valor hacia lo que realmente es importante y necesario.
Es obvio que, en un trabajo remoto y con un ritmo alto de cambios, donde la participación de cada uno afecta los indicadores de negocio, no se puede depender solo de sensaciones internas como: “¿Está todo yendo bien? Parece que sí.” Se necesitan métricas objetivas del proceso productivo. Estas métricas están disponibles para todos los que estén interesados en las métricas de los equipos de producto. Y primero para el propio equipo, el negocio, los intervinientes y la dirección.
Cada dos semanas se lleva a cabo una reunión de estado con cada equipo, donde durante 10 minutos se analizan las métricas, se identifican los cuellos de botella del proceso productivo y se elabora una solución conjunta: ¿qué se puede hacer para eliminar estos cuellos de botella? Aquí también se puede solicitar ayuda a la dirección en caso de que algún problema identificado esté fuera de la zona de influencia del equipo, o la experiencia de colegas que ya hayan enfrentado problemas similares.
Sin embargo, entendemos que para acelerar múltiples veces (que es el objetivo que nos proponemos), aún necesitamos aprender y aplicar muchas cosas en nuestro trabajo diario. En este momento, seguimos expandiendo el enfoque de producto a otros equipos y nuevos productos. Para esto, tuvimos que dominar un nuevo formato para nosotros: la escuela en línea de metodólogos.
Los metodólogos, personas que ayudan a los equipos a estructurar procesos, establecer comunicaciones y mejorar la eficiencia del trabajo, son en esencia agentes de cambio. En este momento, los graduados de nuestro primer ciclo están trabajando con equipos y ayudándoles a tener éxito.
Creo que la situación actual nos abre oportunidades y perspectivas que quizás aún no hemos llegado a comprender del todo. Pero la experiencia y la práctica que estamos adquiriendo en este momento confirman que hemos elegido el camino correcto para nuestro desarrollo. No dejaremos pasar estas nuevas oportunidades en el futuro y podremos responder de manera efectiva a los desafíos que se presenten ante «Sportmaster».
Conclusiones
Durante este tiempo difícil, hemos formulado los principales principios sobre los que se basa el desarrollo de software, que, creo, serán relevantes para cada empresa que se dedique a ello.
Personas. Esto es lo que realmente importa. Los empleados deben disfrutar de su trabajo, entender los objetivos de la empresa y los objetivos de los productos en los que están involucrados. Y, por supuesto, deben poder desarrollarse profesionalmente.
Tecnología. Es necesario que la empresa aborde de manera madura el trabajo con su stack tecnológico y desarrolle competencias en aquellas áreas donde realmente se necesita. Suena muy simple y obvio. Y a menudo se ignora.
Procesos. Es importante construir correctamente el trabajo de los equipos de producto y los centros de competencia, estableciendo una colaboración con el negocio para trabajar en conjunto como socios.
En general, así hemos sobrevivido. La tesis principal de la modernidad se ha confirmado una vez más, resonando con un fuerte golpe.
Incluso si eres un gran negocio offline con muchas tiendas y presencia en múltiples ciudades, desarrolla tu presencia online. No es solo un canal de venta adicional o una bonita aplicación a través de la cual también se puede comprar algo (y también porque los competidores tienen su propia aplicación atractiva). No es un repuesto por si acaso que te ayudará a sobrellevar la tormenta.
Es una necesidad absoluta. A la que deben estar preparados no solo tus capacidades técnicas e infraestructura, sino también las personas y los procesos. Porque es fácil comprar memoria, espacio o desplegar nuevas instancias en un par de horas. Pero las personas y los procesos deben prepararse para ello con antelación.
Fuente: habr.com
