

Hola a todos. Este artículo está escrito para aquellos que todavía están indecisos entre las plataformas de virtualización y después de leer el artículo de la serie «Instalé proxmox y todo está perfecto, 6 años de uptime sin interrupciones». Pero después de instalar alguna solución en caja, surge la pregunta de cómo ajustar esto y aquello para que la monitorización sea más clara, y aquí para controlar las copias de seguridad... Luego llega el momento en que te das cuenta de que deseas algo más funcional o que quieres que dentro de tu sistema todo esté claro, y no ese cajón negro, o que quieres usar algo más que un hipervisor y un montón de máquinas virtuales. En este artículo habrá un poco de reflexión y práctica basada en la plataforma OpenNebula, que elegí porque no es exigente con los recursos y su arquitectura no es tan complicada.
Así que, como podemos ver, muchos proveedores de nube operan sobre KVM y crean un entorno externo para gestionar las máquinas. Es evidente que los grandes hosters desarrollan sus propios entornos para la infraestructura en la nube, como YANDEX, por ejemplo. Algunos utilizan OpenStack y construyen desde ahí, como SELECTEL, MAIL.RU. Pero si tienes tu propio hardware y un pequeño equipo de especialistas, generalmente se elige algo listo: VMWARE, HYPER-V, hay licencias gratuitas y de pago, pero eso no es de lo que hablaremos ahora. Hablaremos de los entusiastas, que son aquellos que no temen proponer y probar cosas nuevas, a pesar de que en la empresa claramente han dejado en claro: «¿Quién se encargará de esto después de ti?», «¿Vamos a sacar esto a producción? Da miedo.» Pero se pueden utilizar estas soluciones inicialmente en un entorno de prueba y si a todos les gusta, entonces se puede plantear el tema de un desarrollo y uso más serio.
También aquí está el enlace a la charla de un participante activo en el desarrollo de esta plataforma.
Es posible que en este artículo haya algo innecesario y ya claro para un experto, y en algunos casos no describiré todo porque hay comandos y descripciones similares en la red. Aquí solo comparto mi experiencia trabajando con esta plataforma. Espero que los participantes activos complementen en los comentarios qué se puede mejorar y qué errores cometí. Todas las acciones se llevaron a cabo en un entorno doméstico compuesto por 3 PCs con diferentes características. Además, no voy a detallar cómo funciona este software ni cómo instalarlo. No, solo mi experiencia en administración y los problemas que enfrenté. Tal vez a alguien le sirva para tomar decisiones.
Así que, comencemos. Como administrador de sistemas, los siguientes puntos son importantes para mí, sin los cuales dudo que utilice esta solución.
1. Repetibilidad de la instalación
Hay un montón de instrucciones para instalar OpenNebula, por lo que no debería haber problemas. De versión en versión aparecen nuevas características que no siempre funcionarán al cambiar de versión.
2. Monitoreo
Vamos a monitorear la propia nodo, KVM y OpenNebula. Afortunadamente, ya hay soluciones listas. Sobre el monitoreo de hosts Linux hay muchas opciones, como Zabbix o Node Exporter — depende de lo que prefiera cada uno — por el momento defino que el monitoreo de métricas del sistema (temperatura donde se puede medir, consistencia del arreglo de discos) se realiza a través de Zabbix, y lo que respecta a aplicaciones a través de un exportador en Prometheus. Para el monitoreo de KVM, por ejemplo, se puede utilizar el proyecto y configurarlo para que se ejecute a través de systemd, funciona muy bien y muestra métricas de KVM, además hay un dashboard listo .
Por ejemplo, aquí está mi archivo:
/etc/systemd/system/libvirtd_exporter.service
[Unit]
Description=Node Exporter

[Service]
User=node_exporter
ExecStart=/usr/sbin/prometheus-libvirt-exporter --web.listen-address=":9101"

[Install]
WantedBy=multi-user.target
Así que tenemos 1 exportador, necesitamos un segundo para monitorear OpenNebula, utilicé uno
Se puede agregar a un común para el monitoreo del sistema lo siguiente.
En el archivo de Node Exporter cambiamos el inicio de la siguiente manera:
ExecStart=/usr/sbin/node_exporter --web.listen-address=":9102" --collector.textfile.directory=/var/lib/opennebula_exporter/textfile_collectorCreamos el directorio mkdir -p /var/lib/opennebula_exporter
El script bash presentado anteriormente primero lo comprobamos en la consola, si muestra lo que se necesita (si da error, instalamos xmlstarlet), lo copiamos en /usr/local/bin/opennebula_exporter.sh
Agregamos a cron una tarea para cada minuto:
*/*1 * * * * (/usr/local/bin/opennebula_exporter.sh > /var/lib/opennebula_exporter/textfile_collector/opennebula.prom)Las métricas han comenzado a aparecer, se pueden recoger con Prometheus y construir gráficos y hacer alertas. En Grafana, por ejemplo, se puede dibujar un panel sencillo como este.
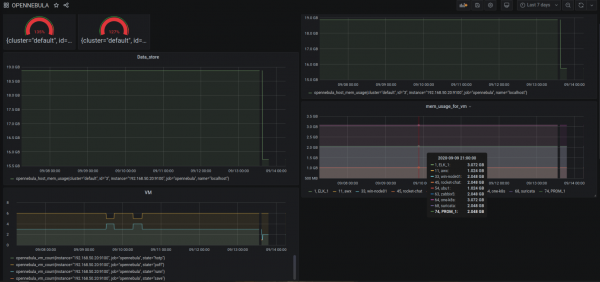
(se ve que aquí hice overcommit de CPU y RAM)
Para aquellos que aman y utilizan Zabbix, hay
Sobre la monitorización, eso es todo, lo principal es que existe. Por supuesto, se puede complementar utilizando las herramientas de monitorización integradas de máquinas virtuales y exportar datos a facturación, aquí cada uno tiene su propia visión, aún no he empezado a abordar esto de manera más concreta.
En cuanto al registro, aún no he comenzado especialmente. Como opción más simple, es agregar td-agent para analizar el directorio /var/lib/one con expresiones regulares. Por ejemplo, el archivo sunstone.log se ajusta a la expresión regular de nginx y otros archivos que muestran el historial de interacciones con la plataforma - ¿cuál es la ventaja de esto? Bueno, por ejemplo, podemos rastrear claramente la cantidad de "Error, error" y detectar más rápidamente dónde y en qué nivel hay un fallo.
3. Copias de seguridad
También hay proyectos de pago mejorados, por ejemplo, sep :OpenNebula_Backup. Aquí debemos entender que simplemente hacer una copia de la imagen de la máquina, en este caso, no es suficiente, ya que nuestras máquinas virtuales deben funcionar con una integración completa (el mismo archivo de contexto, en el que se describen la configuración de red, nombre de vm y configuraciones personalizadas para sus aplicaciones). Por lo tanto, determinamos qué y cómo haremos las copias de seguridad. En algunos casos, es mejor hacer copias de lo que está dentro de la vm. Y tal vez solo debamos hacer una copia de un disco de esta máquina.
Por ejemplo, hemos decidido que todas las máquinas se inician con imágenes persistentes, por lo que leyendo
significa que primero podemos exportar la imagen de nuestra vm:
onevm disk-saveas 74 3 prom.qcow2
ID de imagen: 77

Vemos con qué nombre se ha guardado

oneimage show 77
/var/lib/one//datastores/100/f9503161fe180658125a9b32433bf6e8

Y luego copiamos a donde necesitamos. Por supuesto, es un método nada práctico. Solo quería mostrar que utilizando las herramientas de OpenNebula se pueden construir soluciones como esta.
También encontré en la red y hay también , pero aquí solo para almacenamiento qcow2.
Pero como todos sabemos, tarde o temprano llega el momento en que se desean copias de seguridad incrementales. Aquí es más complicado y es posible que la dirección asigne fondos para una solución de pago, o se puede optar por otro camino, entendiendo que aquí solo utilizamos recursos, y que la reserva se realiza a nivel de aplicaciones añadiendo más nodos y máquinas virtuales. Aquí, insisto en que se use la nube solo para ejecutar clústeres de aplicaciones, y que las bases de datos se ejecuten en otra plataforma o se tomen soluciones listas del proveedor, si hay tal posibilidad.
4. Facilidad de uso
En este punto describiré los problemas con los que me he encontrado. Por ejemplo, en cuanto a las imágenes, como sabemos, hay persistentes: al montar esta imagen a la VM, todos los datos se escriben en esta imagen. Y si es no persistente, la imagen se copia en el almacenamiento y los datos se escriben en lo que se copió de la imagen base. Así es como funcionan las plantillas. Me he creado problemas por no indicar persistente y 200 GB de imagen se copiaban. El problema es que seguramente no se puede cancelar este procedimiento; hay que ir al nodo y terminar el proceso actual de "cp".
Uno de los importantes inconvenientes es que no se puede cancelar las acciones simplemente utilizando la GUI. Más bien, las cancelas y ves que no pasa nada, y vuelves a iniciarlas, cancelas y, de hecho, ya habrá dos procesos de cp que están copiando la imagen.
Y aquí empieza a entenderse por qué OpenNebula numera cada nueva instancia con un nuevo ID. Por ejemplo, en Proxmox, si creas una VM con ID 101, la eliminas y luego la vuelves a crear, tendrá ID 101 nuevamente. En OpenNebula no será así; cada nueva instancia se creará con un nuevo ID y hay una lógica detrás de esto: por ejemplo, la limpieza de datos antiguos o de instalaciones fallidas.
Lo mismo ocurre con el almacenamiento; esta plataforma está más dirigida a un almacenamiento centralizado. Hay complementos para usar el almacenamiento local, pero en este caso no es de eso de lo que se trata. Creo que en el futuro alguien escribirá un artículo sobre cómo utilizar el almacenamiento local en los nodos y emplearlo con éxito en producción.
5. Máxima simplicidad
Por supuesto, cuanto más avanzas, menos personas entenderán lo que dices.
En las condiciones de mi entorno: 3 nodos con almacenamiento nfs, todo funciona correctamente. Pero al realizar experimentos de corte de energía, por ejemplo, al iniciar un snapshot y desconectar la energía de los nodos, mantenemos la configuración en la base de datos acerca de que hay un snapshot, pero de hecho no lo hay (todos entendemos que originalmente se registró en la base de datos sql este evento, pero la operación no se completó con éxito). Lo bueno es que al crear un snapshot se genera un archivo separado y hay un "padre"; por tanto, en caso de problemas, incluso si no funciona a través de la interfaz gráfica, podemos recuperar el archivo qcow2 y restaurarlo por separado.
Sobre las redes, desafortunadamente no es tan simple. Al menos es más fácil que en openstack; solo utilicé vlan (802.1Q): funciona bastante bien, pero si realiza cambios en la configuración de la red desde la plantilla, esos ajustes no se aplicarán a las máquinas ya en funcionamiento, es decir, hay que eliminar y agregar la tarjeta de red para que se apliquen los nuevos ajustes.
Si se quiere comparar con openstack, se puede decir que en opennebula no hay una definición clara de qué tecnologías usar para el almacenamiento de datos, la gestión de redes y recursos; cada administrador decide cómo le resulta más conveniente.
6. Complementos adicionales e instalaciones
Como entendemos, la plataforma en la nube puede gestionar no solo kvm, sino también vmware esxi. Lamentablemente, no tenía un pool con Vcenter; si alguien lo ha probado, por favor escríbame.
En el soporte de otros proveedores de nube se ha declarado
AWS, AZURE.
También intenté integrar Vmware Cloud de Selectel, pero no tuvo éxito; en general, desistí porque había muchos factores en juego, y no tiene sentido escribir al soporte técnico del proveedor de hosting.
Además, ahora en la nueva versión está firecracker: esto inicia microvm, tipo de envoltura de kvm sobre docker, lo que proporciona aún más versatilidad, seguridad y aumento del rendimiento, ya que no es necesario gastar recursos en la emulación del hardware. Solo veo ventajas en comparación con docker en que no ocupa un número adicional de procesos y no se utilizan sockets con esta emulación; por lo tanto, se puede usar perfectamente como balanceador de carga (pero probablemente esto valga la pena mencionarlo en un artículo separado, ya que aún no he realizado todas las pruebas completamente).
7. Experiencia positiva de uso y depuración de errores
Quería compartir mis observaciones sobre el funcionamiento, parte las he descrito arriba, y quiero escribir más. Realmente, probablemente no soy el único que al principio piensa que este no es el sistema y que aquí todo es un parche — ¿cómo se trabaja con esto en general? Pero luego llega la comprensión y todo resulta bastante lógico. Claro que no se puede complacer a todos y algunos aspectos requieren mejoras.
Por ejemplo, una operación simple de copiar una imagen de disco de un datastore a otro. En mi caso hay 2 nodos con nfs, envía la imagen — la copia se realiza a través del frontend de OpenNebula, aunque todos estamos acostumbrados a que los datos se copien directamente entre hosts — en VMware y Hyper-V estamos acostumbrados a esto, pero aquí es diferente. Aquí hay un enfoque y una ideología diferentes, y en la versión 5.12 eliminaron el botón "migrar a datastore" — solo se traslada la máquina, pero no el almacenamiento, ya que se implica un almacenamiento centralizado.
Luego, un error común con diferentes causas "Error al desplegar la máquina virtual: No se pudo crear el dominio desde /var/lib/one//datastores/103/10/deployment.5" A continuación habrá una lista de cosas que se deben revisar.
- Permisos sobre la imagen para el usuario oneadmin;
- Permisos para el usuario oneadmin para iniciar libvirtd;
- ¿Está montado correctamente el datastore? Ve y verifica la ruta en el mismo nodo, posiblemente algo se haya desconectado;
- Red mal configurada, mejor dicho, en el frontend en las configuraciones de red, está configurado que el interfaz principal para vlan es br0, mientras que en el nodo está escrito — bridge0 — debe ser igual.
El datastore del sistema almacena metadatos para tu vm, si inicias vm con una imagen persistente, la vm necesita tener acceso a la configuración originalmente creada en el almacenamiento donde creaste la vm — esto es muy importante. Por lo tanto, al trasladar vm a otro datastore, debes verificar todo nuevamente.
8. Documentación, comunidad. Desarrollo futuro
Y lo demás, buena documentación, comunidad y lo más importante, que el proyecto continúe vivo en el futuro.
Aquí, en general, todo está bastante bien documentado y incluso a partir de la fuente oficial no será difícil instalar y encontrar respuestas a las preguntas.
Comunidad activa. Publica muchas soluciones listas que puedes usar en tus instalaciones.
Actualmente, con la 5.12 han cambiado algunas políticas en la empresa Será interesante saber cómo se desarrollará el proyecto. Al principio, mencioné específicamente algunos proveedores que usan sus propias soluciones y lo que ofrece la industria. No hay una respuesta clara sobre lo que debes usar, por supuesto. Pero para las organizaciones pequeñas, mantener su propio pequeño cloud privado puede no ser tan caro como parece. Lo más importante es saber exactamente que lo necesitas.
Como conclusión, independientemente de lo que elijas como sistema en la nube, no debes quedarte con un solo producto. Si tienes tiempo, vale la pena considerar otras soluciones más abiertas.
Hay un buen chat. ayudan activamente y no te envían a buscar la solución del problema en Google. Únete.
Fuente: habr.com
