

Nota de traducción.: adaptar Kubernetes en GitLab se considera uno de los dos principales factores que contribuyen al crecimiento de la empresa. Sin embargo, hasta hace poco, la infraestructura del servicio en línea GitLab.com se basaba en máquinas virtuales, y solo hace aproximadamente un año comenzó su migración a K8s, la cual aún no se ha completado. Nos complace presentar la traducción de un reciente artículo de un ingeniero SRE de GitLab sobre cómo está sucediendo esto y qué conclusiones están sacando los ingenieros involucrados en el proyecto.
Desde hace aproximadamente un año, nuestro departamento de infraestructura se ha estado ocupando de la migración de todos los servicios que operan en GitLab.com a Kubernetes. Durante este tiempo nos hemos enfrentado a problemas no solo relacionados con la transferencia de servicios a Kubernetes, sino también con la gestión del despliegue híbrido durante la transición. Sobre las valiosas lecciones que hemos aprendido trata este artículo.
Desde el principio, GitLab.com ha tenido sus servidores en la nube en máquinas virtuales. Estas máquinas virtuales son gestionadas por Chef, y su instalación se lleva a cabo mediante nuestro . en caso de que sea necesario actualizar la aplicación consiste en actualizar de manera coordinada y secuencial el parque de servidores utilizando un pipeline de CI. Este método, aunque lento y un poco garantiza que GitLab.com utilice los mismos métodos de instalación y configuración que los usuarios de instalaciones (autogestionadas) de GitLab, que aplican nuestros paquetes de Linux para ello.
Utilizamos este método porque es crucial experimentar todas las penas y alegrías que enfrentan los miembros de la comunidad al instalar y configurar sus propias copias de GitLab. Este enfoque funcionó bien durante un tiempo, pero cuando el número de proyectos en GitLab superó los 10 millones, nos dimos cuenta de que ya no satisfacía nuestras necesidades de escalamiento y despliegue.
Los primeros pasos hacia Kubernetes y GitLab nativo en la nube
En 2017 se creó el proyecto para preparar GitLab para su implementación en la nube, así como para permitir que los usuarios instalen GitLab en clústeres de Kubernetes. En ese momento, sabíamos que trasladar GitLab a Kubernetes ampliaría las capacidades de escalabilidad de la plataforma SaaS, facilitaría las implementaciones y optimizaría el uso de recursos informáticos. Al mismo tiempo, muchas funciones de nuestra aplicación dependían de los volúmenes NFS montados, lo que ralentizaba la transición desde máquinas virtuales.
La búsqueda de soluciones nativas de la nube y Kubernetes permitió a nuestros ingenieros planificar una transición gradual en la que renunciamos a algunas dependencias de la aplicación de los almacenamientos de red, mientras continuábamos desarrollando nuevas funciones. Desde que comenzamos a planear la migración en verano de 2019, muchas de estas limitaciones han sido superadas, ¡y el proceso de transferencia de GitLab.com a Kubernetes está ahora en pleno desarrollo!
Características de GitLab.com en Kubernetes
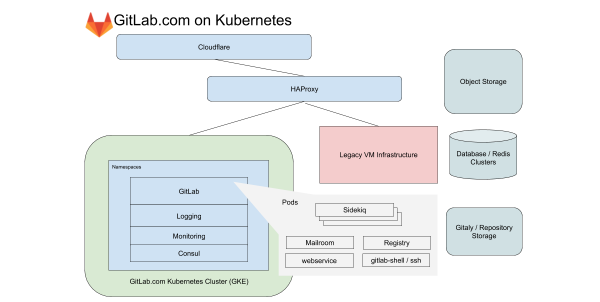
Para GitLab.com utilizamos un único clúster regional de GKE que maneja todo el tráfico de la aplicación. Para minimizar la complejidad (ya de por sí difícil) de la migración, nos enfocamos en los servicios que no dependen del almacenamiento local o NFS. GitLab.com utiliza predominantemente una base de código monolítica en Rails, y dirigimos el tráfico en función de las características de carga de trabajo a diferentes endpoints, aislados en sus propios grupos de nodos.
En el caso del frontend, estos tipos se dividen en solicitudes a web, API, Git SSH/HTTPS y Registry. En el caso del backend, separamos los trabajos en cola según diversas características en función de , que nos permiten establecer objetivos de niveles de servicio (Service-Level Objectives, SLOs) para diferentes cargas.
Todos estos servicios de GitLab.com están configurados utilizando el chart de Helm de GitLab sin modificaciones. La configuración se realiza en subcharts, que pueden ser habilitados selectivamente a medida que trasladamos gradualmente los servicios al clúster. A pesar de que se decidió no incluir en la migración algunos de nuestros servicios con estado, como Redis, Postgres, GitLab Pages y Gitaly, el uso de Kubernetes permite reducir radicalmente el número de VM que actualmente gestiona Chef.
Transparencia y gestión de la configuración de Kubernetes
Todas las configuraciones son gestionadas por GitLab. Para ello se utilizan tres proyectos de configuración basados en Terraform y Helm. Siempre que es posible, tratamos de utilizar GitLab para ejecutar GitLab, pero para tareas operativas tenemos una instalación separada de GitLab. Esta es necesaria para no depender de la disponibilidad de GitLab.com al realizar despliegues y actualizaciones en GitLab.com.
Aunque nuestros pipelines para el clúster de Kubernetes funcionan en una instalación separada de GitLab, los repositorios de código tienen espejos, accesibles públicamente en las siguientes direcciones:
- — la envoltura de configuración de GitLab.com para el chart de Helm de GitLab;
- — contiene configuraciones para servicios que no están directamente relacionados con la aplicación GitLab. Entre ellos se incluyen configuraciones para la captura de logs y la monitorización del clúster, así como para herramientas integradas como PlantUML;
- — configuración de Terraform para Kubernetes y la infraestructura de VM antigua (legacy). Aquí se configuran todos los recursos necesarios para iniciar el clúster, incluyendo el propio clúster, grupos de nodos, cuentas de servicio y reservas de direcciones IP.

Al realizar cambios, se muestra un con un enlace a un diff detallado, que el SRE analiza antes de aplicar cambios en el clúster.
Para el SRE, el enlace conduce a un diff detallado en la instalación de GitLab utilizada para operaciones, cuyo acceso está restringido. Esto permite a los empleados y a la comunidad sin acceso al proyecto en producción (que es solo para SRE) revisar los cambios propuestos en la configuración. Al combinar una instancia pública de GitLab para el código con una instancia privada para los pipelines de CI, mantenemos un flujo de trabajo unificado, garantizando a la vez independencia de gitlab.com durante las actualizaciones de configuración.
Lo que hemos aprendido durante la migración
Durante el proceso de traslado se ha acumulado experiencia que aplicamos a nuevas migraciones y despliegues en Kubernetes.
1. Aumento de costos debido al tráfico entre zonas de disponibilidad
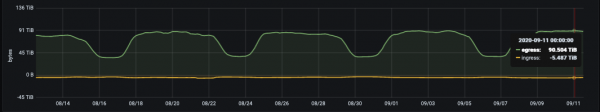
Estadísticas diarias de egress (bytes por día) para el conjunto de repositorios Git en GitLab.com
Google divide su red en regiones. Estas, a su vez, se dividen en zonas de disponibilidad (AZ). El alojamiento de Git está asociado con grandes volúmenes de datos, por lo que es importante controlar el egreso de red. En el caso del tráfico interno, el egreso es gratuito solo si permanece dentro de una misma zona de disponibilidad. En el momento de escribir este artículo, estamos transfiriendo aproximadamente 100 TB de datos en un día laboral normal (y eso es solo para repositorios de Git). Los servicios que en nuestra antigua topología basada en VM estaban en las mismas máquinas virtuales ahora funcionan en diferentes pods de Kubernetes. Esto significa que parte del tráfico que antes era local para la VM puede potencialmente salir fuera de las zonas de disponibilidad.
Los clústeres regionales de GKE permiten abarcar varias zonas de disponibilidad para la redundancia. Estamos considerando la posibilidad de para los servicios que generan grandes volúmenes de tráfico. Esto permitirá reducir los costos de egreso mientras se mantiene la redundancia a nivel de clúster.
2. Limites, solicitudes de recursos y escalado
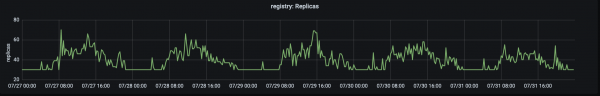
El número de réplicas que manejan el tráfico de producción en registry.gitlab.com. El tráfico alcanza su punto máximo alrededor de las 15:00 UTC.
Nuestra historia con la migración comenzó en agosto de 2019, cuando trasladamos el primer servicio: el registro de contenedores de GitLab (GitLab Container Registry) a Kubernetes. Este servicio crítico con alto tráfico fue ideal para la primera migración, ya que es una aplicación sin estado con pocas dependencias externas. El primer problema que enfrentamos fue el gran número de pods desalojados debido a la falta de memoria en los nodos. Debido a esto, tuvimos que ajustar las solicitudes y los límites.
Se descubrió que en el caso de aplicaciones cuyo consumo de memoria aumenta con el tiempo, bajos valores para las solicitudes (que reservan memoria para cada pod) junto con un límite 'generoso' de uso causaban (saturación) en los nodos y un alto nivel de desalojos. Para enfrentar este problema, se . Esto alivió la presión sobre los nodos y proporcionó un ciclo de vida para los pods que no imponía una carga excesiva en el nodo. Ahora comenzamos las migraciones con solicitudes generosas (y casi idénticas) y límites, ajustándolos según sea necesario.
3. Métricas y registros
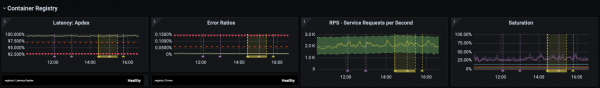
El departamento de infraestructura se centra en las latencias, la tasa de errores y la saturación con los objetivos establecidos (SLO), ligados a .
Durante el último año, uno de los eventos clave en el departamento de infraestructura ha sido la mejora en el monitoreo y la gestión de SLO. Los SLO nos permitieron establecer objetivos para servicios individuales, los cuales seguimos de cerca durante la migración. Pero incluso con esta mejor visibilidad, no siempre se pueden identificar inmediatamente problemas utilizando métricas y alertas. Por ejemplo, al centrarnos en las latencias y la tasa de errores, no abarcamos completamente todos los escenarios de uso del servicio que está en migración.
Este problema se detectó casi de inmediato después de trasladar parte de las cargas de trabajo al clúster. Se hizo especialmente evidente al verificar funciones que tienen un número bajo de solicitudes, pero que tienen dependencias de configuración muy específicas. Una de las lecciones clave aprendidas tras la migración fue la necesidad de considerar en el monitoreo no solo las métricas, sino también los registros y el 'cola larga' (refiriéndose a en el gráfico — nota del traductor) de errores. Ahora, para cada migración, incluimos una lista detallada de consultas a los registros (log queries) y planeamos procedimientos claros de reversión, que en caso de problemas se pueden transferir de un turno a otro.
La atención paralela a las mismas solicitudes en la antigua infraestructura de VM y en la nueva, basada en Kubernetes, presentó un desafío único. A diferencia de la migración de tipo lift-and-shift (traslado rápido de aplicaciones 'tal como están' a la nueva infraestructura; se puede leer más al respecto, por ejemplo, — nota del traductor), el funcionamiento paralelo de las "antiguas" VM y Kubernetes requiere que las herramientas de monitoreo sean compatibles con ambos entornos y sean capaces de combinar métricas en una única vista. Es importante que utilicemos los mismos dashboards y consultas a los registros para lograr una observabilidad coherente durante el período de transición.
4. Redirigir el tráfico al nuevo clúster
Para GitLab.com, parte de los servidores se asigna a . El parque canario atiende nuestros proyectos internos, y también puede . Pero, en primer lugar, está destinado a verificar los cambios realizados en la infraestructura y la aplicación. El primer servicio migrado comenzó recibiendo un volumen limitado de tráfico interno, y seguimos utilizando este método para asegurarnos de que se cumplan los SLO antes de dirigir todo el tráfico al clúster.
En el caso de la migración, esto significa que, primero, se dirigen las solicitudes a proyectos internos en Kubernetes, y luego, gradualmente, redirigimos el resto del tráfico al clúster cambiando el peso para el backend a través de HAProxy. Durante el proceso de transición de VM a Kubernetes, quedó claro que es muy beneficioso tener una forma simple de redirigir el tráfico entre la antigua y nueva infraestructura y, por lo tanto, mantener la antigua infraestructura lista para un retroceso en los primeros días después de la migración.
5. Capacidad de reserva de los pods y su uso
Pronto se identificó el siguiente problema: los pods para el servicio Registry se iniciaron rápidamente, sin embargo, el inicio de los pods para Sidekiq tardaba hasta . El prolongado inicio de los pods para Sidekiq se convirtió en un problema cuando comenzamos la migración a Kubernetes de las cargas de trabajo para los workers, que deben procesar trabajos rápidamente y escalar rápidamente.
En este caso, la lección fue que, aunque el Horizontal Pod Autoscaler (HPA) en Kubernetes maneja bien el aumento del tráfico, es importante considerar las características de las cargas de trabajo y asignar capacidad de reserva a los pods (especialmente en condiciones de demanda desigual). En nuestro caso, hubo un súbito aumento de trabajos, lo que llevó a una rápida escalación, saturando los recursos de CPU antes de que pudiéramos escalar el grupo de nodos.
Siempre hay una tentación de "exprimir" al máximo el clúster, sin embargo, nosotros, al enfrentarnos inicialmente a problemas de rendimiento, comenzamos con un generoso presupuesto de pod y lo reducimos posteriormente, monitoreando de cerca los SLO. El lanzamiento de pods para el servicio Sidekiq se ha acelerado significativamente y ahora, en promedio, toma alrededor de 40 segundos. se han beneficiado tanto GitLab.com como nuestros usuarios de instalaciones autogestionadas que utilizan el chart oficial de Helm de GitLab.
Conclusión
Después de migrar cada servicio, disfrutamos de las ventajas de usar Kubernetes en producción: despliegues de aplicaciones más rápidos y seguros, escalabilidad y una distribución de recursos más eficiente. Además, las ventajas de la migración van más allá del servicio GitLab.com. Cada mejora del chart oficial de Helm también beneficia a sus usuarios.
Espero que hayas disfrutado la historia sobre nuestras aventuras con la migración a Kubernetes. Seguimos trasladando nuevos servicios al clúster. Puedes obtener más información de las siguientes publicaciones:
- «»;
- «»;
- .
P.D. del traductor
También puedes leer en nuestro blog:
- «»;
- «»;
- «»;
- «».
Fuente: habr.com
