

Como es bien sabido, la compañía SAP ofrece un abanico completo de software tanto para la gestión de datos transaccionales como para el procesamiento de estos datos en sistemas de análisis e informes. En particular, la plataforma SAP Business Warehouse (SAP BW) se presenta como una herramienta para el almacenamiento y análisis de datos, dotada de amplias capacidades técnicas. A pesar de sus indudables ventajas, el sistema SAP BW tiene un inconveniente significativo: el alto costo del almacenamiento y procesamiento de datos, especialmente perceptible al utilizar SAP BW on Hana en la nube.
¿Y si comenzamos a utilizar algún producto de almacenamiento que no sea SAP y preferiblemente OpenSource? En X5 Retail Group hemos optado por GreenPlum. Esto, ciertamente, resuelve el problema de costos, pero surgen inmediatamente preguntas que se resolvían casi automáticamente al usar SAP BW.
En particular, ¿cómo extraer datos de los sistemas de origen, la mayoría de los cuales son soluciones SAP?
Las 'métricas de RRHH' fue el primer proyecto donde se necesitaba resolver este problema. Nuestro objetivo era crear un almacenamiento de datos de RRHH y desarrollar informes analíticos sobre la gestión del personal. En este caso, la principal fuente de datos es el sistema transaccional SAP HCM, donde se llevan a cabo todas las actividades relacionadas con el personal, organizativas y de nómina.
Extracción de datos
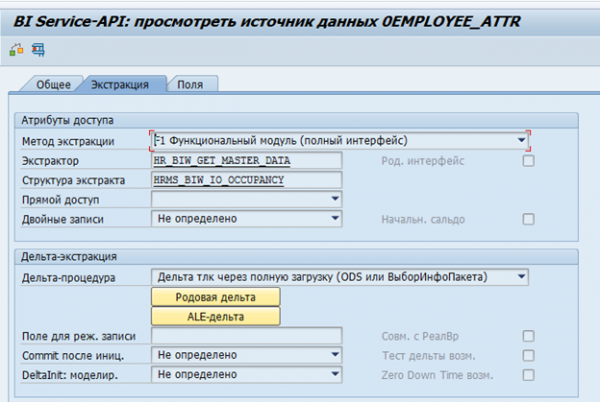
En SAP BW existen extractores de datos estándar para sistemas SAP. Estos extractores pueden recopilar automáticamente los datos necesarios, monitorear su integridad y determinar los cambios. Por ejemplo, la fuente de datos estándar sobre los atributos del empleado 0EMPLOYEE_ATTR:
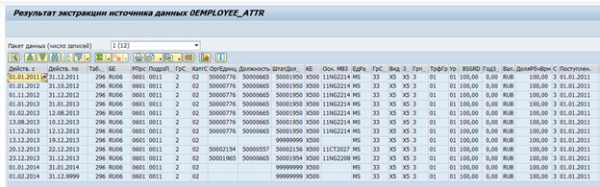
Resultado de la extracción de datos de este extractor para un empleado:
Si es necesario, este extractor se puede modificar según los requisitos propios o se puede crear un extractor personalizado.
La primera idea fue la posibilidad de reutilizarlos. Desafortunadamente, esto resultó ser una tarea inviable. La mayor parte de la lógica está implementada en el lado de SAP BW, y no fue posible separar el extractor en el origen de SAP BW sin problemas.
Se hizo evidente que sería necesario desarrollar un mecanismo propio para extraer datos de los sistemas SAP.
Estructura de almacenamiento de datos en SAP HCM
Para entender los requisitos de tal mecanismo, primero hay que definir qué datos necesitamos exactamente.
La mayoría de los datos en SAP HCM se almacenan en tablas SQL planas. Con base en estos datos, las aplicaciones SAP visualizan a los usuarios las estructuras organizativas, los empleados y otra información de recursos humanos. Por ejemplo, así es como se ve la estructura organizativa en SAP HCM:
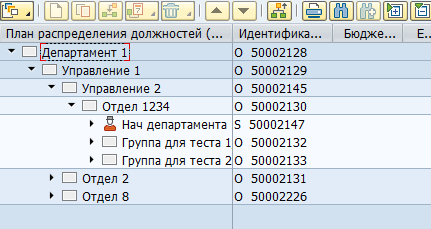
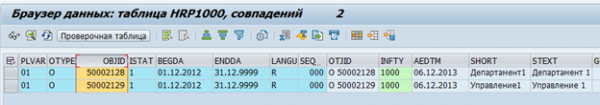
Físicamente, tal árbol se almacena en dos tablas: en hrp1000 los objetos y en hrp1001 las relaciones entre estos objetos.
Objetos 'Departamento 1' y 'Gestión 1':
Relación entre objetos:
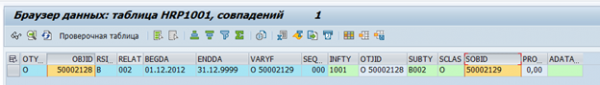
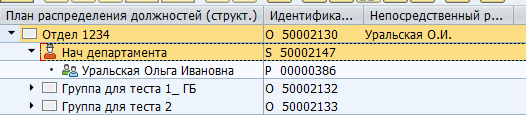
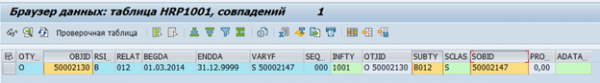
Puede haber una enorme cantidad de tipos tanto de objetos como de relaciones entre ellos. Existen relaciones estándar entre objetos, así como personalizadas para necesidades específicas. Por ejemplo, la relación estándar B012 entre una unidad organizativa y el puesto vacante indica al jefe del departamento.
Visualización del jefe en SAP:
Almacenamiento en la tabla de base de datos:
Los datos de los empleados se almacenan en tablas pa*. Por ejemplo, los datos sobre eventos de personal para un empleado se almacenan en la tabla pa0000.
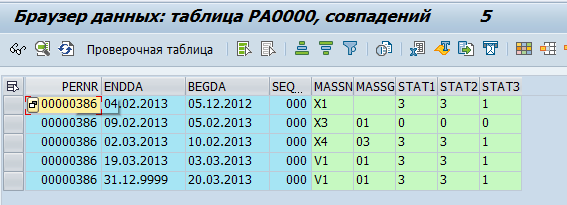
Hemos decidido que GreenPlum tomará los datos 'en crudo', es decir, simplemente los copiará de las tablas de SAP. Y ya directamente en GreenPlum serán procesados y transformados en objetos físicos (por ejemplo, Departamento o Empleado) y métricas (por ejemplo, promedio de plantilla).
Se identificaron alrededor de 70 tablas de las cuales es necesario transferir datos a GreenPlum. Después de esto, comenzamos a trabajar en el método de transferencia de estos datos.
SAP ofrece una cantidad bastante grande de mecanismos de integración. Pero la forma más sencilla - el acceso directo a la base de datos está prohibido debido a restricciones de licencias. Así, todos los flujos de integración deben implementarse a nivel de servidores aplicaciones.
El siguiente problema fue la falta de datos sobre registros eliminados en la base de datos SAP. Al eliminar una fila en la base de datos, se elimina físicamente. Es decir, no era posible formar deltas de cambios a lo largo del tiempo de cambio.
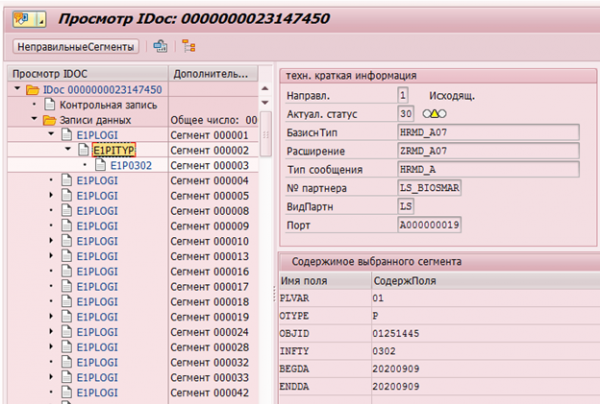
Por supuesto, en SAP HCM existen mecanismos para registrar cambios de datos. Por ejemplo, para la posterior transferencia a los sistemas receptores, existen punteros de cambio (change pointer) que registran cualquier modificación y sobre la base de los cuales se forman los Idoc (objetos para la transferencia a sistemas externos).
Ejemplo de cambio de infotipo IDoc 0302 para un empleado con número de lista 1251445:
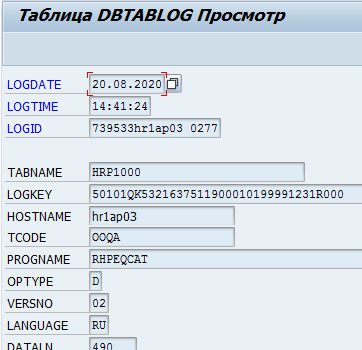
O el registro de cambios de datos en la tabla DBTABLOG.
Ejemplo de registro de eliminación de la entrada con clave QK53216375 de la tabla hrp1000:
Sin embargo, estos mecanismos no están disponibles para todos los datos necesarios, y su procesamiento en el nivel del servidor de aplicaciones puede consumir muchos recursos. Por lo tanto, habilitar el registro para todas las tablas necesarias puede llevar a una notable degradación del rendimiento del sistema.
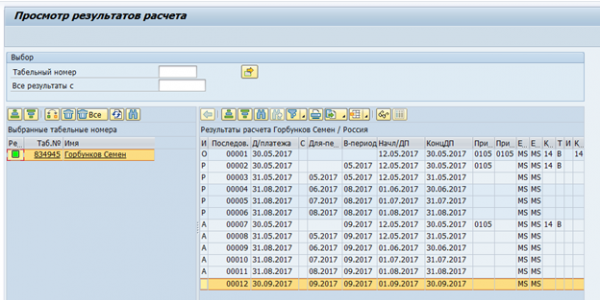
El siguiente problema serio fueron las tablas de clúster. Los datos de evaluación del tiempo y cálculo de salarios en la versión RDBMS SAP HCM se almacenan en un conjunto de tablas lógicas para cada empleado por cada cálculo. Estas tablas lógicas se almacenan como datos binarios en la tabla pcl2.
Clúster de cálculo de salarios:
Los datos de las tablas de clúster no se pueden leer con un comando SQL, y se requiere el uso de macros de SAP HCM o módulos funcionales especiales. En consecuencia, la velocidad de lectura de tales tablas será bastante baja. Por otro lado, en estos clústeres se almacenan datos que solo son necesarios una vez al mes: el cálculo final de salarios y la evaluación del tiempo. Así que la velocidad en este caso no es tan crítica.
Al evaluar las opciones para la formación de la delta de cambios en los datos, también se decidió considerar la opción de exportación completa. La opción de enviar gigabytes de datos inalterados entre sistemas cada día no puede parecer atractiva. Sin embargo, tiene varias ventajas: no es necesario implementar la delta en el lado del origen, ni integrar esta delta en el lado del receptor. En consecuencia, se reduce el costo y el tiempo de implementación, y se aumenta la fiabilidad de la integración. Además, se determinó que prácticamente todos los cambios en SAP HR ocurren en un horizonte de tres meses antes de la fecha actual. Por lo tanto, se decidió realizar una exportación completa diaria de datos de SAP HR por N meses antes de la fecha actual y una exportación completa mensual. El parámetro N depende de la tabla específica
y varía de 1 a 15.
Se propuso el siguiente esquema para la extracción de datos:
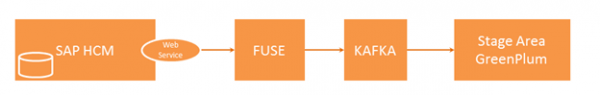
El sistema externo genera una solicitud y la envía a SAP HCM, donde se verifica la integridad de los datos y los permisos de acceso a las tablas. En caso de una verificación exitosa, en SAP HCM se ejecuta un programa que recopila los datos necesarios y los envía a la solución de integración Fuse. Fuse determina el tema correspondiente en Kafka y envía los datos allí. Luego, los datos de Kafka se transfieren a la Área de Etapas GP.
En esta cadena, nos interesa la cuestión de la extracción de datos de SAP HCM. Profundicemos en este tema.
Esquema de interacción entre SAP HCM-FUSE.
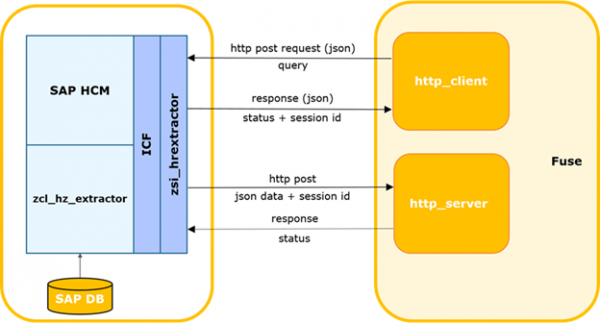
El sistema externo determina el tiempo de la última solicitud exitosa en SAP.
El proceso puede iniciarse mediante un temporizador o algún otro evento, incluido el establecimiento de un tiempo de espera para la respuesta con los datos de SAP e iniciar una nueva solicitud. Posteriormente, se genera una solicitud de diferencias y se envía a SAP.
Los datos de la solicitud se transmiten en el cuerpo en formato json.
Método http: POST.
Ejemplo de solicitud:
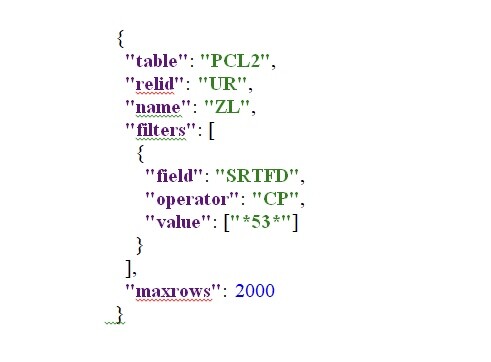
El servicio SAP realiza un control de la solicitud para verificar la integridad, la conformidad con la estructura actual de SAP y la existencia de permisos de acceso a la tabla solicitada.
En caso de errores, el servicio devuelve una respuesta con el código correspondiente y una descripción. En caso de un control exitoso, se crea un proceso en segundo plano para la generación de la selección, se genera un id único de sesión y se devuelve de forma sincrónica.
El sistema externo en caso de error lo registra en el diario. En caso de una respuesta exitosa, transmite el id de la sesión y el nombre de la tabla sobre la que se realizó la solicitud.
El sistema externo registra la sesión actual como abierta. Si hay otras sesiones para esta tabla, se cierran registrando una advertencia en el diario.
La tarea en segundo plano de SAP forma un cursor basado en parámetros específicos y un paquete de datos de tamaño determinado. El tamaño del paquete es el número máximo de registros que el proceso lee de la base de datos. Por defecto, se establece en 2000. Si hay más registros en la selección de la base de datos que el tamaño del paquete utilizado, después de enviar el primer paquete se forma el siguiente bloque con el offset correspondiente y el número de paquete incrementado. Los números se incrementan en 1 y se envían estrictamente en orden secuencial.
A continuación, SAP envía el paquete al servicio web del sistema externo. Este sistema realiza controles del paquete entrante. En el sistema debe haber una sesión registrada con el id recibido y debe estar en estado abierto. Si el número del paquete es > 1, debe haberse registrado la recepción exitosa del paquete anterior (package_id-1).
En caso de un control exitoso, el sistema externo analiza y guarda los datos de la tabla.
Además, si el paquete contiene la bandera final y la serialización se realizó con éxito, se notifica al módulo de integración sobre la finalización exitosa del procesamiento de la sesión y el módulo actualiza el estado de la sesión.
En caso de un error en los controles/análisis, el error se registra y los paquetes de esta sesión serán rechazados por el sistema externo.
Igualmente, en el caso contrario, cuando el sistema externo devuelve un error, se registra y se detiene la transmisión de paquetes.
Para la solicitud de datos del lado de SAP HCM, se ha implementado un servicio de integración. El servicio está implementado en el marco ICF (SAP Internet Communication Framework — ). Permite realizar solicitudes de datos del sistema SAP HCM para tablas específicas. Al formar una solicitud de datos, es posible especificar una lista de campos concretos y parámetros de filtrado para obtener los datos necesarios. Sin embargo, la implementación del servicio no contempla ninguna lógica de negocio. Los algoritmos de cálculo de la delta, parámetros de la solicitud, control de integridad, etc., también se implementan del lado del sistema externo.
Este mecanismo permite recopilar y transmitir todos los datos necesarios en unas pocas horas. Esta velocidad se encuentra en el límite aceptable, por lo que consideramos esta solución como temporal, permitiendo satisfacer la necesidad de una herramienta de extracción en el proyecto.
En el modelo objetivo para resolver la tarea de extracción de datos, se están considerando opciones para el uso de sistemas CDC como Oracle Golden Gate o herramientas ETL como SAP DS.
Fuente: habr.com
