

La clasificación de datos basada en contenido es un desafío abierto. Los sistemas tradicionales de prevención de pérdida de datos (DLP) abordan este problema mediante la huella digital de los datos relevantes y el monitoreo de los puntos finales para obtener dichas huellas. Dada la gran cantidad de recursos de datos que cambian constantemente en Facebook, este enfoque no solo no se escala, sino que también resulta ineficaz para determinar dónde se encuentran los datos. Este artículo se centra en un sistema integral diseñado para detectar tipos semánticos sensibles en Facebook a gran escala y para garantizar automáticamente el almacenamiento de datos y el control de acceso.
El enfoque descrito aquí es nuestro primer sistema integral de privacidad, que intenta resolver este problema mediante la incorporación de señales de datos, aprendizaje automático y métodos tradicionales de huella digital para visualizar y clasificar todos los datos en Facebook. El sistema descrito se opera en un entorno de producción, alcanzando un puntaje promedio F2 de 0.9+ en varias clases de privacidad mientras maneja grandes volúmenes de recursos de datos en decenas de almacenes. Presentamos la traducción de la publicación de Facebook en ArXiv sobre la clasificación de datos escalable para garantizar la seguridad y la privacidad mediante aprendizaje automático.
Introducción
Hoy en día, las organizaciones recogen y almacenan grandes volúmenes de datos en diversos formatos y ubicaciones [1], después los datos se consumen en muchos lugares, a veces se copian o almacenan en caché varias veces, lo que resulta en que información empresarial valiosa y confidencial se dispersa a través de muchos almacenes de datos corporativos. Cuando se requiere que una organización cumpla con ciertos requisitos legales o normativos, como adherirse a normas durante un proceso civil, surge la necesidad de recopilar información sobre la ubicación de los datos necesarios. Cuando se menciona en una orden de confidencialidad que la organización debe enmascarar todos los números de Seguro Social (SSN) al transmitir información personal a entidades no autorizadas, el primer paso natural es encontrar todos los SSN en los almacenes de datos de toda la organización. En tales circunstancias, la clasificación de datos se vuelve crucial [1]. Un sistema de clasificación permitirá a las organizaciones garantizar automáticamente el cumplimiento de privacidad y políticas de seguridad, como la inclusión de políticas de gestión de acceso y conservación de datos. Facebook presenta un sistema que hemos construido en Facebook, que utiliza múltiples señales de datos, una arquitectura de sistema escalable y aprendizaje automático para detectar tipos semánticos de datos sensibles.
La detección y clasificación de datos implica buscarlos y etiquetarlos de tal manera que, cuando sea necesario, se pueda extraer información relevante de manera rápida y eficiente. El proceso actual es más bien manual y consiste en estudiar las leyes o regulaciones correspondientes, determinar qué tipos de información deben considerarse sensibles y cuáles son los diferentes niveles de sensibilidad, y luego construir las clases y políticas de clasificación adecuadas [1]. Después, el sistema de prevención de pérdida de datos (DLP) toma huellas de los datos y rastrea los puntos finales aguas abajo para obtener las huellas. Trabajar con un almacenamiento que tiene muchos activos y petabytes de datos simplemente no es escalable con este enfoque.
Nuestro objetivo es construir un sistema de clasificación de datos que se escale tanto para datos de usuario persistentes como no persistentes, sin ninguna restricción adicional sobre el tipo o formato de los datos. Esto es un objetivo ambicioso y, naturalmente, conlleva desafíos. Cualquier registro de datos puede tener miles de caracteres de longitud.
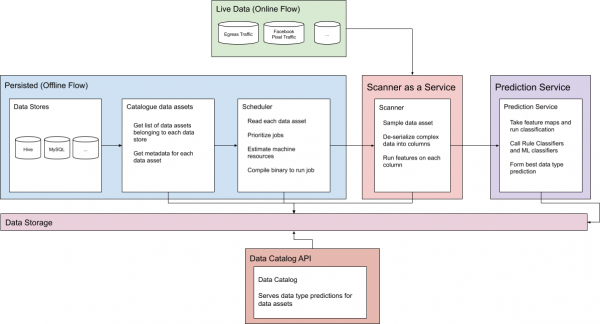
Figura 1. Flujos de pronósticos en línea y fuera de línea
Por lo tanto, debemos representarlo de manera efectiva utilizando un conjunto común de características que pueden ser luego combinadas y desplazadas fácilmente. Estas características no solo deben proporcionar una clasificación precisa, sino también ofrecer flexibilidad y escalabilidad para la fácil adición y descubrimiento de nuevos tipos de datos en el futuro. En segundo lugar, hay que lidiar con grandes tablas autónomas. Los datos persistentes pueden almacenarse en tablas que ocupan múltiples petabytes. Esto puede llevar a una reducción en la velocidad de escaneo. En tercer lugar, debemos cumplir con una estricta clasificación SLA para los datos no persistentes. Esto obliga al sistema a ser altamente eficiente, rápido y preciso. Finalmente, debemos asegurar una clasificación de datos de baja latencia para los datos no persistentes, para realizar la clasificación en tiempo real y también para casos de uso en línea.
Este artículo describe cómo enfrentamos los problemas mencionados y presenta un sistema de clasificación rápido y escalable que clasifica elementos de datos de todos los tipos, formatos y fuentes en función de un conjunto común de características. Ampliamos la arquitectura del sistema y creamos un modelo de aprendizaje automático específico para la clasificación rápida de datos en línea y fuera de línea. Este artículo está organizado de la siguiente manera: en la sección 2 se presenta el diseño general del sistema. La sección 3 discute las partes del sistema de aprendizaje automático. En las secciones 4 y 5 se habla sobre el trabajo relacionado y se esboza la dirección futura del trabajo.
Arquitectura
Para abordar los problemas de datos persistentes y datos en línea a la escala de Facebook, el sistema de clasificación tiene dos flujos separados, que discutiremos en detalle.
Datos persistentes
Inicialmente, el sistema debe conocer una variedad de activos informativos de Facebook. Para cada almacenamiento, se recopila cierta información básica, como el centro de datos que contiene esos datos, el sistema asociado a estos datos y los activos ubicados en un almacenamiento de datos específico. Esto forma un catálogo de metadatos que permite al sistema extraer datos de manera eficiente sin sobrecargar a los clientes y recursos utilizados por otros ingenieros.
Este catálogo de metadatos proporciona una fuente confiable para todos los activos escaneados y permite rastrear el estado de los diferentes activos. Con esta información, se establece la prioridad de planificación basada en los datos recopilados y la información interna del sistema, como el tiempo del último escaneo exitoso del activo y su fecha de creación, así como los requisitos de memoria y CPU previos para este activo, si se ha escaneado anteriormente. Luego, para cada recurso de datos (a medida que los recursos estén disponibles), se invoca la tarea real de escaneo del recurso.
Cada tarea es un archivo binario compilado que realiza una muestra de Bernoulli de los últimos datos disponibles para cada activo. El activo se divide en columnas separadas, donde el resultado de la clasificación de cada columna se procesa de manera independiente. Además, el sistema escanea cualquier dato denso dentro de las columnas. JSON, arreglos, estructuras codificadas, URLs, datos serializados en base 64 y mucho más son todos escaneados. Esto puede aumentar significativamente el tiempo de ejecución del escaneo, ya que una tabla puede contener miles de columnas anidadas en un gran objeto binario. json..
Para cada fila que se selecciona en el activo de datos, el sistema de clasificación extrae objetos flotantes y de texto del contenido y vincula cada objeto de nuevo a la columna de la que fue tomado. El resultado de la etapa de extracción de objetos es un mapa de todos los objetos para cada columna encontrada en el activo de datos.
¿Para qué son las características?
El concepto de características es crucial. En lugar de las características float y text, podemos transmitir muestras de cadenas sin procesar que se extraen directamente de cada recurso de datos. Además, los modelos de aprendizaje automático pueden entrenarse directamente en cada muestra, en lugar de en cientos de cálculos de características que solo intentan aproximar la muestra. Hay varias razones para ello:
- La privacidad es lo primero: lo más importante, el concepto de características nos permite almacenar en memoria solo aquellas muestras que extraemos. Esto garantiza que almacenamos muestras con un único propósito y nunca las registramos mediante nuestros propios esfuerzos. Esto es especialmente importante para datos inestables, ya que el servicio debe mantener cierto estado de clasificación antes de proporcionar una predicción.
- Memoria: algunas muestras pueden tener miles de caracteres de longitud. Almacenar estos datos y enviarlos a partes del sistema sin necesidad consume muchos bytes adicionales. Estos dos factores pueden combinarse con el tiempo, considerando que hay muchos recursos de datos con miles de columnas.
- Agregación de características: a través de sus conjuntos, las características representan claramente los resultados de cada escaneo, lo que permite que el sistema combine los resultados de escaneos anteriores del mismo recurso de datos de manera conveniente. Esto puede ser útil para agregar resultados de escaneos de un recurso de datos en múltiples ejecuciones.
Luego, las características se envían al servicio de predicción, donde utilizamos clasificación basada en reglas y aprendizaje automático para predecir las etiquetas de datos de cada columna. El servicio se basa tanto en clasificadores de reglas como en aprendizaje automático y elige la mejor predicción hecha desde cada objeto de predicción.
Los clasificadores de reglas son heurísticas manuales, utilizan cálculos y coeficientes para normalizar el objeto en un rango de 0 a 100. Una vez que se genera una puntuación inicial para cada tipo de datos y nombre de columna relacionado con esos datos, el cual no figura en ninguna 'lista prohibida', el clasificador de reglas elige la puntuación normalizada más alta entre todos los tipos de datos.
Debido a la complejidad de la clasificación, el uso exclusivo de heurísticas manuales conduce a una baja precisión en la clasificación, especialmente para datos no estructurados. Por esta razón, hemos desarrollado un sistema de aprendizaje automático para trabajar con la clasificación de datos no estructurados, como contenido de usuario y direcciones. El aprendizaje automático ha permitido alejarnos de las heurísticas manuales y aplicar señales de datos adicionales (como nombres de columnas, origen de los datos), mejorando significativamente la precisión de la detección. Profundizaremos en nuestra arquitectura de aprendizaje automático más adelante.
El servicio de pronóstico almacena los resultados para cada columna junto con los metadatos relacionados con el tiempo y el estado del escaneo. Cualquier consumidor y procesos secundarios que dependan de estos datos pueden leerlos del conjunto de datos publicado diariamente. Este conjunto agrega los resultados de todas estas tareas de escaneo, o API en tiempo real del catálogo de datos. Los pronósticos publicados son fundamentales para la aplicación automática de políticas de privacidad y seguridad.
Finalmente, después de que el servicio de pronóstico registra todos los datos y se guardan todos los pronósticos, nuestra API del catálogo de datos puede devolver todos los pronósticos de tipos de datos para un recurso en tiempo real. Cada día, el sistema publica un conjunto de datos que contiene todos los últimos pronósticos para cada activo.
Datos no persistentes
Aunque el proceso descrito anteriormente se creó para activos persistentes, el tráfico no almacenado también se considera parte de los datos de la organización y puede ser importante. Por esta razón, el sistema proporciona una API en línea para la generación de pronósticos de clasificación en tiempo real para cualquier tráfico no persistente. El sistema de pronóstico en tiempo real se utiliza ampliamente para la clasificación del tráfico saliente, tráfico entrante en modelos de aprendizaje automático y datos de anunciantes.
Aquí el API acepta dos argumentos principales: la clave de agrupación y los datos sin procesar que deben ser pronosticados. El servicio realiza la misma extracción de objetos descrita anteriormente y agrupa los objetos juntos para la misma clave. Estas características también se mantienen en la caché almacenada para la recuperación tras fallos. Para cada clave de agrupación, el servicio garantiza que antes de hacer la llamada al servicio de predicción, ha visto suficientes muestras de acuerdo con el proceso descrito anteriormente.
Optimización
Para escanear ciertos almacenes, utilizamos bibliotecas y métodos de optimización de lectura desde almacenamiento en caliente [2] y garantizamos que no haya interrupciones por parte de otros usuarios que acceden al mismo almacenamiento.
Para tablas extremadamente grandes (50+ petabytes), a pesar de todas las optimizaciones y la eficiencia de la memoria, el sistema trabaja en escanear y calcular todo antes de que se agote la memoria. Al final, el escaneo se computa completamente en memoria y no se guarda durante el escaneo. Si las grandes tablas contienen miles de columnas con conjuntos de datos no estructurados, la tarea puede fallar debido a la falta de recursos de memoria al realizar predicciones para toda la tabla. Esto llevará a una disminución de la cobertura. Para combatir esto, hemos optimizado el sistema para usar la velocidad de escaneo como un intermediario en cuán bien maneja el sistema la carga actual. Usamos la velocidad como un mecanismo predictivo para identificar problemas de memoria y al calcular anticipadamente el mapa de objetos. Al hacerlo, usamos menos datos de lo habitual.
Señales de datos
El sistema de clasificación es tan bueno como las señales de los datos. Aquí examinaremos todas las señales utilizadas por el sistema de clasificación.
- Basado en el contenido: por supuesto, la primera y más importante señal es el contenido. Se realiza un muestreo de Bernoulli de cada activo de datos que escaneamos y extraemos características del contenido de los datos. Muchas de las características provienen del contenido. Puede haber cualquier cantidad de objetos flotantes que representan los cálculos de cuántas veces se ha observado un determinado tipo de patrón. Por ejemplo, podríamos tener recuentos de la cantidad de correos electrónicos vistos en la muestra, o indicadores de cuántos emoticonos se han detectado en la muestra. Estos cálculos de características pueden normalizarse y agregarse a diferentes escaneos.
- Origen de los datos: una señal importante que puede ayudar cuando el contenido ha cambiado desde la tabla padre. Un ejemplo común son los datos hash. Cuando los datos en la tabla hija se hash, a menudo provienen de la tabla padre, donde permanecen en texto claro. Los datos de origen ayudan a clasificar ciertos tipos de datos cuando no se leen claramente o se transforman desde la tabla aguas arriba.
- Anotaciones: otra señal de alta calidad que ayuda en la identificación de datos no estructurados. De hecho, las anotaciones y los datos de origen pueden trabajar juntos para difundir atributos entre varios activos de datos. Las anotaciones ayudan a identificar la fuente de los datos no estructurados, mientras que los datos de origen pueden ayudar a rastrear el flujo de esos datos a través del almacenamiento.
- La inyección de datos es un método en el que se introducen intencionalmente caracteres especiales y no legibles en fuentes conocidas con tipos de datos conocidos. Entonces, cada vez que escaneamos el contenido con la misma secuencia de caracteres no legibles, se puede inferir que el contenido proviene de ese tipo de datos conocido. Esta es otra señal de calidad de datos, similar a las anotaciones. A diferencia de esto, la detección basada en el contenido ayuda a identificar los datos ingresados.
Medición de métricas
Un componente importante es el rigor de la metodología para medir métricas. Las métricas clave de la iteración para mejorar la clasificación son la precisión y el recall de cada etiqueta, siendo la evaluación F2 la más relevante.
Para calcular estos indicadores, se necesita una metodología independiente de marcado de activos de datos que no dependa del sistema mismo, pero que pueda utilizarse para una comparación directa con él. A continuación, describiremos cómo recopilamos la verdad fundamental de Facebook y la utilizamos para entrenar nuestro sistema de clasificación.
Recopilación de datos confiables
Acumulamos datos confiables de cada fuente enumerada a continuación en su propia tabla. Cada tabla se encarga de agregar los últimos valores observables de esta fuente específica. Cada fuente tiene un control de calidad de los datos para garantizar que los valores observados sean de alta calidad y contengan las últimas etiquetas de tipos de datos.
- Configuraciones de la plataforma de registro: ciertos campos en las tablas de colmena se completan con datos que pertenecen a un tipo específico. El uso y distribución de estos datos sirve como una fuente confiable de datos válidos.
- Etiquetado manual: los desarrolladores que respaldan el sistema, así como etiquetadores externos, están capacitados para etiquetar columnas. Esto generalmente funciona bien para todos los tipos de datos en el almacenamiento y puede ser la fuente principal de validez para algunos datos no estructurados, como datos de mensajes o contenido generado por el usuario.
- Las columnas de las tablas parentales pueden ser etiquetadas o anotadas como que contienen ciertos datos, y podemos rastrear esos datos en las tablas subordinadas.
- Muestreo de flujos de ejecución: los flujos de ejecución en Facebook portan datos de un tipo específico. Usando nuestro escáner como arquitectura de servicio, podemos muestrear flujos que tengan tipos de datos conocidos y enviarlos a través del sistema. El sistema promete no almacenar estos datos.
- Tablas de muestreo: grandes tablas de colmena que se sabe contienen todo el corpus de datos también se pueden utilizar como datos de entrenamiento y transmitirse a través del escáner como servicio. Esto es ideal para tablas con un rango completo de tipos de datos, de modo que el muestreo de una columna al azar es equivalente al muestreo de todo el conjunto de ese tipo de datos.
- Datos sintéticos: incluso podemos utilizar bibliotecas que generan datos sobre la marcha. Esto funciona bien para tipos de datos simples y públicos, como una dirección o GPS.
- Stewards de datos: los programas de privacidad suelen utilizar stewards de datos para vincular manualmente políticas a partes de los datos. Esto sirve como una fuente de veracidad altamente precisa.
Consolidamos cada fuente principal de datos verificados en un único corpus con todos estos datos. El mayor problema con la veracidad es asegurarse de que sea representativa del almacén de datos. De lo contrario, los motores de clasificación pueden sobreentrenarse. Para combatir esto, todas las fuentes mencionadas anteriormente se utilizan para asegurar un equilibrio en el entrenamiento de modelos o en la computación de métricas. Además, etiquetadores humanos seleccionan de manera uniforme diferentes columnas en el almacén y etiquetan los datos en consecuencia para que la recolección de valores verídicos permanezca imparcial.
Integración continua
Para garantizar una rápida iteración y mejora, es importante medir siempre el rendimiento del sistema en tiempo real. Podemos medir cada mejora de clasificación en comparación con el sistema de hoy, para que tácticamente podamos orientar los datos en futuras mejoras. Aquí veremos cómo el sistema completa el ciclo de retroalimentación proporcionado por los datos verídicos.
Cuando el sistema de planificación se enfrenta a un activo que tiene una etiqueta de una fuente confiable, se programan dos tareas. La primera utiliza nuestro escáner de producción y, por lo tanto, nuestras capacidades de producción. La segunda tarea utiliza el escáner de la última versión con las últimas características. Cada tarea escribe su salida en su propia tabla, etiquetando las versiones junto con los resultados de clasificación.
Así comparamos los resultados de clasificación del candidato a lanzamiento y del modelo de producción en tiempo real.
Mientras los conjuntos de datos comparan las características de RC y PROD, se registran numerosas variaciones del motor de clasificación ML del servicio de pronóstico. El modelo de aprendizaje automático más reciente construido, el modelo actual en producción y cualquier modelo experimental. El mismo enfoque nos permite "cortar" diferentes versiones del modelo (agnóstico de nuestros clasificadores de reglas) y comparar métricas en tiempo real. Es fácil determinar cuándo un experimento de ML está listo para su implementación en producción.
Cada noche, las características de RC calculadas para ese día se envían al pipeline de entrenamiento de ML, donde el modelo se entrena con las últimas características de RC y evalúa su desempeño en comparación con un conjunto de datos confiable.
Cada mañana, el modelo completa su entrenamiento y se publica automáticamente como experimental. Se incluye automáticamente en la lista de experimentos.
Algunos resultados
Se etiquetan más de 100 tipos de datos diferentes con alta precisión. Los tipos bien estructurados, como correos electrónicos y números de teléfono, se clasifican con una puntuación f2 superior a 0,95. Los tipos de datos no estructurados, como contenido del usuario y nombres, también funcionan muy bien, con puntuaciones F2 superiores a 0,85.
Diariamente se clasifica una gran cantidad de columnas de datos estables y no estables en todos los almacenes. Se escanean más de 500 terabytes diariamente en más de 10 almacenes de datos. La cobertura de la mayoría de estos almacenes es superior al 98%.
Con el tiempo, la clasificación se ha vuelto muy eficiente, ya que las tareas de clasificación en el flujo autónomo guardado tardan en promedio 35 segundos desde el escaneo del activo hasta el cálculo de pronósticos para cada columna.
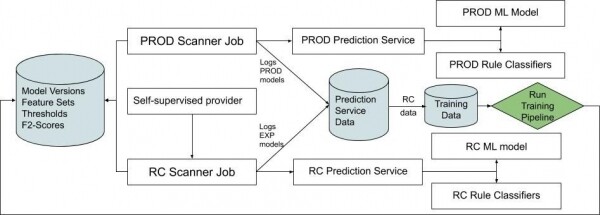
Fig. 2. Diagrama que describe el flujo continuo de integración para entender cómo se generan y envían los objetos de RC al modelo.
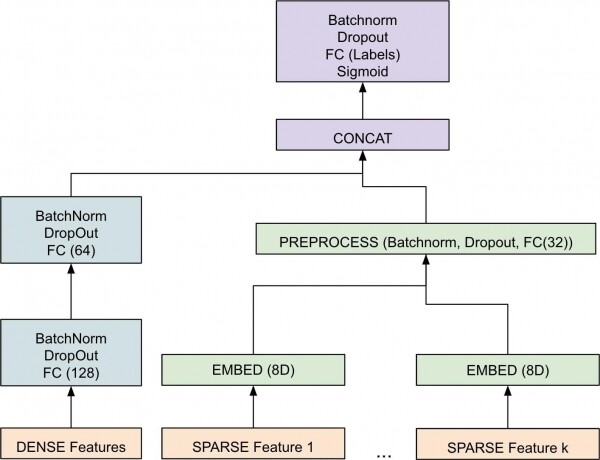
Figura 3. Diagrama de alto nivel del componente de aprendizaje automático.
Componente del sistema de aprendizaje automático
En la sección anterior, profundizamos en la arquitectura de todo el sistema, destacando la escala, la optimización y los flujos de datos en modo autónomo y en línea. En esta sección, exploraremos el servicio de pronóstico y describiremos el sistema de aprendizaje automático que habilita el funcionamiento del servicio de pronóstico.
Con más de 100 tipos de datos y algo de contenido no estructurado, como datos de mensajes y contenido de usuario, el uso exclusivo de heurísticas manuales conduce a una precisión de clasificación subparámetrica, especialmente para datos no estructurados. Por esta razón, también hemos desarrollado un sistema de aprendizaje automático para abordar las complejidades de los datos no estructurados. El uso de aprendizaje automático permite comenzar a alejarnos de las heurísticas manuales y trabajar con características y señales adicionales de datos (como nombres de columnas, origen de los datos) para mejorar la precisión.
El modelo implementado estudia las representaciones vectoriales [3] sobre objetos densos y dispersos por separado. Luego, se combinan para formar un vector que pasa a través de una serie de etapas de normalización por lotes [4] y no linealidades para obtener el resultado final. El resultado final es un número de punto flotante entre [0-1] para cada etiqueta, indicando la probabilidad de que un ejemplo pertenezca a un determinado tipo de sensibilidad. El uso de PyTorch para el modelo nos permitió movernos más rápido, dando a los desarrolladores fuera del equipo la capacidad de realizar y probar cambios rápidamente.
Al diseñar la arquitectura, era importante modelar objetos dispersos (por ejemplo, texto) y densos (por ejemplo, numéricos) por separado debido a su diferencia interna. También fue importante en la arquitectura final realizar una expansión de parámetros para encontrar el valor óptimo de la tasa de aprendizaje, el tamaño del lote y otros hiperparámetros. La elección del optimizador también fue un hiperparámetro importante. Descubrimos que el optimizador popular Adama menudo lleva al sobreajuste, mientras que el modelo con SGD más estable. Había matices adicionales que debíamos incluir directamente en el modelo. Por ejemplo, reglas estáticas que garantizaban que el modelo hacía una predicción determinista cuando una característica tenía un valor específico. Estas reglas estáticas son definidas por nuestros clientes. Descubrimos que incluirlas directamente en el modelo resultó en una arquitectura más autosuficiente y confiable, a diferencia de implementar una etapa de posprocesamiento para manejar estos casos límite específicos. También cabe señalar que durante el entrenamiento, estas reglas están desactivadas para no interferir con el proceso de entrenamiento de descenso de gradiente.
Problemas
Uno de los problemas fue la recolección de datos confiables de alta calidad. El modelo necesita fiabilidad para cada clase, para que pueda aprender asociaciones entre objetos y etiquetas. En la sección anterior discutimos los métodos de recolección de datos tanto para la medición del sistema como para el entrenamiento de los modelos. El análisis mostró que clases de datos como los números de tarjetas de crédito y cuentas bancarias no son muy comunes en nuestro almacenamiento. Esto dificulta la recolección de grandes volúmenes de datos confiables para el entrenamiento de modelos. Para abordar este problema, desarrollamos procesos para obtener datos sintéticos confiables para estas clases. Generamos tales datos para tipos sensibles, incluyendo SSN, números de tarjetas de crédito y IBAN-números, para los cuales el modelo no pudo predecir anteriormente. Este enfoque permite manejar tipos de datos confidenciales sin el riesgo de privacidad asociado con la ocultación de datos confidenciales reales.
Además de los problemas de datos confiables, hay problemas arquitectónicos abiertos en los que estamos trabajando, tales como aislamiento de cambios y detención temprana. El aislamiento de cambios es importante para que al hacer diferentes modificaciones en diferentes partes de la red, el impacto esté aislado a clases específicas y no tenga un efecto amplio en el rendimiento general de la predicción. Mejorar los criterios de detención temprana también es crucial para que podamos detener el proceso de entrenamiento en un punto estable para todas las clases, en lugar de un punto donde algunas clases están sobreentrenadas y otras no.
Importancia de la característica
Cuando se introduce una nueva característica en el modelo, queremos conocer su impacto general en el mismo. También queremos asegurarnos de que las predicciones sean interpretables por los humanos, para que se pueda entender exactamente qué características se utilizan para cada tipo de dato. Para ello, hemos desarrollado e implementado la importancia por clase de las características para el modelo PyTorch. Cabe destacar que esto es diferente de la importancia general de la característica, que normalmente se admite, porque no nos dice qué características son importantes para una clase específica. Medimos la importancia de un objeto calculando el aumento del error de predicción después de permutar el objeto. Una característica es "importante" cuando la permutación de sus valores aumenta el error del modelo, ya que en este caso el modelo dependía de la característica para realizar la predicción. Una característica es "no importante" cuando la permutación de sus valores deja el error del modelo sin cambios, ya que en este caso el modelo la ignoraba [5].
La importancia de la característica para cada clase permite que el modelo sea interpretable, para que podamos ver en qué se enfoca el modelo al predecir la etiqueta. Por ejemplo, cuando analizamos ADDR, nos aseguramos de que la característica relacionada con la dirección, como AddressLinesCount, ocupe un lugar destacado en la tabla de importancia de las características para cada clase, para que nuestra intuición humana se alinee bien con lo que ha aprendido el modelo.
Evaluación
Es importante definir una métrica única de éxito. Elegimos F2 — un equilibrio entre el recall y la precisión (con un sesgo hacia el recall un poco mayor). El recall es más importante para el caso de uso de privacidad que la precisión, porque para el equipo es crucial no perder ningún dato confidencial (mientras se garantiza una precisión razonable). Los datos reales de evaluación del rendimiento F2 de nuestro modelo van más allá del alcance de este artículo. Sin embargo, con un ajuste cuidadoso, podemos lograr una puntuación alta (0,9+) en F2 para las clases sensibles más importantes.
Trabajo relacionado
Existen muchos algoritmos de clasificación automática de documentos no estructurados utilizando diferentes métodos, como la coincidencia de patrones, la búsqueda de similitud de documentos y varios métodos de aprendizaje automático (bayesianos, árboles de decisión, k-vecinos más cercanos y muchos otros) [6]. Cualquiera de ellos puede utilizarse como parte de la clasificación. Sin embargo, el problema radica en la escalabilidad. El enfoque de clasificación presentado en este artículo se inclina hacia la flexibilidad y el rendimiento. Esto nos permite soportar nuevas clases en el futuro y mantener una baja latencia.
También existen muchos trabajos sobre la extracción de huellas de datos. Por ejemplo, los autores en [7] describieron una solución que se centra en el problema de capturar filtraciones de datos confidenciales. La suposición principal es la posibilidad de una huella sobre los datos, para compararla con un conjunto de datos confidenciales conocidos. Los autores en [8] describen un problema similar de filtraciones de privacidad, pero su solución se basa en una arquitectura específica de Android y se clasifica solo cuando las acciones del usuario han resultado en el envío de información personal o si hay una fuga de datos del usuario en la aplicación base. La situación aquí es algo diferente, ya que los datos del usuario también pueden ser altamente no estructurados. Por lo tanto, necesitamos una técnica más compleja que la simple extracción de huellas.
Finalmente, para abordar la falta de datos para ciertos tipos de datos confidenciales, introdujimos datos sintéticos. Existe una gran cantidad de literatura sobre la augmentación de datos, por ejemplo, los autores en [9] investigaron el papel de la inyección de ruido durante el aprendizaje y observaron resultados positivos en el aprendizaje controlado. Nuestro enfoque sobre la privacidad es diferente, porque la introducción de datos ruidosos puede ser contraproducente, y en su lugar nos centramos en datos sintéticos de alta calidad.
Conclusión
En este artículo, presentamos un sistema que puede clasificar un fragmento de datos. Esto nos permite crear sistemas para garantizar el cumplimiento de políticas de privacidad y seguridad. Mostramos que una infraestructura escalable, la integración continua, el aprendizaje automático y datos de alta calidad sobre la veracidad de los datos juegan un papel clave en el éxito de muchas de nuestras iniciativas de privacidad.
Hay muchas direcciones para el trabajo futuro. Este puede incluir garantizar el soporte para datos no estructurados (archivos), clasificar no solo el tipo de datos, sino también el nivel de sensibilidad, así como utilizar el aprendizaje auto-controlado durante el entrenamiento mediante la generación de ejemplos sintéticos precisos. Estos, a su vez, ayudarán a que el modelo reduzca las pérdidas a su mayor magnitud. El trabajo futuro también puede centrarse en el flujo de trabajo de investigación, donde vamos más allá de la detección y proporcionamos un análisis de las causas raíz de diversas violaciones de privacidad. Esto ayudará en casos como el análisis de sensibilidad (es decir, si la sensibilidad de privacidad del tipo de dato es alta (por ejemplo, la IP del usuario) o baja (por ejemplo, la IP interna de Facebook)).
Bibliografía
- David Ben-David, Tamar Domany y Abigail Tarem. Clasificación de datos empresariales utilizando tecnologías de la web semántica. En Peter F. Patel-Schneider, Yue Pan, Pascal Hitzler, Peter Mika, Lei Zhang, Jeff Z. Pan, Ian Horrocks y Birte Glimm, editores, La Web Semántica – ISWC 2010, páginas 66–81, Berlín, Heidelberg, 2010. Springer Berlín Heidelberg.
- Subramanian Muralidhar, Wyatt Lloyd, Sabyasachi Roy, Cory Hill, Ernest Lin, Weiwen Liu, Satadru Pan, Shiva Shankar, Viswanath Sivakumar, Linpeng Tang y Sanjeev Kumar. f4: Sistema de almacenamiento BLOB en caliente de Facebook. En 11º Simposio USENIX sobre Diseño e Implementación de Sistemas Operativos (OSDI 14), páginas 383–398, Broomfield, CO, octubre de 2014. Asociación USENIX.
- Tomas Mikolov, Ilya Sutskever, Kai Chen, Greg S Corrado y Jeff Dean. Representaciones distribuidas de palabras y frases y su composicionalidad. En C. J. C. Burges, L. Bottou, M. Welling, Z. Ghahramani y K. Q. Weinberger, editores, Avances en Sistemas de Procesamiento de Información Neural 26, páginas 3111–3119. Curran Associates, Inc., 2013.
- Sergey Ioffe y Christian Szegedy. Normalización por lotes: Acelerando el entrenamiento de redes profundas al reducir el desplazamiento interno de covariables. En Francis Bach y David Blei, editores, Actas de la 32ª Conferencia Internacional sobre Aprendizaje Automático, volumen 37 de Actas de la Investigación en Aprendizaje Automático, páginas 448–456, Lille, Francia, 07–09 de julio de 2015. PMLR.
- Leo Breiman. Bosques aleatorios. Mach. Apr., 45(1):5–32, octubre de 2001.
- Thair Nu Phyu. Encuesta sobre técnicas de clasificación en minería de datos.
- X. Shu, D. Yao y E. Bertino. Detección de exposición de datos sensibles que preserva la privacidad. Transacciones IEEE sobre Forense de Información y Seguridad, 10(5):1092–1103, 2015.
- Zhemin Yang, Min Yang, Yuan Zhang, Guofei Gu, Peng Ning, y Xiaoyang Wang. Appintent: Analizando la transmisión de datos sensibles en Android para la detección de fugas de privacidad. páginas 1043–1054, 11 2013.
- Qizhe Xie, Zihang Dai, Eduard H. Hovy, Minh-Thang Luong, y Quoc V. Le. Aumento de datos no supervisado.
Descubre los detalles sobre cómo obtener una profesión demandada desde cero o mejorar habilidades y salario a través de los cursos en línea de SkillFactory:
- (12 meses)
- (12 semanas)
- (20 semanas)
- (20 semanas)
Más cursos
- (9 meses)
- (8 meses)
- (9 meses)
- (12 meses)
- (18 meses)
- (12 meses)
- (9 meses)
- (7 meses)
Fuente: habr.com
