

Estimados lectores, ¡buen día!
La tarea de construir plataformas de TI para la acumulación y análisis de datos tarde o temprano surge en cualquier empresa cuyo modelo de negocio se basa en la prestación de servicios intensivos en conocimiento o en la creación de productos técnicamente complejos. La construcción de plataformas analíticas es una tarea compleja y que requiere mucho tiempo. Sin embargo, cualquier tarea se puede simplificar. En este artículo quiero compartir mi experiencia en el uso de herramientas de bajo código que ayudan en la creación de soluciones analíticas. Esta experiencia se adquirió al implementar una serie de proyectos en la dirección de Soluciones de Big Data de la empresa "Neoflex". Desde 2005, la dirección de Soluciones de Big Data de la empresa "Neoflex" se ocupa de la construcción de almacenes y lagos de datos, aborda cuestiones de optimización de la velocidad de procesamiento de información y trabaja en la metodología de gestión de la calidad de los datos.
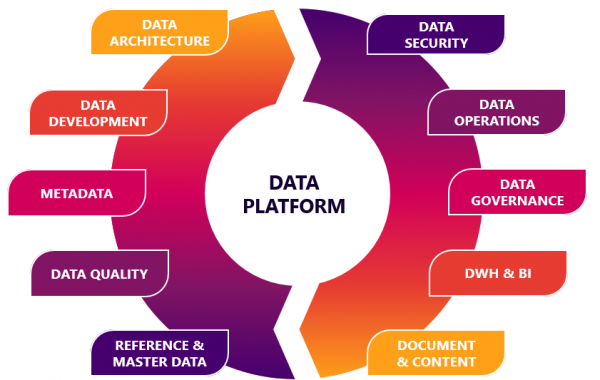
No habrá manera de evitar la acumulación consciente de datos débil y/o fuertemente estructurados. Quizás, incluso si se trata de una pequeña empresa. Cuando un emprendedor prometedor escale su negocio, se encontrará con cuestiones sobre el desarrollo de programas de lealtad, querrá realizar un análisis de la efectividad de los puntos de venta, considerará la publicidad dirigida y se preguntará sobre la demanda de productos complementarios. En un primer acercamiento, la tarea podría resolverse de manera rudimentaria. Pero a medida que el negocio crece, la transición a una plataforma analítica es inevitable.
¿Pero en qué casos las tareas de análisis de datos pueden convertirse en problemas de la clase "Rocket Science"? Probablemente en el momento en que se trate de datos realmente grandes.
Para simplificar la tarea de "Rocket Science", se puede comer un elefante en partes.
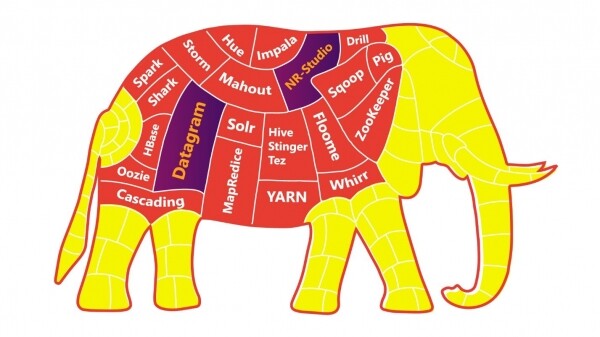
Cuanto mayor sea la discreción y autonomía de sus aplicaciones/servicios/microservicios, más fácil será para usted, sus colegas y todo el negocio procesar el elefante.
A esta conclusión han llegado prácticamente todos nuestros clientes, reestructurando el paisaje basado en las prácticas de ingeniería de los equipos de DevOps.
Pero incluso con una dieta "separada, de elefante", tenemos buenas probabilidades de "sobrealimentar" el paisaje de TI. En este momento, es recomendable detenerse, respirar y mirar hacia low-code engineering platform.
A muchos desarrolladores les asusta la perspectiva de un estancamiento en su carrera al alejarse de la escritura directa de código hacia el 'arrastre' de flechas en interfaces de usuarios de sistemas low-code. Sin embargo, la llegada de las máquinas no significó la desaparición de los ingenieros, sino que llevó su trabajo a un nuevo nivel.
Veamos por qué.
El análisis de datos en los sectores de logística, telecomunicaciones, investigación de medios y el sector financiero siempre está relacionado con las siguientes preguntas:
- La velocidad de análisis automatizado;
- La capacidad de realizar experimentos sin afectar el flujo principal de producción de datos;
- La fiabilidad de los datos preparados;
- El seguimiento de cambios y la versionado;
- Proveniencia de datos, linaje de datos, CDC;
- La rapidez de entrega de nuevas funciones en el entorno de producción;
- Y el famoso: costo de desarrollo y mantenimiento.
Es decir, los ingenieros tienen una gran cantidad de tareas de alto nivel, que solo se pueden realizar con suficiente eficacia si liberan su mente de las tareas de bajo nivel de desarrollo.
Las premisas para que los desarrolladores pasen a un nuevo nivel son la evolución y digitalización del negocio. El valor del desarrollador también está cambiando: hay una gran escasez de desarrolladores capaces de sumergirse en la esencia de los conceptos de negocio que se automatizan.
Hagamos una analogía con los lenguajes de programación de bajo y alto nivel. La transición de lenguajes de bajo nivel a lenguajes de alto nivel es un cambio de 'escritura de directivas directas en el lenguaje de hardware' hacia 'directivas en el lenguaje de personas'. Es decir, añadir un cierto nivel de abstracción. En este sentido, la transición a plataformas low-code desde lenguajes de programación de alto nivel es un cambio de 'directivas en el lenguaje de personas' hacia 'directivas en el lenguaje de negocio'. Si hay desarrolladores a quienes este hecho les preocupa, entonces probablemente ya están preocupados desde el momento en que apareció JavaScript, que utiliza funciones de ordenamiento de matrices. Y estas funciones, por supuesto, tienen detrás implementaciones en otros medios de la misma programación de alto nivel.
Por lo tanto, low-code es simplemente la aparición de otro nivel de abstracción.
Experiencia práctica en el uso de low-code.
El tema del low-code es bastante amplio, pero ahora me gustaría hablar sobre la aplicación práctica de los "conceptos de bajo código" a través de uno de nuestros proyectos.
La división de Big Data Solutions de la empresa "Neoflex" se especializa en gran medida en el sector financiero, construyendo almacenes y lagos de datos y automatizando varios informes. En este nicho, el uso de low-code se ha convertido en un estándar. Entre otras herramientas low-code, se pueden mencionar las herramientas para organizar procesos ETL: Informatica Power Center, IBM Datastage, Pentaho Data Integration. O bien, Oracle Apex, que sirve como entorno de desarrollo rápido para interfaces de acceso y edición de datos. Sin embargo, el uso de herramientas de desarrollo de bajo código no siempre está asociado con la creación de aplicaciones específicas en un stack tecnológico comercial con una clara dependencia del proveedor.
Con las plataformas de low-code también se pueden organizar la orquestación de flujos de datos, crear espacios de ciencia de datos o, por ejemplo, módulos de verificación de calidad de datos.
Uno de los ejemplos prácticos de la experiencia en el uso de herramientas de desarrollo de bajo código es la colaboración entre "Neoflex" y la empresa Mediascope, uno de los líderes del mercado ruso en investigaciones de medios. Una de las tareas comerciales de esta empresa es la producción de datos, sobre la base de los cuales los anunciantes, plataformas en Internet, canales de televisión, estaciones de radio, agencias de publicidad y marcas toman decisiones sobre la compra de publicidad y planifican sus comunicaciones de marketing.
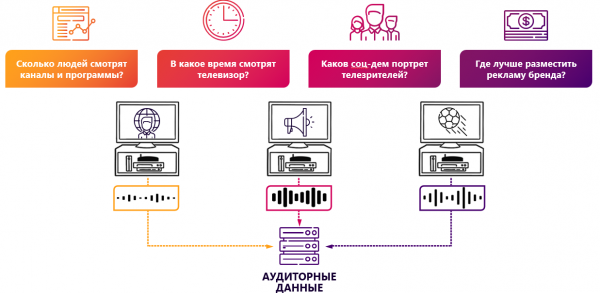
Las investigaciones de medios son un campo de negocio tecnológicamente exigente. El reconocimiento de secuencias de video, la recopilación de datos de dispositivos que analizan visualizaciones, la medición de la actividad en recursos web: todo esto implica que la empresa tenga un gran personal de TI y una enorme experiencia en la construcción de soluciones analíticas. Pero el crecimiento exponencial de la cantidad de información y la diversidad de sus fuentes obliga a la industria de TI de datos a progresar constantemente. La solución más simple para escalar la plataforma analítica de Mediascope que ya funciona podría haber sido aumentar el personal de TI. Pero una solución mucho más eficiente es acelerar el proceso de desarrollo. Uno de los pasos que llevan en esta dirección puede ser la aplicación de plataformas de low-code.
Al momento del inicio del proyecto, la empresa ya contaba con una solución de producto funcional. Sin embargo, la implementación de la solución en MSSQL no podía cumplir completamente con las expectativas de escalabilidad de funcionalidades, manteniendo un costo aceptable de desarrollo.
La tarea que teníamos ante nosotros era verdaderamente ambiciosa: Neoflex y Mediascope debían crear una solución industrial en menos de un año, con un MVP listo durante el primer trimestre desde el inicio del trabajo.
Como base para construir la nueva plataforma de datos, basada en cálculos low-code, se eligió la pila de tecnologías Hadoop. El estándar de almacenamiento de datos fue HDFS utilizando archivos en formato parquet. Para acceder a los datos en la plataforma, se utilizó Hive, donde todas las vitrinas disponibles se presentan en forma de tablas externas. La carga de datos en el almacenamiento se realizaba con la ayuda de Kafka y Apache NiFi.
La herramienta low-code en este concepto se aplicó para optimizar la tarea más laboriosa en la construcción de la plataforma analítica: el cálculo de datos.
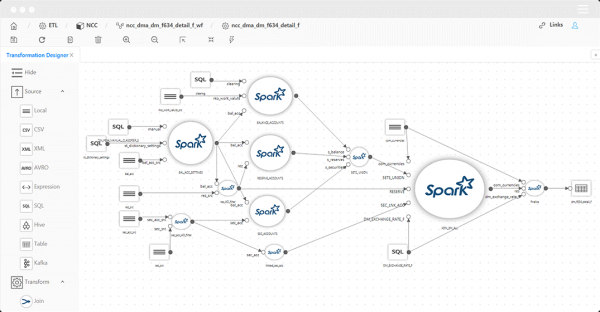
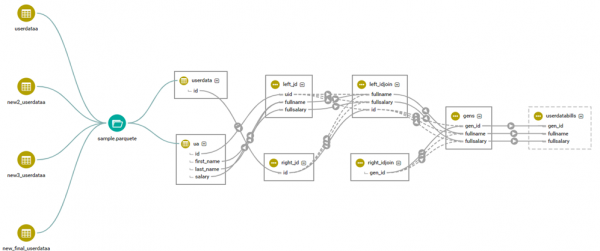
El mecanismo principal para mapear datos fue la herramienta low-code Datagram. Neoflex Datagram es una herramienta para desarrollar transformaciones y flujos de datos.
Al utilizar esta herramienta, se puede prescindir de escribir código en Scala "manualmente". El código de Scala se genera automáticamente utilizando el enfoque de Model Driven Architecture.
Una ventaja evidente de este enfoque es la aceleración del proceso de desarrollo. Sin embargo, además de la velocidad, hay otras ventajas:
- Visualización del contenido y la estructura de fuentes/receptores;
- Rastreo del origen de los objetos del flujo de datos hasta campos individuales (lineage);
- Ejecución parcial de transformaciones con visualización de resultados intermedios;
- Visualización del código fuente y su modificación antes de la ejecución;
- Validación automática de transformaciones;
- Carga automática de datos 1 a 1.
La barrera de entrada a las soluciones de low-code para la generación de transformaciones es relativamente baja: el desarrollador necesita saber SQL y tener experiencia con herramientas de ETL. Es importante aclarar que los generadores de transformaciones impulsados por código no son herramientas de ETL en el sentido amplio de la palabra. Las herramientas de low-code pueden no tener su propio entorno para ejecutar el código. Esto significa que el código generado se ejecutará en el entorno que ya existía en el clúster antes de la instalación de la solución de low-code. Y este es, quizás, otro punto a favor del low-code. Dado que en paralelo con el equipo de low-code puede trabajar un equipo 'clásico' que implemente la funcionalidad, por ejemplo, en código Scala puro. La incorporación de mejoras de ambos equipos a producción será simple y 'sin costuras'.
Vale la pena mencionar que además del low-code, también existen soluciones no-code. Y en esencia, son cosas diferentes. El low-code permite en mayor medida que el desarrollador intervenga en el código generado. En el caso de Datagram, es posible visualizar y editar el código Scala generado, mientras que en no-code esta posibilidad puede no estar disponible. Esta diferencia es bastante significativa no solo en términos de flexibilidad de la solución, sino también en cuanto a la comodidad y la motivación en el trabajo de los ingenieros de datos.
Arquitectura de la solución
Intentemos entender cómo exactamente una herramienta de low-code ayuda a resolver el problema de optimizar la velocidad de desarrollo de la funcionalidad de cálculo de datos. Primero, analicemos la arquitectura funcional del sistema. En este caso, se toma como ejemplo el modelo de producción de datos para investigaciones mediáticas.
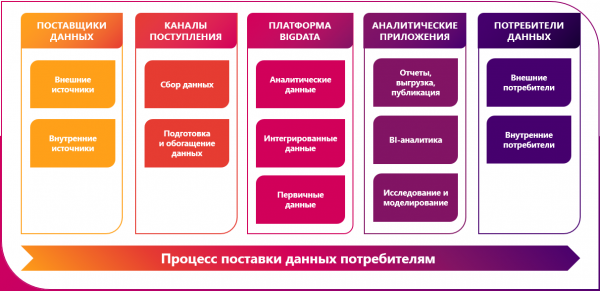
Las fuentes de datos en nuestro caso son bastante diversas y variadas:
- Los Peoplemeters (medidores de TV) son dispositivos de hardware y software que registran el comportamiento del usuario en los encuestados de un panel de televisión: quién, cuándo y qué canal de televisión se vio en el hogar que participa en la investigación. La información suministrada es un flujo de intervalos de visualización de la transmisión, vinculado al paquete de medios y al producto mediático. Los datos en la etapa de carga en el Data Lake pueden enriquecerse con atributos demográficos, vinculaciones a estrategias geográficas, zona horaria y otra información necesaria para analizar la audiencia de un determinado producto mediático. Las mediciones realizadas pueden ser utilizadas para el análisis o la planificación de campañas publicitarias, la evaluación de la actividad y las preferencias de la audiencia, y la elaboración de la programación de emisiones;
- Los datos pueden provenir de sistemas de monitoreo de transmisión de televisión en streaming y de la medición de visualización de contenido en recursos de video en Internet;
- Herramientas de medición en el entorno web, que incluyen tanto contadores centrados en el sitio como centrados en el usuario. Un complemento del navegador research bar y una aplicación móvil integrada pueden servir como proveedor de datos para el Data Lake; VPN.
- Los datos también pueden provenir de plataformas que consolidan los resultados de encuestas en línea y los resultados de entrevistas telefónicas en investigaciones de encuestas de la empresa;
- El enriquecimiento adicional del lago de datos puede llevarse a cabo a través de la carga de información de registros de empresas asociadas.
La implementación de carga as is desde sistemas fuente a staging primario de datos en crudo puede ser organizada de diversas maneras. En caso de utilizar low-code para estos fines, es posible la generación automática de scripts de carga basada en metadatos. Al mismo tiempo, no es necesario descender al nivel de desarrollo de mapeos de source a target. Para llevar a cabo la carga automática, necesitamos establecer una conexión con la fuente, después de lo cual definimos en la interfaz de carga la lista de entidades a ser cargadas. La creación de la estructura de directorios en HDFS se realizará automáticamente y corresponderá a la estructura de almacenamiento de datos en el sistema fuente.
Sin embargo, en el contexto de este proyecto, decidimos no utilizar esta capacidad de las plataformas low-code, debido a que la empresa Mediascope ya había comenzado a trabajar en la creación de un servicio similar utilizando la combinación de Nifi + Kafka.
Es importante señalar de inmediato que estas herramientas no son sustitutos entre sí, sino que se complementan entre ellas. Nifi y Kafka pueden funcionar en ambos sentidos (Nifi -> Kafka) y (Kafka -> Nifi). Para la plataforma de investigación de medios se utilizó la primera opción de conexión.
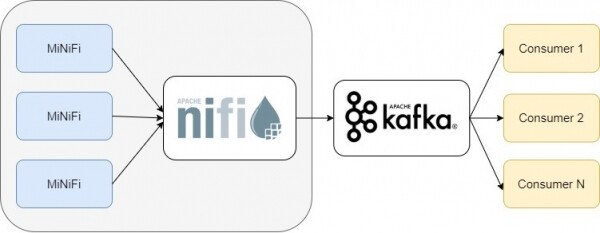
En nuestro caso, Nifi necesitaba procesar diferentes tipos de datos de sistemas de origen y enviarlos al broker Kafka. La dirección de los mensajes a un tópico específico de Kafka se hacía mediante la aplicación de los procesadores PublishKafka de Nifi. La orquestación y el mantenimiento de estas canalizaciones se realiza en una interfaz visual. La herramienta Nifi y el uso de la combinación Nifi + Kafka también se pueden considerar un enfoque de low-code para el desarrollo, con una baja barrera de entrada a las tecnologías Big Data y que acelera el proceso de desarrollo de aplicaciones.
La siguiente etapa en la implementación del proyecto fue llevar a cabo la conversión al formato de una capa semántica unificada de datos detallados. En caso de que una entidad tenga atributos históricos, el cálculo se realiza en el contexto de la partición considerada. Si la entidad no es histórica, se puede optar por recalcular todo el contenido del objeto o renunciar completamente al recalculo de este objeto (debido a la ausencia de cambios). En esta etapa se generan las claves para todas las entidades. Las claves se almacenan en los registros correspondientes de los master-objetos Hbase, que contienen la correspondencia entre las claves en la plataforma analítica y las claves de los sistemas de origen. La consolidación de las entidades atómicas se acompaña de un enriquecimiento con los resultados del cálculo preliminar de datos analíticos. El framework utilizado para el cálculo de datos fue Spark. La funcionalidad descrita para llevar los datos a una semántica unificada también se implementó con base en los mapeos de la herramienta de low-code Datagram.
En la arquitectura objetivo, se requería asegurar el acceso SQL a los datos para los usuarios comerciales. Para esta opción se utilizó Hive. El registro de objetos en Hive se realiza automáticamente al activar la opción 'Registr Hive Table' en la herramienta de low-code.
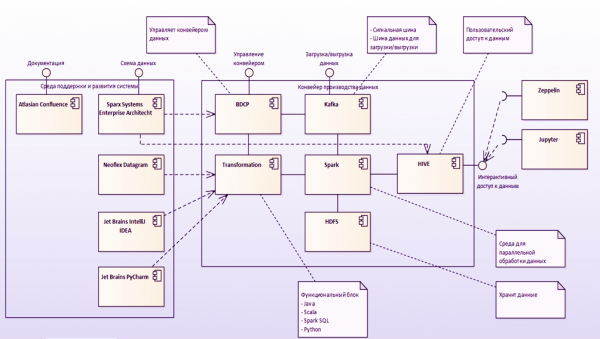
Gestión del flujo de cálculo
Datagram tiene una interfaz para diseñar flujos de trabajo. Los mapeos pueden ser ejecutados utilizando el programador Oozie. En la interfaz del desarrollador de flujos, es posible crear esquemas de transformaciones de datos en paralelo, secuencialmente o en función de condiciones dadas. Hay soporte para scripts de shell y programas en Java. También es posible usar servidores Apache Livy. Apache Livy se utiliza para ejecutar aplicaciones directamente desde el entorno de desarrollo.
En caso de que la empresa ya cuente con su propio orquestador de procesos, es posible utilizar la API REST para integrar mapeos en el flujo existente. Por ejemplo, hemos tenido una experiencia bastante exitosa integrando mapeos en Scala en orquestadores escritos en PLSQL y Kotlin. La API REST de la herramienta de bajo código implica operaciones como la generación de un año ejecutable basado en el diseño del mapeo, invocación del mapeo, invocación de una secuencia de mapeos y, por supuesto, la transmisión de parámetros en la URL para iniciar los mapeos.
Junto con Oozie, es posible organizar el flujo de cálculo utilizando Airflow. No me detendré mucho en la comparación entre Oozie y Airflow, simplemente diré que en el contexto de trabajos del proyecto de investigaciones en medios, la elección se incluyó hacia Airflow. Los principales argumentos en esta ocasión fueron una comunidad más activa que desarrolla el producto y una interfaz + API más desarrolladas.
Airflow también es excelente porque para describir los procesos de cálculo, se utiliza el popular Python. Y en general, no hay tantas plataformas de gestión de flujos de trabajo de código abierto. La ejecución y monitoreo de procesos (incluyendo diagramas de Gantt) solo suman puntos a la reputación de Airflow.
El formato del archivo de configuración para ejecutar mapeos de la solución de bajo código se convirtió en spark-submit. Esto sucedió por dos razones. Primero, spark-submit permite iniciar directamente un archivo jar desde la consola. Segundo, puede contener toda la información necesaria para configurar el flujo de trabajo (lo que facilita la escritura de scripts que forman el Dag).
El elemento más común del flujo de trabajo de Airflow en nuestro caso fue SparkSubmitOperator.
SparkSubmitOperator permite ejecutar archivos jar: mapeos empaquetados de Datagram con parámetros de entrada previamente definidos.
Es importante mencionar que cada tarea de Airflow se ejecuta en un hilo separado y no tiene conocimiento de otras tareas. Por lo tanto, la interacción entre tareas se lleva a cabo mediante operadores de control, como DummyOperator o BranchPythonOperator.
La combinación del uso de la solución low-code Datagram con la universalización de archivos de configuración (que forman Dag) ha llevado a una aceleración y simplificación significativa del proceso de desarrollo de flujos de carga de datos.
Cálculo de vitrinas
Probablemente, la etapa más intensiva en recursos intelectuales en la producción de datos analíticos es el paso de construcción de vitrinas. En el contexto de uno de los flujos de cálculo de datos de una empresa de investigación, en esta etapa se lleva a cabo una conversión a la transmisión estándar teniendo en cuenta la corrección de zonas horarias vinculada a la red de emisión. También es posible realizar ajustes para la red local de emisión (noticias y publicidad locales). Entre otras cosas, en este paso se lleva a cabo la segmentación de intervalos de visualización continua de productos mediáticos basándose en el análisis de los intervalos de visualización. Aquí también se lleva a cabo la "ponderación" de los valores de visualización en función de la información sobre su relevancia (cálculo del coeficiente de corrección).
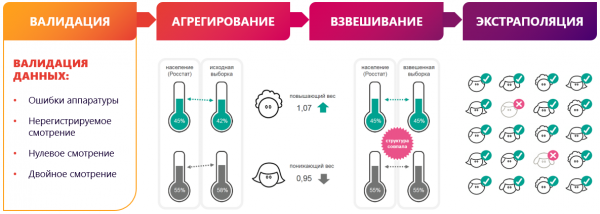
Un paso separado en la preparación de vitrinas es la validación de datos. El algoritmo de validación está relacionado con la aplicación de una serie de modelos matemáticos de ciencia. Sin embargo, el uso de una plataforma low-code permite descomponer el algoritmo complejo en una serie de mapeos visualmente legibles. Cada uno de estos mapeos realiza una tarea específica. Como resultado, es posible realizar una depuración intermedia, registro y visualización de las etapas de preparación de datos.
Se decidió discretizar el algoritmo de validación en los siguientes subtareas:
- Construcción de regresiones de dependencia de la visualización de la red de televisión en la región con respecto a la visualización de todas las redes en la región durante 60 días.
- Cálculo de los residuos estandarizados (desviaciones de los valores reales de los predichos por el modelo de regresión) para todos los puntos de regresión y para el día de cálculo.
- Muestreo de pares anómalos región-red de televisión, donde el residuo estandarizado del día de cálculo supera la norma (definida por la configuración de la operación).
- El recálculo del residuo estandarizado corregido para pares anómalos región-red de televisión para cada encuestado que vio la red en la región con la determinación de la contribución de dicho encuestado (cantidad de cambio del residuo estandarizado) al excluir la visualización de dicho encuestado de la muestra.
- Búsqueda de candidatos cuya exclusión lleva el residuo estandarizado del día de cálculo a la norma.
El ejemplo anterior es una confirmación de la hipótesis de que un ingeniero de datos ya tiene demasiado en mente... Y, si realmente es un 'ingeniero' y no un 'programador', entonces el miedo a la degradación profesional por el uso de herramientas low-code debería desvanecerse por completo.
¿Qué más puede hacer low-code?
El ámbito de aplicación de la herramienta low-code para el procesamiento por lotes y en stream de datos sin la necesidad de escribir código en Scala manualmente no termina aquí.
La aplicación de low-code en el desarrollo de datalakes ya se ha convertido en un estándar para nosotros. Probablemente se puede decir que las soluciones en el stack de Hadoop siguen el camino de desarrollo de los DWH clásicos basados en RDBMS. Las herramientas low-code en el stack de Hadoop pueden abordar tanto tareas de procesamiento de datos como la construcción de interfaces BI finales. Cabe destacar que bajo BI se puede entender no solo la representación de datos, sino también su edición por parte de usuarios de negocio. Esta funcionalidad la utilizamos con frecuencia en la construcción de plataformas analíticas para el sector financiero.
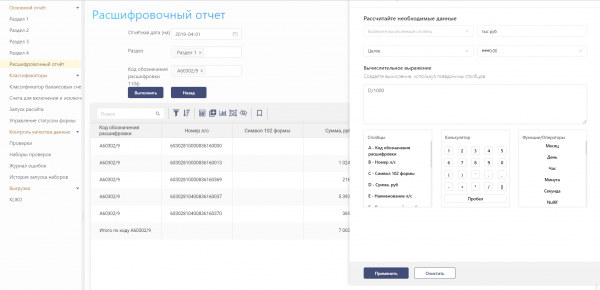
Entre otras cosas, con low-code y, en particular, Datagram, es posible resolver la tarea de rastrear el origen de los objetos de flujo de datos con atomicidad hasta campos individuales (lineage). Para ello, en la herramienta low-code se ha implementado la conexión con Apache Atlas y Cloudera Navigator. En esencia, el desarrollador debe registrar un conjunto de objetos en los diccionarios de Atlas y hacer referencia a los objetos registrados al crear mapeos. El mecanismo de rastreo del origen de los datos o análisis de dependencias de los objetos ahorra mucho tiempo al realizar modificaciones en los algoritmos de cálculo. Por ejemplo, al construir informes financieros, esta característica permite afrontar de manera más cómoda el período de cambios legislativos. Cuanto mejor comprendamos la dependencia inter-formal en los objetos del nivel detallado, menos nos enfrentaremos a defectos 'sorpresa' y reduciremos el número de retrabajos.
Calidad de Datos y Low-code
Otra tarea implementada por la herramienta low-code en el proyecto de la empresa Mediascope fue la de Calidad de Datos. Una característica del proceso de verificación de datos para el proyecto de la empresa de investigación fue la ausencia de impacto en la operatividad y velocidad del flujo principal de cálculo de datos. Para orquestar flujos independientes de verificación de datos, se utilizó el ya conocido Apache Airflow. A medida que cada paso en la producción de datos estaba listo, se lanzó simultáneamente una parte aislada del proceso DQ.
Se considera una buena práctica monitorear la calidad de los datos desde su creación en la plataforma analítica. Al tener información sobre los metadatos, ya podemos verificar el cumplimiento de las condiciones básicas — not null, constraints, foreign keys — desde el momento en que la información llega a la capa primaria. Esta funcionalidad se implementó sobre la base de mapeos generados automáticamente de la familia de calidad de datos en Datagram. La generación de código en este caso también se basa en los metadatos del modelo. En el proyecto de la empresa Mediascope, la conexión se realizó con los metadatos del producto Enterprise Architect.
Gracias a la conexión entre la herramienta low-code y Enterprise Architect, se generaron automáticamente las siguientes verificaciones:
- Verificación de la presencia de valores 'null' en campos con el modificador 'not null';
- Verificación de la presencia de duplicados en la clave primaria;
- Verificación de clave externa de la entidad;
- Verificación de la unicidad de la fila según un conjunto de campos.
Para realizar verificaciones más complejas de disponibilidad y validez de los datos, se creó un mapeo con Scala Expression que toma como entrada el código de verificación de Spark SQL, preparado por los analistas en Zeppelin.
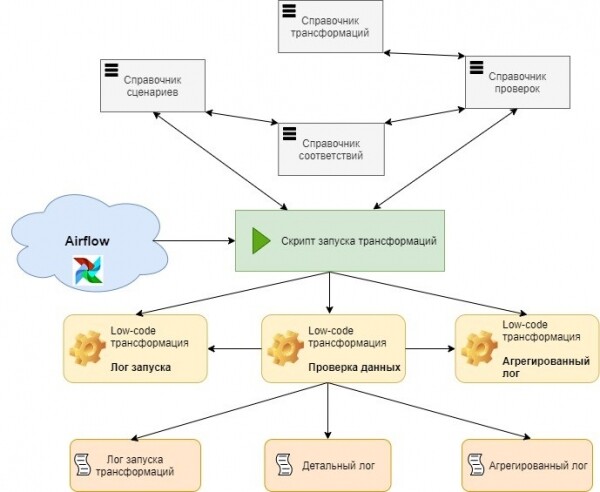
Por supuesto, la autogeneración de verificaciones debe abordarse de manera gradual. En el marco del proyecto descrito, se llevaron a cabo los siguientes pasos:
- DQ, implementados en notas de Zeppelin;
- DQ, integrados en el mapeo;
- DQ en forma de mapeos masivos separados, que contienen un conjunto completo de verificaciones por cada entidad;
- Mapeos DQ universales parametrizados que toman como entrada información sobre metadatos y verificaciones de negocios.
Probablemente, la principal ventaja de crear un servicio de verificaciones parametrizadas es la reducción del tiempo de entrega de funcionalidad al entorno de producción. Nuevas verificaciones de calidad pueden eludir el patrón clásico de entrega de código a través de entornos de desarrollo y pruebas:
- Todas las verificaciones de metadatos se generan automáticamente al modificar el modelo en EA;
- Las verificaciones de disponibilidad de datos (definición de la existencia de algún dato en un momento dado) pueden generarse a partir de un directorio que almacena el tiempo esperado de aparición del siguiente conjunto de datos por objeto;
- Las verificaciones de negocio sobre la validez de los datos son creadas por los analistas en notas de Zeppelin. Desde ahí, se envían directamente a las tablas de configuración del módulo DQ en el entorno de producción.
Los riesgos de descargar scripts directamente en producción son prácticamente inexistentes. Incluso en caso de un error de síntaxis, lo máximo que podemos enfrentar es la no ejecución de una verificación, ya que el flujo de cálculo de datos y el flujo de ejecución de las verificaciones de calidad están separados entre sí.
De hecho, el servicio DQ está permanentemente en funcionamiento en el entorno de producción y está listo para comenzar su trabajo en el momento en que aparece el siguiente conjunto de datos.
En conclusión
La ventaja de utilizar low-code es evidente. Los desarrolladores no necesitan crear una aplicación "desde cero". Y un programador liberado de tareas adicionales produce resultados más rápido. La rapidez, a su vez, libera tiempo adicional para abordar cuestiones de optimización. Por lo tanto, en este caso, se puede esperar una solución de mejor calidad y más rápida.
Por supuesto, el low-code no es una panacea, y la magia no sucederá por sí sola:
- La industria del low-code está pasando por una etapa de "maduración", y todavía no hay estándares industriales homogéneos;
- Muchas soluciones low-code no son gratuitas, y su adquisición debe ser un paso consciente, que debe darse con plena confianza en el beneficio financiero de su uso;
- Muchas soluciones low-code no siempre se llevan bien con GIT / SVN. O son incómodas de usar en caso de ocultar el código generado;
- Al ampliar la arquitectura, puede ser necesario ajustar la solución low-code, lo que, a su vez, provoca el efecto de "dependencia" del proveedor de la solución low-code.
- Un adecuado nivel de seguridad es posible, pero es muy laborioso y complejo de implementar en motores de sistemas low-code. Las plataformas de low-code deben ser elegidas no solo por el principio de buscar beneficios de su uso. Al elegir, es recomendable preguntarse sobre la existencia de funcionalidades de gestión de accesos y delegación/escalado de datos de identificación a través de todo el paisaje IT de la organización.
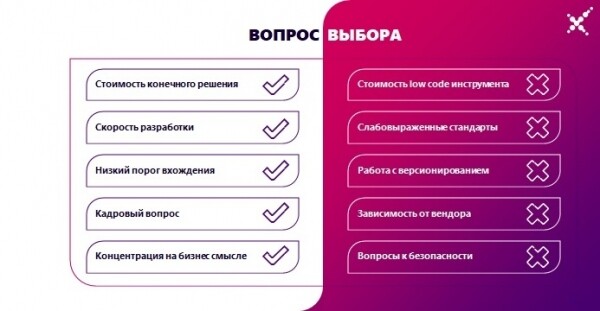
Sin embargo, si conoces todas las desventajas del sistema elegido y, aun así, los beneficios de su uso son predominantemente mayores, entonces avanza hacia el low-code sin miedo. Sobre todo, dado que la transición a él es inevitable, al igual que cualquier evolución.
Si un desarrollador en una plataforma low-code puede realizar su trabajo más rápido que dos desarrolladores sin low-code, eso le da a la empresa una ventaja en todos los aspectos. La barrera de entrada a las soluciones low-code es más baja que en las tecnologías "tradicionales", lo que tiene un impacto positivo en la cuestión de la escasez de talento. Al utilizar herramientas de bajo código, se puede acelerar la interacción entre equipos funcionales y tomar decisiones más rápidamente sobre la idoneidad del camino elegido en las investigaciones de ciencia de datos. Las plataformas de bajo nivel pueden ser el motor de la transformación digital de la organización, ya que las soluciones producidas pueden entenderse fácilmente por los no especialistas en tecnología (en particular, los usuarios de negocio).
Si tiene plazos ajustados, una lógica de negocio compleja, escasez de experiencia tecnológica, y necesita acelerar el tiempo de lanzamiento al mercado, entonces el low-code es una de las maneras de satisfacer sus necesidades.
No se puede negar la importancia de las herramientas tradicionales de desarrollo, sin embargo, en muchos casos, el uso de soluciones de bajo código es la mejor manera de aumentar la eficiencia en la resolución de problemas.
Fuente: habr.com
