

Cada vez más, recibimos solicitudes de clientes como: "Queremos algo como Amazon RDS, pero más barato"; "Queremos algo como RDS, pero en todas partes, en cualquier infraestructura". Para implementar una solución gestionada similar en Kubernetes, analizamos el estado actual de los operadores más populares para PostgreSQL (Stolon, operadores de Crunchy Data y Zalando) y tomamos nuestra decisión.
Este artículo presenta nuestra experiencia desde un punto de vista teórico (una revisión de soluciones) y práctico (lo que se eligió y qué resultado se obtuvo). Pero primero, definamos qué requisitos se exigen para un posible reemplazo de RDS...
¿Qué es RDS?
Cuando la gente habla de RDS, según nuestra experiencia, se refieren a un servicio gestionado (managed) de base de datos que:
- es fácil de configurar;
- tiene la capacidad de trabajar con instantáneas y restaurarse a partir de ellas (preferentemente, con soporte para );
- permite crear topologías master-slave;
- tiene una rica lista de extensiones;
- proporciona auditoría y gestión de usuarios/accesos.
En términos generales, los enfoques para implementar la tarea planteada pueden ser muy diversos, sin embargo, la opción con un Ansible condicional no nos resulta cercana. (Llegaron a una conclusión similar nuestros colegas de 2GIS como resultado de de crear "una herramienta para la rápida implementación de un clúster redundante basado en Postgres".)
Precisamente los operadores son el enfoque común para solucionar tareas semejantes en el ecosistema de Kubernetes. Ya se ha hablado de ellos en cuanto a bases de datos ejecutadas dentro de Kubernetes, por el director técnico de "Flanta", , en .
NB: Para crear rápidamente operadores sencillos, recomendamos prestar atención a nuestra herramienta de código abierto . Usándola, se puede hacer sin conocimientos de Go, de manera más familiar para los administradores de sistemas: en Bash, Python, etc.
Existen varios operadores K8s populares para PostgreSQL:
- Stolon;
- Crunchy Data PostgreSQL Operator;
- Zalando Postgres Operator.
Miremos más de cerca.
Selección de un operador
Además de las importantes capacidades que ya se mencionaron, nosotros, como ingenieros de infraestructura en Kubernetes, también esperábamos de los operadores lo siguiente:
- despliegue desde Git y con ;
- soporte para anti-afinidad de pods;
- instalación de afinidad de nodos o selector de nodo;
- instalación de tolerancias;
- existencia de capacidades de optimización;
- tecnologías comprensibles e incluso comandos.
Sin entrar en detalles sobre cada uno de los puntos (pueden preguntar en los comentarios si quedan dudas sobre ellos después de leer todo el artículo), señalaré en general que estos parámetros son necesarios para una descripción más precisa de la especialización de los nodos del clúster, con el fin de encargarlos para aplicaciones específicas. Así podemos lograr un equilibrio óptimo en cuestiones de rendimiento y costo.
Ahora, pasemos a los propios operadores de PostgreSQL.
1. Stolon
de la empresa italiana Sorint.lab en fue considerado como un tipo de referencia entre los operadores para bases de datos. Es un proyecto bastante antiguo: su primera publicación pública fue en noviembre de 2015(!), y el repositorio de GitHub cuenta con casi 3000 estrellas y más de 40 colaboradores.
Y de hecho, Stolon es un excelente ejemplo de una arquitectura bien pensada:
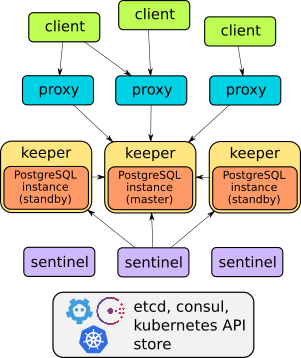
Puedes conocer los detalles de este operador en el informe o . En general, basta con decir que puede hacer todo lo descrito: failover, un proxy para acceso transparente de clientes, copias de seguridad... Además, el proxy proporciona acceso a través de un único endpoint de servicio, a diferencia de otras dos soluciones que se describen a continuación (ellas tienen dos servicios para acceder a la base).
Sin embargo, Stolon , lo que hace que no se pueda desplegar tan fácil y rápidamente — "como pan caliente" — crear instancias de bases de datos en Kubernetes. La gestión se realiza a través de la utilidad stolonctl, el despliegue — a través de Helm chart, y se definen variables de usuario en ConfigMap.
Por un lado, resulta que el operador no es realmente un operador (ya que no utiliza CRD). Pero por otro lado, es un sistema flexible que permite configurar recursos en K8s de la manera que te resulte conveniente.
Resumiendo, para nosotros no parecía óptimo tener un chart separado para cada base de datos. Por lo tanto, comenzamos a buscar alternativas.
2. Crunchy Data PostgreSQL Operator
, una joven startup estadounidense, parecía una alternativa lógica. Su historia pública comienza con el primer lanzamiento en marzo de 2017, desde entonces el repositorio de GitHub ha recibido poco menos de 1300 estrellas y más de 50 colaboradores. La última versión de septiembre fue probada para trabajar con Kubernetes 1.15-1.18, OpenShift 3.11+ y 4.4+, GKE y VMware Enterprise PKS 1.3+.
La arquitectura del Crunchy Data PostgreSQL Operator también cumple con los requisitos declarados:
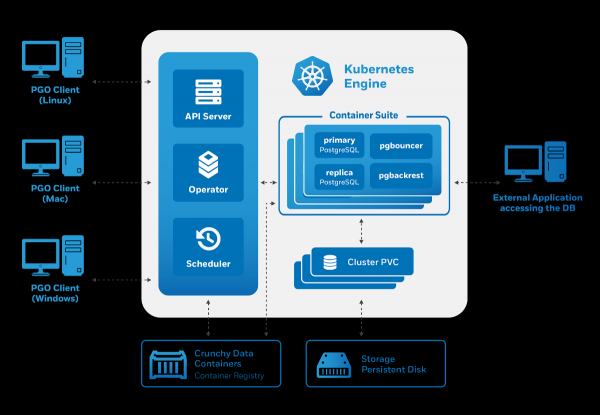
La gestión se realiza a través de la utilidad pgo, sin embargo, es responsable de generar Recursos Personalizados para Kubernetes. Por lo tanto, como potenciales usuarios, el operador nos alegró:
- hay gestión a través de CRD;
- gestión conveniente de usuarios (también a través de CRD);
- integración con otros componentes — una colección especializada de imágenes de contenedores para PostgreSQL y herramientas relacionadas (incluyendo pgBackRest, pgAudit, extensiones de contrib y más).
Sin embargo, los intentos de comenzar a usar el operador de Crunchy Data revelaron varios problemas:
- No había posibilidad de toleraciones — solo se preveía nodeSelector.
- Los pods creados eran parte de un Deployment, a pesar de que estábamos implementando una aplicación stateful. A diferencia de StatefulSet, los Deployments no pueden crear discos.
La última desventaja lleva a momentos peculiares: en el entorno de prueba logramos lanzar 3 réplicas con un solo disco almacenamiento local, lo que hizo que el operador informara que 3 réplicas estaban funcionando (aunque no era así).
Otra característica de este operador es su integración lista con varios sistemas auxiliares. Por ejemplo, es fácil instalar pgAdmin y pgBounce, y en se consideran Grafana y Prometheus preconfigurados. En el reciente se destaca una mejor integración con el proyecto , gracias a lo cual el operador ofrece una visualización clara de métricas de PgSQL 'listo para usar'.
Sin embargo, la extraña elección de recursos generados por Kubernetes nos llevó a la necesidad de encontrar otra solución.
3. Zalando Postgres Operator
Conocemos los productos de Zalando desde hace tiempo: tenemos experiencia con Zalenium y, por supuesto, hemos probado — su popular solución HA para PostgreSQL. Acerca del enfoque de la empresa para crear habló uno de sus autores — Alexey Klyukin — en la transmisión , y nos gustó.
Esta es la solución más joven de las analizadas en el artículo: la primera versión se lanzó en agosto de 2018. Sin embargo, a pesar de la pequeña cantidad de lanzamientos formales, el proyecto ha recorrido un largo camino, ya superando en popularidad a la solución de Crunchy Data con más de 1300 estrellas en GitHub y el mayor número de contribuyentes (más de 70).
‘Bajo el capó’ de este operador se utilizan soluciones probadas por el tiempo:
- Patroni y para la gestión,
- — para copias de seguridad,
- — como un pool de conexiones.
Así es como se presenta la arquitectura del operador de Zalando:
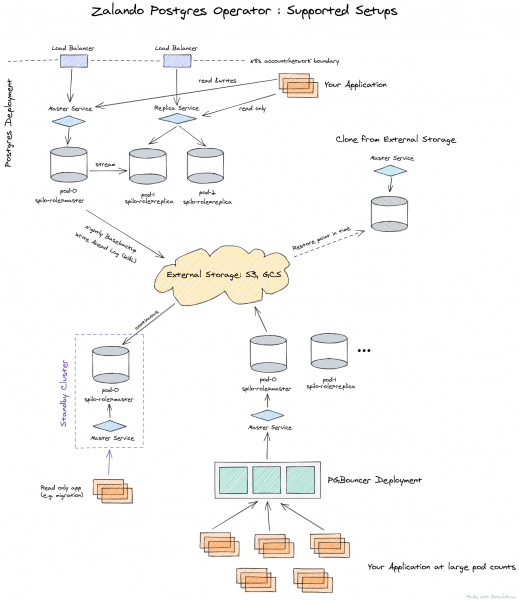
El operador se gestiona completamente a través de Recursos Personalizados, creando automáticamente un StatefulSet a partir de contenedores que luego se pueden personalizar añadiendo diversos sidecars al pod. Todo esto es una ventaja significativa en comparación con el operador de Crunchy Data.
Dado que elegimos la solución de Zalando entre las 3 opciones consideradas, a continuación se presentará una descripción de sus capacidades junto con ejemplos de uso.
Práctica con el Postgres Operator de Zalando
El despliegue del operador es muy sencillo: basta con descargar la versión actual desde GitHub y aplicar los archivos YAML de la carpeta. . Como alternativa, también se puede utilizar .
Después de la instalación, es importante preocuparse por la configuración . Se realiza a través de ConfigMap postgres-operator en el espacio de nombres donde se instaló el operador. Una vez que los almacenes están configurados, se puede desplegar el primer clúster de PostgreSQL.
Por ejemplo, nuestro despliegue estándar se ve de la siguiente manera:
apiVersion: acid.zalan.do/v1
kind: postgresql
metadata:
 name: staging-db
spec:
 numberOfInstances: 3
 patroni:
   synchronous_mode: true
 postgresql:
   version: "12"
 resources:
   limits:
     cpu: 100m
     memory: 1Gi
   requests:
     cpu: 100m
     memory: 1Gi
 sidecars:
 - env:
   - name: DATA_SOURCE_URI
     value: 127.0.0.1:5432
   - name: DATA_SOURCE_PASS
     valueFrom:
       secretKeyRef:
         key: password
         name: postgres.staging-db.credentials
   - name: DATA_SOURCE_USER
     value: postgres
   image: wrouesnel/postgres_exporter
   name: prometheus-exporter
   resources:
     limits:
       cpu: 500m
       memory: 100Mi
     requests:
       cpu: 100m
       memory: 100Mi
 teamId: staging
 volume:
   size: 2Gi
Este manifiesto despliega un clúster de 3 instancias con un sidecar en forma de , desde el cual recopilamos métricas de la aplicación. Como pueden ver, todo es muy simple, y si se desea, se puede crear literalmente un número ilimitado de clústeres.
También vale la pena prestar atención a la interfaz web para administración — . Se proporciona junto con el operador y permite crear y eliminar clústeres, así como gestionar las copias de seguridad que realiza el operador.
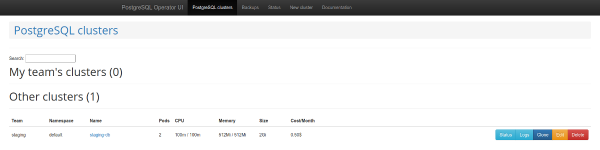
Lista de clústeres de PostgreSQL
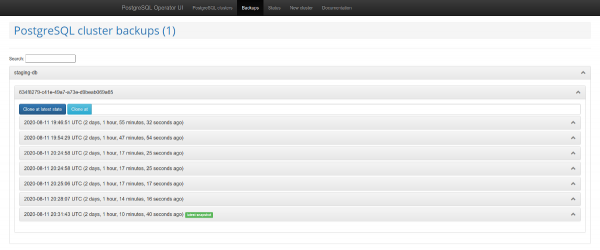
Gestión de copias de seguridad
Otra característica interesante es el soporte para . Este mecanismo crea automáticamente roles en PostgreSQL, basándose en la lista de nombres de usuarios recibida. Después de esto, la API permite devolver la lista de usuarios para quienes se crean roles automáticamente.
Problemas y sus soluciones
Sin embargo, el uso del operador pronto reveló varias desventajas significativas:
- falta de soporte para nodeSelector.
- imposibilidad de desactivar las copias de seguridad;
- al utilizar la función de creación de bases no aparecen privilegios por defecto;
- periódicamente falta documentación o esta se encuentra desactualizada.
Afortunadamente, muchos de estos problemas pueden resolverse. Comencemos por el final: problemas con documentación.
Es probable que te enfrentes a que no siempre está claro cómo definir la copia de seguridad y cómo conectar el bucket de respaldo a la interfaz de usuario de Operator. Esto se menciona de manera superficial en la documentación, y la descripción real se encuentra en :
- hay que crear un secreto;
- para pasárselo al operador como un parámetro
pod_environment_secret_nameen la CRD con la configuración del operador o en ConfigMap (dependiendo de cómo decidieras instalar el operador).
Sin embargo, como resultó ser, en este momento es imposible. Es por eso que hemos reunido con algunos desarrollos adicionales de terceros. Más detalles sobre ello — ver abajo.
Si se le pasan al operador parámetros para la copia de seguridad, concretamente — wal_s3_bucket y las claves de acceso en AWS S3, entonces él realizará copias de seguridad de todo: no solo las bases en producción, sino también las de staging. Eso no nos satisfizo.
En la descripción de los parámetros para Spilo, que es la envoltura básica de Docker para PgSQL al usar el operador, se descubrió: se puede pasar el parámetro WAL_S3_BUCKET vacío, desactivando así las copias de seguridad. Además, para nuestra gran alegría, también se encontró un , que de inmediato aceptamos en nuestro fork. Ahora solo es necesario agregar enableWALArchiving: false al recurso del clúster de PostgreSQL.
Sí, había la opción de hacerlo de otra manera, ejecutando 2 operadores: uno para staging (sin copias de seguridad) y el otro — para producción. Pero así pudimos manejarlo con uno solo.
Está bien, aprendimos a dar acceso a las bases para S3 y las copias de seguridad empezaron a llegar al almacenamiento. ¿Cómo hacer que las páginas de copias de seguridad funcionen en la interfaz de usuario de Operator?
En la interfaz de usuario de Operator será necesario agregar 3 variables:
-
SPILO_S3_BACKUP_BUCKET -
AWS_ACCESS_KEY_ID -
AWS_SECRET_ACCESS_KEY
Después de esto, la gestión de copias de seguridad estará disponible, lo que en nuestro caso simplificará el trabajo con staging, permitiendo entregar allí instantáneas de producción sin scripts adicionales.
Como otra ventaja se mencionó el trabajo con la API de Teams y amplias posibilidades para crear bases y roles mediante el operador. Sin embargo, los roles creados no tenían derechos por defecto. En consecuencia, un usuario con derechos de lectura no podía leer nuevas tablas.
¿Por qué es así? A pesar de que en el código son necesarios GRANT, no se aplican siempre. Hay 2 métodos: syncPreparedDatabases y syncDatabases. Hay syncPreparedDatabases — a pesar de que en la sección preparedDatabases hay una condición defaultRoles y defaultUsers para la creación de roles, — los permisos por defecto no se aplican. Estamos en proceso de preparar un parche para que estos permisos se apliquen automáticamente.
Y el último punto en las mejoras relevantes para nosotros es , que añade Node Affinity al StatefulSet creado. Nuestros clientes a menudo prefieren reducir costos utilizando instancias spot, y no deberíamos alojar servicios de base de datos en ellas. Este problema se podría resolver también mediante tolerancias, pero la presencia de Node Affinity aporta una mayor certeza.
¿Qué se ha logrado?
Como resultado de la solución a los problemas mencionados, hemos bifurcado el Postgres Operator de Zalando en , donde se compila con parches tan útiles. Y para mayor comodidad, hemos recopilado .
La lista de PR aceptados en la bifurcación:
- ;
- ;
- ;
- .
Sería genial si la comunidad apoyara estos PR para que ingresen upstream con la próxima versión del operador (1.6).
¡Bonus! Historia de éxito con la migración de producción
Si usas Patroni, puedes migrar producción viva al operador con un tiempo de inactividad mínimo.
Spilo permite crear clústeres en standby a través de almacenamiento S3 con , cuando el registro binario de PgSQL se guarda primero en S3 y luego se descarga por la réplica. Pero, ¿qué hacer si tienes no Wal-E en una infraestructura antigua? La solución a este problema ya en Habr.
La replicación lógica de PostgreSQL viene al rescate. Sin embargo, no entraremos en detalles sobre cómo crear publicaciones y suscripciones, porque… nuestro plan fracasó.
El hecho es que había varias tablas con alta carga en la base de datos con millones de filas, que además, estaban siendo constantemente actualizadas y eliminadas. con copy_data, cuando una nueva réplica copia todo el contenido del maestro, simplemente no podía mantenerse al día con el maestro. La copia del contenido funcionó durante una semana, pero no alcanzó al maestro. Al final, resolver el problema fue posible gracias a compañeros de Avito: se puede transferir datos utilizando pg_dump. Voy a describir nuestra (ligeramente modificada) variante de este algoritmo.
La idea es crear una suscripción inactiva vinculada a un slot de replicación específico y luego corregir el número de transacción. Hubo réplicas disponibles para el trabajo de producción. Esto es importante porque la réplica ayudará a crear un volcado consistente y continuar recibiendo cambios del maestro.
En los siguientes comandos que describen el proceso de migración, se utilizarán las siguientes designaciones para los hosts:
- master — servidor de origen;
- replica1 — réplica en flujo en la antigua producción;
- replica2 — nueva réplica lógica.
Plan de migración
1. Crearemos en el maestro una suscripción para todas las tablas en el esquema public de la base de datos. dbname:
psql -h master -d dbname -c "CREATE PUBLICATION dbname FOR ALL TABLES;"
2. Crearemos un slot de replicación en el maestro:
psql -h master -c "select pg_create_logical_replication_slot('repl', 'pgoutput');"
3. Detendremos la replicación en la antigua réplica:
psql -h replica1 -c "select pg_wal_replay_pause();"
4. Obtendremos el número de transacción desde el maestro:
psql -h master -c "select replay_lsn from pg_stat_replication where client_addr = 'replica1';"
5. Haremos un volcado desde la antigua réplica. Haremos esto en varios hilos, lo que ayudará a acelerar el proceso:
pg_dump -h replica1 --no-publications --no-subscriptions -O -C -F d -j 8 -f dump/ dbname
6. Cargaremos el volcado en el nuevo servidor:
pg_restore -h replica2 -F d -j 8 -d dbname dump/
7. Después de cargar el volcado, se puede iniciar la replicación en la réplica en flujo:
psql -h replica1 -c "select pg_wal_replay_resume();"
7. Creamos la suscripción en la nueva réplica lógica:
psql -h replica2 -c "create subscription oldprod connection 'host=replica1 port=5432 user=postgres password=secret dbname=dbname' publication dbname with (enabled = false, create_slot = false, copy_data = false, slot_name='repl');"
8. Obtendremos oid la suscripción:
psql -h replica2 -d dbname -c "select oid, * from pg_subscription;"
9. Supongamos que se obtuvo oid=1000. Aplicaremos el número de transacción a la suscripción:
psql -h replica2 -d dbname -c "select pg_replication_origin_advance('pg_1000', 'AA/AAAAAAAA');"
10. Iniciaremos la replicación:
psql -h replica2 -d dbname -c "alter subscription oldprod enable;"
11. Comprobaremos el estado de la suscripción, la replicación debería estar funcionando:
psql -h replica2 -d dbname -c "select * from pg_replication_origin_status;"
psql -h master -d dbname -c "select slot_name, restart_lsn, confirmed_flush_lsn from pg_replication_slots;"
12. Después de que la replicación esté en marcha y las bases estén sincronizadas, se puede realizar el cambio.
13. Después de deshabilitar la replicación, será necesario corregir las secuencias. Esto está bien descrito .
Gracias a este plan, el cambio se realizó con mínimas demoras.
Conclusión
Los operadores de Kubernetes permiten simplificar diversas acciones, reduciéndolas a la creación de recursos de K8s. Sin embargo, tras lograr una asombrosa automatización mediante su uso, es importante recordar que puede acarrear una serie de matices inesperados, así que elige tus operadores sabiamente.
Tras considerar los tres operadores de Kubernetes más populares para PostgreSQL, decidimos optar por el proyecto de Zalando. Tuvimos que enfrentar ciertas dificultades, pero el resultado realmente nos satisfizo, por lo que planeamos expandir esta experiencia a otras instalaciones de PgSQL. Si tienes experiencia con soluciones similares, estaremos encantados de ver los detalles en los comentarios.
P.D.
También puedes leer en nuestro blog:
- «»;
- «»;
- «».
Fuente: habr.com
