

¡Hola, Habr!
En este artículo, hablaré sobre la generación de números pseudoaleatorios entre participantes que no confían entre sí. Como veremos a continuación, implementar un generador de números “casi” bueno es bastante simple, pero uno muy bueno es complicado.
¿Por qué es necesario generar números aleatorios entre participantes que no confían entre sí? Una de las áreas de aplicación es en las aplicaciones descentralizadas. Por ejemplo, una aplicación que acepta una apuesta de un participante y duplica la cantidad con una probabilidad del 49% o la retira con un 51%, solo funcionará si puede obtener un número aleatorio de manera imparcial. Si un atacante puede influir en el resultado del generador de números aleatorios, incluso de manera insignificante, aumentará su probabilidad de recibir un pago en la aplicación, lo que podría llevar a la vaciado de la misma.
Cuando desarrollamos un protocolo distribuido para la generación de números aleatorios, queremos que tenga tres propiedades:
Debe ser imparcial. En otras palabras, ningún participante debe influir en el resultado del generador de números aleatorios de ninguna manera.
Debe ser impredecible. En otras palabras, ningún participante debe ser capaz de anticipar qué número será generado (o deducir alguna de sus propiedades) antes de que sea generado.
El protocolo debe ser viable, es decir, resistente a que un porcentaje de los participantes se desconecte de la red o intente detener el protocolo de forma intencionada.
En este artículo, revisaremos dos enfoques: RANDAO + VDF y un enfoque basado en códigos borrables. En la siguiente parte, analizaremos a fondo el enfoque basado en firmas umbrales.
Pero primero, descompongamos un algoritmo simple y comúnmente utilizado, que es viable, impredecible, pero sesgado.
RANDAO
RANDAO es un enfoque muy simple y, por ende, bastante utilizado para obtener aleatoriedad. Todos los participantes de la red primero eligen un número pseudoaleatorio de forma local, luego cada participante envía el hash del número elegido. Después, los participantes revelan sus números seleccionados uno por uno y realizan una operación XOR sobre los números revelados, cuyo resultado se convierte en el resultado del protocolo.
El paso de publicar los hash antes de revelar los números es necesario para que un atacante no pueda elegir su número después de haber visto los números de los demás participantes. Esto le permitiría, de hecho, determinar de manera unilateral el resultado del generador de números aleatorios.
A lo largo del protocolo, los participantes deben llegar a un consenso dos veces (es decir, acuerdo): cuándo empezar a revelar los números elegidos y, por lo tanto, dejar de aceptar los hash, y cuándo finalizar la aceptación de los números elegidos y calcular el número aleatorio resultante. Tomar tales decisiones entre participantes que no confían unos en otros es en sí mismo una tarea complicada, y volveremos a ello en futuros artículos; en este artículo asumiremos que dicho algoritmo de consenso está disponible para nosotros.
¿Cuáles de las propiedades que describimos anteriormente tiene RANDAO? Es impredecible, tiene la misma viabilidad que el protocolo de consenso subyacente, pero es sesgado. En particular, un atacante puede observar la red y, después de que otros participantes revelen sus números, puede calcular su XOR y decidir si revelar o no su número para influir en el resultado. Aunque esto no permite que el atacante determine unilateralmente el resultado del generador de números aleatorios, aún le proporciona 1 bit de influencia. Y si los atacantes controlan múltiples participantes, el número de bits bajo su control será igual al número de participantes que controlan.
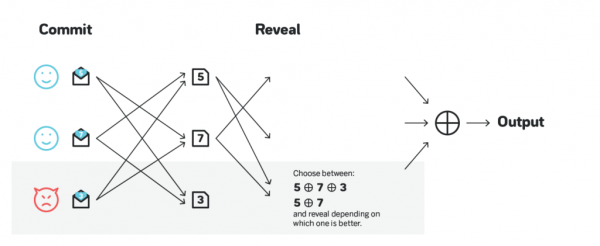
La influencia de los atacantes se puede reducir significativamente si se exige que los participantes revelen los números en orden. Entonces, un atacante solo podrá influir en el resultado si se revela al final. Aunque la influencia es considerablemente menor, el algoritmo sigue siendo sesgado.
RANDAO + VDF
Una de las formas de hacer que RANDAO sea imparcial es la siguiente: una vez que todos los números han sido revelados y se ha calculado el XOR, el resultado se introduce en una función que toma mucho tiempo para calcular, pero permite verificar la corrección del cálculo de forma muy rápida.
(vdf_output, vdf_proof) = VDF_compute(input) // esto es muy lento
correct = VDF_verify(input, vdf_output, vdf_proof) // esto es muy rápido
Esta función se llama Verifiable Delay Function, o VDF. Si el tiempo de cálculo del resultado final es mayor que la fase de revelación de números, entonces un atacante no podrá predecir el efecto de mostrar o ocultar su número, y por lo tanto perderá la capacidad de influir en el resultado.
Desarrollar un buen VDF es extremadamente complicado. Recientemente se han producido algunos avances, como y que han hecho que los VDF sean más aplicables en la práctica, y Ethereum 2.0 planea a largo plazo utilizar RANDAO con VDF como fuente de números aleatorios. Además de ser impredecible y no sesgado, este enfoque tiene la ventaja adicional de ser viable siempre que al menos dos participantes estén disponibles en la red (asumiendo que el protocolo de consenso utilizado es viable con tan pocos participantes).
La mayor dificultad de este enfoque radica en configurar el VDF de tal manera que ni siquiera un participante con hardware especializado muy costoso pueda calcular el VDF antes de que finalice la fase de revelación. Idealmente, el algoritmo debería tener un margen de seguridad significativo, digamos, de 10x. En la imagen de abajo se muestra un ataque de un participante que tiene un ASIC especializado que le permite ejecutar el VDF más rápido que el tiempo asignado para la revelación de la confirmación de RANDAO. Este participante aún puede calcular el resultado final usando o no usando su número, y después de eso, basándose en los cálculos, decidir si mostrarlo o no.
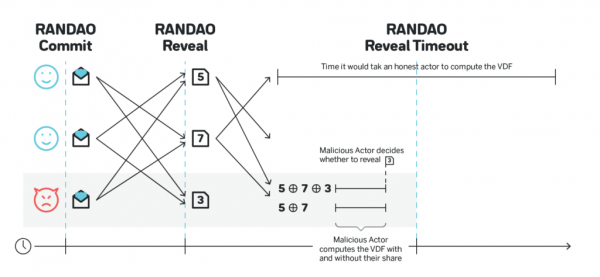
Para la familia de VDF mencionada anteriormente, el rendimiento de un ASIC especializado puede ser más de 100 veces superior al de hardware convencional. Así, si la fase de revelación dura 10 segundos, el VDF calculado en un ASIC así debería tardar más de 100 segundos para tener un margen de seguridad de 10 veces, y por lo tanto, el mismo VDF calculado en hardware convencional debería tardar 100 x 100 segundos = ~ 3 horas.
La Fundación Ethereum planea abordar este problema creando sus propios ASIC gratuitos y públicos. Una vez que esto suceda, todos los demás protocolos también podrán beneficiarse de esta tecnología, pero hasta entonces, el enfoque RANDAO + VDF no será tan viable para los protocolos que no pueden invertir en el desarrollo de sus propios ASIC.
Se ha recopilado una gran cantidad de artículos, videos e información sobre VDF en .
Usamos códigos que borran
En esta sección, analizaremos el protocolo de generación de números aleatorios que utiliza . Puede soportar hasta ⅓ de actores maliciosos, permaneciendo viable, y permite la existencia de hasta ⅔ de actores maliciosos antes de que puedan predecir o influir en el resultado.
La idea principal del protocolo es la siguiente. Para simplificar, supongamos que hay exactamente 100 participantes. Supongamos también que todos los participantes tienen localmente una cierta clave privada, y las claves públicas de todos los participantes son conocidas por todos los participantes:
Cada participante genera localmente una larga cadena, la divide en 67 partes, crea códigos borrables para obtener 100 acciones, de modo que cualquier conjunto de 67 sea suficiente para reconstruir la cadena, asigna cada una de las 100 partes a uno de los participantes y las cifra con la clave pública del mismo participante. Luego se publican todas las partes codificadas.
Los participantes utilizan algún consenso para llegar a un acuerdo sobre los conjuntos codificados de 67 participantes específicos.
Una vez alcanzado el consenso, cada participante toma las partes codificadas en cada uno de los 67 conjuntos, cifradas con su clave pública, descifra todas esas partes y publica todas esas partes descifradas.
Una vez que 67 participantes han realizado el paso (3), todos los conjuntos acordados pueden ser completamente decodificados y restaurados gracias a las propiedades de los códigos borrables, y el número final puede ser obtenido como el XOR de las cadenas iniciales de las que los participantes comenzaron en (1).
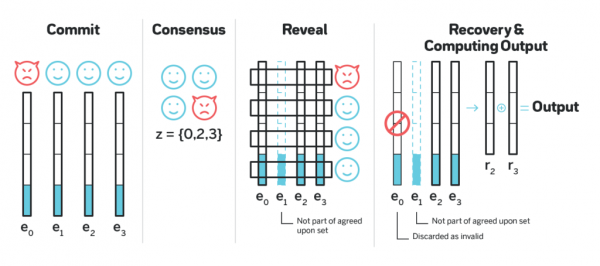
Se puede demostrar que este protocolo es imparcial e impredecible. El número aleatorio resultante se define después de alcanzar el consenso, pero no se conoce hasta que ⅔ de los participantes decodifican las partes cifradas con su clave pública. Así, el número aleatorio se define antes de que se publique la información necesaria para su recuperación.
¿Qué ocurre si en el paso (1) uno de los participantes envió a los demás participantes partes codificadas que no son un código de borrado válido para algún string? Sin cambios adicionales, diferentes participantes no podrán recuperar el string en absoluto, o recuperarán strings diferentes, lo que provocará que diferentes participantes obtengan distintos números aleatorios. Para prevenir esto, se puede hacer lo siguiente: cada participante, además de las partes codificadas, también calcula de todas esas partes, y envía a cada participante tanto la parte codificada como la raíz del árbol de Merkle y la prueba de inclusión de la parte en el árbol de Merkle. En el consenso del paso (2), los participantes no solo acuerdan sobre un conjunto de muchas partes, sino sobre muchas raíces concretas de esos árboles (si algún participante se desvía del protocolo y envía diferentes raíces del árbol de Merkle a diferentes participantes, y se muestran dos de esas raíces durante el consenso, su string no se incluye en el conjunto resultante). Como resultado del consenso, tendremos 67 strings codificados y sus correspondientes raíces del árbol de Merkle, de modo que hay al menos 67 participantes (no necesariamente los mismos que propusieron las strings correspondientes), que poseen para cada uno de los 67 strings un mensaje con la parte del código de borrado y la prueba de inclusión de su parte en el árbol de Merkle correspondiente.
Cuando en el paso (4) un participante descodifica 67 partes para algún string e intenta reconstruir el string original, se puede dar uno de los siguientes casos:
El string se reconstruye, y si se vuelve a codificar con códigos de borrado y se calcula el árbol de Merkle para las partes contadas localmente, la raíz coincide con la que se acordó en el consenso.
El string se reconstruye, pero la raíz calculada localmente no coincide con la que se acordó en el consenso.
El string no se reconstruye.
Es fácil demostrar que si al menos para un participante se presenta la opción (1), entonces para todos los participantes se presentará la opción (1), y viceversa, si al menos para un participante se presenta la opción (2) o (3), entonces para todos los participantes se presentará la opción (2) o (3). Así, para cada fila en el conjunto, o todos los participantes la restaurarán con éxito, o todos los participantes no podrán restaurarla. Entonces, el número aleatorio resultante es el XOR solo de aquellas filas que los participantes pudieron restaurar.
Firmas umbral
Otro enfoque de la aleatoriedad implica el uso de las llamadas firmas umbral BLS. El generador de números aleatorios basado en firmas umbral tiene exactamente las mismas garantías que el algoritmo descrito anteriormente basado en códigos borrables, pero tiene una asintótica significativamente menor en la cantidad de mensajes enviados a través de la red por cada número generado.
Las firmas BLS son una construcción que permite a varios participantes crear una única firma compartida para un mensaje. Estas firmas se utilizan frecuentemente para ahorrar espacio y ancho de banda, ya que no requieren el envío de múltiples firmas.
Un uso frecuente de las firmas BLS en protocolos de blockchain, además de la generación de números aleatorios, es la firma de bloques en protocolos BFT. Por ejemplo, 100 participantes crean bloques, y un bloque se considera final si 67 de ellos lo firman. Todos pueden presentar sus partes de la firma BLS y usar algún algoritmo de consenso para acordar 67 de ellas, y luego combinarlas en una única firma BLS. Cualquier conjunto de 67 (o más) partes puede ser utilizado para crear la firma final, que dependerá de qué 67 firmas específicas se hayan combinado, y por lo tanto puede diferir; sin embargo, a pesar de que diferentes elecciones de 67 participantes crearán diferentes firmas, cualquier firma de este tipo será una firma válida para el bloque. Los otros participantes solo necesitan recibir a través de la red y verificar una única firma por bloque, en lugar de 67, lo que reduce considerablemente la carga en la red.
Resulta que si las claves privadas utilizadas por los participantes se generan de cierta manera, entonces, independientemente de cuántas 67 firmas (o más, pero nunca menos) se agreguen, la firma resultante será la misma. Esto puede ser utilizado como una fuente de aleatoriedad: los participantes primero acuerdan un mensaje específico que firmarán (esto puede ser el resultado de RANDAO o simplemente el hash del último bloque, en realidad no tiene importancia, siempre que cambie cada vez y sea consensuado), y crean para ello una firma BLS. El resultado de la generación será impredecible hasta que los 67 participantes proporcionen sus partes, y después de eso, la salida ya está predefinida y no puede depender de las acciones de ningún participante.
Este enfoque a la aleatoriedad es viable si al menos ⅔ de los participantes están en línea y siguen el protocolo, y es imparcial e impredecible mientras al menos ⅓ de los participantes sigan el protocolo. Es importante señalar que un atacante que controle más de ⅓ pero menos de ⅔ de los participantes puede detener el protocolo, pero no puede predecir o influir en su salida.
Las firmas umbral en sí mismas son un tema muy interesante. En la segunda parte del artículo, analizaremos en detalle cómo funcionan y cómo deben generarse las claves de los participantes para que las firmas umbral puedan utilizarse como generador de números aleatorios.
En conclusión
Este artículo es el primero en una serie de artículos técnicos en el blog . NEAR es un protocolo de blockchain y una plataforma para el desarrollo de aplicaciones descentralizadas con énfasis en la facilidad de desarrollo y la simplicidad de uso para los usuarios finales.
El código del protocolo es de código abierto, nuestra implementación está escrita en Rust y se puede encontrar .
Puedes ver cómo es el desarrollo en NEAR y experimentar en un IDE en línea .
Puedes seguir todas las noticias en ruso en y en , y en inglés en el oficial .
¡Hasta pronto!
Fuente: habr.com
