

¡Hola, Habr!
En en los artículos discutimos por qué podría ser necesario generar números aleatorios para los participantes que no confían entre sí, qué requisitos se plantean para dichos generadores de números aleatorios, y examinamos dos enfoques para su implementación.
En esta parte del artículo, examinaremos en detalle otro enfoque que utiliza firmas umbral.
Un poco de criptografía
Para entender cómo funcionan las firmas umbral, es necesario conocer un poco de criptografía básica. Usaremos dos conceptos: escalares, o simplemente números, que denotaremos con letras minúsculas (x, y) y puntos en una curva elíptica, que denotaremos con letras mayúsculas.
Para comprender los fundamentos de las firmas umbral, no es necesario entender cómo funcionan las curvas elípticas, más allá de algunas cosas básicas:
Los puntos en una curva elíptica se pueden sumar y multiplicar por un escalar (la multiplicación por un escalar la denotaremos como xG, aunque la notación Gx también se usa con frecuencia en la literatura). El resultado de la suma y la multiplicación por un escalar es un punto en una curva elíptica.
Conociendo solo el punto G y su producto con el escalar xG no se puede calcular x.
También utilizaremos el concepto de polinomio p(x) de grado k-1. En particular, utilizaremos la siguiente propiedad de los polinomios: si conocemos el valor p(x) para cualquier k diferentes x y no tenemos más información sobre p(x), podemos calcular p(x) para cualquier otro x.
Es interesante que para cualquier polinomio p(x) y un cierto punto en la curva G, conociendo el valor p(x)G para cualquier k de valores diversos x, también se puede calcular p(x)G para cualquier x.
Esta información es suficiente para profundizar en los detalles de cómo funcionan las firmas umbral y cómo usarlas para generar números aleatorios.
Generador de números aleatorios basado en firmas umbral
Supongamos que n los participantes quieren generar un número aleatorio, y queremos que la participación de cualquier k de ellos sea suficiente para generar el número, pero que los atacantes que controlan k-1 o menos participantes no puedan predecir o influir en el número generado.
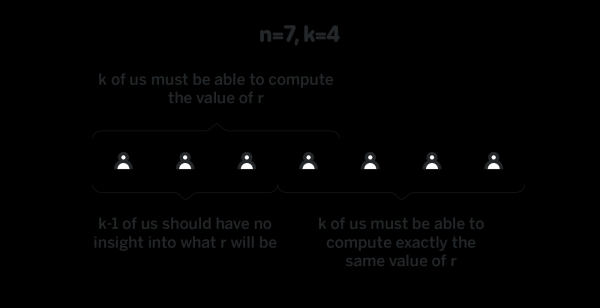
Supongamos que existe tal polinomio p(x) de grado k-1, que el primer participante conoce p(1), el segundo sabe p(2), y así sucesivamente (n-ando sabe p(n)). También supongamos que para un cierto punto previamente definido G todos conocen p(x)G para todos los valores x. Lo llamaremos p(i) “componente privada” i-ésimo participante (porque solo i-el participante la conoce), y p(i)G “componente pública” i-ésimo participante (porque todos los participantes la conocen). Como recordarán, saber p(i)G no es suficiente para reconstruir p(i).
Crear tal polinomio de modo que solo el i--ésimo participante y nadie más conozca su componente privada es la parte más difícil e interesante del protocolo, y la analizaremos a continuación. Por ahora, supongamos que tenemos tal polinomio y que todos los participantes conocen sus componentes privadas.
¿Cómo podemos usar un polinomio así para generar un número aleatorio? Para empezar, necesitamos alguna cadena que no se haya utilizado previamente como entrada para el generador. En el caso de la blockchain, el hash del último bloque h es un buen candidato para tal cadena. Supongamos que los participantes quieren crear un número aleatorio usando h como semilla. Primero, los participantes convierten h en un punto en la curva usando cualquier función previamente definida:
H = scalarToPoint(h)
Luego, cada participante i calcula y publica Hi = p(i)H, lo que pueden hacer porque conocen p(i) y H. La divulgación Hde i no permite a otros participantes reconstruir la componente privada i-ésimo participante, y por lo tanto, un conjunto de componentes privadas se puede usar de bloque a bloque. Así, el costoso algoritmo para crear el polinomio, descrito a continuación, solo necesita ser ejecutado una vez.
Cuando k los participantes revelan Hi = p(i)H, todos pueden calcular Hx = p(x)H para todos x gracias a la propiedad de los polinomios que discutimos en la sección anterior. En este momento, todos los participantes calculan H0 = p(0)H, y este es el número aleatorio resultante. Tenga en cuenta que nadie conoce p(0), y por lo tanto la única forma de calcular p(0)H es la interpolación p(x)H, lo que es posible solo cuando k los valores p(i)H son conocidos. Revelar cualquier menor cantidad p(i)H no proporciona ninguna información sobre p(0)H.
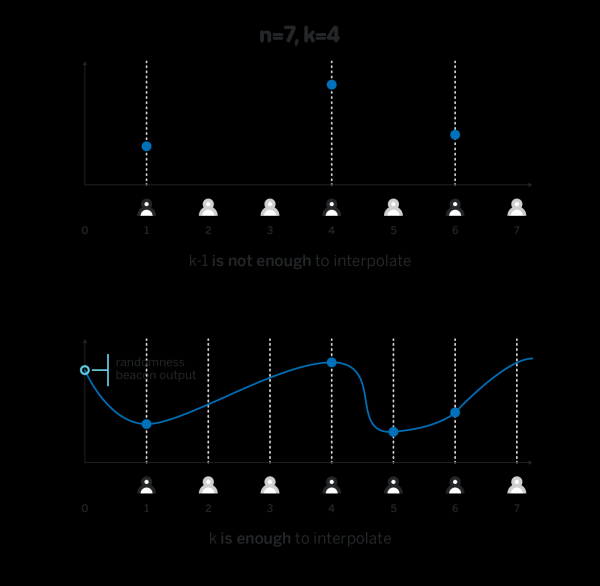
El generador anterior tiene todas las propiedades que queremos: los atacantes que controlan solo k--1 participantes, o menos, no tienen ninguna información ni influencia sobre la salida, mientras que cualquier k participante puede calcular el número resultante, y cualquier subconjunto de k participantes siempre llegará al mismo resultado para la misma semilla.
Hay un problema que hemos evitado cuidadosamente más arriba. Para que la interpolación funcione, es importante que el valor Hi publicado por cada participante i sea realmente igual a p(i)H. Dado que nadie más que el i-ésimo participante sabe p(i), nadie más que el el i--ésimo participante puede verificar que Hola se ha calculado correctamente, y sin alguna prueba criptográfica de corrección Hi un atacante puede publicar cualquier valor como Hola, y afectar de forma arbitraria la salida del generador de números aleatorios:
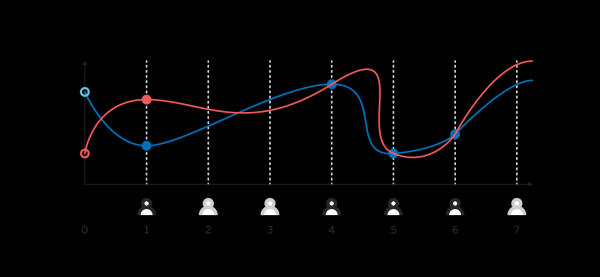 Diferentes valores H_1 enviados por el primer participante conducen a diferentes H_0 resultantes
Hay al menos dos formas de probar la corrección Hi, las abordaremos después de revisar la generación del polinomio.
Generación del polinomio
En la sección anterior asumimos que tenemos un polinomio p(x) de grado k-1 que el participante i conoce p(i), y nadie más tiene información sobre ese valor. En la siguiente sección, también necesitaremos que para algún punto predefinido G todos sepan p(x)G para todos x.
En esta sección asumiremos que cada participante tiene localmente alguna clave privada xi, de modo que la clave pública correspondiente Xi sea conocida.
Un posible protocolo de generación de polinomios es el siguiente:
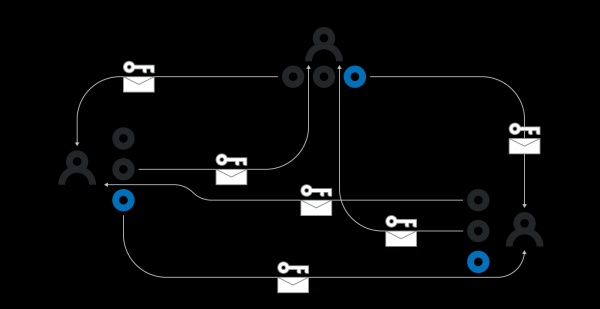
Cada participante i crea localmente un polinomio arbitrario pi(x) de grado k-1. Luego envían a cada participante j valor pi(j), cifrado con la clave pública Xj. De este modo, solo el el i-j-ésimo y participante sabej-ésimo i(j). El participante ptambién anuncia públicamente i pi(j)G inclusively. para todos j desde 1 hasta k Todos los participantes utilizan algún consenso para elegir
a los participantes, cuyos polinomios se utilizarán. Dado que algunos participantes pueden estar fuera de línea, no podemos esperar a que todos k los participantes publiquen sus polinomios. El resultado de este paso es un conjunto n que consiste en al menos Z los polinomios creados en el paso (1) k Los participantes se aseguran de que los valores que conocen.
i(j) correspondan a los ppi(j)G. Después de este paso, deben quedar únicamente polinomios para los cuales se ha transmitido privadamente calcula su componente privada Z p(j) ppi(j)G. Después de este paso, deben quedar únicamente polinomios para los cuales se ha transmitido privadamente
Cada participante j como la suma de i(j) para todos . Cada participante también calcula todos los valores ppi(x)G para todos i i en Zp(x) – p(x)G . Cada participante también calcula todos los valores es realmente un polinomio de grado en Z.
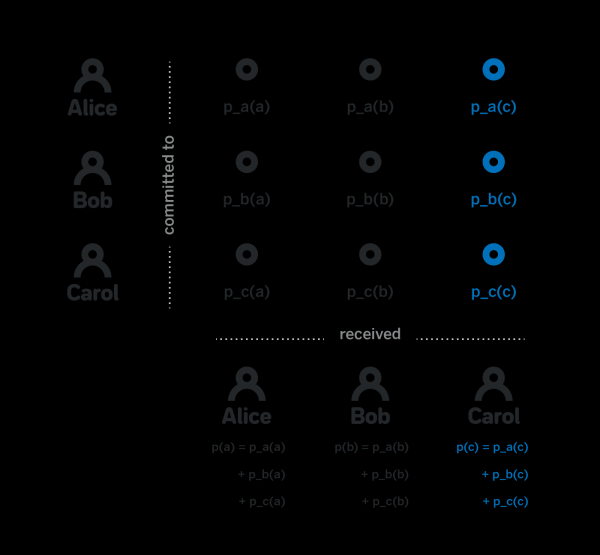
Tenga en cuenta que k-1, porque es la suma de cada uno de los i(x), cada uno de los cuales es un polinomio de grado porque es la suma de términos individuales pi(x), cada uno de los cuales es un polinomio de grado k-1. Luego, ten en cuenta que, aunque cada participante j conoce p(j), no tienen información sobre p(x) para x ≠ j. De hecho, para calcular este valor, necesitan conocer todos los pi(x), y mientras el participante j no conozca al menos uno de los polinomios seleccionados, no tiene suficiente información sobre p(x).
Este es todo el proceso de generación del polinomio que era necesario en la sección anterior. Los pasos 1, 2 y 4 mencionados anteriormente tienen una implementación suficientemente evidente. Sin embargo, el paso 3 no es tan trivial.
Específicamente, necesitamos ser capaces de demostrar que los cifrados pi(j) corresponden realmente a los publicados Después de este paso, deben quedar únicamente polinomios para los cuales se ha transmitido privadamente Si no podemos demostrarlo, un atacante i podría enviar basura en lugar de pi(j) al participante j, y el participante j no podrá obtener el verdadero valor pi(j), y no podrá calcular su componente privada.
Hay un protocolo criptográfico que permite crear un mensaje adicional proofi(j), de manera que cualquier participante, teniendo un valor cierto e, así como proofi(j) y pi(j)G, puede convencerse localmente de que e – esto es realmente pi(j), cifrado con la clave del participante j. Desafortunadamente, el tamaño de tal prueba es increíblemente grande, y considerando que es necesario publicar O(nk) tales pruebas, no se pueden utilizar para este propósito.
En lugar de demostrar que pi(j) corresponde a pi(j)G, podemos en el protocolo de generación del polinomio dedicar un período de tiempo muy grande, durante el cual todos los participantes verifican los cifrados recibidos pi(j), y si el mensaje descifrado no corresponde al público pi(j)G, publican una prueba criptográfica de que el mensaje cifrado que recibieron es incorrecto. Demostrar que el mensaje no corresponde a pi(G) es mucho más sencillo que demostrar que coincide. Cabe señalar que esto requiere que cada participante aparezca en la red al menos una vez durante el tiempo asignado para la creación de tales pruebas, y se basa en la suposición de que si publicaron tal prueba, llegará a todos los demás participantes dentro de ese mismo tiempo asignado.
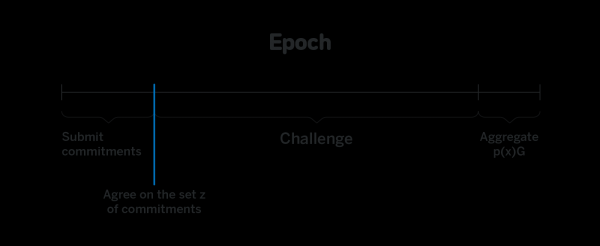
Si un participante no aparece en la red durante ese período, y realmente tenía al menos un componente incorrecto, entonces este participante específico no podrá participar en la generación futura de números. El protocolo, sin embargo, seguirá funcionando si hay al menos k de participantes que o bien solo recibieron componentes correctos, o pudieron dejar evidencia de incorrección en el tiempo asignado.
Evidencias de la corrección de H_i
La última parte que queda por discutir es cómo demostrar la corrección de lo publicado Hi, a saber, que Hi = p(i)H, sin revelación p(i).
Recordemos que los valores H, G, p(i)G son públicos y conocidos por todos. La operación de obtención p(i) conociendo p(i)G y G se llama logaritmo discreto, o dlog, y queremos demostrar que:
dlog(p(i)G, G) = dlog(Hi, H)
sin divulgación p(i). Existen construcciones para tales pruebas, por ejemplo,.
Con tal construcción, cada participante junto con Hola envía una prueba de corrección de acuerdo con la construcción.
Cuando se genera un número aleatorio, a menudo es necesario que lo utilicen participantes distintos a aquellos que lo generaron. A esos participantes, junto con el número, se les debe enviar toda la Hola y pruebas complementarias.
Un lector curioso puede preguntarse: dado que el número aleatorio final es H0, y p(0)G – es información pública, ¿por qué es necesaria una prueba para cada individual Hi, por qué en lugar de eso no enviar una prueba de que
dlog(p(0)G, G) = dlog(H0, H)
El problema es que con el Protocolo de Schnorr no se puede crear tal prueba, porque nadie conoce el valor p(0),que es necesario para crear la prueba, y más aún, todo el generador de números aleatorios está basado en el hecho de que nadie conoce este valor. Por lo tanto, es necesario tener todos los valores Hola y sus pruebas individuales, para demostrar la corrección. H0.
Sin embargo, si hubiera alguna operación en los puntos de las curvas elípticas que fuera semánticamente similar a la multiplicación, la prueba de corrección de H0 sería trivial, simplemente comprobaríamos que
H0 × G = p(0)G × H
Si la curva seleccionada soporta tal prueba funciona. En este caso, H0 no solo es la salida del generador de números aleatorios que puede verificar cualquier participante que conozca G, H y p(0)G. H0 también es una firma en el mensaje que se utilizó como semilla, que confirma que k y n los participantes firmaron este mensaje. Así, si seed – es el hash de un bloque en el protocolo blockchain, entonces H0 es simultáneamente una multi-firma sobre el bloque, y un muy buen número aleatorio.
En conclusión
Este artículo es parte de una serie de artículos técnicos en el blog . NEAR es un protocolo de blockchain y una plataforma para el desarrollo de aplicaciones descentralizadas, enfocándose en la simplicidad de desarrollo y la facilidad de uso para los usuarios finales.
El código del protocolo es de código abierto, nuestra implementación está escrita en Rust y se puede encontrar .
Puedes ver cómo es el desarrollo en NEAR y experimentar en un IDE en línea .
Puedes seguir todas las noticias en ruso en y en , y en inglés en el oficial .
¡Hasta pronto!
Fuente: habr.com
