

El alto rendimiento es uno de los requisitos clave al trabajar con grandes volúmenes de datos. En la gestión de carga de datos en Sber, nos encargamos de procesar prácticamente todas las transacciones en nuestra Nube de Datos basada en Hadoop, por lo que tratamos con flujos de información realmente grandes. Naturalmente, siempre estamos buscando formas de mejorar el rendimiento, y ahora queremos contar cómo logramos parchear el RegionServer HBase y el cliente HDFS, lo que nos permitió aumentar significativamente la velocidad de las operaciones de lectura.
Sin embargo, antes de pasar a los detalles de las mejoras, es importante hablar sobre las limitaciones que, en principio, no se pueden evitar si se utiliza HDD.
Por qué los HDD y las lecturas rápidas de acceso aleatorio son incompatibles
Como se sabe, HBase, así como muchas otras bases de datos, almacena datos en bloques con un tamaño de varias decenas de kilobytes. Por defecto, esto es alrededor de 64 KB. Ahora imaginemos que necesitamos obtener solo 100 bytes y le pedimos a HBase que nos entregue estos datos según una clave. Dado que el tamaño del bloque en HFiles es de 64 KB, se solicitarán 640 veces más (¡en un momento!) de lo que realmente necesitamos.
Además, dado que la solicitud pasará a través de HDFS y su mecanismo de caché de metadatos ShortCircuitCache (que permite el acceso directo a los archivos), esto resulta en la lectura de ya 1 MB del disco. Sin embargo, se puede regular mediante el parámetro dfs.client.read.shortcircuit.buffer.size y en muchos casos tiene sentido reducir este valor, por ejemplo, a 126 KB.
Supongamos que hacemos esto, pero además, cuando empezamos a leer datos a través de la API de Java, con funciones como FileChannel.read y le pedimos al sistema operativo que lea el volumen especificado de datos, este lee 'por si acaso' el doble, es decir, 256 KB en nuestro caso. Esto ocurre porque en Java no hay una forma sencilla de establecer la bandera FADV_RANDOM, que previene este comportamiento.
Al final, para obtener nuestros 100 bytes, se lee en realidad 2600 veces más. Podría parecer que la solución es obvia, reduzcamos el tamaño del bloque a un kilobyte, establezcamos la bandera mencionada y obtendremos un gran avance en velocidad. Pero el problema es que al reducir el tamaño del bloque a la mitad, también disminuimos el número de bytes leídos por unidad de tiempo en la misma proporción.
Se puede obtener algún beneficio al establecer la bandera FADV_RANDOM, pero solo con una alta concurrencia y con un tamaño de bloque de al menos 128 KB, aunque esto es un máximo de unas pocas decenas de por ciento:
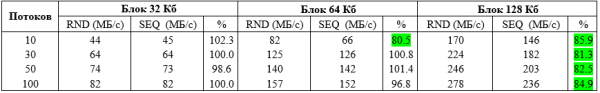
Las pruebas se realizaron en 100 archivos, cada uno de 1 GB, y distribuidos en 10 discos duros HDD.
Vamos a calcular qué velocidad podemos esperar en general:
Supongamos que leemos desde 10 discos a una velocidad de 280 MB/s, es decir, 3 millones de veces 100 bytes. Pero, como recordamos, los datos que necesitamos aparecen 2600 veces menos que lo leído. Así, dividimos 3 millones entre 2600 y obtenemos 1100 registros por segundo.
Desalentador, ¿no es así? Así es la naturaleza Random Access del acceso a los datos en HDD, sin importar el tamaño del bloque. Este es el límite físico del acceso aleatorio y ninguna base de datos puede extraer más en tales condiciones.
¿Cómo logran las bases de datos alcanzar velocidades mucho más altas? Para responder a esta pregunta, veamos lo que sucede en la siguiente imagen:
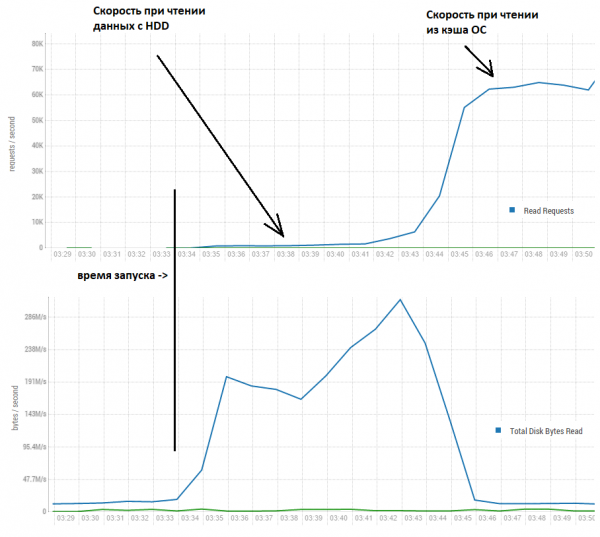
Aquí vemos que en los primeros minutos, la velocidad es realmente del orden de mil registros por segundo. Sin embargo, luego, gracias a que se lee mucho más de lo que se solicitó, los datos se asientan en el buff/cache del sistema operativo (Linux) y la velocidad aumenta a unos aceptables 60 mil por segundo.
Por lo tanto, a partir de ahora, abordaremos la aceleración del acceso solo a los datos que están en la caché del sistema operativo o en almacenes de velocidad comparable, como SSD/NVMe.
En nuestro caso, realizaremos pruebas en un banco de 4 servidores, cada uno configurado de la siguiente manera:
CPU: Xeon E5-2680 v4 @ 2.40GHz 64 hilos.
Memoria: 730 GB.
versión de java: 1.8.0_111
Y aquí, el punto clave es el volumen de datos en las tablas que se deben leer. Lo que sucede es que si leemos datos de una tabla que cabe completamente en la caché de HBase, en realidad ni siquiera se llegará a leer desde el buff/cache del sistema operativo. Esto se debe a que HBase por defecto reserva el 40% de la memoria para una estructura denominada BlockCache. En esencia, es un ConcurrentHashMap, donde la clave es el nombre del archivo + el desplazamiento del bloque, y el valor son los datos en ese desplazamiento.
Así, cuando la lectura se realiza solo desde esta estructura, vemos , como si fueran millones de consultas por segundo. Pero imagina que no podemos dedicar cientos de gigabytes de memoria solo para la base de datos, porque en esos servidores se ejecutan muchas otras cosas útiles.
Por ejemplo, en nuestro caso, el volumen de BlockCache en un RS es de aproximadamente 12 GB. Hemos desplegado dos RS en una sola nodo, es decir, se han asignado 96 GB de BlockCache en todos los nodos. Y los datos son muchas veces más, supongamos que tenemos 4 tablas, cada una con 130 regiones, donde los archivos tienen un tamaño de 800 MB, comprimidos con FAST_DIFF, es decir, en total 410 GB (esto son datos limpios, sin considerar el factor de replicación).
De este modo, BlockCache representa solo alrededor del 23% del volumen total de datos y esto se acerca mucho más a las condiciones reales de lo que se llama BigData. Y aquí es donde comienza lo más interesante: es evidente que cuanto menos aciertos haya en la caché, peor será el rendimiento. En caso de fallos, tendremos que realizar una gran cantidad de trabajo, es decir, descender hasta llamar a las funciones del sistema. Sin embargo, esto es inevitable, así que consideremos un aspecto completamente diferente: ¿qué sucede con los datos dentro de la caché?
Simplifiquemos la situación y supongamos que tenemos una caché que solo puede almacenar 1 objeto. Aquí hay un ejemplo de lo que sucederá al intentar trabajar con un volumen de datos 3 veces mayor que la caché, tendremos que:
1. Colocar el bloque 1 en la caché
2. Eliminar el bloque 1 de la caché
3. Colocar el bloque 2 en la caché
4. Eliminar el bloque 2 de la caché
5. Colocar el bloque 3 en la caché
¡Se han realizado 5 acciones! Sin embargo, no se puede considerar normal esta situación; de hecho, estamos obligando a HBase a realizar una gran cantidad de trabajo completamente innecesario. Constantemente está leyendo datos de la caché del sistema operativo, colocándolos en BlockCache, solo para desecharlos casi de inmediato, porque ha llegado un nuevo lote de datos. La animación al inicio de la publicación muestra la esencia del problema: el recolector de basura está desbordado, el ambiente se calienta, la pequeña Greta en Suecia, lejos y en un clima cálido, se preocupa. Y nosotros, los informáticos, no nos gusta ver a los niños tristes, así que comenzamos a pensar en qué podemos hacer al respecto.
¿Y si en lugar de colocar todos los bloques en la caché, solo colocamos un porcentaje determinado de ellos, para que la caché no se llene? Para empezar, simplemente agregamos unas pocas líneas de código al inicio de la función que coloca datos en BlockCache:
  public void cacheBlock(BlockCacheKey cacheKey, Cacheable buf, boolean inMemory) {
    if (cacheDataBlockPercent != 100 && buf.getBlockType().isData()) {
      if (cacheKey.getOffset() % 100 >= cacheDataBlockPercent) {
        return;
      }
    }
...
El sentido aquí es el siguiente: el offset es la posición del bloque en el archivo y los últimos dígitos están distribuidos aleatoriamente y de manera uniforme del 00 al 99. Por lo tanto, solo vamos a omitir los que caen dentro del rango deseado.
Por ejemplo, estableceremos cacheDataBlockPercent = 20 y veremos qué sucede:
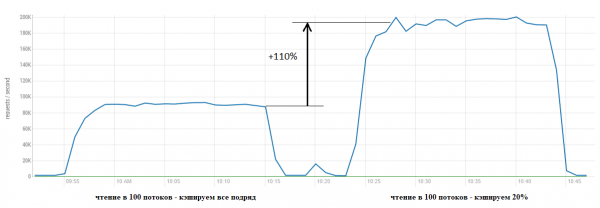
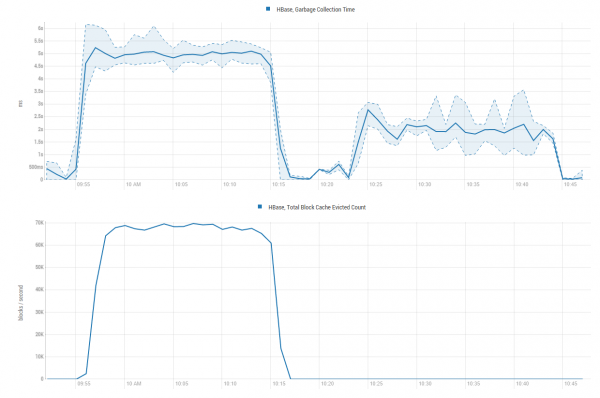
El resultado es evidente. En los gráficos a continuación queda claro cómo se produjo esta aceleración: ahorramos muchos recursos de GC al no realizar el trabajo de Sísifo de colocar datos en la caché solo para desecharlos después.
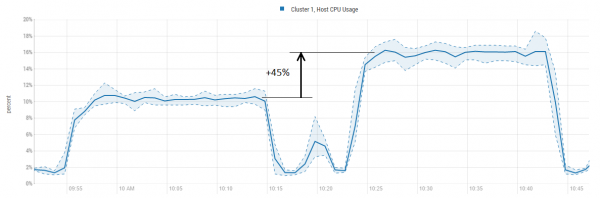
La utilización de la CPU, sin embargo, aumenta, pero mucho menos que el rendimiento.
Aquí también vale la pena señalar que los bloques que se almacenan en BlockCache pueden ser diferentes. La mayor parte, alrededor del 95%, son datos. Y el resto son metadatos, como filtros Bloom o LEAF_INDEX y . Estos datos son pocos, pero muy útiles, ya que antes de acceder directamente a los datos, HBase consulta los metadatos para entender si es necesario buscar más allá y, si es así, dónde se encuentra exactamente el bloque que le interesa.
Por lo tanto, en el código vemos la verificación de la condición buf.getBlockType().isData() y gracias a estos metadatos, dejaremos los datos en la caché en cualquier caso.
Ahora aumentemos la carga y ajustemos un poco la función. En la primera prueba establecimos el porcentaje de umbral = 20 y el BlockCache estaba ligeramente subcargado. Ahora pondremos un 23% y comenzaremos a agregar 100 hilos cada 5 minutos para ver en qué momento se produce la saturación:
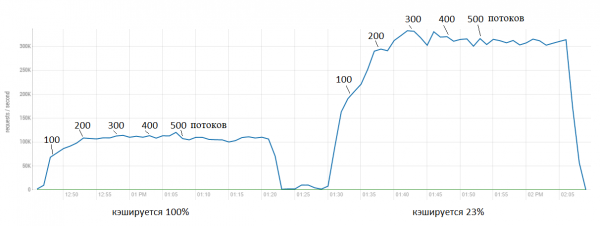
Aquí vemos que la versión original prácticamente se encuentra de inmediato en el límite alrededor de 100 mil solicitudes por segundo. Mientras que el parche proporciona un aumento hasta 300 mil. A su vez, es claro que un mayor aumento ya no es tan "gratuito", y la utilización de la CPU también aumenta.
Sin embargo, esta no es una solución muy elegante, ya que no sabemos de antemano qué porcentaje de bloques debe ser almacenado en caché, esto depende del perfil de carga. Por lo tanto, se implementó un mecanismo de ajuste automático de este parámetro según la actividad de las operaciones de lectura.
Para gestionar esto, se agregaron tres parámetros:
hbase.lru.cache.heavy.eviction.count.limit — establece cuántas veces debe ejecutarse el proceso de expulsión de datos de la caché antes de que comencemos a usar la optimización (es decir, saltar bloques). Por defecto, es igual a MAX_INT = 2147483647, lo que significa que la función nunca comenzará a trabajar con ese valor. Debido a que el proceso de expulsión se ejecuta cada 5 a 10 segundos (dependiendo de la carga) y 2147483647 * 10 / 60 / 60 / 24 / 365 = 680 años. Sin embargo, podemos establecer este parámetro en 0 y hacer que la función funcione inmediatamente después de su inicio.
Sin embargo, hay una carga útil en este parámetro. Si nuestra carga se caracteriza por lecturas a corto plazo intercaladas (supongamos durante el día) y lecturas a largo plazo (por la noche), entonces podemos hacer que la función se active solo cuando hay operaciones de lectura prolongadas.
Por ejemplo, sabemos que las lecturas a corto plazo suelen durar alrededor de 1 minuto. En este caso, no debe comenzarse a expulsar bloques, la caché no tendrá tiempo de volverse obsoleta y podemos establecer este parámetro en, por ejemplo, 10. Esto hará que la optimización comience a trabajar solo cuando se inicien lecturas prolongadas, es decir, después de 100 segundos. Así, si tenemos lecturas a corto plazo, todos los bloques entrarán en la caché y estarán disponibles (excepto aquellos que serán expulsados por el algoritmo estándar). Y cuando realizamos lecturas a largo plazo, la función se activa y podemos esperar un rendimiento mucho más alto.
hbase.lru.cache.heavy.eviction.mb.size.limit — establece cuántos megabytes nos gustaría colocar en la caché (y naturalmente expulsar) en 10 segundos. La función intentará alcanzar este valor y mantenerlo. La idea es la siguiente: si introducimos gigabytes en la caché, también tendremos que expulsar gigabytes, lo cual, como vimos anteriormente, es bastante costoso. Sin embargo, no debemos intentar establecerlo demasiado pequeño, ya que esto conducirá a una salida prematura del modo de salto de bloques. Para servidores potentes (alrededor de 20-40 núcleos físicos), es óptimo establecerlo en alrededor de 300-400 MB. Para un servidor de gama media (~10 núcleos) 200-300 MB. Para sistemas débiles (2-5 núcleos) 50-100 MB puede ser aceptable (no se ha probado en tales).
Veamos cómo funciona: supongamos que hemos establecido hbase.lru.cache.heavy.eviction.mb.size.limit = 500, hay alguna carga (lecturas) y entonces cada ~10 segundos calculamos cuántos bytes han sido desalojados según la fórmula:
Overhead = Suma de Bytes Liberados (MB) * 100 / Límite (MB) — 100;
Si en realidad se desalojaron 2000 MB, entonces el Overhead resulta ser:
2000 * 100 / 500 — 100 = 300%
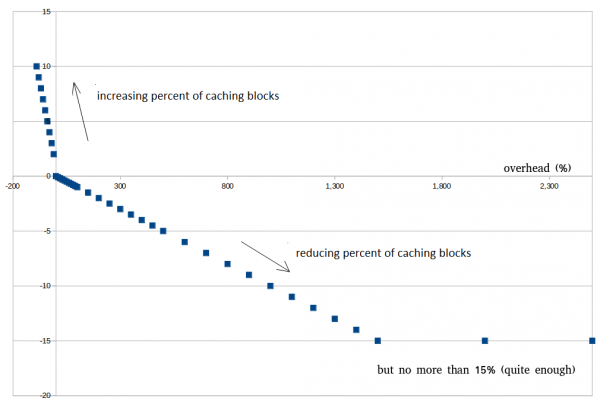
Los algoritmos intentan mantener el porcentaje en no más de unas pocas decenas por ciento, por lo que la función reducirá el porcentaje de bloques en caché, implementando así un mecanismo de autoajuste.
Sin embargo, si la carga disminuyó, pongamos que solo se desalojaron 200 MB y el Overhead se volvió negativo (lo que se llama overshooting):
200 * 100 / 500 — 100 = -60%
Entonces la función, por el contrario, aumentará el porcentaje de bloques en caché hasta que el Overhead se vuelva positivo.
A continuación, un ejemplo de cómo se ve esto con datos reales. No intentes alcanzar el 0%, eso es imposible. Es bastante bueno cuando está entre el 30% y el 100%, ya que ayuda a evitar una salida prematura del modo de optimización durante picos a corto plazo.
hbase.lru.cache.heavy.eviction.overhead.coefficient — establece cuán rápido nos gustaría obtener un resultado. Si sabemos firmemente que nuestras lecturas son principalmente prolongadas y no queremos esperar, podemos aumentar este coeficiente y obtener un alto rendimiento más rápido.
Por ejemplo, hemos establecido este coeficiente = 0.01. Esto significa que el Overhead (ver arriba) se multiplicará por este número en el resultado obtenido y se reducirá el porcentaje de bloques en caché. Supongamos que el Overhead = 300%, y el coeficiente = 0.01, entonces el porcentaje de bloques en caché se reducirá en 3%.
Una lógica similar de 'Backpressure' se ha implementado también para valores negativos de Overhead (overshooting). Dado que siempre pueden ocurrir fluctuaciones a corto plazo en el volumen de lecturas-desalojos, este mecanismo permite evitar una salida prematura del modo de optimización. El Backpressure tiene una lógica invertida: cuanto mayor es el overshooting, más bloques se cachean.
Código de implementación
        LruBlockCache cache = this.cache.get();
        if (cache == null) {
          break;
        }
        freedSumMb += cache.evict() / 1024 / 1024;
        /*
        * A veces leemos más datos de los que pueden caber en BlockCache
        * y eso causa una alta tasa de desalojos.
        * Esto a su vez lleva a un gran trabajo del recolector de basura.
        * Así, muchos bloques se colocan en BlockCache pero nunca se leen,
        * gastando muchos recursos de CPU.
        * Aquí analizaremos cuántos bytes fueron liberados y decidiremos
        * si ha llegado el momento de reducir la cantidad de bloques en caché.
        * Esto ayuda a evitar colocar demasiados bloques en BlockCache
        * cuando evict() está trabajando de manera muy activa y a ahorrar CPU para otros trabajos.
        * Más detalles: https://issues.apache.org/jira/browse/HBASE-23887
        */

        // Primero que nada, tenemos que controlar cuánto tiempo
        // ha pasado desde que se lanzó la última evict()
        // Esto debería ser casi el mismo tiempo (+/- 10s)
        // porque obtenemos volúmenes comparables de bytes liberados cada vez.
        // 10s porque este es el periodo predeterminado para ejecutar evict() (ver arriba this.wait)
        long stopTime = System.currentTimeMillis();
        if ((stopTime - startTime) > 1000 * 10 - 1) {
          // Aquí tenemos que calcular qué situación tenemos.
          // Tenemos el límite "hbase.lru.cache.heavy.eviction.bytes.size.limit"
          // y podemos calcular la sobrecarga sobre él.
          // Usaremos esta información para decidir,
          // cómo cambiar el porcentaje de bloques en caché.
          freedDataOverheadPercent =
            (int) (freedSumMb * 100 / cache.heavyEvictionMbSizeLimit) - 100;
          if (freedSumMb > cache.heavyEvictionMbSizeLimit) {
            // Ahora estamos en una situación en la que estamos por encima del límite
            // Pero tal vez decidamos ignorarlo porque terminará bastante pronto
            heavyEvictionCount++;
            if (heavyEvictionCount > cache.heavyEvictionCountLimit) {
              // Ha estado sucediendo por mucho tiempo y tenemos que reducir la cantidad de
              // bloques en caché ahora. Así que aquí calculamos cuántos bloques queremos omitir.
              // Depende de:
              // 1. Sobrecarga - si la sobrecarga es grande, podríamos ser más agresivos
              // reduciendo la cantidad de bloques en caché.
              // 2. Qué tan rápido queremos obtener el resultado. Si sabemos que nuestra
              // lectura intensa ha durado mucho tiempo, no queremos esperar y podemos
              // aumentar el coeficiente y obtener un buen rendimiento bastante rápido.
              // Pero si no estamos seguros, podemos hacerlo lentamente y eso podría prevenir
              // una salida prematura de este modo. Así que, cuando el coeficiente es
              // más alto obtendremos un mejor rendimiento cuando la lectura intensa sea estable.
              // Pero cuando la lectura está cambiando, podemos ajustarnos a ello y establecer
              // el coeficiente a un valor más bajo.
              int change =
                (int) (freedDataOverheadPercent * cache.heavyEvictionOverheadCoefficient);
              // Pero la práctica muestra que una reducción del 15% es bastante suficiente.
              // No somos codiciosos (podría llevar a una salida prematura).
              change = Math.min(15, change);
              change = Math.max(0, change); // Creo que esto nunca sucederá, pero lo comprobamos para estar seguros
              // Así que este es el punto clave, aquí estamos reduciendo el porcentaje de bloques en caché
              cache.cacheDataBlockPercent -= change;
              // Si bajamos demasiado, debemos detenernos aquí, 1% de todos modos debe serlo.
              cache.cacheDataBlockPercent = Math.max(1, cache.cacheDataBlockPercent);
            }
          } else {
            // Bueno, hemos tenido un exceso.
            // Tal vez sea solo una fluctuación a corto plazo y podemos quedarnos en este modo.
            // Esto ayuda a evitar una salida prematura durante una fluctuación a corto plazo.
            // Si el exceso es menor al 90%, trataremos de aumentar el porcentaje de
            // bloques en caché y esperamos que sea suficiente.
            if (freedSumMb >= cache.heavyEvictionMbSizeLimit * 0.1) {
              // Lógica simple: más exceso - más bloques en caché (contrapresión)
              int change = (int) (-freedDataOverheadPercent * 0.1 + 1);
              cache.cacheDataBlockPercent += change;
              // Pero no puede ser más del 100%, así que lo comprobamos.
              cache.cacheDataBlockPercent = Math.min(100, cache.cacheDataBlockPercent);
            } else {
              // Parece que la lectura intensa ha terminado.
              // Simplemente salimos de este modo.
              heavyEvictionCount = 0;
              cache.cacheDataBlockPercent = 100;
            }
          }
          LOG.info("BlockCache desalojado (MB): {}, sobrecarga (%): {}, " +
            "contador de desalojos intensos: {}, " +
            "porcentaje actual de bloque de datos en caché (%): {}",
            freedSumMb, freedDataOverheadPercent,
            heavyEvictionCount, cache.cacheDataBlockPercent);

          freedSumMb = 0;
          startTime = stopTime;
       }
Ahora consideremos todo esto con un ejemplo real. Tenemos el siguiente escenario de prueba:
- Comenzamos a hacer Scan (25 hilos, batch = 100)
- Después de 5 minutos, añadimos multi-gets (25 hilos, batch = 100)
- Después de 5 minutos, desactivamos multi-gets (queda solo scan de nuevo)
Hacemos dos ejecuciones, primero hbase.lru.cache.heavy.eviction.count.limit = 10000 (lo que desactiva la función), y luego establecemos limit = 0 (lo activa).
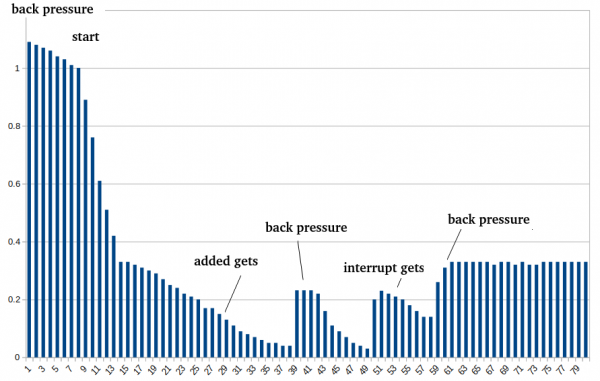
En los registros a continuación, vemos cómo se activa la función, restableciendo Overshooting a 14-71%. De vez en cuando, la carga disminuye, lo que activa Backpressure y HBase vuelve a almacenar en caché más bloques.
Registro de RegionServer
evicted (MB): 0, ratio 0.0, overhead (%): -100, contador de desalojo pesado: 0, caché de DataBlock actual (%): 100
evicted (MB): 0, ratio 0.0, overhead (%): -100, contador de desalojo pesado: 0, caché de DataBlock actual (%): 100
evicted (MB): 2170, ratio 1.09, overhead (%): 985, contador de desalojo pesado: 1, caché de DataBlock actual (%): 91 < start
evicted (MB): 3763, ratio 1.08, overhead (%): 1781, contador de desalojo pesado: 2, caché de DataBlock actual (%): 76
evicted (MB): 3306, ratio 1.07, overhead (%): 1553, contador de desalojo pesado: 3, caché de DataBlock actual (%): 61
evicted (MB): 2508, ratio 1.06, overhead (%): 1154, contador de desalojo pesado: 4, caché de DataBlock actual (%): 50
evicted (MB): 1824, ratio 1.04, overhead (%): 812, contador de desalojo pesado: 5, caché de DataBlock actual (%): 42
evicted (MB): 1482, ratio 1.03, overhead (%): 641, contador de desalojo pesado: 6, caché de DataBlock actual (%): 36
evicted (MB): 1140, ratio 1.01, overhead (%): 470, contador de desalojo pesado: 7, caché de DataBlock actual (%): 32
evicted (MB): 913, ratio 1.0, overhead (%): 356, contador de desalojo pesado: 8, caché de DataBlock actual (%): 29
evicted (MB): 912, ratio 0.89, overhead (%): 356, contador de desalojo pesado: 9, caché de DataBlock actual (%): 26
evicted (MB): 684, ratio 0.76, overhead (%): 242, contador de desalojo pesado: 10, caché de DataBlock actual (%): 24
evicted (MB): 684, ratio 0.61, overhead (%): 242, contador de desalojo pesado: 11, caché de DataBlock actual (%): 22
evicted (MB): 456, ratio 0.51, overhead (%): 128, contador de desalojo pesado: 12, caché de DataBlock actual (%): 21
evicted (MB): 456, ratio 0.42, overhead (%): 128, contador de desalojo pesado: 13, caché de DataBlock actual (%): 20
evicted (MB): 456, ratio 0.33, overhead (%): 128, contador de desalojo pesado: 14, caché de DataBlock actual (%): 19
evicted (MB): 342, ratio 0.33, overhead (%): 71, contador de desalojo pesado: 15, caché de DataBlock actual (%): 19
evicted (MB): 342, ratio 0.32, overhead (%): 71, contador de desalojo pesado: 16, caché de DataBlock actual (%): 19
evicted (MB): 342, ratio 0.31, overhead (%): 71, contador de desalojo pesado: 17, caché de DataBlock actual (%): 19
evicted (MB): 228, ratio 0.3, overhead (%): 14, contador de desalojo pesado: 18, caché de DataBlock actual (%): 19
evicted (MB): 228, ratio 0.29, overhead (%): 14, contador de desalojo pesado: 19, caché de DataBlock actual (%): 19
evicted (MB): 228, ratio 0.27, overhead (%): 14, contador de desalojo pesado: 20, caché de DataBlock actual (%): 19
evicted (MB): 228, ratio 0.25, overhead (%): 14, contador de desalojo pesado: 21, caché de DataBlock actual (%): 19
evicted (MB): 228, ratio 0.24, overhead (%): 14, contador de desalojo pesado: 22, caché de DataBlock actual (%): 19
evicted (MB): 228, ratio 0.22, overhead (%): 14, contador de desalojo pesado: 23, caché de DataBlock actual (%): 19
evicted (MB): 228, ratio 0.21, overhead (%): 14, contador de desalojo pesado: 24, caché de DataBlock actual (%): 19
evicted (MB): 228, ratio 0.2, overhead (%): 14, contador de desalojo pesado: 25, caché de DataBlock actual (%): 19
evicted (MB): 228, ratio 0.17, overhead (%): 14, contador de desalojo pesado: 26, caché de DataBlock actual (%): 19
desalojado (MB): 456, razón 0.17, sobrecarga (%): 128, contador de desalojos graves: 27, bloque de datos en caché actual (%): 18 < añadidos obtenidos (pero la tabla es la misma)
desalojado (MB): 456, razón 0.15, sobrecarga (%): 128, contador de desalojos graves: 28, bloque de datos en caché actual (%): 17
desalojado (MB): 342, razón 0.13, sobrecarga (%): 71, contador de desalojos graves: 29, bloque de datos en caché actual (%): 17
desalojado (MB): 342, razón 0.11, sobrecarga (%): 71, contador de desalojos graves: 30, bloque de datos en caché actual (%): 17
desalojado (MB): 342, razón 0.09, sobrecarga (%): 71, contador de desalojos graves: 31, bloque de datos en caché actual (%): 17
desalojado (MB): 228, razón 0.08, sobrecarga (%): 14, contador de desalojos graves: 32, bloque de datos en caché actual (%): 17
desalojado (MB): 228, razón 0.07, sobrecarga (%): 14, contador de desalojos graves: 33, bloque de datos en caché actual (%): 17
desalojado (MB): 228, razón 0.06, sobrecarga (%): 14, contador de desalojos graves: 34, bloque de datos en caché actual (%): 17
desalojado (MB): 228, razón 0.05, sobrecarga (%): 14, contador de desalojos graves: 35, bloque de datos en caché actual (%): 17
desalojado (MB): 228, razón 0.05, sobrecarga (%): 14, contador de desalojos graves: 36, bloque de datos en caché actual (%): 17
desalojado (MB): 228, razón 0.04, sobrecarga (%): 14, contador de desalojos graves: 37, bloque de datos en caché actual (%): 17
desalojado (MB): 109, razón 0.04, sobrecarga (%): -46, contador de desalojos graves: 37, bloque de datos en caché actual (%): 22 < presión de retroceso
desalojado (MB): 798, razón 0.24, sobrecarga (%): 299, contador de desalojos graves: 38, bloque de datos en caché actual (%): 20
desalojado (MB): 798, razón 0.29, sobrecarga (%): 299, contador de desalojos graves: 39, bloque de datos en caché actual (%): 18
desalojado (MB): 570, razón 0.27, sobrecarga (%): 185, contador de desalojos graves: 40, bloque de datos en caché actual (%): 17
desalojado (MB): 456, razón 0.22, sobrecarga (%): 128, contador de desalojos graves: 41, bloque de datos en caché actual (%): 16
desalojado (MB): 342, razón 0.16, sobrecarga (%): 71, contador de desalojos graves: 42, bloque de datos en caché actual (%): 16
desalojado (MB): 342, razón 0.11, sobrecarga (%): 71, contador de desalojos graves: 43, bloque de datos en caché actual (%): 16
desalojado (MB): 228, razón 0.09, sobrecarga (%): 14, contador de desalojos graves: 44, bloque de datos en caché actual (%): 16
desalojado (MB): 228, razón 0.07, sobrecarga (%): 14, contador de desalojos graves: 45, bloque de datos en caché actual (%): 16
desalojado (MB): 228, razón 0.05, sobrecarga (%): 14, contador de desalojos graves: 46, bloque de datos en caché actual (%): 16
desalojado (MB): 222, razón 0.04, sobrecarga (%): 11, contador de desalojos graves: 47, bloque de datos en caché actual (%): 16
desalojado (MB): 104, razón 0.03, sobrecarga (%): -48, contador de desalojos graves: 47, bloque de datos en caché actual (%): 21 < interrupción de obtenciones
desalojado (MB): 684, razón 0.2, sobrecarga (%): 242, contador de desalojos graves: 48, bloque de datos en caché actual (%): 19
desalojado (MB): 570, razón 0.23, sobrecarga (%): 185, contador de desalojos graves: 49, bloque de datos en caché actual (%): 18
desalojado (MB): 342, razón 0.22, sobrecarga (%): 71, contador de desalojos graves: 50, bloque de datos en caché actual (%): 18
desalojado (MB): 228, razón 0.21, sobrecarga (%): 14, contador de desalojos graves: 51, bloque de datos en caché actual (%): 18
desalojado (MB): 228, razón 0.2, sobrecarga (%): 14, contador de desalojos graves: 52, bloque de datos en caché actual (%): 18
desalojado (MB): 228, razón 0.18, sobrecarga (%): 14, contador de desalojos graves: 53, bloque de datos en caché actual (%): 18
desalojado (MB): 228, razón 0.16, sobrecarga (%): 14, contador de desalojos graves: 54, bloque de datos en caché actual (%): 18
desalojado (MB): 228, razón 0.14, sobrecarga (%): 14, contador de desalojos graves: 55, bloque de datos en caché actual (%): 18
desalojado (MB): 112, razón 0.14, sobrecarga (%): -44, contador de desalojos graves: 55, bloque de datos en caché actual (%): 23 < presión de retroceso
desalojado (MB): 456, razón 0.26, sobrecarga (%): 128, contador de desalojos graves: 56, bloque de datos en caché actual (%): 22
desalojado (MB): 342, razón 0.31, sobrecarga (%): 71, contador de desalojos graves: 57, bloque de datos en caché actual (%): 22
desalojado (MB): 342, proporción 0.33, overhead (%): 71, contador de desalojos pesado: 58, datos en caché actuales DataBlock (%): 22
desalojado (MB): 342, proporción 0.33, overhead (%): 71, contador de desalojos pesado: 59, datos en caché actuales DataBlock (%): 22
desalojado (MB): 342, proporción 0.33, overhead (%): 71, contador de desalojos pesado: 60, datos en caché actuales DataBlock (%): 22
desalojado (MB): 342, proporción 0.33, overhead (%): 71, contador de desalojos pesado: 61, datos en caché actuales DataBlock (%): 22
desalojado (MB): 342, proporción 0.33, overhead (%): 71, contador de desalojos pesado: 62, datos en caché actuales DataBlock (%): 22
desalojado (MB): 342, proporción 0.33, overhead (%): 71, contador de desalojos pesado: 63, datos en caché actuales DataBlock (%): 22
desalojado (MB): 342, proporción 0.32, overhead (%): 71, contador de desalojos pesado: 64, datos en caché actuales DataBlock (%): 22
desalojado (MB): 342, proporción 0.33, overhead (%): 71, contador de desalojos pesado: 65, datos en caché actuales DataBlock (%): 22
desalojado (MB): 342, proporción 0.33, overhead (%): 71, contador de desalojos pesado: 66, datos en caché actuales DataBlock (%): 22
desalojado (MB): 342, proporción 0.32, overhead (%): 71, contador de desalojos pesado: 67, datos en caché actuales DataBlock (%): 22
desalojado (MB): 342, proporción 0.33, overhead (%): 71, contador de desalojos pesado: 68, datos en caché actuales DataBlock (%): 22
desalojado (MB): 342, proporción 0.32, overhead (%): 71, contador de desalojos pesado: 69, datos en caché actuales DataBlock (%): 22
desalojado (MB): 342, proporción 0.32, overhead (%): 71, contador de desalojos pesado: 70, datos en caché actuales DataBlock (%): 22
desalojado (MB): 342, proporción 0.33, overhead (%): 71, contador de desalojos pesado: 71, datos en caché actuales DataBlock (%): 22
desalojado (MB): 342, proporción 0.33, overhead (%): 71, contador de desalojos pesado: 72, datos en caché actuales DataBlock (%): 22
desalojado (MB): 342, proporción 0.33, overhead (%): 71, contador de desalojos pesado: 73, datos en caché actuales DataBlock (%): 22
desalojado (MB): 342, proporción 0.33, overhead (%): 71, contador de desalojos pesado: 74, datos en caché actuales DataBlock (%): 22
desalojado (MB): 342, proporción 0.33, overhead (%): 71, contador de desalojos pesado: 75, datos en caché actuales DataBlock (%): 22
desalojado (MB): 342, proporción 0.33, overhead (%): 71, contador de desalojos pesado: 76, datos en caché actuales DataBlock (%): 22
desalojado (MB): 21, proporción 0.33, overhead (%): -90, contador de desalojos pesado: 76, datos en caché actuales DataBlock (%): 32
evicted (MB): 0, ratio 0.0, overhead (%): -100, contador de desalojo pesado: 0, caché de DataBlock actual (%): 100
evicted (MB): 0, ratio 0.0, overhead (%): -100, contador de desalojo pesado: 0, caché de DataBlock actual (%): 100
Los escaneos fueron necesarios para ilustrar este mismo proceso en forma de gráfico de la relación entre dos secciones de caché: single (donde entran los bloques que nadie ha solicitado antes) y multi (donde se almacenan los datos que han sido 'solicitados' al menos una vez):
Y, por último, cómo se ven los parámetros en forma de gráfico. Para comparación, la caché estuvo completamente desactivada al principio, luego se inició HBase con caché y se retrasó el inicio de la optimización durante 5 minutos (30 ciclos de desalojo).
El código completo se puede encontrar en Pull Request en github.
Sin embargo, 300 mil lecturas por segundo no es todo lo que se puede obtener de este hardware en estas condiciones. Lo que sucede es que cuando se necesita acceder a los datos a través de HDFS, se utiliza el mecanismo ShortCircuitCache (en adelante SSC), que permite acceder a los datos directamente, evitando interacciones de red.
El perfil mostró que este mecanismo, aunque proporciona una gran ventaja, también se convierte en un cuello de botella en algún momento, ya que prácticamente todas las operaciones pesadas ocurren dentro del lock, lo que provoca bloqueos la mayor parte del tiempo.
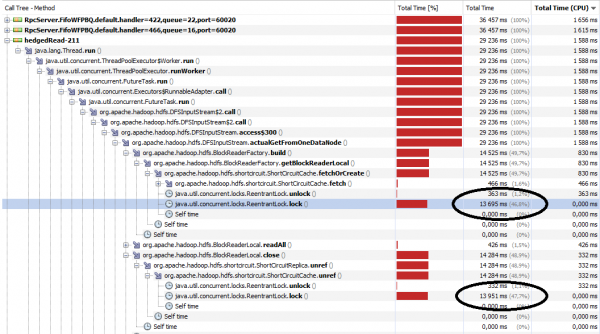
Al darnos cuenta de esto, entendimos que el problema se podría eludir creando un arreglo de SSC independientes:
private final ShortCircuitCache[] shortCircuitCache;
...
shortCircuitCache = new ShortCircuitCache[this.clientShortCircuitNum];
for (int i = 0; i < this.clientShortCircuitNum; i++)
  this.shortCircuitCache[i] = new ShortCircuitCache(…);
Y luego trabajar con ellos, excluyendo intersecciones también por el último dígito del offset:
public ShortCircuitCache getShortCircuitCache(long idx) {
    return shortCircuitCache[(int) (idx % clientShortCircuitNum)];
}
Ahora podemos proceder con las pruebas. Para esto, leeremos archivos de HDFS con una simple aplicación multihilo. Establecemos los parámetros:
conf.set("dfs.client.read.shortcircuit", "true");
conf.set("dfs.client.read.shortcircuit.buffer.size", "65536"); // por defecto = 1 MB y esto ralentiza mucho la lectura, así que es mejor ajustarlo a las necesidades reales
conf.set("dfs.client.short.circuit.num", num); // de 1 a 10
Y simplemente leemos los archivos:
FSDataInputStream in = fileSystem.open(path);
for (int i = 0; i  900000000)
        position = 0L;
    int res = in.read(position, byteBuffer, 0, 65536);
}
Este código se ejecuta en hilos separados y vamos a aumentar el número de archivos leídos simultáneamente (de 10 a 200 — eje horizontal) y la cantidad de cachés (de 1 a 10 — gráficos). El eje vertical muestra la aceleración que otorga el aumento de SSC en comparación con el caso cuando solo hay una caché.
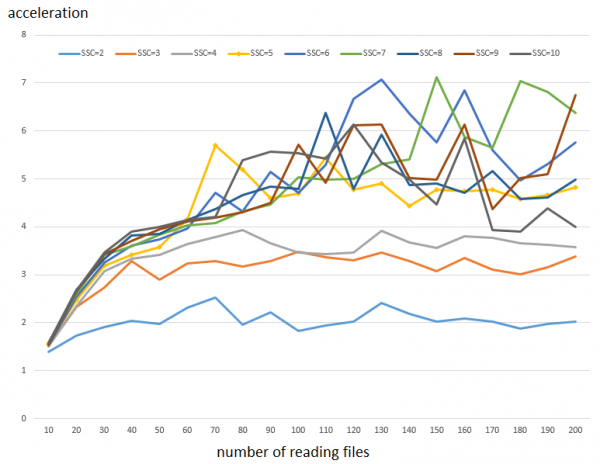
Cómo leer el gráfico: el tiempo de ejecución de 100,000 lecturas en bloques de 64 KB con una sola caché requiere 78 segundos. Mientras que con 5 cachés se realiza en 16 segundos. Es decir, hay una aceleración de ~5 veces. Como se puede ver en el gráfico, con un número pequeño de lecturas paralelas el efecto no es muy notable, esto empieza a jugar un papel significativo cuando el número de flujos de lectura supera 50. También es evidente que el aumento de la cantidad de SSC a 6 y más proporciona un incremento de rendimiento significativamente menor.
Nota 1: dado que los resultados de las pruebas son bastante volátiles (ver abajo), se realizaron 3 ejecuciones y los valores obtenidos fueron promediados.
Nota 2: El aumento del rendimiento de la configuración para acceso aleatorio es el mismo, aunque el acceso es un poco más lento.
Sin embargo, es necesario aclarar que, a diferencia del caso con HBase, esta aceleración no siempre es gratuita. Aquí estamos más en el proceso de "desbloquear" las capacidades de la CPU para realizar el trabajo, en vez de quedar atrapados en los bloqueos.
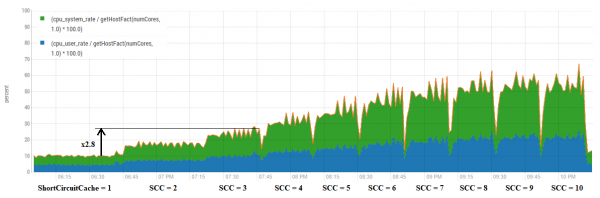
Aquí se puede observar que, en general, el aumento en la cantidad de cachés da un crecimiento aproximadamente proporcional en la utilización de la CPU. Sin embargo, hay algunas combinaciones que son más ventajosas.
Por ejemplo, examinemos más de cerca la configuración SSC = 3. El aumento en el rendimiento en ese rango es de aproximadamente 3.3 veces. A continuación se presentan los resultados de las tres ejecuciones individuales.
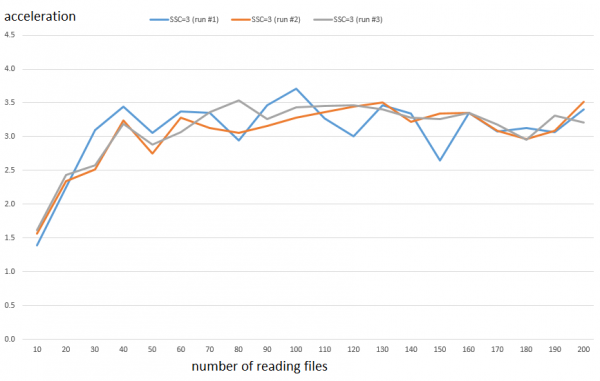
Mientras que el consumo de la CPU aumenta aproximadamente 2.8 veces. La diferencia no es muy grande, pero a la pequeña Greta ya le alegrará y posiblemente podrá encontrar tiempo para asistir a la escuela y a las lecciones.
De esta forma, esto tendrá un efecto positivo para cualquier herramienta que utilice acceso masivo a HDFS (por ejemplo Spark, etc.), siempre que el código de la aplicación sea ligero (es decir, el cuello de botella está del lado del cliente de HDFS) y haya capacidad libre en la CPU. Para comprobarlo, probemos qué efecto tendría la combinación de la optimización BlockCache y el ajuste SSC para la lectura desde HBase.
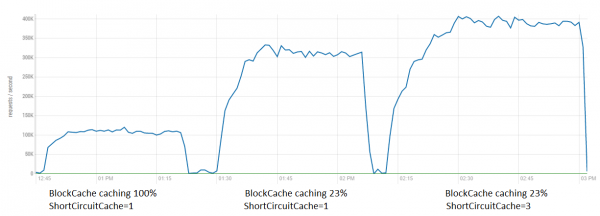
Aquí se observa que en tales condiciones, el efecto no es tan grande como en las pruebas refinadas (lectura sin ningún procesamiento), sin embargo, extraer un adicional de 80K es bastante factible. Juntas, ambas optimizaciones proporcionan una aceleración de hasta 4 veces.
También se realizó un PR sobre esta optimización , que fue fusionado y esta funcionalidad estará disponible en las próximas versiones.
Y, por último, fue interesante comparar el rendimiento de lectura de una base de datos de columnas amplias como Cassandra y HBase.
Para ello, se ejecutaron instancias de la herramienta estándar de prueba de carga YCSB desde dos hosts (800 hilos en total). En el lado del servidor, había 4 instancias de RegionServer y Cassandra en 4 hosts (diferentes a los de los clientes, para evitar su influencia). Las lecturas se realizaron desde tablas de tamaño:
HBase — 300 GB en HDFS (100 GB de datos limpios)
Cassandra — 250 GB (factor de replicación = 3)
Es decir, el volumen era aproximadamente el mismo (en HBase un poco más).
Parámetros de HBase:
dfs.client.short.circuit.num = 5 (optimización del cliente HDFS)
hbase.lru.cache.heavy.eviction.count.limit = 30 — esto significa que el parche comenzará a funcionar después de 30 desalojos (~5 minutos)
hbase.lru.cache.heavy.eviction.mb.size.limit = 300 — el volumen objetivo de almacenamiento en caché y desalojo
Los registros de YCSB fueron analizados y resumidos en gráficos de Excel:
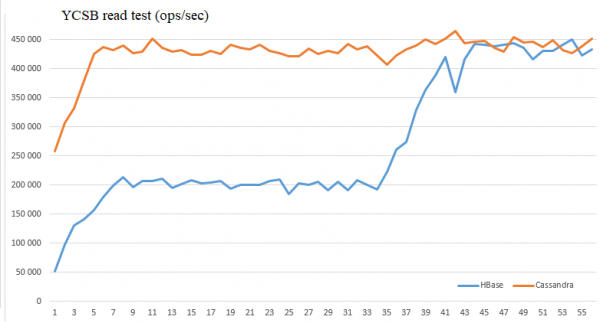
Como se puede ver, los datos de optimización permiten igualar el rendimiento de estas bases de datos en estas condiciones y alcanzar 450 mil lecturas por segundo.
Esperamos que esta información pueda ser útil para alguien en la fascinante lucha por el rendimiento.
Fuente: habr.com
