

El informe se centra en cuestiones prácticas del desarrollo de un operador en Kubernetes, el diseño de su arquitectura y los principios básicos de funcionamiento.
En la primera parte del informe, abordaremos:
- qué es un operador en Kubernetes y por qué es necesario;
- cómo el operador simplifica la gestión de sistemas complejos;
- qué puede hacer un operador y qué no puede hacer.
A continuación, pasaremos a discutir la estructura interna del operador. Revisaremos la arquitectura y el funcionamiento del operador paso a paso. Analizaremos en detalle:
- la interacción entre el operador y Kubernetes;
- qué funciones asume el operador y qué delega en Kubernetes.
Analizaremos la gestión de shards y réplicas de bases de datos en Kubernetes.
Luego, discutiremos preguntas sobre el almacenamiento de datos:
- cómo trabajar con almacenamiento persistente desde la perspectiva del operador;
- los obstáculos de usar almacenamiento local.
En la parte final del informe, examinaremos ejemplos prácticos de aplicación con Amazon o Google Cloud Service. El informe se basa en el desarrollo y la experiencia de operación de un operador para ClickHouse.
Video:
Me llamo Vladislav Klimenko. Hoy quería hablar sobre nuestra experiencia en el desarrollo y operación de un operador, específicamente se trata de un operador especializado para gestionar clústeres de bases de datos. Usaremos para gestionar el clúster de ClickHouse.
¿Por qué tenemos la oportunidad de hablar sobre el operador y ClickHouse?
- Nos dedicamos al soporte y desarrollo de ClickHouse.
- Actualmente tratamos de aportar poco a poco nuestro granito de arena al desarrollo de ClickHouse. Y somos los segundos después de Yandex en la cantidad de cambios realizados en ClickHouse.
- Hacemos esfuerzos por realizar proyectos adicionales para el ecosistema de ClickHouse.
Sobre uno de esos proyectos, me gustaría hablar. Se trata del ClickHouse-operator para Kubernetes.
En mi informe, me gustaría abordar dos temas:
- El primer tema es cómo funciona nuestro operador para gestionar bases de datos ClickHouse en Kubernetes.
- El segundo tema es cómo funciona cualquier operador, es decir, cómo interactúa con Kubernetes.
Estos dos temas se entrelazarán a lo largo de toda mi presentación.
¿A quién le interesará escuchar lo que intento contar?
- Será especialmente interesante para quienes operan operadores.
- O para aquellos que quieren crear el suyo propio, para entender cómo funciona internamente, cómo interactúa el operador con Kubernetes y cuáles son los posibles obstáculos.
Para entender mejor lo que vamos a discutir hoy, sería útil saber cómo funciona Kubernetes y tener una preparación básica en tecnologías de la nube.
¿Qué es ClickHouse? Es una base de datos columnar especializada en el procesamiento en línea de consultas analíticas. Y es completamente de código abierto.
Y necesitamos saber solo dos cosas. Hay que entender que es una base de datos, por lo que lo que voy a contar será aplicable prácticamente a cualquier base de datos. Y que el sistema de gestión de bases de datos ClickHouse escala muy bien, proporcionando prácticamente una escalabilidad lineal. Por lo tanto, el estado del clúster es algo natural para ClickHouse. Y nos interesa discutir cómo mantener un clúster de ClickHouse en Kubernetes.
¿Para qué se necesita allí? ¿Por qué no podemos seguir explotándolo de forma independiente? Las respuestas son en parte técnicas y en parte organizativas.
- En la práctica, cada vez más nos encontramos en la situación en la que, en grandes empresas, prácticamente todos los componentes ya están en Kubernetes. Las bases de datos quedan fuera.
- Y cada vez más surge la pregunta: "¿Es posible integrarlas dentro?". Por eso, las grandes empresas intentan maximizar la unificación de la gestión para poder manejar rápidamente sus almacenes de datos.
- Y esto ayuda especialmente si se necesita la máxima posibilidad de replicar lo mismo en un nuevo lugar, es decir, la máxima portabilidad.
¿Qué tan simple o complicado es? Claro que se puede hacer manualmente. Pero no es tan sencillo, porque se suma la complejidad de gestionar Kubernetes, además de la especificidad de ClickHouse. Y se produce una agregación.
Y todo esto genera un conjunto bastante grande de tecnologías, cuya gestión se vuelve ya bastante complicada, porque Kubernetes trae sus preguntas diarias sobre la explotación, y ClickHouse trae las suyas. Especialmente si tenemos varios ClickHouse, y necesitamos estar constantemente trabajando con ellos.
Con ClickHouse, en una configuración dinámica, hay un número considerable de preguntas que generan una carga constante en DevOps:
- Cuando queremos cambiar algo en ClickHouse, por ejemplo, añadir una réplica o un shard, tenemos que llevar a cabo la gestión de configuración.
- Luego hay que cambiar el esquema de datos, porque ClickHouse tiene una manera específica de fragmentar. Es necesario desglosar el esquema de datos y configurar las configuraciones.
- Se debe configurar la monitorización.
- Recopilación de registros para nuevos fragmentos, para nuevas réplicas.
- Preocuparse por la recuperación.
- Y el reinicio.
Son trabajos rutinarios que sería muy deseable facilitar en la operación.
Kubernetes ayuda bien en la operación, pero en aspectos básicos del sistema.
Kubernetes facilita y automatiza cosas como:
- La recuperación.
- El reinicio.
- La gestión del sistema de almacenamiento.
Esto es bueno, es la dirección correcta, pero no tiene idea completa de cómo operar un clúster de bases de datos.
Se quiere más, se desea que toda la base de datos funcione en Kubernetes.
Se busca algo como un gran botón mágico rojo, que al presionarlo despliegue y mantenga un clúster a lo largo de todo su ciclo de vida, con tareas diarias que deben resolverse. Un clúster ClickHouse en Kubernetes.
Y hemos tratado de crear una solución que ayude a facilitar el trabajo. Este es el ClickHouse-operator para Kubernetes de Altinity.
Un operador es un programa cuya tarea principal es gestionar otros programas, es decir, es un gestor.
Y contiene plantillas de comportamiento. Esto se puede denominar conocimientos codificados del área temática.
Y su tarea principal es facilitar la vida del DevOps y reducir el micromanagement, para que él (DevOps) ya piense en términos de alto nivel, es decir, que no se dedique a gestionar cada detalle manualmente.
Y el operador es un robot asistente que se ocupa de las microtareas y ayuda al DevOps.
¿Para qué se necesita un operador? Se destaca especialmente en dos cuestiones:
- Cuando el especialista que trabaja con ClickHouse no tiene suficiente experiencia, pero ya es necesario gestionar ClickHouse, el operador facilita la operación y permite gestionar un clúster de ClickHouse con una configuración bastante compleja, sin profundizar demasiado en los detalles de cómo funciona todo internamente. Simplemente se le dan tareas de alto nivel y esto funciona.
- Y la segunda tarea en la que se destaca más es cuando se necesita automatizar un gran número de tareas estándar. Despeja microtareas de los administradores de sistemas.
Esto es más necesario para aquellos que recién comienzan su camino o para los que necesitan dedicarse mucho a la automatización.
¿En qué se diferencia el enfoque basado en operadores de otros sistemas? Existe Helm. También ayuda a instalar ClickHouse, se pueden dibujar helm charts que incluso instalan un clúster completo de ClickHouse. Entonces, ¿cuál es la diferencia entre un operador y, por ejemplo, Helm?
La principal diferencia fundamental es que Helm es gestión de paquetes, mientras que el operador va un paso más allá. Esto cubre todo el ciclo de vida. No se trata solo de instalación, incluye tareas diarias como escalado, particionamiento, es decir, todo lo que debe hacerse durante el ciclo de vida (si es necesario, también la eliminación) lo resuelve el operador. Intenta automatizar y gestionar todo el ciclo de vida del software. Esta es su diferencia fundamental frente a otras soluciones disponibles.
Esta fue la parte introductoria, sigamos adelante.
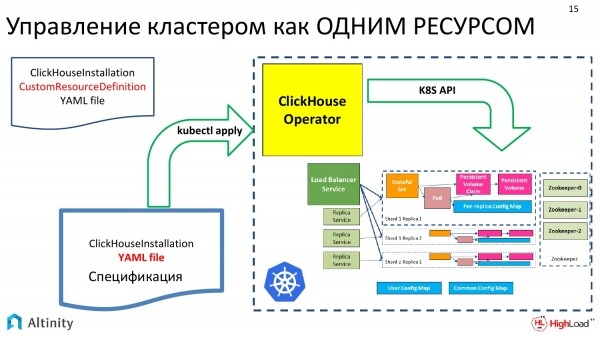
¿Cómo construimos nuestro operador? Intentamos abordar la cuestión para gestionar el clúster de ClickHouse como un único recurso.
Aquí a la izquierda de la imagen tenemos los datos de entrada. Este es un YAML con la especificación del clúster, que se transmite de manera clásica a Kubernetes a través de kubectl. Allí, nuestro operador lo capta, hace su magia y el resultado es este esquema. Esta es la implementación de ClickHouse en Kubernetes.
Y a continuación, iremos viendo poco a poco cómo funciona exactamente el operador, qué tareas estándar se pueden resolver. Solo analizaremos tareas estándar porque tenemos un tiempo limitado. Y no se hablará de todo lo que el operador puede resolver.
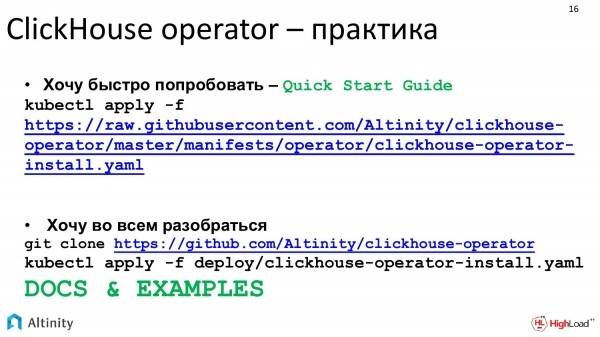
Partamos de la práctica. Nuestro proyecto es completamente open source, por lo que se puede ver en GitHub cómo funciona. Y también se puede partir de la consideración de que, si solo se desea iniciar, el Quick Start Guide es un buen punto de partida.
Si se desea profundizar en los detalles, nos esforzamos por mantener la documentación en un estado más o menos aceptable.
Comencemos con una tarea práctica. La primera tarea, desde la que todos queremos empezar, es ejecutar el primer ejemplo de cualquier manera. ¿Cómo ejecutar ClickHouse utilizando un operador, incluso sin saber muy bien cómo funciona? Escribimos un manifiesto, ya que toda comunicación con k8s se realiza a través de manifiestos.
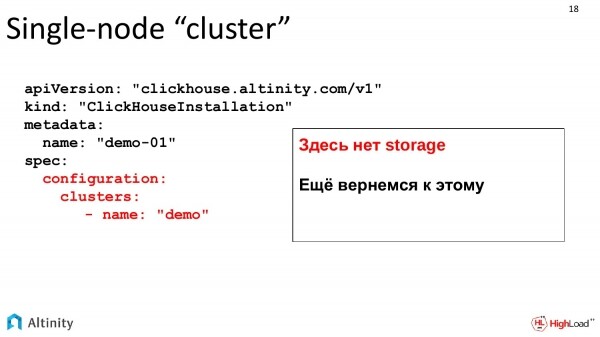
Este es un manifiesto complicado. Lo que está resaltado en rojo es lo que debemos enfatizar. Estamos pidiendo al operador que cree un clúster llamado demo.
Por ahora, estos son ejemplos básicos. El almacenamiento aún no se describe, pero volveremos al almacenamiento más adelante. Por ahora, observaremos el desarrollo del clúster en dinámica.
Hemos creado este manifiesto. Se lo proporcionamos a nuestro operador. Él trabajó y realizó la magia.
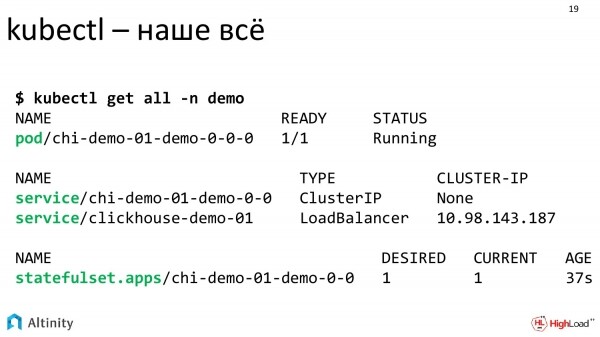
Miremos en la consola. Tres componentes llaman nuestra atención: un Pod, dos Services y un StatefulSet.
El operador ha trabajado y podemos ver qué es lo que ha creado.
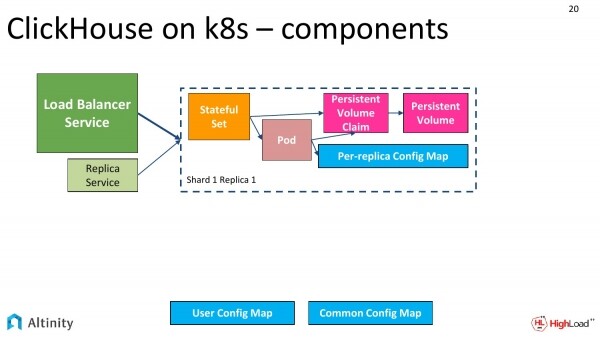
Crea aproximadamente este esquema. Tenemos un StatefulSet, un Pod, ConfigMap para cada réplica, ConfigMap para todo el clúster. Es imprescindible contar con servicios como puntos de entrada al clúster.
Los servicios son el servicio Load Balancer central y, además, se puede tener uno para cada réplica y cada shard.
Así es como se ve nuestro clúster básico. Consiste en una única nodo.
Sigamos adelante, vamos a complicar las cosas. Necesitamos shardear el clúster.
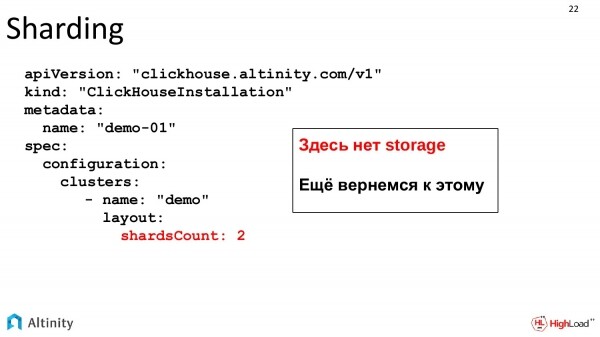
Nuestras tareas están aumentando, está surgiendo dinámica. Queremos agregar un shard. Seguimos el desarrollo. Modificamos nuestra especificación. Indicamos que queremos dos shards.
Este es el mismo archivo que se desarrolla dinámicamente con el crecimiento del sistema. No hay almacenamiento, pero se verá en detalle más adelante, es un tema aparte.
Proporcionamos el operador YAML y observamos qué sucede.
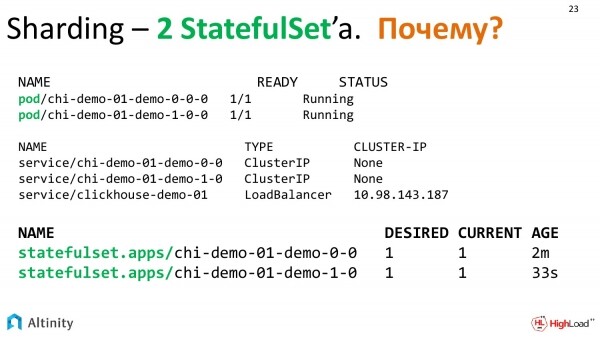
El operador pensó y creó las siguientes entidades. Ya tenemos dos Pods, tres Services y, inesperadamente, 2 StatefulSets. ¿Por qué 2 StatefulSets?
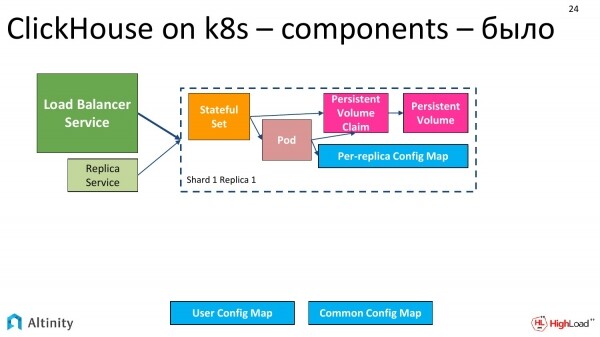
En el esquema estaba así: este es nuestro estado inicial, cuando teníamos un pod.
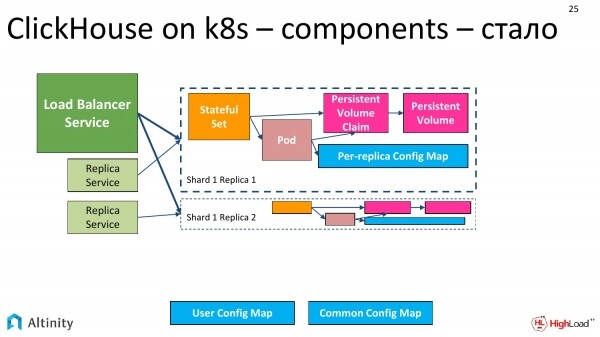
Ahora se ve así. Por ahora, todo es simple, se ha duplicado.
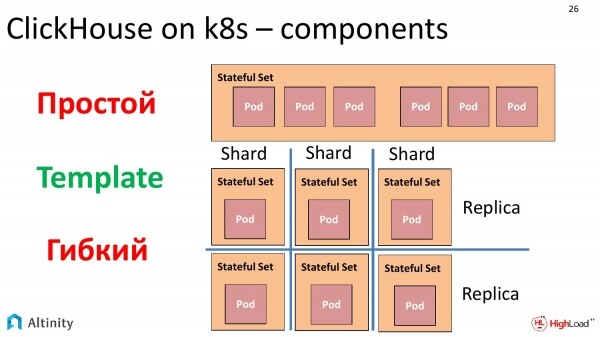
¿Y por qué se convirtió en dos StatefulSets? Aquí hay que desviarse y discutir cómo Kubernetes maneja los Pods.
Hay un objeto llamado StatefulSet, que permite crear un conjunto de Pods a partir de una plantilla. Aquí el factor clave es el Template. Y se pueden ejecutar muchos Pods a partir de un mismo template en un StatefulSet. La frase clave aquí es 'muchos Pods de una misma plantilla'.
Y había una gran tentación de hacer todo el clúster, empaquetándolo en un solo StatefulSet. Esto funcionará, no hay ningún problema con eso. Pero hay un matiz. Si queremos construir un clúster heterogéneo, es decir, de varias versiones de ClickHouse, aquí empiezan nuestras preguntas. Sí, StatefulSet puede hacer un rolling update, sí, se puede implementar una nueva versión, explicando que solo se deben intentar actualizar no más de ciertos nodos al mismo tiempo.
Pero si extrapolamos la tarea y decimos que queremos hacer un clúster completamente heterogéneo y que no deseamos cambiar de una versión antigua a una nueva mediante un rolling update, sino que simplemente queremos crear un clúster heterogéneo tanto en términos de diferentes versiones de ClickHouse como en diferentes tipos de almacenamiento. Queremos, por ejemplo, hacer algunas réplicas en discos separados, en discos lentos; en general, construir completamente un clúster heterogéneo. Y debido a que StatefulSet crea una solución estandarizada a partir de una plantilla, no es posible hacerlo.
Después de reflexionar un poco, se tomó la decisión de hacerlo de esta manera. Cada réplica está en su propio StatefulSet. Hay algunas desventajas en esta solución, pero en la práctica, todo esto está completamente encapsulado por el operador. Y hay un montón de ventajas. Podemos construir completamente el clúster que queramos, por ejemplo, absolutamente heterogéneo. Por lo tanto, en el clúster, donde tenemos dos shards con una réplica cada uno, tendremos 2 StatefulSets y 2 Pods precisamente porque elegimos este enfoque debido a las razones mencionadas anteriormente para poder construir un clúster heterogéneo.
Volvamos a las tareas prácticas. En nuestro clúster, es necesario configurar usuarios, es decir, se necesita realizar alguna configuración de ClickHouse en Kubernetes. El operador proporciona todas las posibilidades para esto.
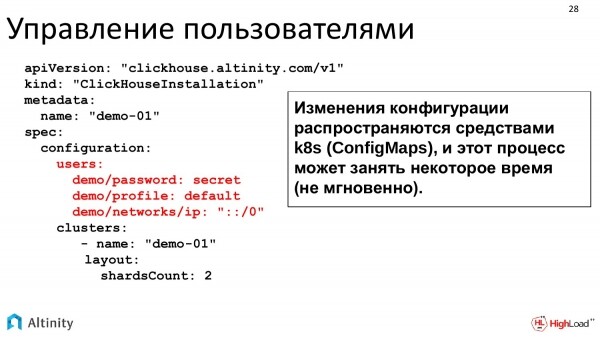
Se puede escribir directamente en YAML lo que queremos. Todas las opciones de configuración se mapean directamente de este YAML a las configuraciones de ClickHouse, que luego se distribuyen por todo el clúster.
También se puede escribir así. Esto es solo un ejemplo. La contraseña se puede hacer cifrada. Se admiten absolutamente todas las opciones de configuración de ClickHouse. Aquí solo hay un ejemplo.
La configuración del clúster se distribuye como ConfigMap. En la práctica, la actualización del ConfigMap no ocurre de inmediato, por lo que si el clúster es grande, el proceso de empuje de la configuración lleva algún tiempo. Pero todo esto es muy conveniente en operación.
Complicamos la tarea. El clúster se está desarrollando. Queremos replicar los datos. Es decir, ya tenemos dos shards, cada uno con una réplica, y los usuarios configurados. Estamos creciendo y queremos encargarnos de la replicación.
¿Qué necesitamos para la replicación?
Necesitamos ZooKeeper. En ClickHouse, la replicación se basa en ZooKeeper. ZooKeeper es necesario para que varias réplicas de ClickHouse tengan consenso sobre qué bloques de datos existen en qué instancia de ClickHouse.
Se puede usar cualquier ZooKeeper. Si la empresa tiene un ZooKeeper externo, se puede utilizar. Si no, se puede instalar desde nuestro repositorio. Hay un instalador que facilita todo esto.
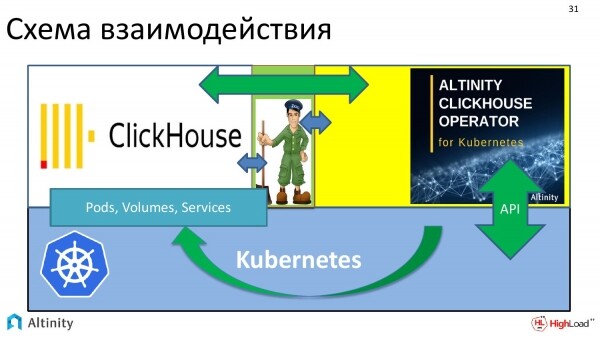
Y el esquema de interacción de todo el sistema resulta ser así. Tenemos Kubernetes como plataforma. En él se ejecuta el operador de ClickHouse. Aquí he representado a ZooKeeper. Y el operador interactúa tanto con ClickHouse como con ZooKeeper. Es decir, se genera una interacción.
Y todo esto es necesario para que ClickHouse replique los datos con éxito en k8s.
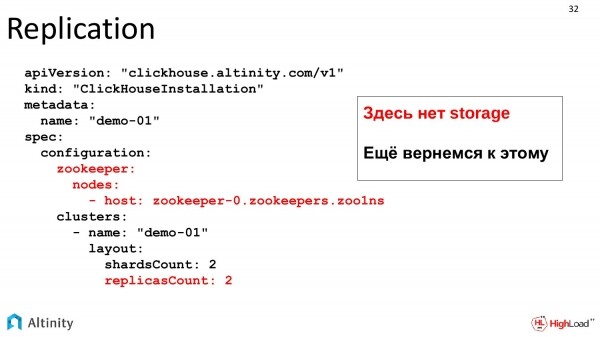
Ahora echemos un vistazo a la propia tarea, a cómo se verá el manifiesto para la replicación.
Agregamos dos secciones a nuestro manifiesto. La primera es de dónde obtener ZooKeeper, que puede estar dentro de Kubernetes o ser externo. Es solo una descripción. Y pedimos réplicas. Es decir, queremos dos réplicas. En total, deberíamos tener 4 pods. Recuerden que en cuanto al almacenamiento, volveremos a eso más adelante. El almacenamiento es una historia aparte.
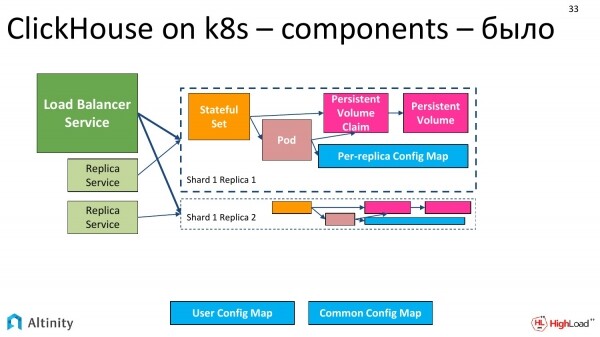
Así era antes.
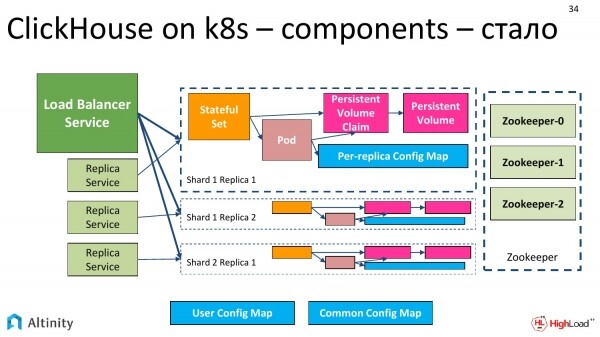
Así se ve ahora. Se agregan las réplicas. La cuarta no cabía, creemos que puede haber muchas. Y a un lado se agrega ZooKeeper. Los esquemas se complican.
Y ha llegado el momento de agregar la siguiente tarea. Vamos a añadir Almacenamiento Persistente.
 En cuanto al Almacenamiento Persistente, tenemos varias opciones de ejecución.
En caso de que estemos ejecutando en un proveedor de la nube, por ejemplo, utilizando Amazon o Google, hay una gran tentación de aprovechar el almacenamiento en la nube. Es muy conveniente, es bueno.
Y hay una segunda opción. Es para almacenamiento local, cuando tenemos discos locales en cada nodo. Esta opción es mucho más complicada de implementar, pero es más eficiente.
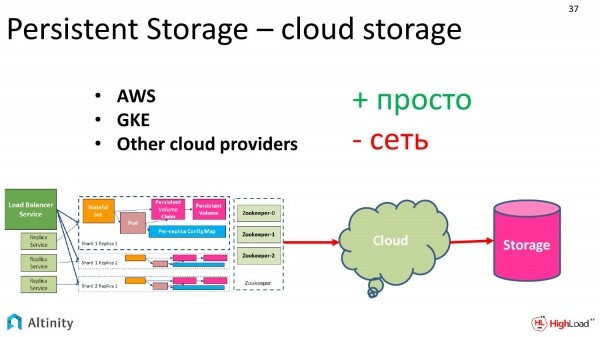
Veamos qué tenemos en relación al almacenamiento en la nube.
Tiene ventajas. Es muy fácil de configurar. Simplemente pedimos al proveedor de la nube que nos proporcione un almacenamiento de cierta capacidad y clase. Las clases son definidas por los proveedores.
Y hay una desventaja. Para algunos, esta no es una desventaja crítica. Por supuesto, habrá algunas sobrecargas de rendimiento. Es muy conveniente en el trabajo, confiable, pero hay ciertas caídas de rendimiento potenciales.
Y dado que ClickHouse se centra precisamente en el rendimiento, se puede incluso decir que aprovecha todo lo que puede, por lo que muchos clientes intentan extraer el máximo rendimiento.
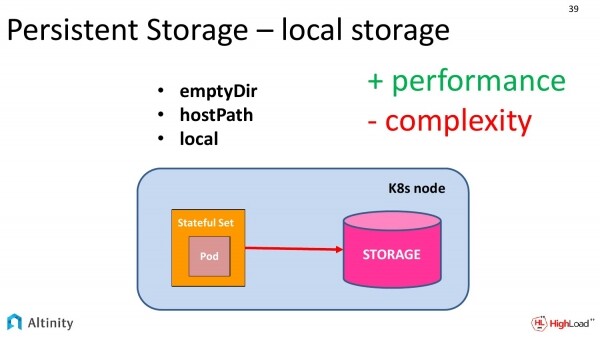
Y para extraer el máximo, necesitamos almacenamiento local.
Kubernetes proporciona tres abstracciones para usar almacenamiento local en Kubernetes. Estas son:
- EmptyDir
- HostPath.
- Local
Veamos en qué se diferencian y en qué se parecen.
En primer lugar, en los tres enfoques tenemos almacenamiento: son discos locales que están en el mismo nodo físico de k8s. Pero tienen algunas diferencias.
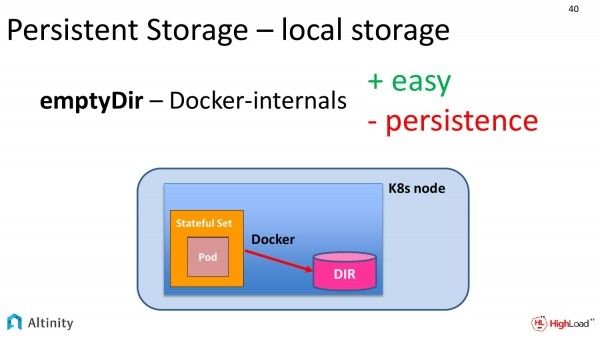
Empecemos con lo más simple, es decir, con emptyDir. ¿Qué es esto en la práctica? Es cuando pedimos a nuestra especificación que el sistema de contenedorización (la mayoría de las veces, Docker) nos proporcione acceso a una carpeta en el disco local.
En la práctica, Docker crea en algún lugar de su propio camino una carpeta temporal, la llama con un hash largo y proporciona una interfaz de acceso a ella.
¿Cómo funcionará esto en términos de rendimiento? Funcionará a la velocidad del disco local, es decir, hay acceso completo a su disco duro.
Pero esta opción tiene una desventaja. La persistencia en este caso es bastante dudosa. Al primer movimiento de Docker con los contenedores, la persistencia se pierde. Si Kubernetes decidiera por alguna razón mover este Pod a otro disco, los datos se perderían.
Este enfoque es bueno para pruebas, porque ya muestra una velocidad normal, pero no es adecuado para algo serio.
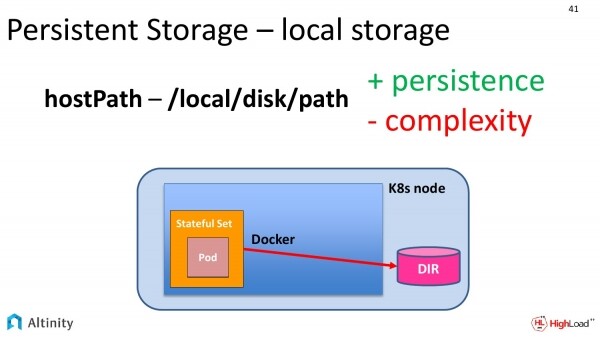
Por eso hay un segundo enfoque. Este es hostPath. Si miras la diapositiva anterior y esta, puedes ver una sola diferencia. Nuestra carpeta ha salido de Docker directamente a la nodo de Kubernetes. Aquí es un poco más simple. Simplemente especificamos el camino en el sistema de archivos local donde nos gustaría almacenar nuestros datos.
Las ventajas de este método son claras. Es un verdadero almacenamiento persistente, de hecho, clásico. Los datos se registrarán en el disco en una dirección específica.
También hay desventajas. La complejidad de gestión. Nuestro Kubernetes puede querer mover un Pod a otro nodo físico. Y aquí es donde entra en juego DevOps. Debe explicar correctamente a todo el sistema que estos pods solo se pueden mover a nodos en los que tengas algo montado por estos caminos, y no más de un nodo a la vez. Esto es bastante complicado.
Con este propósito, hemos creado plantillas en nuestro operador para ocultar toda esta complejidad. Y podría simplemente decir: "Quiero que tenga una instancia de ClickHouse en cada nodo físico y en tal ruta".
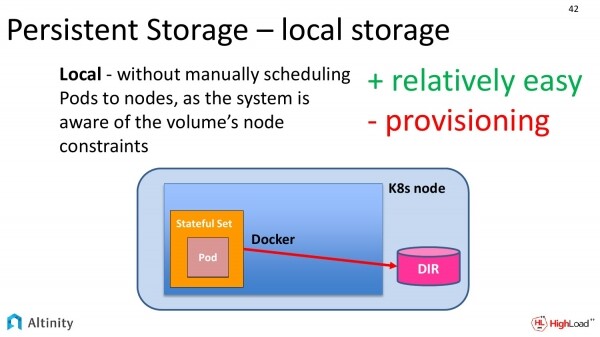
Pero esta necesidad no solo nos concierne a nosotros, por lo que los caballeros de Kubernetes también comprenden que a la gente le gustaría tener acceso a discos físicos, y por eso proporcionan un tercer nivel.
Se llama local. La diferencia con la diapositiva anterior es prácticamente ninguna. Solo que antes había que realizar manualmente el proceso, que no se podían mover estos pods de nodo a nodo porque debían estar conectados a un disco físico local en una ruta específica, y ahora todo ese conocimiento se encapsula en Kubernetes. Y resulta mucho más fácil de configurar.
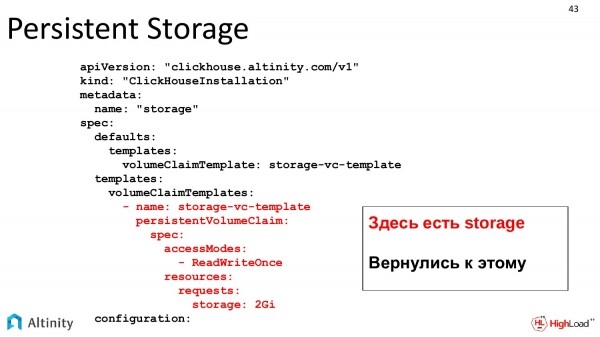
Regresamos a nuestra tarea práctica. Volvamos a la plantilla YAML. Aquí tenemos un almacenamiento real. Hemos regresado a esto. Estamos definiendo un clásico VolumeClaim template como en k8s. Y describimos qué almacenamiento queremos.
Después de esto, k8s solicitará almacenamiento. Nos lo asignará en StatefulSet. Y al final esto quedará a disposición de ClickHouse.
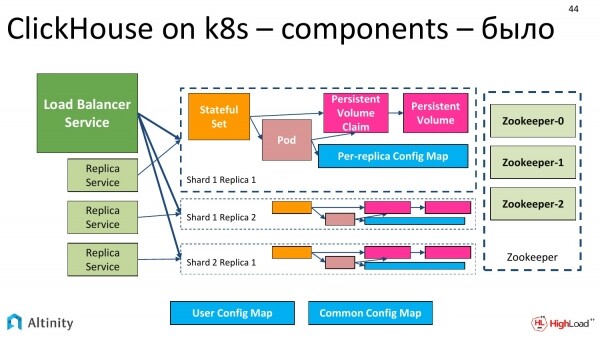
Tenía un esquema como este. Nuestro Almacenamiento Persistente estaba en rojo, lo que indicaba que debería hacerse.
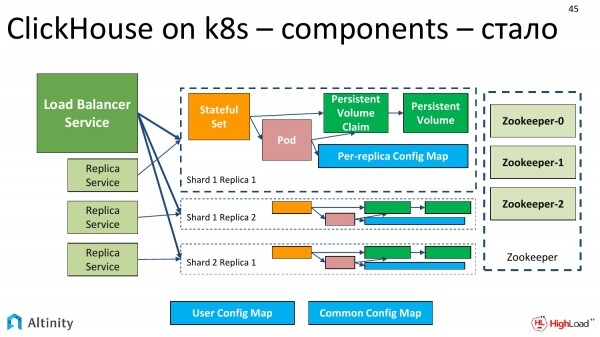
Y ahora se vuelve verde. Ahora el esquema del clúster ClickHouse en k8s está completamente finalizado. Tenemos shards, réplicas, ZooKeeper, hay un verdadero Persistente, que se implementa de una forma u otra. El esquema ya es completamente funcional.
Seguimos avanzando. Nuestro clúster está en desarrollo. Y Alexey se esfuerza, lanzando una nueva versión de ClickHouse.
Surge la tarea práctica: probar la nueva versión de ClickHouse en nuestro clúster. Y, por supuesto, no queremos implementarla en su totalidad, quisiéramos instalar una nueva versión en algún rincón lejano, o tal vez no solo una nueva versión, sino dos a la vez, porque salen con frecuencia.
¿Qué podemos decir al respecto?
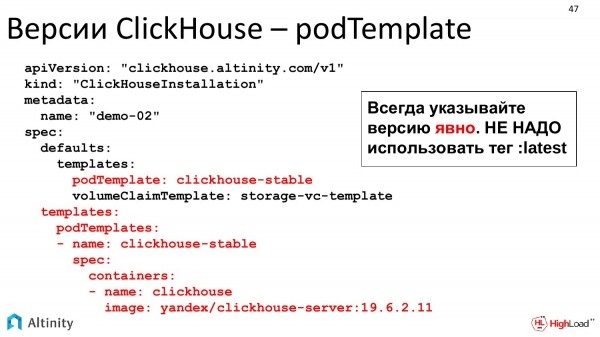
Aquí tenemos la oportunidad justa. Son plantillas de pod. Se puede detallar, nuestro operador permite construir un clúster heterogéneo. Es decir, configurando desde todas las réplicas en grupo, hasta cada réplica personal en la versión de ClickHouse que queremos, y la versión de almacenamiento que deseamos. Podremos configurar completamente un clúster de la manera que nos necesite.
Ahora nos adentraremos un poco más. Hasta ahora, hemos hablado de cómo funciona el ClickHouse-operator en relación a la especificidad de ClickHouse.
Ahora me gustaría hablar brevemente sobre cómo funciona cualquier operador en general, así como de cómo interactúa con K8s.
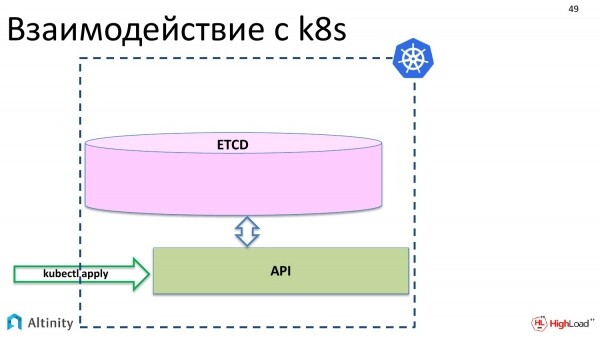
Comencemos con la interacción con K8s. ¿Qué sucede cuando hacemos kubectl apply? A través de la API en etcd aparecen nuestros objetos.
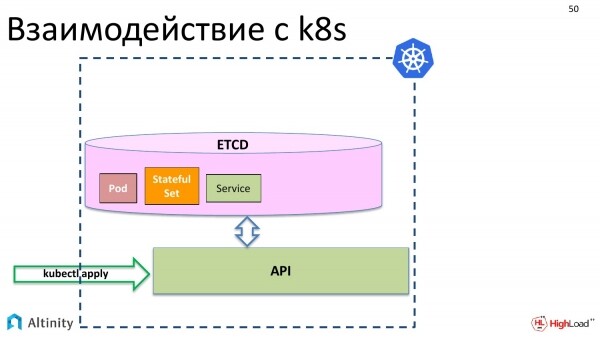
Por ejemplo, los objetos básicos de Kubernetes: pod, StatefulSet, servicio, y así sucesivamente.
Sin embargo, aún no ocurre nada físico. Estos objetos deben materializarse en el clúster.
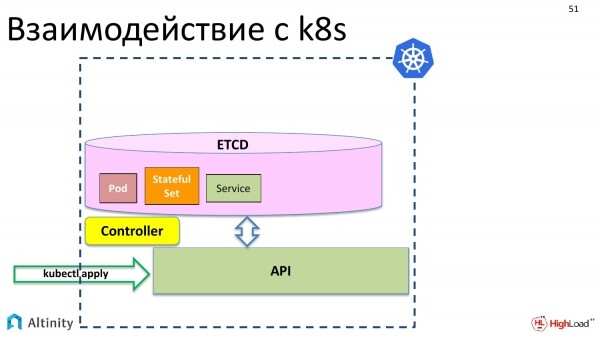
Para esto, aparece el controlador. El controlador es un componente especial de k8s que puede materializar estas descripciones. Sabe cómo y qué hacer físicamente. Sabe cómo iniciar contenedores y qué debe configurarse para que el servidor funcione.
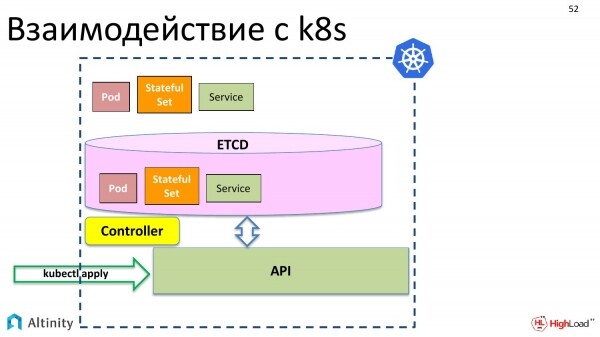
Y materializa nuestros objetos en K8s.
Pero queremos operar no solo con pods y StatefulSets, sino que queremos crear un ClickHouseInstallation, es decir, un objeto del tipo ClickHouse, para operarlo como un todo. Hasta ahora, esa posibilidad no existe.
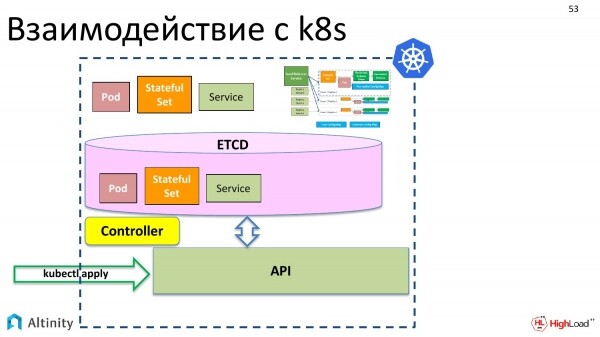
Pero K8s tiene algo muy agradable. Queremos que haya una entidad compleja que reúna nuestro clúster formado por pods y StatefulSets.
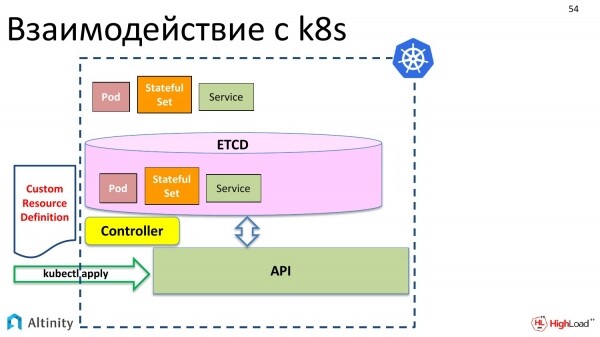
¿Y qué debemos hacer para esto? En primer lugar, entra en escena la Custom Resource Definition. ¿Qué es esto? Es una descripción para K8s de que tendrás otro tipo de datos, que queremos agregar un recurso personalizado que será complejo dentro de pods y StatefulSets. Esta es la descripción de la estructura de datos.
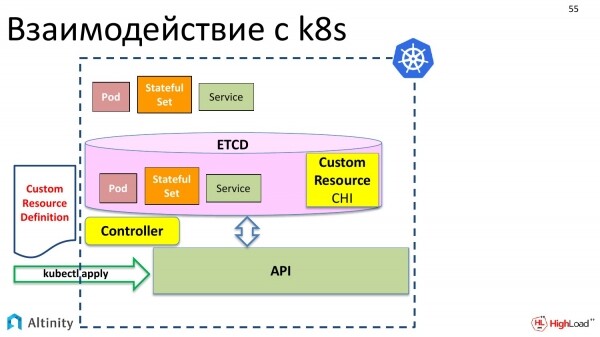
También lo enviamos allí a través de kubectl apply. Kubernetes lo recibió con gusto.
Y ahora tenemos la posibilidad de registrar un recurso personalizado llamado ClickHouseInstallation en el almacenamiento del objeto en etcd.
Pero por el momento no sucederá nada más. Es decir, si ahora creamos un archivo YAML que hemos discutido con la descripción de shards, réplicas y decimos "kubectl apply", Kubernetes lo aceptará, lo colocará en etcd y dirá: "Perfecto, pero no sé qué hacer con él. No sé cómo gestionar ClickHouseInstallation".
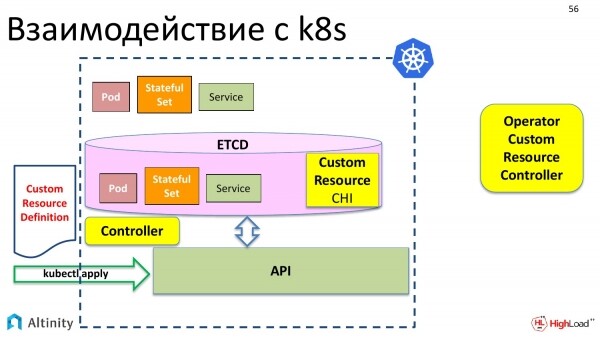
Por lo tanto, necesitamos a alguien que ayude a Kubernetes a gestionar un nuevo tipo de datos. A la izquierda tenemos un controlador integrado de Kubernetes que trabaja con tipos de datos estándar. A la derecha debe aparecer un controlador personalizado que sabe trabajar con tipos de datos personalizados.
Y su nombre alternativo es operador. Lo he destacado aquí fuera de Kubernetes porque puede ejecutarse fuera de K8s. La mayoría de las veces, por supuesto, todos los operadores se ejecutan en Kubernetes, pero nada impide que se ejecute externamente, por eso aquí se ha presentado fuera.
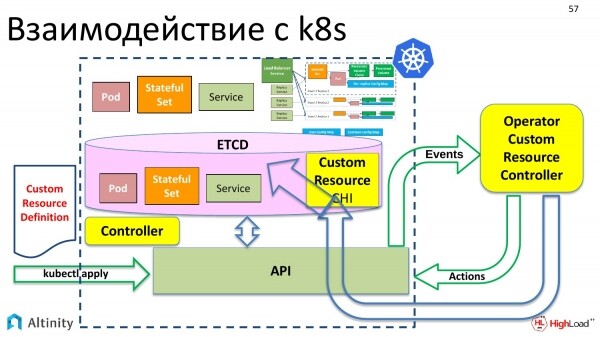
Y, por su parte, el controlador personalizado, también conocido como operador, interactúa con Kubernetes a través de la API. Ya sabe cómo interactuar con la API. Y ya sabe cómo materializar un esquema complejo a partir de un recurso personalizado que deseamos crear. Precisamente para eso sirve el operador.
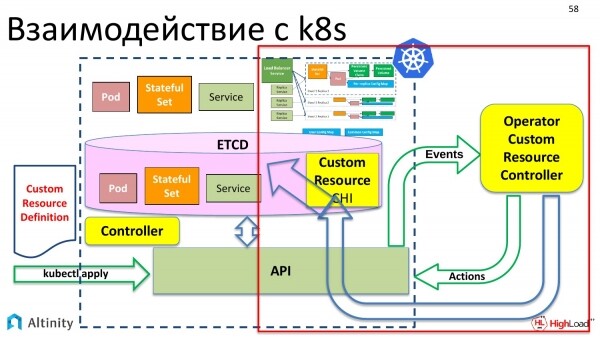
¿Cómo funciona el operador? Vamos a echar un vistazo al lado derecho para descubrir cómo lo hace. Vamos a averiguar cómo el operador materializa todo esto y cómo continúa la interacción con K8s.
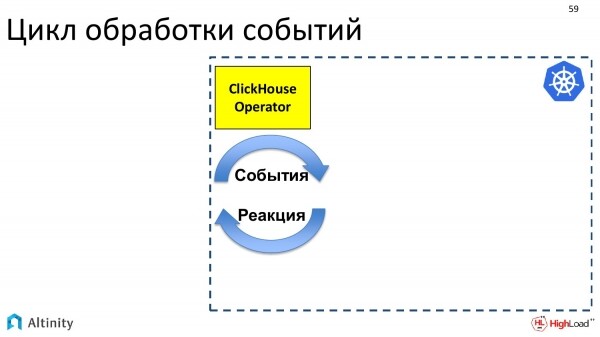
El operador es un programa. Su enfoque es basado en eventos. El operador, a través de la API de Kubernetes, se suscribe a eventos. En la API de Kubernetes hay puntos de entrada donde se puede suscribir a eventos. Y si algo cambia en K8s, Kubernetes envía eventos a todos los interesados, es decir, quien esté suscrito a ese punto de API recibirá las notificaciones.
El operador se suscribe a eventos y debe realizar alguna reacción. Su tarea es reaccionar a los eventos que aparecen.
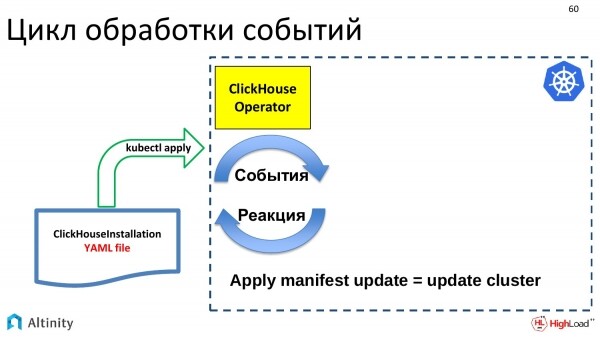
Los eventos se generan a través de ciertas actualizaciones. Nuestro archivo YAML con la descripción de ClickHouseInstallation llega. A través de kubectl apply, fue a etcd. Allí se activó un evento, y este evento llegó al operador de ClickHouse. El operador recibió esta descripción. Y debe hacer algo al respecto. Si ha llegado una actualización al objeto ClickHouseInstallation, entonces es necesario actualizar el clúster. Y la tarea del operador es actualizar el clúster.
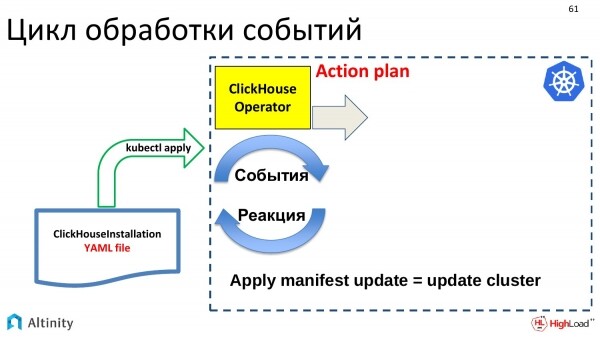
¿Qué hace? Primero, es necesario elaborar un plan de acción sobre qué haremos con esta actualización. Las actualizaciones pueden ser muy pequeñas, es decir, pequeñas en la ejecución de YAML, pero pueden llevar a grandes cambios en el clúster. Por lo tanto, el operador crea un plan y luego se adhiere a él.
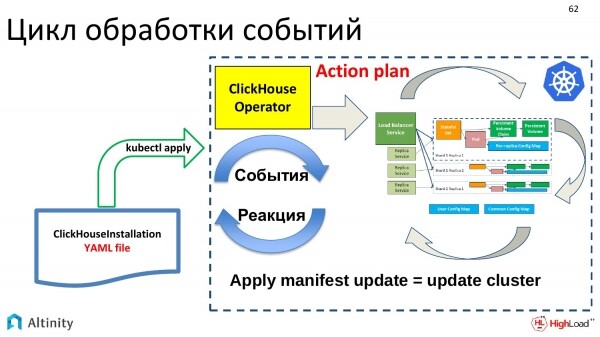
Él comienza a implementar esta estructura según el plan, para materializar pods, servicios, es decir, hacer lo que es su tarea principal. Es como construir un clúster de ClickHouse en Kubernetes.
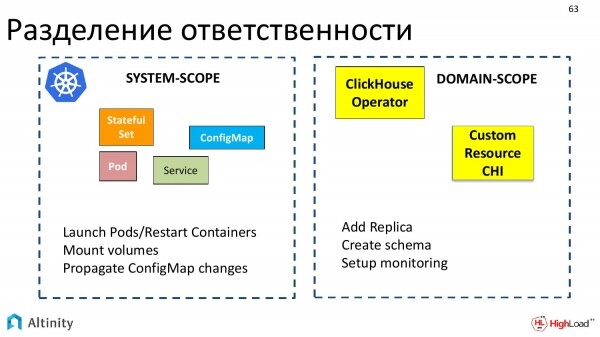
Ahora, hablemos de algo interesante. Esta es la división de responsabilidades entre Kubernetes y el operador, es decir, qué hace Kubernetes, qué hace el operador y cómo interactúan entre sí.
Kubernetes se encarga de las cosas del sistema, es decir, de un conjunto básico de objetos que se puede interpretar como de ámbito del sistema. Kubernetes sabe cómo iniciar pods, cómo reiniciar contenedores, cómo montar volúmenes, cómo trabajar con ConfigMap, es decir, todo lo que se puede denominar sistema.
Los operadores operan en dominios específicos. Cada operador se crea para su propio dominio específico. Nosotros hicimos uno para ClickHouse.
Y el operador interactúa precisamente en términos del dominio específico, como agregar una réplica, crear un esquema, configurar la supervisión. Así se produce esta división.
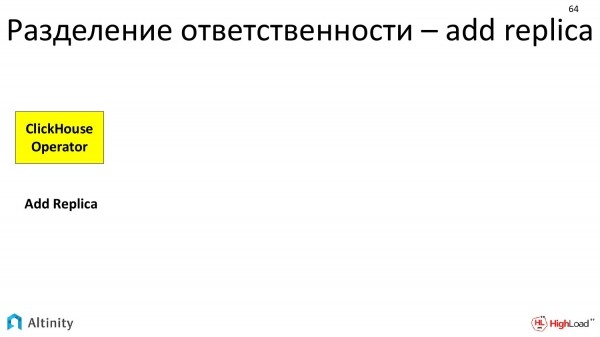
Veamos un ejemplo práctico de cómo ocurre esta división de responsabilidades cuando realizamos la acción de agregar una réplica.
Al operador llega la tarea: agregar una réplica. ¿Qué hace el operador? El operador calculará que necesita crear un nuevo StatefulSet, en el que se deben describir ciertas plantillas, reclamos de volumen.
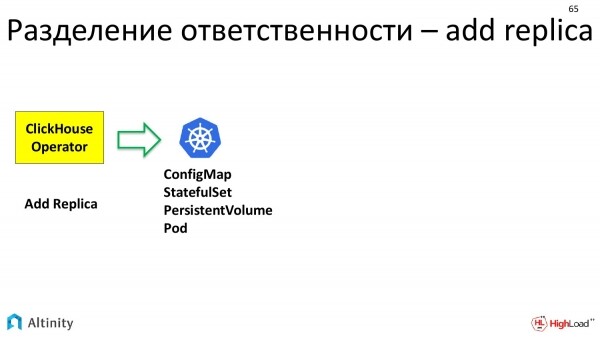
Él prepara todo esto y lo pasa a K8s. Indica que necesita ConfigMap, StatefulSet, Volumen. Kubernetes lo procesa. Materializa las unidades básicas con las que operación.
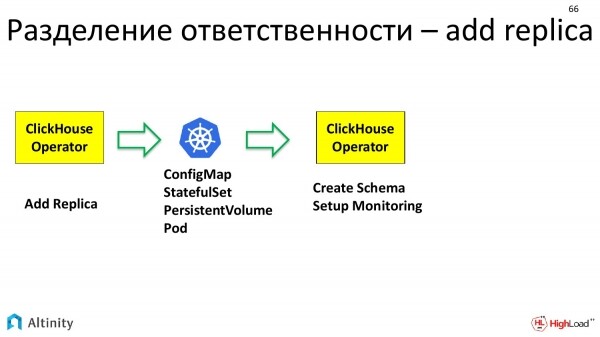
Y luego entra nuevamente en juego el ClickHouse-operator. Ya tiene un pod físico, sobre el cual se puede trabajar. Y ClickHouse-operator nuevamente trabaja en términos del dominio específico. Es decir, para incluir una réplica en el clúster, primero hay que configurar el esquema de datos que existe en este clúster. Y, en segundo lugar, esta réplica debe incluirse en la supervisión para que sea monitoreada de manera efectiva. Esto lo configura el operador.
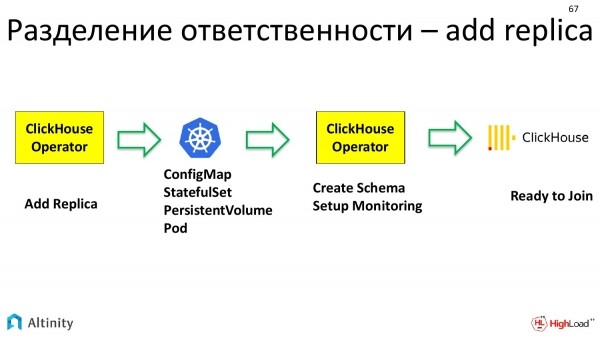
Y solo después de eso, entra en juego ClickHouse, es decir, otra entidad de nivel superior. Esta ya es una base de datos. Tiene su propia instancia, una réplica configurada, que está lista para unirse al clúster.
La cadena de ejecución y separación de responsabilidades al agregar una réplica es bastante larga.
Continuamos con nuestras tareas prácticas. Si ya existe un clúster, podemos llevar a cabo la migración de la configuración.
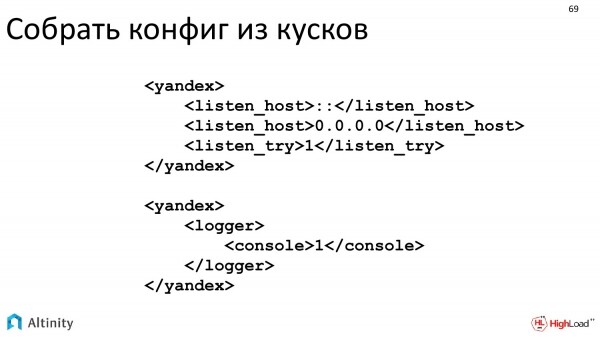
Hicimos que en el XML existente, que ClickHouse entiende, se pueda trasmitir a través.
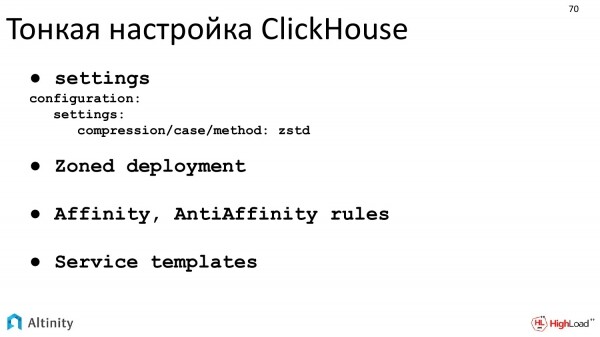
Se puede hacer un ajuste fino de ClickHouse. Justo el despliegue zonificado es de lo que hablé al explicar hostPath y almacenamiento local. Es cómo hacer correctamente un despliegue zonificado.
La siguiente tarea práctica es la monitorización.
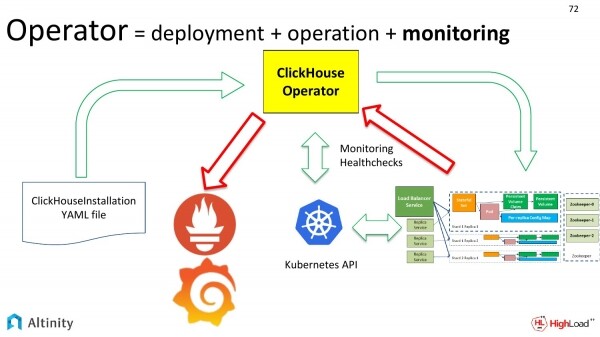
Si nuestro clúster cambia, debemos ajustar periódicamente la monitorización.
Veamos el esquema. Ya hemos revisado las flechas verdes. Ahora veamos las flechas rojas. Así es como queremos monitorizar nuestro clúster. Cómo las métricas del clúster de ClickHouse llegan a Prometheus y luego a Grafana.
¿Y cuál es la dificultad con la monitorización? ¿Por qué se considera un logro? La complejidad radica en la dinámica. Cuando tenemos un solo clúster y es estático, se puede configurar la monitorización una vez y no volver a preocuparse.
Pero si tenemos muchos clústeres, o si algo cambia constantemente, el proceso es dinámico. Y estar continuamente reconfigurando la monitorización es una pérdida de recursos y tiempo, es decir, simplemente pereza. Esto debe automatizarse. La dificultad está precisamente en la dinámica del proceso. Y el operador lo automatiza muy bien.
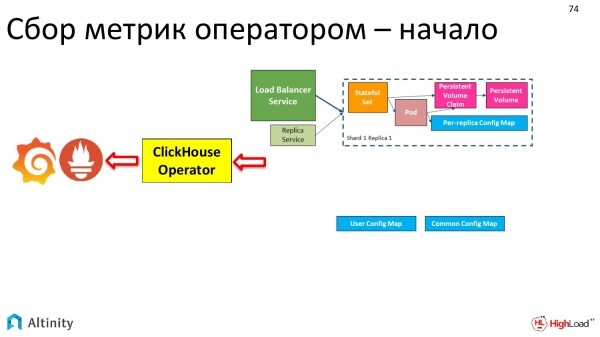
¿Cómo ha evolucionado nuestro clúster? Al principio era así.
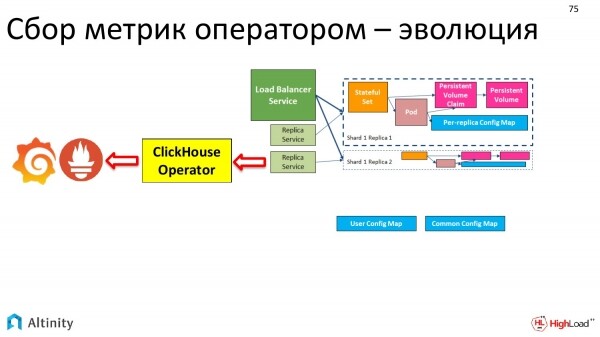
Luego fue así.
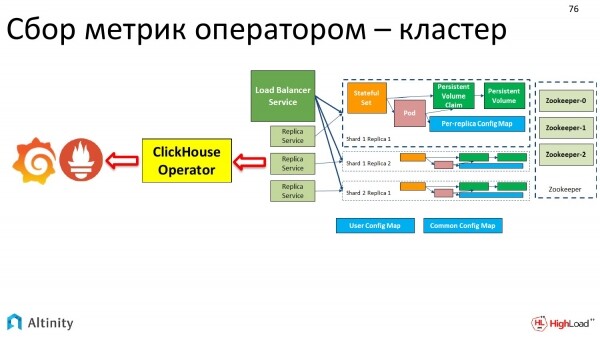
Al final, se convirtió en esto.
Y la monitorización se realiza automáticamente por el operador. Un único punto de entrada.
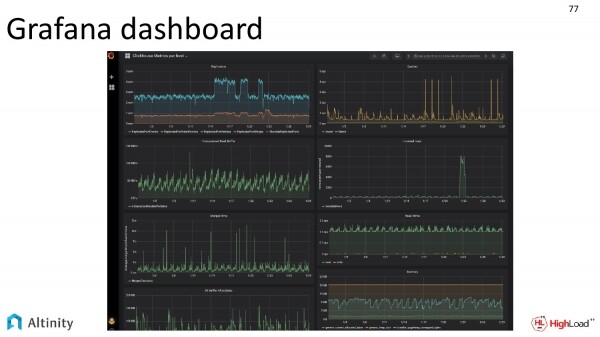
Y solo miramos en el panel de Grafana cómo está la vida interna de nuestro clúster.
Por cierto, el panel de Grafana también se distribuye con nuestro operador directamente en los fuentes. Se puede conectar y usar. Este pantallazo me lo dieron nuestros DevOps.
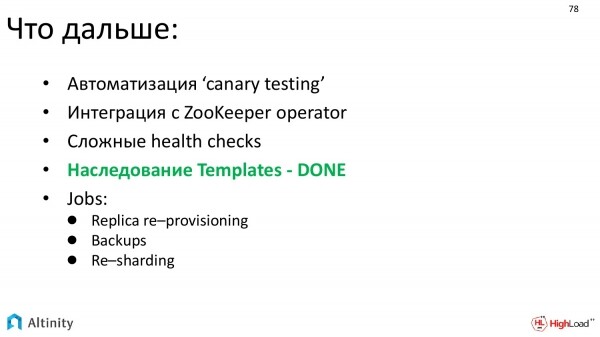
¿A dónde nos gustaría avanzar? Esto es:
- Desarrollar la automatización de pruebas. La tarea principal es la prueba automatizada de nuevas versiones.
- También queremos automatizar la integración con ZooKeeper. Y está en nuestros planes integrarnos con ZooKeeper-operator. Es decir, para ZooKeeper se ha escrito un operador y tiene sentido que ambos operadores comiencen a integrarse para construir una solución más conveniente.
- Queremos hacer comprobaciones de vida más complejas.
- He destacado en verde lo que se aproxima: la herencia de Templates - LISTO, es decir, con la próxima versión del operador ya tendremos herencia de plantillas. Esta es una herramienta poderosa que permite construir configuraciones complejas a partir de fragmentos.
- Y queremos la automatización de tareas complejas. La principal de ellas es el Re-sharding.
Hagamos un resumen intermedio.
¿Qué obtenemos al final? ¿Vale la pena o no? ¿Es necesario intentar llevar la base de datos a Kubernetes y aplicar el operador en general y el operador Alitnity en particular?
Al final obtenemos:
- Una simplificación y automatización significativas de la configuración, despliegue y mantenimiento.
- Monitoreo incorporado de inmediato.
- Y plantillas codificadas listas para usar en situaciones complejas. Ya no es necesario hacer manualmente acciones como agregar una réplica. Esto lo hace el operador.
Solo queda una última pregunta. Ya tenemos la base de datos en Kubernetes, virtualización. ¿Qué pasa con el rendimiento de esta solución, especialmente considerando que ClickHouse está optimizado para el rendimiento?
La respuesta es: ¡todo está bien! No entraré en detalles, este es un tema para otra presentación.
Pero existe un proyecto como TSBS. ¿Cuál es su tarea principal? Es una prueba de bases de datos para medir el rendimiento. Es un intento de comparar lo similar con lo similar.
¿Cómo funciona? Se genera un conjunto de datos. Luego, este conjunto de datos se ejecuta en diferentes bases de datos utilizando el mismo conjunto de pruebas. Cada base de datos resuelve un problema de la manera que puede. Y después se pueden comparar los resultados.
Ya admite una gran cantidad de bases de datos. He destacado tres principales. Son:
- TimescaleDB.
- InfluxDB.
- ClickHouse.
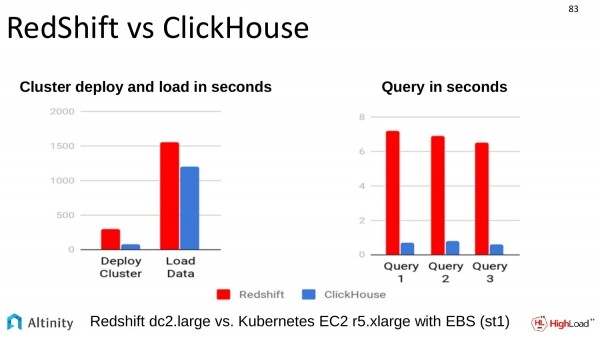
También se realizó una comparación con otra solución similar. La comparación fue con RedShift. Se realizó la comparación en Amazon. ClickHouse también supera a todos en este aspecto.
¿Qué conclusiones se pueden extraer de lo que he contado?
- Es posible usar bases de datos en Kubernetes. Probablemente se puedan usar cualquier tipo de base de datos, pero en general parece que sí se puede. Definitivamente se puede usar ClickHouse en Kubernetes con la ayuda de nuestro operador.
- El operador ayuda a automatizar procesos y realmente simplifica la vida.
- El rendimiento es normal.
- Y nos parece que esto es algo que se puede y se debe utilizar.
¡Código abierto – únanse!
Como ya mencioné, el operador es un producto completamente de código abierto, por lo que sería muy bueno que la mayor cantidad posible de personas lo utilizara. ¡Únanse! ¡Los esperamos a todos!
¡Gracias a todos!
Preguntas
¡Gracias por la presentación! Me llamo Anton. Soy de la empresa SEMrush. Estoy interesado en el tema del registro. Se escucha sobre monitoreo, pero no sobre registro, si hablamos del clúster en su totalidad. Nosotros, por ejemplo, tenemos un clúster montado en hardware. Y utilizamos registro centralizado, recolectamos datos estándar en un solo lugar. Y luego sacamos de ahí los datos que nos interesan.
Buena pregunta, es decir, el registro está en la lista de tareas pendientes. Nuestro operador aún no lo automatiza. Aún está en desarrollo, el proyecto es bastante joven. Entendemos la necesidad del registro. Este también es un tema muy importante. Y probablemente no es menos importante que el monitoreo. Pero lo primero en la lista para su implementación fue el monitoreo. El registro vendrá. Naturalmente, estamos tratando de automatizar todos los aspectos de la vida del clúster. Por lo tanto, la respuesta es que en este momento el operador, desafortunadamente, no puede hacerlo, pero está en nuestros planes, lo haremos. Si hay deseos de unirse, por favor, un pull request.
¡Hola! ¡Gracias por la presentación! Tengo una pregunta estándar relacionada con los Volúmenes Persistentes. Cuando creamos una configuración con este operador, ¿cómo determina el operador en qué nodo se ha montado un disco o carpeta en particular? ¿Debemos explicarle que, por favor, coloque nuestro ClickHouse solo en esos nodos donde hay un disco?
Hasta donde entiendo, esta pregunta es una continuación del almacenamiento local, especialmente la parte relacionada con hostPath. Se trata de cómo explicarle a todo el sistema que el pod debe ejecutarse específicamente en un nodo determinado, donde tenemos un disco físico conectado, que está montado en una ruta específica. Esta es toda una sección que toqué de manera muy superficial, porque la respuesta es bastante extensa.
En resumen, se ve así. Necesitamos, por supuesto, hacer el aprovisionamiento de estos volúmenes. En este momento, no hay aprovisionamiento dinámico en el almacenamiento local, por lo que los DevOps deben crear los discos, es decir, estos volúmenes. Y deben explicarle a Kubernetes sobre el aprovisionamiento, que tendrás volúmenes persistentes de tal clase, que están en tales nodos. Luego, será necesario explicarle a Kubernetes que los pods que requieren tal clase de almacenamiento local deben ser programados solo en esos nodos, basándose en las etiquetas. Para estos fines, el operador tiene la posibilidad de asignar alguna etiqueta y una por instancia de host. Y resultará que los pods serán enrutados por Kubernetes para ejecutarse solo en nodos que cumplen con los requisitos de las etiquetas, dicho de manera simple. Los administradores asignan etiquetas y hacen el aprovisionamiento de discos manualmente. Y entonces se escala.
Y precisamente la tercera opción local ayuda a facilitar esto un poco. Como ya hice énfasis, es un trabajo detallado de configuración, que al final ayuda a obtener el rendimiento máximo.
Tengo una segunda pregunta relacionada con esto. Kubernetes fue diseñado de tal manera que no nos importa si perdemos un nodo o no. ¿Qué debemos hacer en este caso si hemos perdido el nodo donde tenemos un shard?
Sí, Kubernetes fue inicialmente posicionado con la idea de que nuestra relación con nuestros pods es como la de ganado, pero aquí cada disco se convierte en algo así como una mascota. Hay un problema en que no podemos simplemente desecharlos. Y el desarrollo de Kubernetes va en la dirección de que no es posible tratar esto completamente de manera filosófica, como si fueran recursos totalmente desechables.
Ahora una pregunta práctica. ¿Qué hacer si has perdido un nodo en el que estaba el disco? Aquí la tarea se resuelve a un nivel más alto. En el caso de ClickHouse, tenemos réplicas que operan a un nivel superior, es decir, al nivel de ClickHouse.
¿Cuál es la disposición resultante? DevOps es responsable de que no se pierdan los datos. Debe configurar correctamente la replicación y debe asegurarse de que la replicación se ejecute. En la réplica a nivel de ClickHouse, los datos deben estar duplicados. Esta no es la tarea que resuelve el operador. Y no es la tarea que resuelve Kubernetes mismo. Esto es a nivel de ClickHouse.
¿Qué hacer si se ha caído un nodo físico? Entonces, será necesario instalar uno nuevo, correctamente provisionar el disco en él y aplicar las etiquetas. Después de eso, cumplirá con los requisitos para que Kubernetes pueda ejecutar una instancia de pod en él. Kubernetes lo iniciará. De hecho, no tienes suficientes pods para el requerido. Pasará por el ciclo que te mostré. Y en el nivel más alto, ClickHouse entenderá que ha entrado una réplica que aún está vacía y a la que hay que empezar a transferir datos. Es decir, este proceso todavía está mal automatizado.
¡Gracias por la presentación! Cuando ocurren problemas, se cae el operador y se reinicia, y en ese momento llegan eventos, ¿cómo los manejas?
¿Qué sucederá si el operador se ha caído y se reinició?
Sí. Y en ese momento llegaron eventos.
La tarea de qué hacer en este caso se divide parcialmente entre el operador y Kubernetes. Kubernetes tiene la capacidad de reproducir el evento que ocurrió. Lo reproduce. Y la tarea del operador es asegurarse de que, cuando se le haga replay del registro de eventos, esos eventos sean idempotentes. Y que la entrada repetida del mismo evento no rompa nuestro sistema. Y nuestro operador cumple con esta tarea.
¡Hola! ¡Gracias por la presentación! Dmitry Zavyalov, de la empresa Smédova. ¿Está prevista la adición a la operación de la capacidad de configuración con haproxy? Me interesa algún otro balanceador además del estándar, que sea inteligente y entienda que allí realmente está ClickHouse.
¿Estás hablando de Ingress?
Sí, reemplaza Ingress por haproxy. En haproxy se puede especificar la topología del clúster, donde están las réplicas.
Por el momento no hemos pensado en ello. Si lo necesitas y puedes explicar por qué es necesario, se podría implementar, especialmente si decides participar. Con mucho gusto consideraríamos la opción. Respuesta breve: no, actualmente no tenemos esa funcionalidad. Gracias por la sugerencia, lo evaluaremos. Y si además explicas el caso de uso y por qué es necesario en la práctica, por ejemplo, creas issues en GitHub, sería genial.
Ya existe.
Bien. Estamos abiertos a cualquier propuesta. Y haproxy se añade a la lista de tareas pendientes. La lista de tareas pendientes sigue creciendo, no disminuye por ahora. Pero eso es bueno, significa que el producto es demandado.
Fuente: habr.com
