

¿Cómo entiende un desarrollador backend que una consulta SQL funcionará bien en producción? En empresas grandes o de rápido crecimiento, no todos tienen acceso a la producción. Además, incluso con acceso, no todas las consultas se pueden comprobar sin complicaciones, y crear una copia de la base de datos a menudo toma horas. Para resolver estos problemas, hemos creado un DBA artificial: Joe. Ya ha sido implementado con éxito en varias empresas y ayuda a más de una decena de desarrolladores.
Video:
¡Hola a todos! Me llamo Anatoly Stanсler. Trabajo en la empresa . Nos dedicamos a acelerar el proceso de desarrollo eliminando las demoras relacionadas con el funcionamiento de Postgres, para los desarrolladores, DBA y QA.
Tenemos clientes fantásticos y hoy una parte de la presentación estará dedicada a los casos que hemos encontrado trabajando con ellos. Les contaré cómo les ayudamos a resolver problemas bastante serios.
Cuando estamos desarrollando y hacemos migraciones complejas y pesadas, nos hacemos la pregunta: "¿Funcionará esta migración?". Utilizamos revisiones, aprovechamos el conocimiento de colegas más experimentados y expertos en DBA. Y pueden decir si funcionará o no.
Pero, quizás, sería mejor si pudiéramos probar esto en copias a gran escala por nosotros mismos. Y hoy hablaremos precisamente de los enfoques actuales para las pruebas y cómo podemos hacerlo mejor y con qué herramientas. También discutiremos los pros y los contras de estos enfoques y qué podemos mejorar aquí.
¿Alguna vez alguien ha hecho índices o ha realizado cambios directamente en producción? Bastante gente. ¿Y a cuántos les ha llevado esto a perder datos o a experimentar tiempos de inactividad? Entonces conocen este dolor. Gracias a Dios, hay copias de seguridad.
El primer enfoque es la prueba en producción. O cuando un desarrollador está en su máquina local, tiene datos de prueba, hay una muestra limitada. Y lanzamos en producción y se obtiene una situación como esta.
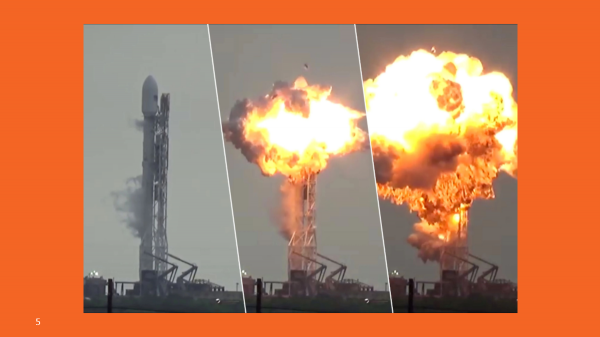
Es doloroso, es costoso. Probablemente no sea la mejor forma de hacerlo.
¿Y cuál sería la mejor forma de hacerlo?
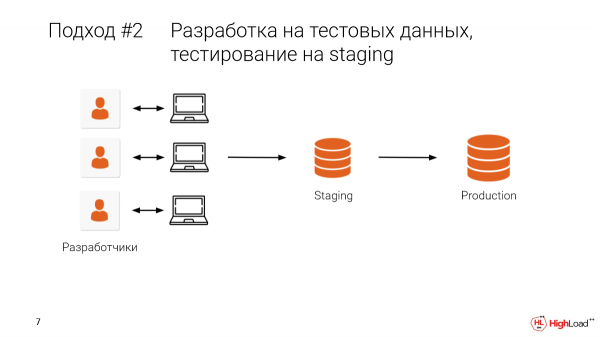
Tomemos el entorno de staging y dediquemos alguna parte de la producción. O, en el mejor de los casos, tomemos producción real, todos los datos. Y después de haber desarrollado localmente, verificaremos adicionalmente también en staging.
Esto nos permitirá eliminar algunos errores, es decir, no permitir que lleguen a producción.
¿Cuáles son los problemas?
- El problema es que compartimos este staging con colegas. Y muy a menudo sucede que haces algún cambio, ¡bam! – y no hay datos, el trabajo se va al traste. El staging era de varios terabytes. Y hay que esperar mucho tiempo para que se reinicie. Y decidimos que lo mejor es desarrollarlo mañana. Eso es todo, nuestra capacidad de desarrollo se detuvo.
- Y, por supuesto, tenemos muchos colegas ahí, muchos equipos. Y hay que coordinar manualmente. Y eso no es conveniente.
Y hay que decir que solo tenemos un intento, un disparo, si queremos hacer algún cambio en la base de datos, manipular los datos, cambiar la estructura. Y si algo sale mal, si hay un error en la migración, no podremos retroceder rápidamente.
Es mejor que el enfoque anterior, pero aún existe una gran probabilidad de que algún error llegue a producción.
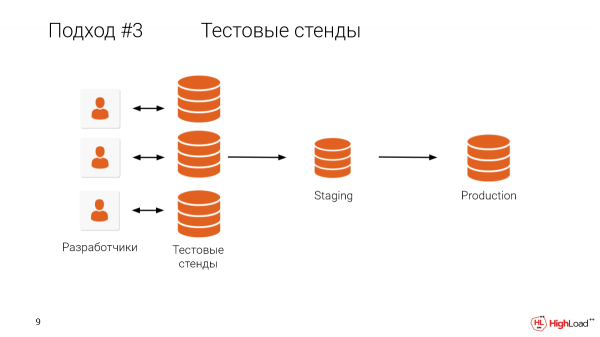
¿Qué nos impide dar a cada desarrollador un entorno de pruebas, una copia completa? Creo que queda claro qué es lo que impide eso.
¿Quién tiene una base de datos que supere el terabyte? Más de la mitad de los asistentes.
Y está claro que mantener máquinas para cada desarrollador, cuando la producción es tan grande, es muy costoso y, además, lleva tiempo.
Tenemos clientes que han comprendido que es muy importante probar todos los cambios en copias completas, pero su base es menor de un terabyte, y no tienen los recursos para mantener un entorno de pruebas para cada desarrollador. Por eso tienen que descargar los volúmenes localmente en sus máquinas y probar de esa manera. Eso lleva mucho tiempo.
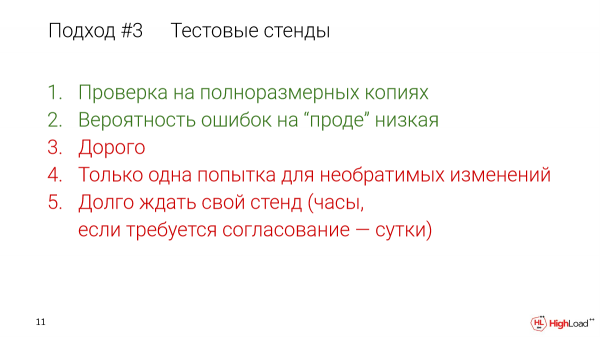
Incluso si lo haces dentro de la infraestructura, descargar un terabyte de datos en una hora ya es bastante bueno. Pero utilizan volúmenes lógicos, los descargan localmente desde la nube. Para ellos, la velocidad es de unos 200 gigabytes por hora. Y además necesitan tiempo para descomprimir el volumen lógico, aplicar los índices, etc.
Pero utilizan este enfoque porque les permite mantener la producción confiable.
¿Qué podemos hacer aquí? Hagamos que los entornos de pruebas sean económicos y proporcionemos a cada desarrollador su propio entorno de pruebas.
Y eso es posible.
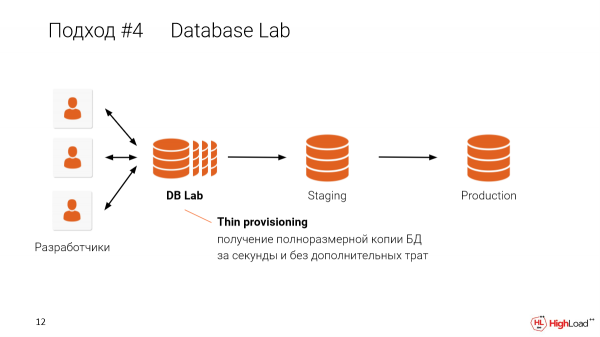
Y en este enfoque, cuando hacemos clones delgados para cada desarrollador, podemos compartirlo en una sola máquina. Por ejemplo, si tienes una base de datos de cuatro terabytes y quieres proporcionársela a 10 desarrolladores, no necesitas tener 10 bases de datos de cuatro terabytes. Con una sola máquina, puedes crear copias aisladas delgadas para cada desarrollador usando una sola máquina. Cómo funciona te lo contaré un poco más adelante.
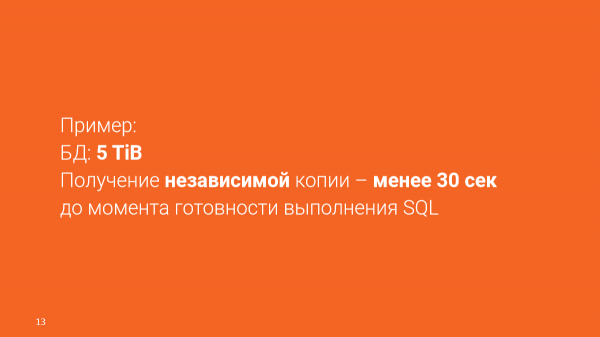
Un ejemplo real:
La base de datos tiene 4,5 terabytes.
Podemos obtener copias independientes en 30 segundos.
No necesitas esperar a que se configure un entorno de pruebas ni depender de su tamaño. Puedes obtenerlo en segundos. Serán entornos completamente aislados, pero que comparten datos entre sí.
Eso es genial. Aquí estamos hablando de magia y universos paralelos.
En nuestro caso, esto funciona con el sistema OpenZFS.
OpenZFS es un sistema de archivos copy-on-write que soporta de forma nativa snapshots y clones. Es confiable y escalable. Es fácil de gestionar. Se puede desplegar literalmente en dos comandos.
Hay otras opciones:
LVM,
Almacenamiento de red (por ejemplo, Pure Storage).
Database Lab, del que hablo, es modular. Se puede implementar utilizando tales opciones. Pero por ahora nos hemos centrado en OpenZFS, porque específicamente con LVM tuvimos problemas.
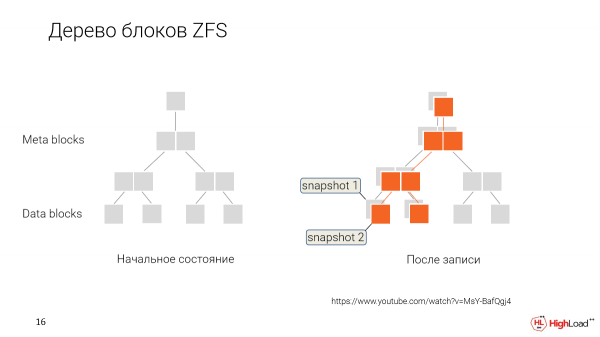
¿Cómo funciona? En lugar de sobrescribir los datos cada vez que los cambiamos, los guardamos, simplemente marcando que estos nuevos datos pertenecen a un nuevo momento en el tiempo, a un nuevo snapshot.
Y luego, cuando queremos retroceder o crear un nuevo clon de alguna versión más antigua, simplemente decimos: 'Ok, dame esos bloques de datos que están marcados de esta manera'.
Y este usuario trabajará con ese conjunto de datos. Los irá cambiando gradualmente, creando sus propios snapshots.
Y tendremos ramificación. Cada desarrollador en nuestro caso tendrá la oportunidad de tener su propio clon, que editará, mientras que los datos que son comunes serán compartidos entre todos.
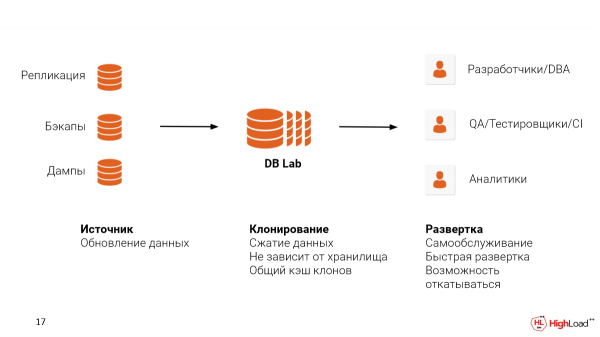
Para desplegar un sistema así, hay que resolver dos problemas:
La primera es la fuente de datos de donde los obtendrás. Se puede configurar la replicación con producción. Se pueden utilizar las copias de seguridad que ya tienes configuradas, espero. WAL-E, WAL-G o Barman. Y, incluso si usas alguna solución en la nube, como RDS o Cloud SQL, puedes utilizar volcado lógico. Pero, de todos modos, te recomendamos utilizar copias de seguridad, porque con este enfoque también mantendrás la estructura física de los archivos, lo que permitirá estar más cerca de las métricas que verías en producción, para detectar los problemas que surjan.
La segunda es el lugar donde deseas hospedar Database Lab. Puede ser en la nube o en local. Aquí es importante mencionar que ZFS soporta la compresión de datos. Y lo hace bastante bien.
Imagina que cada una de estas copias, dependiendo de las operaciones que realicemos con la base, tendrá un crecimiento en algún dev. También se necesitará espacio para ese dev. Pero gracias a que tomamos una base de 4,5 terabytes, ZFS la comprimirá a 3,5 terabytes. Dependiendo de la configuración, esto se puede variar. Y aún nos quedará espacio para dev.
Este sistema se puede utilizar para diferentes casos de uso.
Son desarrolladores y DBA para verificar consultas y optimización.
Esto se puede utilizar en pruebas QA para verificar una migración específica antes de implementarla en producción. Y también podemos generar entornos especiales para QA con datos reales, donde pueden probar nuevas funcionalidades. Y esto tomará segundos en lugar de esperar horas, o incluso días en otros casos donde no se utilizan copias delgadas.
Y otro caso particular. Si en la empresa no hay un sistema de análisis configurado, podemos crear un clon delgado de la base de datos del producto y entregarlo para consultas largas o para índices especiales que puedan utilizarse en el análisis.
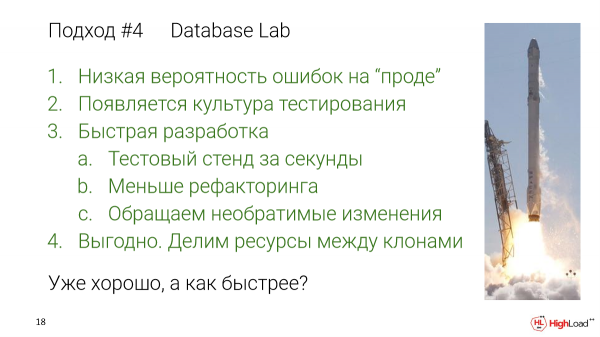
Con este enfoque:
Baja probabilidad de errores en producción, porque hemos probado todos los cambios con datos a gran escala.
Se genera una cultura de pruebas, ya que ahora no hay que esperar horas por tu propio entorno.
Y no hay barreras, no hay esperas entre las pruebas. Realmente puedes ir y comprobar. Y será mejor así, porque aceleraremos el desarrollo.
Habrá menos refactorización. Menos errores llegarán a producción. Los refactorizaremos menos después.
Podemos realizar cambios irreversibles. Esto no está en los enfoques estándar.
- Es ventajoso porque compartimos los recursos de los entornos de prueba.
Ya es un buen avance, ¿qué más se podría acelerar?
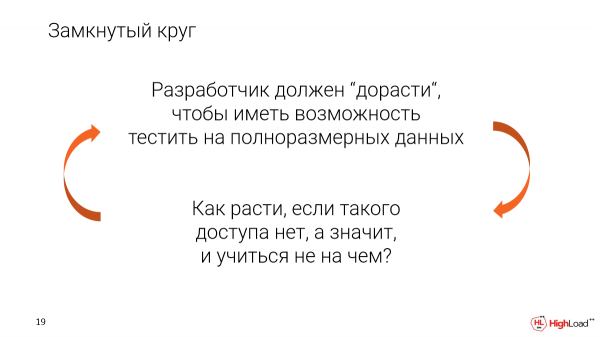
Gracias a este sistema, podemos reducir drásticamente la barrera de entrada para este tipo de pruebas.
Actualmente existe un círculo vicioso, donde el desarrollador, para acceder a datos reales en tamaño completo, debe convertirse en un experto. Debe confiarse en él dicho acceso.
Pero, ¿cómo crecer si no hay? ¿Y si solo tienes un conjunto de datos de prueba muy pequeño? Entonces no podrás obtener experiencia real.
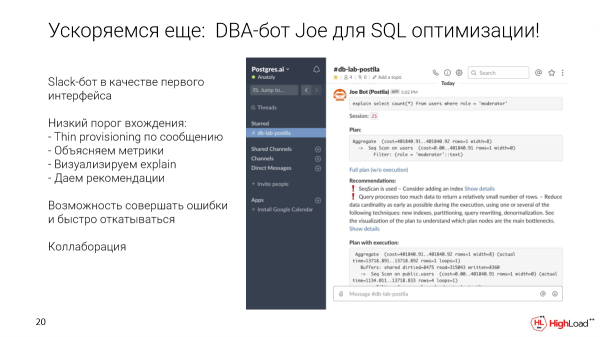
¿Cómo salir de este círculo? Como primera interfaz, cómoda para desarrolladores de cualquier nivel, elegimos un bot de Slack. Pero podría ser cualquier otra interfaz.
¿Qué permite hacer? Se puede tomar una consulta específica y enviarla a un canal especial para la base de datos. Automáticamente desplegaremos un clon delgado en segundos. Ejecutaremos esta consulta. Recopilaremos métricas y recomendaciones. Mostraremos visualización. Y luego, este clon quedará para que esa consulta pueda optimizarse de alguna manera, añadir índices, etc.
Además, Slack nos ofrece oportunidades de colaboración de inmediato. Dado que es solo un canal, puedes empezar a discutir esa consulta en un hilo específico, mencionando a tus colegas y DBA que están dentro de la empresa.
Pero, por supuesto, también hay problemas. Dado que es el mundo real y estamos utilizando un servidor en el que alojamos muchos clones, tenemos que limitar la cantidad de memoria y potencia de procesamiento disponible para los clones.
Pero para que estas pruebas sean creíbles, hay que resolver de alguna manera este problema.
Está claro que un aspecto importante son los datos idénticos. Pero eso ya lo tenemos. Y queremos lograr una configuración idéntica. Y podemos ofrecer una configuración prácticamente idéntica.
Sería genial tener el mismo hardware que en producción, aunque puede diferir.
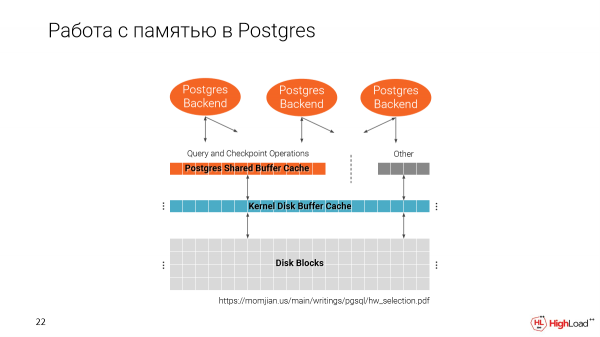
Recordemos cómo Postgres trabaja con la memoria. Tenemos dos cachés. Uno de la sistema de archivos y el otro propio de Postgres, es decir, el Shared Buffer Cache.
Es importante señalar que el Shared Buffer Cache se aloca al iniciar Postgres dependiendo del tamaño que especifiques en la configuración.
Y el segundo caché utiliza todo el espacio disponible.
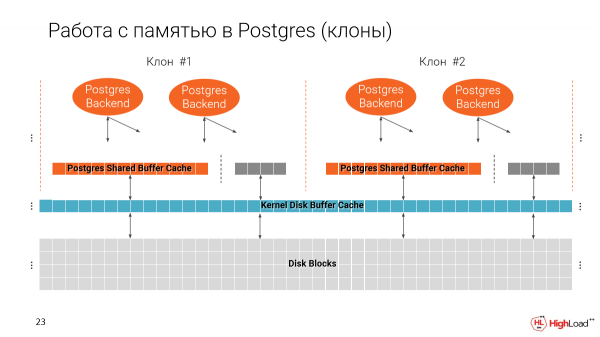
Y cuando hacemos varios clones en una sola máquina, resulta que vamos llenando la memoria gradualmente. Y en buen sentido, el Shared Buffer Cache debería ser el 25 % de la capacidad total de memoria disponible en la máquina.
Y resulta que si no cambiamos este parámetro, solo podremos ejecutar 4 instancias en una máquina, es decir, solamente 4 de esos delgados clones. Y esto, por supuesto, es malo, porque queremos tener muchos más.
Pero, por otro lado, el Buffer Cache se utiliza para realizar consultas, para índices, es decir, el plan depende del tamaño de nuestros cachés. Y si simplemente tomamos este parámetro y lo reducimos, nuestros planes pueden cambiar drásticamente.
Por ejemplo, si en producción tenemos un caché grande, entonces Postgres preferirá utilizar el índice. Pero si no, entonces se realizará un SeqScan. ¿Y cuál sería el sentido si nuestros planes no coincidieran?
Pero aquí llegamos a la solución de que, en realidad, el plan en Postgres no depende del tamaño específico establecido en el Shared Buffer, sino que depende del effective_cache_size.
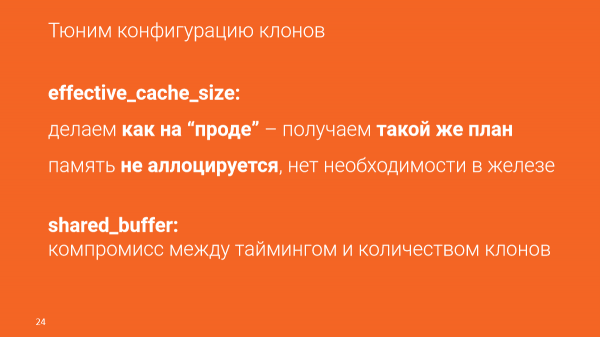
Effective_cache_size es la cantidad de caché que se supone que tenemos disponible, es decir, la suma de Buffer Cache y el caché del sistema de archivos. Esto se establece en la configuración. Y esta memoria no se aloca.
Y gracias a este parámetro, podemos engañar a Postgres al decir que en realidad tenemos acceso a muchos datos, incluso si esos datos no existen. Y de esta manera, los planes coincidirán completamente con producción.
Pero esto puede afectar el tiempo. Y optimizamos las consultas en función del tiempo, pero lo importante es que el tiempo depende de muchos factores:
Depende de la carga que actualmente existe en producción.
Depende de las características de la máquina misma.
Y este es un parámetro indirecto, pero en realidad podemos optimizar en función de la cantidad de datos que esta consulta leerá para obtener un resultado.
Y si queremos que el tiempo de respuesta se asemeje a lo que veremos en producción, debemos utilizar hardware lo más parecido posible y, tal vez, incluso más, para que todos los clones quepan. Pero esto es un compromiso, es decir, recibirán los mismos planes, verán cuántos datos lee una consulta en particular y podrán concluir si esta consulta es buena (o la migración) o mala y necesita optimización.
Vamos a analizar cómo se lleva a cabo la optimización específicamente con Joe.
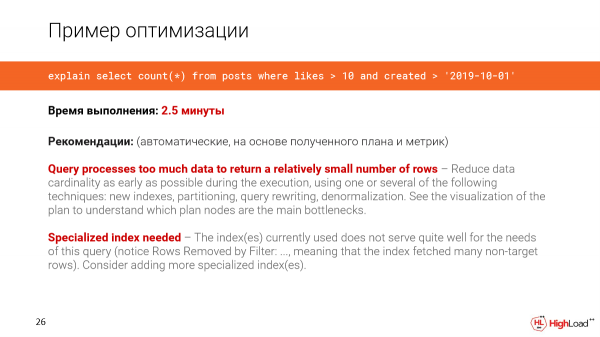
Tomemos una consulta de un sistema real. En este caso, la base de datos tiene 1 terabyte. Y queremos contar el número de publicaciones recientes que han recibido más de 10 'me gusta'.
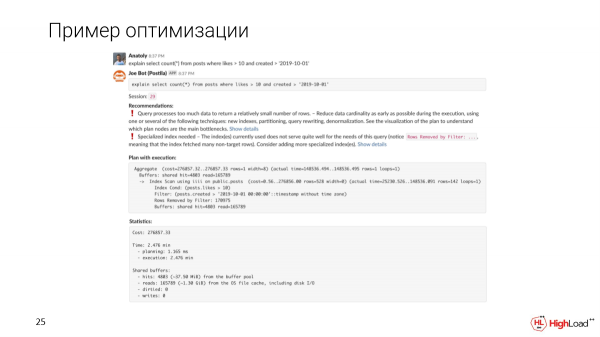
Escribimos un mensaje en el canal y se despliega un clon para nosotros. Y veremos que dicha consulta se ejecutará en 2,5 minutos. Esto es lo primero que notaremos.
B Joe mostrará recomendaciones automáticas basadas en el plan y las métricas.
Veremos que la consulta está procesando demasiados datos para obtener un número relativamente pequeño de filas. Se necesita algún índice especializado, ya que hemos notado que en la consulta hay demasiadas filas filtradas.
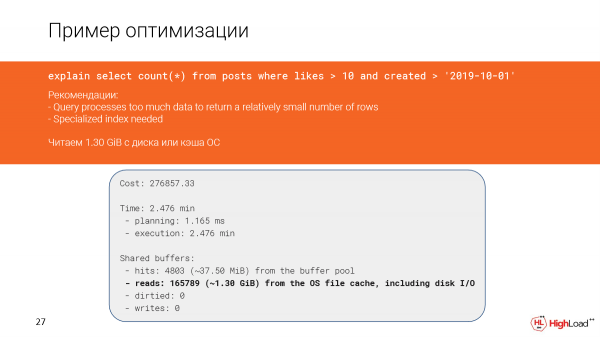
Miremos más de cerca qué ocurrió. De hecho, vemos que leímos casi un gigabyte y medio de datos desde el caché de archivos o incluso desde el disco. Y esto no es bueno, ya que solo obtuvimos 142 filas.
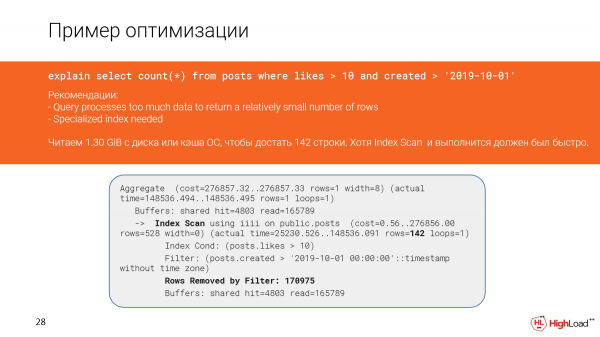
Y, a primera vista, tuvimos un escaneo de índice que debería haber funcionado rápidamente, pero, dado que filtramos demasiadas filas (tuvimos que contarlas), la consulta se ejecutó lentamente.
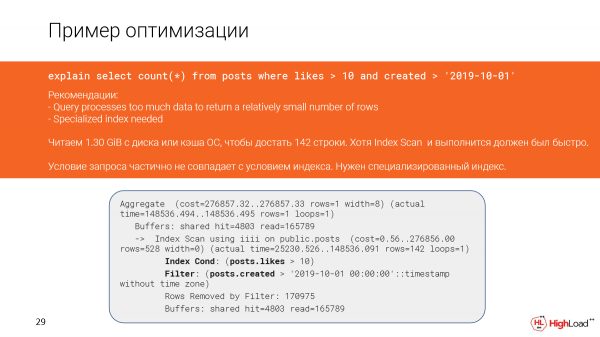
Y esto sucedió en el plan debido a que las condiciones en la consulta y las del índice no coincidían parcialmente.
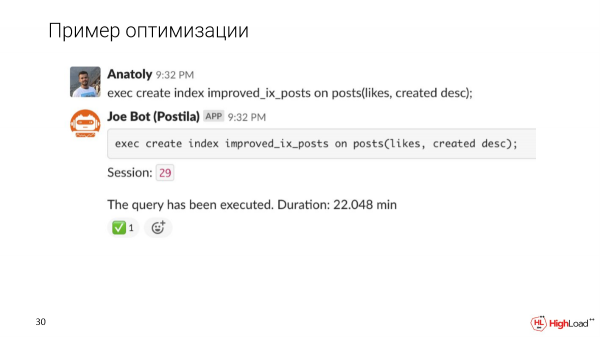
Intentemos hacer que el índice sea más preciso y veamos cómo cambia la ejecución de la consulta después de esto.
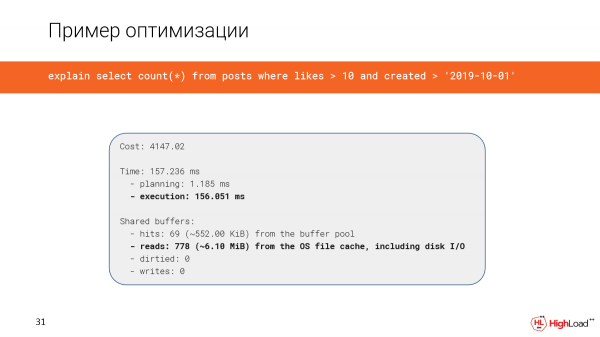
La creación del índice tomó bastante tiempo, pero ahora verificamos la consulta y vemos que el tiempo en lugar de 2,5 minutos se redujo a solo 156 milisegundos, lo cual es bastante bueno. Y solo leemos 6 megabytes de datos.
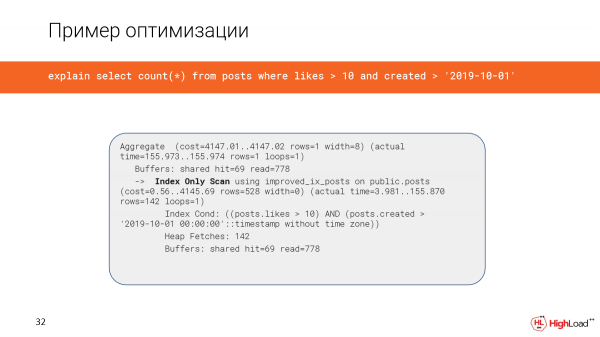
Y ahora se está utilizando un escaneo solo de índice.
Otra historia importante es que queremos presentar el plan de una manera más comprensible. Hemos implementado visualización mediante gráficos de llamas.
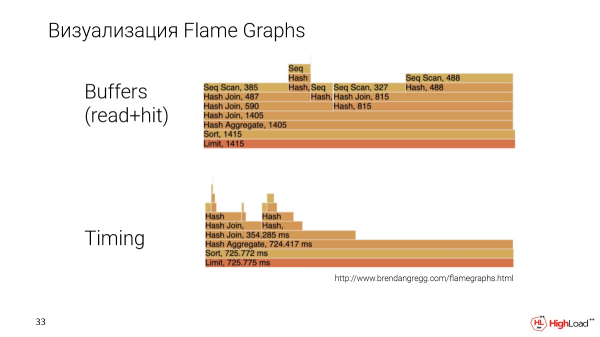
Esta es otra consulta, más compleja. Y los gráficos de llamas los construimos según dos parámetros: la cantidad de datos que leía un nodo específico en el plan y el tiempo, es decir, el tiempo de ejecución del nodo.
Aquí podemos comparar nodos específicos entre sí. Será evidente cuál de ellos ocupa más o menos espacio, lo que suele ser complicado en otros métodos de visualización.
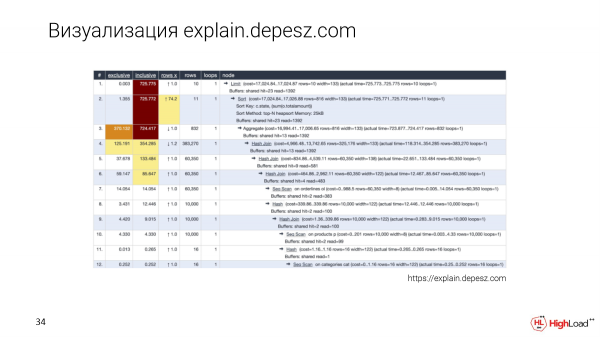
Por supuesto, todos conocen explain.depesz.com. Una buena característica de esta visualización es que guardamos el plan de texto y también extraemos algunos parámetros clave en una tabla, para que sea posible clasificar.
Y los desarrolladores que aún no se han adentrado en este tema también utilizan explain.depesz.com, porque les resulta más fácil entender qué métricas son importantes y cuáles no.
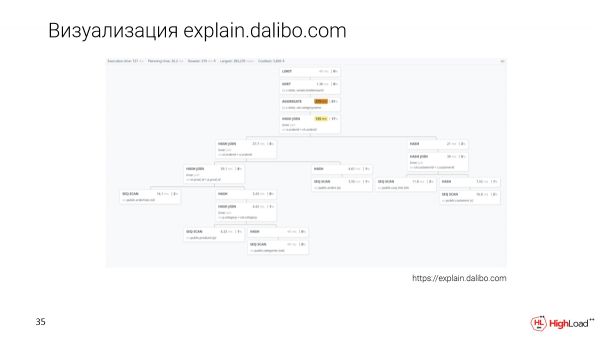
Hay un nuevo enfoque de visualización: explain.dalibo.com. Hacen una visualización en forma de árbol, pero aquí es muy difícil comparar los nodos entre sí. Aquí se puede entender bien la estructura, sin embargo, si hay una consulta grande, será necesario desplazarse de un lado a otro, pero también es una opción.
Colaboración
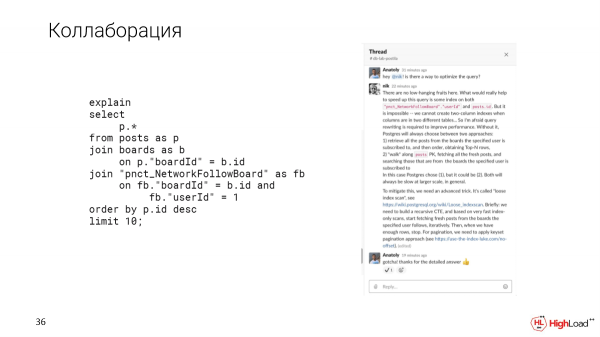
Y, como mencioné antes, Slack nos brinda la oportunidad de colaborar. Por ejemplo, si encontramos una consulta complicada que no sabemos cómo optimizar, podemos aclarar esta cuestión con nuestros colegas en un hilo en Slack.
Nos parece que es importante probar con datos de tamaño completo. Para esto, hemos creado la herramienta Update Database Lab, que está disponible en open source. También pueden usar el bot Joe. Pueden llevarlo justo ahora e implementarlo en su propio entorno. Todas las guías están allí disponibles.
También es importante señalar que la solución en sí no es revolucionaria, porque existe Delphix, pero es una solución empresarial. Está completamente cerrada y es muy cara. Nosotros nos especializamos en Postgres. Todos nuestros productos son open source. ¡Únete a nosotros!
Con esto concluyo. ¡Gracias!
Preguntas
¡Hola! Gracias por la presentación. ¡Muy interesante, especialmente para mí, porque resolví un problema similar hace un tiempo. Por eso tengo una serie de preguntas. Espero poder hacer al menos algunas de ellas!
Es interesante saber cómo calculan el espacio para este entorno. La tecnología implica que bajo ciertas circunstancias, sus clones pueden alcanzar el tamaño máximo. A grandes rasgos, si tienes una base de datos de diez terabytes y 10 clones, es fácil simular una situación en la que cada clon contenga 10 datos únicos. ¿Cómo calculan ese espacio, es decir, la diferencia de la que hablaban, en la que vivirán estos clones?
Buena pregunta. Aquí es importante estar atento a los clónicos específicos. Y si alguna modificación en un clón es demasiado grande y comienza a crecer, podemos primero alertar al usuario sobre esto o detener ese clón inmediatamente para evitar que se produzca una situación de fallo.
Sí, tengo una pregunta adicional. Es decir, ¿cómo garantizan el ciclo de vida de estos módulos? Para nosotros, esto es un problema y toda una historia aparte. ¿Cómo funciona?
Cada clón tiene un ttl. En principio, tenemos un ttl fijo.
¿Cuál es, si no es un secreto?
1 hora, es decir, inactivo – 1 hora. Si no se utiliza, lo eliminamos. Pero aquí no hay nada sorprendente, ya que podemos levantar un clón en segundos. Y si se necesita de nuevo, simplemente lo hacemos.
También me interesa su elección de tecnologías, porque nosotros, por ejemplo, usamos varios métodos al mismo tiempo por distintas razones. ¿Por qué eligieron ZFS? ¿Por qué no usaron LVM? Mencionaron que hubo problemas con LVM. ¿Cuáles fueron esos problemas? En mi opinión, la opción con almacenamiento de bloques es la más óptima desde el punto de vista del rendimiento.
¿Cuál es el principal problema con ZFS? Que debes ejecutarlo en un solo host, es decir, todas las instancias vivirán dentro de un mismo sistema operativo. En el caso del almacenamiento de bloques, puedes conectar diferentes equipos. Y el cuello de botella son solo aquellos bloques que están en el almacenamiento. Y es interesante la cuestión de la elección de tecnologías. ¿Por qué no LVM?
Podemos discutir específicamente sobre LVM en el meetup. En cuanto al almacenamiento de bloques, simplemente es caro. Podemos implementar el sistema ZFS en cualquier lugar. Puedes desplegarlo en tu propia máquina. Simplemente puedes descargar el repositorio y ejecutarlo. ZFS se puede instalar prácticamente en cualquier lugar si hablamos de Linux. Es decir, obtenemos una solución muy flexible. Además, ZFS ofrece muchas capacidades de serie. Puedes cargar tantos datos como quieras, conectar un gran número de discos, hay instantáneas. Y, como ya dije, es fácil de administrar. Es decir, parece muy agradable de usar. Está comprobado, tiene muchos años. Tiene una comunidad muy grande que sigue creciendo. ZFS es una solución muy fiable.
Nikolai Samokhvalov: ¿Puedo comentar algo más? Me llamo Nikolai, trabajo junto con Anatoliy. Estoy de acuerdo en que el almacenamiento de bloques es genial. Y algunos de nuestros clientes tienen Pure Storage, etc.
Anatoli señaló correctamente que estamos enfocados en la modularidad. Y en el futuro podemos implementar una única interfaz: hacer un snapshot, clonar, destruir el clon. Todo esto es fácil. Y el almacenamiento es genial, si está disponible.
Pero ZFS está disponible para todos. Ya es suficiente con DelPhix, tienen 300 clientes. De ellos, en el Fortune 100 hay 50 clientes, es decir, están enfocados en la NASA, etc. Es hora de que esta tecnología esté al alcance de todos. Por eso tenemos un Core de código abierto. Hay una parte de la interfaz que no es de código abierto. Esta es la plataforma que vamos a mostrar. Pero queremos que sea accesible para todos. Queremos hacer una revolución, para que todos los testers dejen de adivinar en sus laptops. Debemos escribir SELECT y ver de inmediato que es lento. Ya es suficiente de esperar a que el DBA nos lo cuente. Este es el objetivo principal. Y creo que lo lograremos. Y estamos creando esto para que todos lo tengan. Por eso ZFS, porque estará disponible en todas partes. Gracias a la comunidad por resolver problemas y por tener una licencia de código abierto, etc.
¡Saludos! ¡Gracias por la presentación! Me llamo Maxim. Nosotros hemos resuelto problemas similares. Lo hemos resuelto en casa. ¿Cómo dividen los recursos entre estos clones? Cada clon, en cada momento, puede estar haciendo su propia tarea: uno prueba una cosa, otro prueba otra, alguno está construyendo un índice, otro ejecutando un job pesado. Y si se puede dividir por CPU, ¿cómo lo dividen en términos de IO? Esa es la primera pregunta.
Y la segunda pregunta sobre las diferencias entre los entornos. Supongamos que aquí tengo ZFS y todo va perfecto, pero en el cliente en producción no hay ZFS, sino ext4, por ejemplo. ¿Qué hacemos en ese caso?
Las preguntas son muy buenas. Mencioné brevemente este problema con la división de recursos. Y la solución es la siguiente. Imagina que estás probando en staging. Puede que también tengas una situación en la que alguien está generando una carga, y otra persona otra. Y al final ves métricas confusas. Incluso el mismo problema puede surgir en producción. Cuando quieres verificar alguna consulta y te das cuenta de que hay un problema – que está tardando en ejecutarse – en realidad el problema no estaba en la consulta, sino que había alguna carga paralela.
Y por eso es importante centrarse en cuál será el plan, qué pasos seguiremos en el plan y cuántos datos levantaremos para ello. El hecho de que nuestros discos, por ejemplo, estén sobrecargados con algo, afectará específicamente el tiempo. Pero podemos evaluar, por la cantidad de datos, cuán demandante es esta solicitud. No es tan importante que simultáneamente haya alguna otra ejecución.
Tengo dos preguntas. Esto es realmente genial. ¿Ha habido casos en los que los datos en producción son críticamente importantes, por ejemplo, números de tarjetas de crédito? ¿Hay algo ya preparado o es una tarea separada? Y la segunda pregunta: ¿hay algo así para MySQL?
En cuanto a los datos. Haremos ofuscación, aunque en este momento no lo estamos haciendo. Pero si estás desplegando precisamente Joe, si no das acceso a los desarrolladores, entonces no hay acceso a los datos. ¿Por qué? Porque Joe no muestra los datos. Solo muestra métricas, planes y eso es todo. Se diseñó así porque esta es una de las demandas de nuestro cliente. Querían tener la capacidad de optimizar, pero sin dar acceso a todos.
Acerca de MySQL. Este sistema se puede utilizar para cualquier cosa que almacene estado en disco. Y dado que trabajamos con Postgres, actualmente estamos automatizando completamente todo para Postgres. Queremos automatizar la obtención de datos de la copia de seguridad. Estamos configurando Postgres correctamente. Sabemos cómo hacer que los planes coincidan, etc.
Pero dado que el sistema es extensible, también se podrá utilizar para MySQL. Y hay ejemplos de ello. Hay algo similar en Yandex, pero no lo publican en ningún lado. Lo utilizan dentro de Yandex.Metrica. Y ahí la historia es precisamente sobre MySQL. Pero las tecnologías son las mismas, ZFS.
¡Gracias por la presentación! También tengo un par de preguntas. Mencionaste que la clonación se puede utilizar para análisis, por ejemplo, para construir índices adicionales. ¿Puedes contar un poco más sobre cómo funciona esto?
Y haré la segunda pregunta de inmediato sobre la uniformidad de los entornos, la uniformidad de los planes. El plan depende, entre otras cosas, de las estadísticas recopiladas por Postgres. ¿Cómo resuelven este problema?
No hay análisis de casos específicos porque aún no hemos utilizado esto, pero existe esa posibilidad. Si hablamos de índices, imagina que se ejecuta una consulta en una tabla con cientos de millones de registros y en una columna que normalmente no está indexada en producción. Y queremos calcular algunos datos. Si esta consulta se ejecuta en producción, hay una posibilidad de que haya inactividad, ya que la consulta podría tardar un minuto en procesarse.
Ok, hagamos un clon ligero que no asuste detener por unos minutos. Y para facilitar la recopilación de análisis, agreguemos índices en las columnas que nos interesan.
¿Se creará el índice cada vez?
Se puede hacer de manera que toquemos los datos, hagamos instantáneas, luego nos recuperemos de esta instantánea y ejecutemos nuevas consultas. Es decir, se puede hacer de tal manera que podamos levantar nuevos clones con los índices ya establecidos.
En cuanto a la pregunta sobre las estadísticas, si nos recuperamos de una copia de seguridad, si hacemos replicación, entonces nuestras estadísticas serán exactamente las mismas. Porque traemos toda la estructura física de los datos, es decir, los datos tal cual, junto con todas las métricas de estadísticas.
Aquí hay otro problema. Si utilizas una solución en la nube, solo hay disponibles volcado lógicos, porque Google, Amazon no permiten obtener una copia física. Entonces habrá ese problema.
Gracias por el informe. Aquí surgieron dos buenas preguntas sobre MySQL y sobre la división de recursos. Pero, en esencia, todo se reduce a que este es un tema no de bases de datos específicas, sino en general del sistema de archivos. Por lo tanto, las preguntas sobre la división de recursos también deben resolverse desde allí, no al final, sino desde el sistema de archivos. servidor, en instancia.
Mi pregunta está un poco más cerca de la multi-capa de la base de datos, donde hay varias capas. Por ejemplo, hemos configurado la actualización de una imagen de diez terabytes, estamos en replicación. Y usamos específicamente esta solución para bases de datos. Hay replicación, se está actualizando la información. Mientras tanto, 100 empleados están trabajando paralelamente, lanzando estas diferentes instantáneas. ¿Qué hacer? ¿Cómo evitar conflictos, donde iniciaron una cosa y luego el sistema de archivos cambió, y todas esas instantáneas se arruinaron?
No irán, porque así funciona ZFS. Podemos mantener por separado en un solo flujo los cambios del sistema de archivos, que llegan gracias a la replicación. Y mantener clones de versiones antiguas de los datos que utilizan los desarrolladores. Y esto funciona bien para nosotros, está todo en orden.
Entonces, ¿la actualización ocurrirá como una capa adicional y todas las nuevas instantáneas se basarán en esta capa, verdad?
De las capas anteriores, que eran de las replicaciones pasadas.
Las capas anteriores desaparecerán, pero se referirán a la capa antigua, y las nuevas imágenes se tomarán de la última capa que se obtuvo en la actualización?
En general, sí.
Entonces, como consecuencia, tendremos muchas capas. ¿Y con el tiempo será necesario comprimarlas?
Sí, eso es correcto. Hay un cierto intervalo. Mantenemos instantáneas semanales. Esto depende de los recursos que tengas. Si puedes almacenar muchos datos, puedes retener las instantáneas durante mucho tiempo. No se eliminarán automáticamente. No habrá corrupción de datos. Si las instantáneas están desactualizadas, como creemos, es decir, esto depende de la política en la empresa, podemos eliminarlas y liberar espacio.
¡Hola, gracias por la presentación! Sobre la pregunta de Joe. Dijo que el cliente no quería dar acceso a todos los datos. Estrictamente hablando, si alguien tiene el resultado de Explain Analyze, puede ver los datos.
Así es. Por ejemplo, podemos escribir: «SELECT FROM WHERE email = algo». Es decir, no veríamos los datos en sí, pero podríamos ver algunos indicios indirectos. Hay que entender esto. Pero, por otro lado, todo esto es visible. Tenemos auditoría de registros, tenemos control de otros colegas que también ven en qué están trabajando los desarrolladores. Y si alguien intenta hacerlo, el servicio de seguridad se acercará a ellos y trabajará en esta cuestión.
¡Buenos días! Gracias por la presentación. Tengo una pregunta corta. Si en la empresa no se usa Slack, ¿hay alguna vinculación con él actualmente o se pueden desplegar instancias para que los desarrolladores conecten una aplicación de prueba a las bases de datos?
Actualmente, hay integración con Slack, es decir, no hay ningún otro mensajero, pero realmente queremos agregar soporte para otros mensajeros también. ¿Qué puedes hacer? Puedes desplegar DB Lab sin Joe, usar la REST API o nuestra plataforma para crear clones y conectarte con PSQL. Pero esto se puede hacer si estás dispuesto a darle a tus desarrolladores acceso a los datos, ya que aquí no habrá ninguna interfaz.
No necesito esa capa, sino tal capacidad.
Entonces, sí, se puede hacer.
Fuente: habr.com
