

¡Hola a todos! Me llamo Oleg Sidorenkov, trabajo en la empresa DomKlik como líder del equipo de infraestructura. Hemos estado utilizando "Cubo" en producción durante más de tres años, y durante este tiempo hemos vivido muchos momentos interesantes con él. Hoy les contaré cómo, con el enfoque correcto, se puede extraer aún más rendimiento de un Kubernetes "vanilla" para su clúster. ¡Listos, listos, ya!
Todos ustedes saben muy bien que Kubernetes es un sistema escalable de código abierto para la orquestación de contenedores; bien, o 5 binarios que hacen magia, gestionando el ciclo de vida de sus microservicios en un entorno de servidor. Además, es una herramienta bastante flexible, que se puede ensamblar como un juguete de Lego, para una máxima personalización para diferentes tareas.
Y, aparentemente, todo está bien: simplemente añade servidores al clúster como si fueran leña a la chimenea y no habrá problemas. Pero si te preocupas por el medio ambiente, te preguntarás: "¿Cómo puedo mantener el fuego en la estufa y cuidar el bosque?". En otras palabras, ¿cómo encontrar formas de mejorar la infraestructura y reducir costos?
1. Supervise los recursos de los equipos y aplicaciones.
Uno de los métodos más simples, pero efectivos, es implementar requests/limits. Separa las aplicaciones por namespaces, y los namespaces por equipos de desarrollo. Establece valores de consumo de tiempo de CPU, memoria, y almacenamiento efímero antes de desplegar la aplicación.
resources:
   requests:
     memory: 2Gi
     cpu: 250m
   limits:
     memory: 4Gi
     cpu: 500m
Por experiencia, hemos llegado a la conclusión: no se deben inflar los requests por encima de los límites más de dos veces. El tamaño del clúster se calcula a partir de los requests, y si estableces diferencias de recursos en las aplicaciones, por ejemplo, de 5 a 10 veces, imagina qué pasará con tu nodo cuando se llene de pods y de repente reciba carga. Nada bueno. Como mínimo, tendrás throttling, y como máximo, dirás adiós a un worker y tendrás carga cíclica en los demás nodos una vez que los pods empiecen a migrar.
Además, con limitranges puedes establecer inicialmente los valores de recursos para el contenedor — mínimos, máximos y por defecto:
➜  ~ kubectl describe limitranges --namespace ops
Name:       limit-range
Namespace:  ops
Type        Resource           Min   Max   Default Request  Default Limit  Max Limit/Request Ratio
----        --------           ---   ---   ---------------  -------------  -----------------------
Container   cpu                50m   10    100m             100m           2
Container   ephemeral-storage  12Mi  8Gi   128Mi            4Gi            -
Container   memory             64Mi  40Gi  128Mi            128Mi          2
No olvides limitar los recursos del namespace para que un equipo no pueda acaparar todos los recursos del clúster:
➜  ~ kubectl describe resourcequotas --namespace ops
Name:                   resource-quota
Namespace:              ops
Resource                Used          Hard
--------                ----          ----
limits.cpu              77250m        80
limits.memory           124814367488  150Gi
pods                    31            45
requests.cpu            53850m        80
requests.memory         75613234944   150Gi
services                26            50
services.loadbalancers  0             0
services.nodeports      0             0
Como se observa en la descripción resourcequotas, si el equipo ops quiere desplegar pods que consumirán otros 10 cpu, el programador no permitirá que esto suceda y generará un error:
Error creando: pods "nginx-proxy-9967d8d78-nh4fs" está prohibido: cuota excedida: resource-quota, solicitado: limits.cpu=5, requests.cpu=5, usado: limits.cpu=77250m, requests.cpu=53850m, limitado: limits.cpu=10, requests.cpu=10Para resolver este tipo de problemas, se puede escribir una herramienta, como , que pueda almacenar y confirmar el estado de los recursos de los equipos.
2. Selecciona un almacenamiento de archivos óptimo
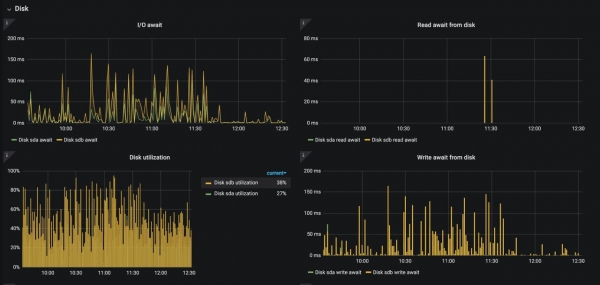
Aquí quisiera tocar el tema de volúmenes persistentes y el subsistema de disco de los nodos worker de Kubernetes. Espero que nadie esté usando «Cube» en HDD en producción, pero a veces un SSD convencional ya no es suficiente. Nos hemos encontrado con el problema de que los registros mataban el disco debido a las operaciones de E/S, y aquí no hay muchas opciones disponibles:
Utilizar SSD de alto rendimiento o cambiar a NVMe (si estás gestionando tu propio hardware).
Reducir el nivel de registro.
Hacer un balanceo «inteligente» de los pods que están sobrecargando el disco (
podAntiAffinity).
La captura de pantalla anterior muestra lo que sucede con el disco del nginx-ingress-controller cuando está habilitado el registro de access_logs (~12 mil registros/seg). Este estado, por supuesto, puede llevar a la degradación de todas las aplicaciones en este nodo.
En lo que respecta a PV, desgraciadamente, no he probado todos Volúmenes persistentes. Utilice la mejor opción que se adapte a usted. Históricamente, hemos tenido una pequeña parte de servicios que necesitan volúmenes RWX, y hace tiempo se comenzó a usar almacenamiento NFS para esta tarea. Barato y... suficiente. Claro, hemos tenido que lidiar con muchos problemas, pero aprendimos a optimizarlo y ya no nos duele la cabeza. Y si es posible, cambie a almacenamiento de objetos S3.
3. Reúna imágenes optimizadas
Es mejor utilizar imágenes optimizadas para contenedores, para que Kubernetes pueda extraerlas más rápido y ejecutarlas de manera más eficiente.
La optimización significa que las imágenes:
contienen solo una aplicación o realizan una sola función;
tienen un tamaño pequeño, ya que las imágenes grandes se transmiten peor por la red;
tienen puntos finales para verificar la disponibilidad y la preparación, con los cuales Kubernetes puede tomar acciones en caso de inactividad;
utilizan sistemas operativos amigables con los contenedores (como Alpine o CoreOS), que son más resistentes a errores de configuración;
utilizan compilaciones de múltiples etapas, para que pueda desplegar solo aplicaciones compiladas y no los códigos fuente asociados.
Hay muchas herramientas y servicios que permiten verificar y optimizar imágenes sobre la marcha. Es importante mantenerlas siempre actualizadas y comprobadas en cuanto a seguridad. Como resultado, usted obtiene:
Reducción de la carga de red en todo el clúster.
Disminución del tiempo de inicio del contenedor.
Menor volumen de todo su registro de Docker.
4. Utilice la caché de DNS
Hablando de altas cargas, vivir sin optimizar el sistema DNS del clúster es bastante difícil. Hace mucho tiempo, los desarrolladores de Kubernetes mantenían su solución kube-dns. Se implementó también en nuestro caso, pero este software no se optimizó como se debía y no daba el rendimiento requerido, aunque la tarea parecía simple. Después apareció coredns, al que migramos y que funcionó sin problemas; posteriormente se convirtió en el servicio DNS predeterminado en K8s. En algún momento, alcanzamos 40 mil rps hacia el sistema DNS, y esa solución también se quedó corta. Pero, por suerte, se lanzó Nodelocaldns, también conocido como caché local de nodo, también .
¿Por qué usamos esto? Hay un error en el núcleo de Linux que, al hacer múltiples llamadas a través de conntrack NAT por UDP, conduce a una condición de carrera al escribir en las tablas conntrack, y parte del tráfico a través de NAT se pierde (cada llamada a través del servicio implica NAT). Nodelocaldns resuelve este problema al eliminar NAT y actualizar la conexión a TCP para los DNS upstream, así como al almacenar en caché localmente las consultas DNS a los upstream (incluida una corta caché negativa de 5 segundos).
5. Escale los pods horizontal y verticalmente de manera automática
¿Puede afirmar con confianza que todos sus microservicios están listos para un aumento de carga de dos a tres veces? ¿Cómo asignar correctamente los recursos a sus aplicaciones? Mantener un par de pods en ejecución más allá de la carga de trabajo puede resultar excesivo, y mantenerlos justos puede arriesgarse a causar inactividad por un aumento repentino del tráfico en el servicio. La solución intermedia puede alcanzarse con el encantamiento de la multiplicación de servicios como y .
VPA permite aumentar automáticamente los requests/limits de sus contenedores en el pod según el uso real. ¿Cómo puede ser útil? Si tiene pods que no se pueden escalar horizontalmente por alguna razón (lo que no es completamente confiable), puede intentar confiar en el VPA para cambiar sus recursos. Su característica clave es el sistema de recomendaciones basado en datos históricos y actuales del metric-server, por lo que, si no desea cambiar automáticamente los requests/limits, puede simplemente rastrear los recursos recomendados para sus contenedores y optimizar la configuración para ahorrar CPU y memoria en el clúster.
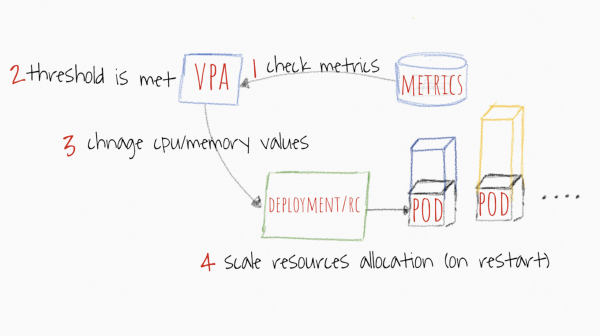 La imagen es tomada de https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
El programador en Kubernetes siempre se basa en los requests. Cualquiera que sea el valor que coloque, el programador buscará un nodo adecuado basándose en él. Los valores de limits son necesarios para que el kubelet entienda cuándo limitar o eliminar un pod. Y dado que el único parámetro importante es el valor de requests, el VPA trabajará con él. Cada vez que establece el escalamiento vertical de una aplicación, está definiendo cuáles deberían ser los requests. ¿Y qué pasará con los limits? Este parámetro también será escalado proporcionalmente.
Por ejemplo, aquí están la configuraciones estándar de un pod:
recursos:
   solicitudes:
     memoria: 250Mi
     cpu: 200m
   límites:
     memoria: 500Mi
     cpu: 350m
El mecanismo de recomendaciones determina que tu aplicación necesita 300m de CPU y 500Mi para funcionar correctamente. Recibirás estas configuraciones:
recursos:
   solicitudes:
     memoria: 500Mi
     cpu: 300m
   límites:
     memoria: 1000Mi
     cpu: 525m
Como se mencionó anteriormente, esta es una escalabilidad proporcional basada en la relación solicitudes/límites en el manifiesto:
CPU: 200m → 300m: relación 1:1.75;
Memoria: 250Mi → 500Mi: relación 1:2.
En cuanto a HPA, aquí el mecanismo de trabajo es más transparente. Se establecen valores umbrales para las métricas, como CPU y memoria, y si el valor promedio de todas las réplicas supera el umbral, la aplicación se escala en +1 pod hasta que el valor caiga por debajo del umbral o hasta que se alcance el número máximo de réplicas.
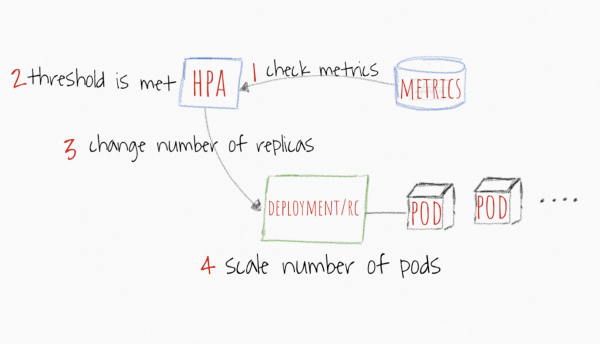 La imagen es tomada de https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Además de las métricas estándar, como CPU y memoria, puedes configurar umbrales en tus métricas personalizadas de Prometheus y trabajar con ellas si consideras que es la definición más precisa de cuándo escalar tu aplicación. Después de que la aplicación se estabilice por debajo del límite de métricas establecido, el HPA comenzará a escalar los pods hacia abajo hasta el número mínimo de réplicas o hasta que la carga cumpla con el umbral establecido.
6. No olvides sobre la Afinidad de Nodos y la Afinidad de Pods
No todos los nodos funcionan con el mismo hardware, y no todos los pods necesitan ejecutar aplicaciones que requieren intensivos cálculos. Kubernetes permite definir la especialización de nodos y pods usando Afinidad de Nodos y Afinidad de Pods.
Si tienes nodos adecuados para operaciones con intensivos cálculos, es mejor vincular aplicaciones a nodos correspondientes para obtener la máxima eficiencia. Para ello, utiliza nodeSelector con la etiqueta del nodo.
Supongamos que tienes dos nodos: uno con CPUType=HIGHFREQ y un gran número de núcleos rápidos, otro con MemoryType=HIGHMEMORY con gran cantidad de memoria y rendimiento superior. Es más sencillo asignar el despliegue del pod al nodo HIGHFREQ, agregando en la sección spec el siguiente selector:
…
nodeSelector:
	CPUType: HIGHFREQ
Una forma más costosa y específica de hacerlo es utilizar nodeAffinity en el campo afinidad la sección spec. Hay dos opciones:
requiredDuringSchedulingIgnoredDuringExecution: configuración rígida (el programador solo desplegará pods en nodos específicos (y en ningún otro lugar));preferredDuringSchedulingIgnoredDuringExecution: configuración suave (el programador intentará desplegar en nodos específicos, y si no puede, intentará desplegar en el siguiente nodo disponible).
Puedes especificar una sintaxis particular para controlar las etiquetas de los nodos, por ejemplo, En, NoEn, Existe, NoExiste, Gt o Lt. Sin embargo, ten en cuenta que los métodos complejos en listas largas de etiquetas ralentizarán la toma de decisiones en situaciones críticas. En otras palabras, no lo compliques.
Como se mencionó antes, Kubernetes permite asociar los pods actuales. Es decir, puedes hacer que ciertos pods funcionen junto a otros pods en la misma zona de disponibilidad (relevante para la nube) o nodos.
En podAffinity los campos afinidad la sección spec disponibles son los mismos que en el caso de nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution y preferredDuringSchedulingIgnoredDuringExecution. La única diferencia es que matchExpressions asociará pods a un nodo donde ya se esté ejecutando un pod con esa etiqueta.
Además, Kubernetes ofrece el campo podAntiAffinity, que, por el contrario, no asocia un pod a un nodo con ciertos pods.
Con respecto a las expresiones nodeAffinity se puede dar el mismo consejo: intenta mantener la simplicidad y la lógica en las reglas, no intentes sobrecargar la especificación de los pods con un conjunto complicado de reglas. Es muy fácil crear una regla que no cumplirá con las condiciones del clúster, creando una carga innecesaria para el programador y reduciendo el rendimiento general.
7. Taints & Tolerations
Hay otra forma de gestionar el programador. Si tienes un gran clúster con cientos de nodos y miles de microservicios, es muy difícil evitar que ciertos pods se coloquen en nodos específicos.
Aquí es donde ayuda el mecanismo de taints — reglas prohibitorias. Por ejemplo, en ciertos escenarios, puedes prohibir a ciertos nodos ejecutar pods. Para aplicar un taint a un nodo específico, debes usar la opción taint en kubectl. Indica la clave y el valor, y luego el taint como NoSchedule o NoExecute:
$ kubectl taint nodes node10 node-role.kubernetes.io/ingress=true:NoScheduleTambién vale la pena mencionar que el mecanismo de taint admite tres efectos principales: NoSchedule, NoExecute y PreferNoSchedule.
NoSchedulesignifica que mientras no haya una entrada correspondiente en la especificación del podtolerations, no podrá ser desplegado en el nodo (en este ejemplonode10).PreferNoSchedule— una versión simplificadaNoSchedule. En este caso, el programador intentará no distribuir pods que no tengan la entrada correspondientetolerationsen el nodo, pero esto no es una restricción rígida. Si no hay recursos en el clúster, los pods comenzarán a desplegarse en ese nodo.NoExecute— este efecto activa la evacuación inmediata de los pods que no tienen un registro correspondientetolerations.
Curiosamente, este comportamiento se puede anular mediante el mecanismo de tolerancias. Esto es conveniente cuando hay un nodo "prohibido" y necesitas desplegar solo servicios de infraestructura en él. ¿Cómo hacerlo? Permitir solo aquellos pods para los que existe una tolerancia adecuada.
Así es como se verá la especificación del pod:
spec:
   tolerations:
     - key: "node-role.kubernetes.io\/ingress"
        operator: "Equal"
        value: "true"
        effect: "NoSchedule"
Esto no significa que en el próximo redeploy el pod necesariamente se asignará a este nodo, no es un mecanismo de afinidad de nodo y nodeSelector. Pero al combinar varias características, puedes lograr una configuración muy flexible del programador.
8. Configura la prioridad de despliegue de los pods
El hecho de que hayas configurado el enlace de los pods a los nodos no significa que todos los pods deban ser procesados con la misma prioridad. Por ejemplo, podrías querer desplegar algunos pods antes que otros.
Kubernetes ofrece diferentes formas de configurar la prioridad de los pods (Prioridad y Preempción de Pods). La configuración consta de varias partes: el objeto PriorityClass y la descripción del campo priorityClassName en la especificación del pod. Veamos un ejemplo:
apiVersion: scheduling.k8s.io\/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 99999
globalDefault: false
description: "Esta clase de prioridad debe ser utilizada solo para pods muy importantes"
Estamos creando PriorityClass, asignándole un nombre, descripción y valor. Cuanto mayor sea value, mayor será la prioridad. El valor puede ser cualquier número entero de 32 bits, menor o igual a 1,000,000,000. Valores más altos están reservados para pods del sistema críticos, que generalmente no pueden ser despojados. El desalojo solo ocurrirá si no hay lugar para desplegar un pod de alta prioridad, entonces algunos pods de un nodo específico serán evacuados. Si este mecanismo te parece demasiado estricto, puedes agregar la opción preemptionPolicy: Never, y entonces no habrá desalojo; el pod estará en primer lugar en la cola y esperará a que el programador encuentre recursos libres para él.
Luego creamos un pod, en el que especificamos el nombre priorityClassName:
apiVersion: v1
kind: Pod
metadata:
  name: static-web
  labels:
    role: myrole
 spec:
  containers:
    - name: web
      image: nginx
      ports:
        - name: web
          containerPort: 80
          protocol: TCP
  priorityClassName: high-priority
Se pueden crear tantas clases de prioridad como se desee, aunque se recomienda no exagerar (por ejemplo, limitarse a prioridad baja, media y alta).
De esta manera, si es necesario, podrá aumentar la eficiencia del despliegue de servicios críticos, como nginx-ingress-controller, coredns, etc.
9. Optimice el clúster ETCD
ETCD se puede considerar el cerebro de todo el clúster. Es muy importante mantener el funcionamiento de esta base de datos a un alto nivel, ya que de ella depende la velocidad de las operaciones en el 'Kube'. Mantener el clúster ETCD en los nodos maestros sería una solución estándar y, a la vez, bastante buena para tener una latencia mínima hacia kube-apiserver. Si no se puede hacer así, coloque ETCD lo más cerca posible, manteniendo una buena capacidad de ancho de banda entre los participantes. También preste atención a cuántos nodos de ETCD pueden fallar sin dañar el clúster.
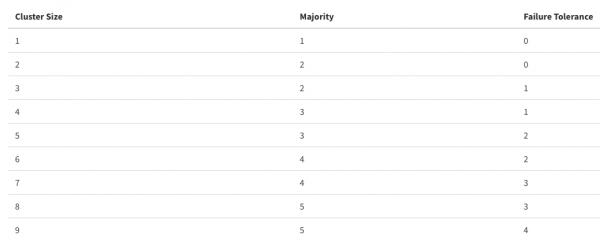
Tenga en cuenta que un aumento excesivo en el número de participantes en el clúster puede mejorar la tolerancia a fallos a expensas del rendimiento, todo debe estar en equilibrio.
En cuanto a la configuración del servicio, hay pocas recomendaciones:
Tener buen hardware, según el tamaño del clúster (puede leer ).
Ajustar algunos parámetros si ha distribuido el clúster entre un par de centros de datos o si su red y discos dejan mucho que desear (puede leer ).
Conclusión
En este artículo se describen los puntos que nuestro equipo intenta seguir. No es una descripción paso a paso de acciones, sino opciones que pueden ser útiles para optimizar los costos operativos del clúster. Está claro que cada clúster es único, y las decisiones de configuración pueden variar mucho, por lo que sería interesante recibir su retroalimentación: ¿cómo supervisa su clúster de Kubernetes, qué herramientas utiliza para mejorar su funcionamiento? Comparta su experiencia en los comentarios, será interesante conocerla.
Fuente: habr.com
