

Google ha presentado un nuevo códec de audio Lyra, optimizado para lograr la máxima calidad en la transmisión de voz incluso al usar canales de comunicación muy lentos. El código de implementación de Lyra está escrito en C++ y es de código abierto bajo la licencia Apache 2.0, pero entre las dependencias necesarias para su funcionamiento se encuentra la biblioteca propietaria libsparse_inference.so, que implementa el núcleo para cálculos matemáticos. Se señala que la biblioteca propietaria es temporal; Google promete desarrollar en el futuro un reemplazo abierto y garantizar el soporte para diversas plataformas.
En términos de calidad de los datos de voz transmitidos a bajas velocidades, Lyra supera significativamente a los códecs tradicionales que utilizan métodos de procesamiento digital de señales. Para lograr una alta calidad en la transmisión de voz en condiciones de un volumen limitado de información transmitida, además de los métodos convencionales de compresión de sonido y transformación de señales, Lyra utiliza un modelo de voz basado en un sistema de aprendizaje automático, que permite recrear la información faltante basándose en características típicas de la voz. El modelo utilizado para la generación del sonido ha sido entrenado con varias miles de horas de grabaciones de voces en más de 70 idiomas.
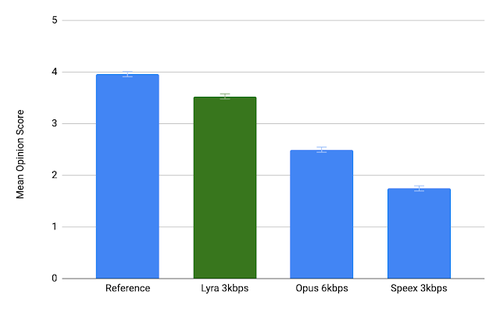
El códec incluye un codificador y un decodificador. El algoritmo de funcionamiento del codificador se centra en extraer parámetros de los datos de voz cada 40 milisegundos, comprimirlos y enviarlos al receptor a través de la red. Para transmitir datos, se requiere un canal de comunicación con una velocidad de 3 kilobits por segundo. Los parámetros de sonido extraídos incluyen espectrogramas mel-logarítmicos, que consideran las características de energía de la voz en diferentes rangos de frecuencia y están preparados teniendo en cuenta el modelo de percepción auditiva humana.
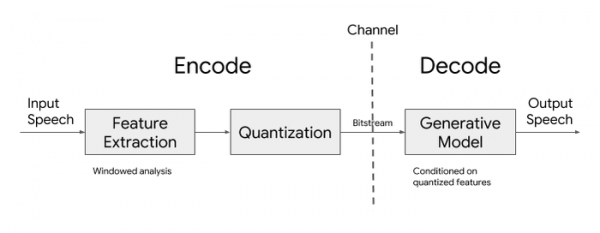
El decodificador utiliza un modelo generativo que recrea la señal de voz a partir de los parámetros de sonido enviados. Para reducir la complejidad de los cálculos, se aplicó un modelo ligero basado en una red neuronal recurrente, que es una variante del modelo de síntesis de voz WaveRNN, en el que se utiliza una frecuencia de muestreo más baja, pero se generan simultáneamente varias señales en diferentes rangos de frecuencia. Las señales obtenidas se superponen luego para obtener una única señal de salida, correspondiente a la frecuencia de muestreo especificada.
Para acelerar, también se aplican instrucciones de procesador especializadas, disponibles en procesadores ARM de 64 bits. Como resultado, a pesar del uso de aprendizaje automático, el códec Lyra puede utilizarse para la codificación y decodificación de voz en tiempo real en smartphones de gama media, mostrando una latencia de transmisión de señal de 90 milisegundos.
Fuente: opennet.ru
