

¡Hola Habr! Los conjuntos de datos para Big Data y aprendizaje automático están creciendo exponencialmente y necesitamos procesarlos rápidamente. Nuestra publicación trata sobre otra tecnología innovadora en el ámbito de los cálculos de alto rendimiento (HPC, High Performance Computing), presentada en el stand de Kingston en . Esta es la aplicación de sistemas de almacenamiento de datos de gama alta (SASD) en servidores con procesadores gráficos (GPU) y la tecnología de bus GPUDirect Storage. Gracias al intercambio directo de datos entre el SASD y la GPU, evitando la CPU, se acelera considerablemente la carga de datos en los aceleradores GPU, permitiendo que las aplicaciones de Big Data funcionen a máxima capacidad, gracias a las GPUs. Por su parte, a los desarrolladores de sistemas HPC les interesan los logros en el área de SASD con velocidad de entrada/salida extremadamente alta — tal como los que produce Kingston.
El rendimiento de la GPU supera la carga de datos
Desde que se creó CUDA en 2007 — una arquitectura de software y hardware para cálculos paralelos basados en GPU para el desarrollo de aplicaciones de propósito general, las capacidades de las propias GPUs han crecido increíblemente. Hoy, las GPUs tienen cada vez más aplicaciones en el ámbito de las aplicaciones HPC, como grandes datos (Big Data), aprendizaje automático (ML, machine learning) y aprendizaje profundo (DL, deep learning).
Cabe destacar que, a pesar de la similitud de los términos, los dos últimos son tareas algorítmicamente diferentes. ML enseña a la computadora a partir de datos estructurados, mientras que DL lo hace a partir de las respuestas de una red neuronal. Un ejemplo que ayuda a comprender las diferencias es bastante simple. Supongamos que una computadora debe distinguir entre fotos de gatos y perros que se cargan desde un sistema de almacenamiento. Para ML, se debe proporcionar un conjunto de imágenes con múltiples etiquetas, cada una de las cuales define una característica particular del animal. Para DL, es suficiente cargar un número mucho mayor de imágenes, pero sólo con una etiqueta que diga "esto es un gato" o "esto es un perro". DL es muy parecido a cómo se enseñan a los niños pequeños: simplemente se les muestran imágenes de perros y gatos en libros y en la vida real (a menudo, sin explicar la diferencia detallada), y el cerebro del niño comienza a identificar el tipo de animal después de un cierto número crítico de imágenes para comparar (se estima que son unas cien o más visualizaciones a lo largo de la infancia temprana). Los algoritmos de DL aún no son tan perfectos: para que la red neuronal pueda trabajar tan exitosamente en la identificación de imágenes, es necesario presentar y procesar millones de imágenes en la GPU.
Conclusión del prefacio: se pueden construir aplicaciones HPC en base a GPU en el ámbito de Big Data, ML y DL, pero existe un problema: los conjuntos de datos son tan grandes que el tiempo dedicado a cargar datos del sistema de almacenamiento a la GPU comienza a reducir el rendimiento general de la aplicación. En otras palabras, las GPUs rápidas siguen sin estar completamente cargadas debido a la lenta entrada-salida de datos de otros subsistemas. La diferencia en la velocidad de entrada/salida entre la GPU y el bus hacia la CPU/Sistema de almacenamiento puede ser de un orden de magnitud.
¿Cómo funciona la tecnología GPUDirect Storage?
El proceso de entrada-salida es controlado por la CPU, así como el proceso de carga de datos desde el almacenamiento hacia las GPUs para su posterior procesamiento. De aquí surge la necesidad de una tecnología que proporcione acceso directo entre la GPU y los discos NVMe para una rápida interacción entre ellos. La primera tecnología de este tipo fue propuesta por NVIDIA y se llamó GPUDirect Storage. En esencia, es una variante de una tecnología que ellos mismos desarrollaron anteriormente llamada GPUDirect RDMA (Acceso Directo a la Memoria Remota).
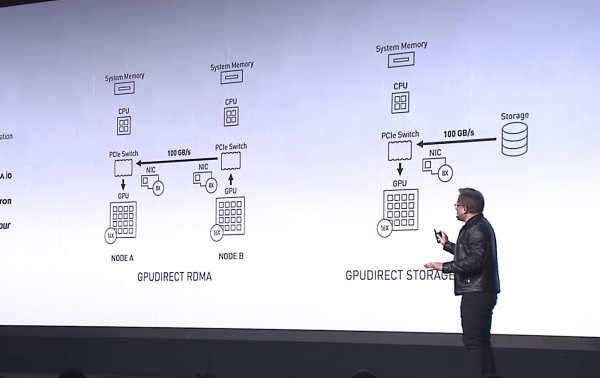
Jensen Huang, CEO de NVIDIA, presenta GPUDirect Storage como una variante de GPUDirect RDMA en la exhibición SC-19. Fuente: NVIDIA
La diferencia entre GPUDirect RDMA y GPUDirect Storage radica en los dispositivos entre los cuales se realiza la direccionamiento. La tecnología GPUDirect RDMA está destinada a mover datos directamente entre la tarjeta de red (NIC) y la memoria de la GPU, mientras que GPUDirect Storage proporciona un camino directo para transferir datos entre el almacenamiento local o remoto, como NVMe o NVMe a través de Fabric (NVMe-oF) y la memoria de la GPU.
Ambas opciones, GPUDirect RDMA y GPUDirect Storage, evitan el movimiento innecesario de datos a través del búfer en la memoria de la CPU y permiten que el mecanismo de acceso directo a la memoria (DMA) transfiera datos directamente desde la tarjeta de red o almacenamiento a la memoria de la GPU o viceversa, todo sin cargar el procesador central. Para GPUDirect Storage, la ubicación del almacenamiento no importa: puede ser un disco NVMe dentro de la unidad con GPU, en un rack o conectado a través de la red como NVMe-oF.
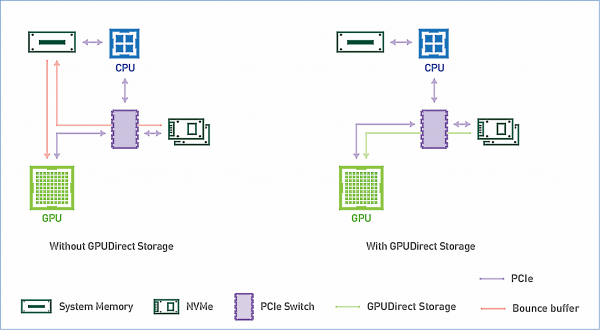
Esquema de funcionamiento de GPUDirect Storage. Fuente: NVIDIA
Los sistemas de almacenamiento de alta gama basados en NVMe son muy demandados en el mercado de aplicaciones HPC.
Entendiendo que con la llegada de GPUDirect Storage el interés de los grandes clientes se enfocará en la oferta de sistemas de almacenamiento que ofrezcan tasas de entrada/salida que coincidan con el ancho de banda de la GPU, en la exposición SC-19, Kingston mostró un sistema de demostración compuesto por un sistema de almacenamiento basado en discos NVMe y una unidad con GPU, en el cual se realizaba un análisis de miles de imágenes satelitales por segundo. Ya hemos escrito sobre este sistema de almacenamiento basado en 10 discos DC1000M U.2 NVMe. .
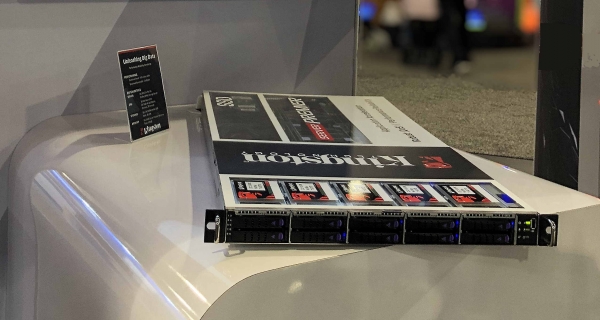
El sistema de almacenamiento basado en 10 discos DC1000M U.2 NVMe complementa a la perfección un servidor con aceleradores gráficos. Fuente: Kingston
Este sistema de almacenamiento se presenta en forma de una unidad en rack de 1U o mayor, y puede escalarse en función del número de discos DC1000M U.2 NVMe, donde cada uno tiene capacidades de 3.84 a 7.68 TB. El DC1000M es el primer modelo de SSD NVMe en factor de forma U.2 en la línea de dispositivos de Kingston para centros de datos. Tiene una calificación de resistencia (DWPD, escrituras por día del disco), que permite sobrescribir datos a su capacidad total una vez al día durante la vida útil garantizada del dispositivo.
En la prueba fio v3.13 sobre el sistema operativo Ubuntu 18.04.3 LTS, kernel de Linux 5.0.0-31-generic, el prototipo de sistema de almacenamiento exhibido mostró una velocidad de lectura (Sustained Read) de 5.8 millones IOPS con un ancho de banda sostenido (Sustained Bandwidth) de 23.8 Gbps.
Ariel Pérez, gerente de negocios SSD en Kingston, describió así los nuevos sistemas de almacenamiento: «Estamos listos para proporcionar la próxima generación de servidores con soluciones SSD U.2 NVMe, para eliminar muchos de los cuellos de botella en la transferencia de datos que tradicionalmente han estado asociados con los sistemas de almacenamiento. La combinación de unidades NVMe SSD y nuestra memoria RAM Server Premier DRAM convierte a Kingston en uno de los proveedores más completos de soluciones integrales para el procesamiento de datos en la industria».
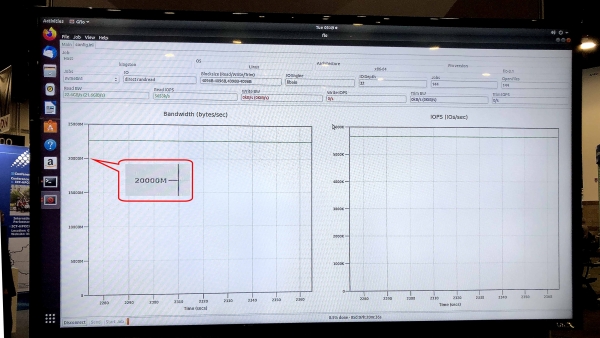
La prueba gfio v3.13 mostró un ancho de banda de 23.8 Gbps para el sistema de almacenamiento de demostración con discos DC1000M U.2 NVMe. Fuente: Kingston
¿Cómo se vería un sistema típico para aplicaciones HPC donde se implementa la tecnología GPUDirect Storage o una similar? Se trata de una arquitectura con separación física de bloques funcionales dentro del rack: una o dos unidades para memoria RAM, varias para nodos de computación GPU y CPU, y una o más unidades para el sistema de almacenamiento.
Con el anuncio de GPUDirect Storage y la posible aparición de tecnologías similares por parte de otros proveedores de GPU, Kingston experimenta un aumento en la demanda de sistemas de almacenamiento diseñados para su uso en computación de alto rendimiento. Un marcador será la velocidad de lectura de datos desde el sistema de almacenamiento, comparable al ancho de banda de tarjetas de red de 40 o 100 Gbps en la entrada al nodo de computación con GPU. Así, sistemas de almacenamiento ultrarrápidos, incluyendo NVMe externos a través de Fabric, pasarán de ser una excentricidad a convertirse en la norma para aplicaciones HPC. Además de la ciencia y los cálculos financieros, encontrarán uso en muchas otras áreas prácticas, como sistemas de seguridad de nivel metropolitano Safe City o centros de monitoreo de transporte, donde se requiere velocidad de reconocimiento e identificación a niveles de millones de imágenes HD por segundo», estableció el nicho de mercado para los sistemas de almacenamiento de alto rendimiento.
Puedes encontrar más información sobre los productos de Kingston en la empresa.
Fuente: habr.com
