

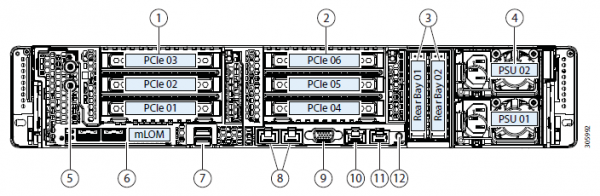
Este es un mito bastante común en el ámbito del hardware de servidores. Sin embargo, en la práctica, las soluciones hiperconvergentes (todo en uno) son necesarias por muchas razones. Históricamente, las primeras arquitecturas fueron desarrolladas por Amazon y Google para sus propios servicios. La idea era crear un granja de computación a partir de nodos idénticos, cada uno con sus propios discos. Todo esto se integraba con un software de sistematización (hipervisor) y se dividía en máquinas virtuales. La principal tarea era minimizar los esfuerzos en el mantenimiento de un nodo y minimizar los problemas durante la escalabilidad: simplemente se adquirían mil o dos de esos servidores y se conectaban al lado. En la práctica, esto es raro, y con mucho mayor frecuencia se habla de un menor número de nodos y una arquitectura un poco diferente.
Pero la ventaja sigue siendo la misma: una increíble simplicidad en la escalabilidad y gestión. La desventaja es que diferentes tareas consumen recursos de manera diferente, y en algunos casos habrá muchos discos locales, en otros habrá poca RAM, y así sucesivamente, lo que significa que con diferentes tipos de tareas, la utilización de recursos disminuirá.
Resulta que pagas un 10–15% más por la facilidad de configuración. Este es el mito detrás del encabezado. Buscamos durante mucho tiempo dónde se aplicaría la tecnología de manera óptima y lo encontramos. La cuestión es que Cisco no tenía sus propios sistemas de almacenamiento, pero querían abarcar el mercado de servidores completo. Y crearon Cisco Hyperflex, una solución con almacenamiento local en los nodos.
Y de esto inesperadamente surgió una muy buena solución para centros de datos de respaldo (Recuperación ante Desastres). Por qué y cómo, ahora les contaré. Y mostraré las pruebas del clúster.
Dónde se necesita
La hiperconvergencia es:
- La transferencia de discos a los nodos de computación.
- La integración completa del subsistema de almacenamiento de datos con el subsistema de virtualización.
- La transferencia / integración con el subsistema de red.
Tal conexión permite implementar muchas características de almacenamiento de datos a nivel de virtualización y todo desde una única ventana de gestión.
En nuestra empresa, hay una gran demanda de proyectos de diseño de centros de datos de respaldo, y a menudo se elige una solución hiperconvergente debido a la amplia variedad de opciones de replicación (incluso hasta un metroclúster) disponibles de manera estándar.
En el caso de los centros de datos de respaldo, generalmente se trata de un objeto remoto ubicado en el otro extremo de la ciudad o incluso en otra ciudad. Permite recuperar sistemas críticos en caso de una falla parcial o total del centro de datos principal. Los datos se replican continuamente desde la producción, y esta replicación puede realizarse a nivel de aplicación o a nivel de dispositivo de almacenamiento (SAN).
Por lo tanto, ahora hablaré sobre la estructura del sistema y las pruebas, y luego sobre un par de escenarios de aplicación real con datos sobre el ahorro.
Pruebas
Nuestro ejemplar consta de cuatro servidores, cada uno con 10 discos SSD de 960 GB. Hay un disco dedicado para el almacenamiento en caché de operaciones de escritura y para la máquina virtual de servicio. La solución es la cuarta versión. La primera era claramente mediocre (según los comentarios), la segunda tenía problemas, la tercera ya era bastante estable, y esta se puede considerar un lanzamiento tras finalizar la beta pública. Durante el tiempo de prueba, no vi problemas, todo funciona a la perfección.
Cambios en v4Se han corregido un montón de errores.
Inicialmente, la plataforma solo podía funcionar con el hipervisor VMware ESXi y admitía un número limitado de nodos. Además, el proceso de implementación no siempre finalizaba con éxito, era necesario reiniciar algunos pasos, había problemas con la actualización desde versiones anteriores, y los datos en la GUI no siempre se mostraban correctamente (aunque aún no estoy encantado con la visualización de los gráficos de rendimiento), a veces surgían problemas en la integración con la virtualización.
Ahora todos los problemas iniciales han sido solucionados, HyperFlex es compatible tanto con ESXi como con Hyper-V, además de esto es posible:
- Crear un clúster expandido.
- Crear un clúster para oficinas sin usar Fabric Interconnect, de dos a cuatro nodos (solo compramos servidores).
- Posibilidad de trabajar con SAN externas.
- Soporte para contenedores y Kubernetes.
- Crear zonas de disponibilidad.
- Integración con VMware SRM, si la funcionalidad incorporada no satisface las necesidades.
La arquitectura no difiere mucho de las soluciones de los principales competidores, no se ha reinventado la rueda. Todo esto funciona en la plataforma de virtualización VMware o Hyper-V. Se aloja físicamente en servidores de desarrollo propio de Cisco UCS. Hay quienes odian la plataforma por su relativa complejidad en la configuración inicial, el montón de botones, un sistema de plantillas y dependencias no trivial, pero también hay quienes han encontrado el zen, se han empapado de la idea y ya no quieren trabajar con otros servidores.
Nos enfocaremos en la solución para VMware, ya que se creó inicialmente para esta y tiene más funcionalidad; Hyper-V fue mejorado sobre la marcha para no quedarse atrás de los competidores y cumplir con las expectativas del mercado.
Hay un clúster de servidores equipados con discos. Hay discos para almacenamiento de datos (SSD o HDD, según su gusto y necesidades), y hay un SSD para caching. Al escribir datos en el datastore, se realiza la preservación de datos en la capa de caché (disco SSD dedicado y RAM de la VM de servicio). Al mismo tiempo, un bloque de datos se envía a los nodos en el clúster (el número de nodos depende del factor de replicación del clúster). Después de la confirmación de todos los nodos sobre la escritura exitosa, la confirmación se envía al hipervisor y luego a la VM. Los datos escritos se desduplican, comprimen y almacenan en discos en segundo plano. A su vez, siempre se escribe un gran bloque en los discos de almacenamiento de manera secuencial, lo que reduce la carga en ellos.
La desduplicación y compresión están siempre activadas y no se pueden desactivar. La lectura de datos se realiza directamente desde los discos de almacenamiento o desde la caché RAM. Si se utiliza una configuración híbrida, la lectura también se almacena en un disco SSD.
Los datos no están vinculados a la ubicación actual de la máquina virtual y se distribuyen uniformemente entre los nodos. Este enfoque permite cargar de manera equitativa todos los discos y las interfaces de red. Surge un claro inconveniente: no podemos reducir al mínimo la latencia de lectura, ya que no hay garantía de que los datos estén localmente disponibles. Pero considero que este es un sacrificio menor en comparación con las ventajas obtenidas. Especialmente porque las latencias de red han alcanzado niveles en los que prácticamente no afectan el resultado general.
Toda la lógica de funcionamiento del subsistema de discos es gestionada por una VM de servicio especial, el controlador Cisco HyperFlex Data Platform, que se crea en cada nodo de almacenamiento. En nuestra configuración, se asignaron ocho vCPU y 72 GB de RAM a la VM de servicio, lo cual no es poco. Cabe recordar que el host tiene disponibles 28 núcleos físicos y 512 GB de RAM.
La VM de servicio tiene acceso directo a los discos físicos a través de la conexión del controlador SAS en la VM. La comunicación con el hipervisor se realiza a través de un módulo especial llamado IOVisor, que intercepta las operaciones de entrada y salida, y mediante un agente que permite enviar comandos a la API del hipervisor. El agente se encarga de trabajar con los snapshots y clones de HyperFlex.
En el hipervisor, los recursos de disco se montan como NFS o SMB (dependiendo del tipo de hipervisor, adivinen cuál es cuál). Pero bajo el capó, se trata de un sistema de archivos distribuido que permite añadir características de sistemas de almacenamiento completo: asignación de volúmenes delgada, compresión y deduplicación, snapshots mediante la tecnología Redirect-on-Write, replicación sincrónica/asincrónica.
La VM de servicio proporciona acceso a la interfaz web de gestión del subsistema HyperFlex. Hay integración con vCenter, y gran parte de las tareas diarias se pueden realizar desde allí, pero las datastores, por ejemplo, es más conveniente configurarlas desde una web separada, si ya ha pasado a la interfaz rápida de HTML5, o utilizar el cliente Flash completo con integración total. En la web de servicio se puede ver el rendimiento y el estado detallado del sistema.
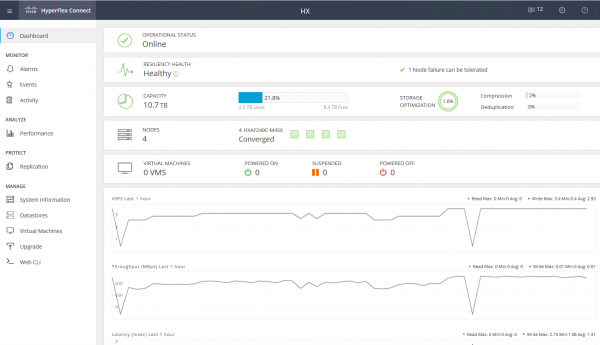
También existe otro tipo de nodos en el clúster: los nodos de computación. Estos pueden ser servidores en rack o blade sin discos incorporados. En estos servidores se pueden ejecutar VMs cuyas datos se almacenan en servidores con discos. Desde el punto de vista del acceso a los datos, no hay diferencia entre los tipos de nodos, ya que la arquitectura permite abstraerse de la ubicación física de los datos. La relación máxima de nodos de computación a nodos de almacenamiento es de 2:1.
El uso de nodos de computación aumenta la flexibilidad al escalar los recursos del clúster: no es necesario adquirir nodos con discos si solo necesitamos CPU/RAM. Además, podemos agregar un blade chassis y obtener ahorros en el espacio para servidores en el rack.
En resumen, tenemos una plataforma hiperconvergente con las siguientes características:
- Hasta 64 nodos en el clúster (hasta 32 nodos de almacenamiento).
- La cantidad mínima de nodos en el clúster es de tres (dos para el clúster Edge).
- Mecanismo de redundancia de datos: espejado con un factor de replicación de 2 y 3.
- Clúster Metro.
- Replicación asíncrona de VM a otro clúster HyperFlex.
- Orquestación de conmutación de VM a un centro de datos remoto.
- Instantáneas nativas con tecnología Redirect-on-Write.
- Hasta 1 PB de espacio útil con un factor de replicación de 3 sin considerar la deduplicación. No consideramos el factor de replicación 2, ya que no es una opción seria para la venta.
Otro gran beneficio es la simplicidad en la gestión y despliegue. Todas las complejidades de la configuración de servidores UCS son manejadas por una VM especializada, preparada por ingenieros de Cisco.
Configuración del banco de pruebas:
- 2 x Cisco UCS Fabric Interconnect 6248UP como clúster de gestión y componentes de red (48 puertos, funcionando en modo Ethernet 10G/FC 16G).
- Cuatro servidores Cisco UCS HXAF240 M4.
Características de los servidores:
CPU
2 x Intel ® Xeon ® E5-2690 v4
RAM
16 x 32GB DDR4-2400-MHz RDIMM/PC4-19200/rango dual/x4/1.2v
Red
UCSC-MLOM-CSC-02 (VIC 1227). 2 puertos 10G Ethernet
HBA de almacenamiento
Controlador de pasaje SAS modular Cisco 12G
Discos de almacenamiento
1 x SSD Intel S3520 120 GB, 1 x SSD Samsung MZ-IES800D, 10 x SSD Samsung PM863a 960 GB
Más opciones de configuraciónAdemás del hardware seleccionado, actualmente están disponibles las siguientes opciones:
- HXAF240c M5.
- Uno o dos CPU desde Intel Silver 4110 hasta Intel Platinum I8260Y. Disponible la segunda generación.
- 24 ranuras de memoria, módulos desde 16 GB RDIMM 2600 hasta 128 GB LRDIMM 2933.
- De 6 a 23 discos para datos, un disco de caché, un disco del sistema y uno de arranque.
Discos de capacidad
- HX-SD960G61X-EV 960GB 2.5 pulgadas Enterprise Value 6G SATA SSD (1X resistencia) SAS 960 GB.
- HX-SD38T61X-EV 3.8TB 2.5 pulgadas Enterprise Value 6G SATA SSD (1X resistencia) SAS 3.8 TB.
- Discos de caché
- HX-NVMEXPB-I375 375GB 2.5 pulgadas Intel Optane Drive, rendimiento extremo & resistencia.
- HX-NVMEHW-H1600* 1.6TB 2.5 pulgadas Ent. Perf. NVMe SSD (3X resistencia) NVMe 1.6 TB.
- HX-SD400G12TX-EP 400GB 2.5 pulgadas Ent. Perf. 12G SAS SSD (10X resistencia) SAS 400 GB.
- HX-SD800GBENK9** 800GB 2.5 pulgadas Ent. Perf. 12G SAS SED SSD (10X resistencia) SAS 800 GB.
- HX-SD16T123X-EP 1.6TB 2.5 pulgadas Enterprise performance 12G SAS SSD (3X resistencia).
Discos de sistema / registro
- HX-SD240GM1X-EV 240GB 2.5 pulgadas Enterprise Value 6G SATA SSD (requiere actualización).
Discos de arranque
- HX-M2-240GB 240GB SATA M.2 SSD SATA 240 GB.
Conexión a la red a través de puertos Ethernet de 40G, 25G o 10G.
Como FI, pueden ser HX-FI-6332 (40G), HX-FI-6332-16UP (40G), HX-FI-6454 (40G/100G).
La prueba misma
Para probar el subsistema de disco, utilicé HCIBench 2.2.1. Esta es una herramienta gratuita que permite automatizar la creación de carga de varias máquinas virtuales. La carga misma se genera con el uso de fio convencional.
Nuestro clúster está compuesto por cuatro nodos, con un factor de replicación de 3, todos los discos Flash.
Para las pruebas, creé cuatro datastores y ocho máquinas virtuales. Para las pruebas de escritura, se prevé un escenario en el que el disco caché no se sobrecarga.
Los resultados de las pruebas son los siguientes:
100 % Lectura 100 % Aleatorio
0 % Lectura 100 % Aleatorio
Bloque/profundidad de cola
128
256
512
1024
2048
128
256
512
1024
2048
4K
0,59 ms 213804 IOPS
0,84 ms 303540 IOPS
1,36 ms 374348 IOPS
2,47 ms 414116 IOPS
4,86 ms 420180 IOPS
2,22 ms 57408 IOPS
3,09 ms 82744 IOPS
5,02 ms 101824 IOPS
8,75 ms 116912 IOPS
17,2 ms 118592 IOPS
8K
0,67 ms 188416 IOPS
0,93 ms 273280 IOPS
1,7 ms 299932 IOPS
2,72 ms 376484 IOPS
5,47 ms 373176 IOPS
3,1 ms 41148 IOPS
4,7 ms 54396 IOPS
7,09 ms 72192 IOPS
12,77 ms 80132 IOPS
16K
0,77 ms 164116 IOPS
1,12 ms 228328 IOPS
1,9 ms 268140 IOPS
3,96 ms 258480 IOPS
3,8 ms 33640 IOPS
6,97 ms 36696 IOPS
11,35 ms 45060 IOPS
32K
1,07 ms 119292 IOPS
1,79 ms 142888 IOPS
3,56 ms 143760 IOPS
7,17 ms 17810 IOPS
11,96 ms 21396 IOPS
64K
1,84 ms 69440 IOPS
3,6 ms 71008 IOPS
7,26 ms 70404 IOPS
11,37 ms 11248 IOPS
Los valores en negrita indican después de los cuales no hay crecimiento en el rendimiento, a veces incluso se observa degradación. Esto se debe a que llegamos al límite del rendimiento de la red/controladores/discos.
- Lectura secuencial 4432 MB/s.
- Escritura secuencial 804 MB/s.
- Con la falla de un controlador (falla de la máquina virtual o del host), la caída en el rendimiento es del doble.
- En caso de falla del disco de almacenamiento, la caída es de 1/3. La reconstrucción del disco consume el 5% de los recursos de cada controlador.
En bloques pequeños, alcanzamos el rendimiento del controlador (máquina virtual), su CPU está cargada al 100%, al aumentar el bloque estamos limitados por el ancho de banda de los puertos. 10 Gbps no es suficiente para aprovechar el potencial de los sistemas AllFlash. Desafortunadamente, las características del stand demo proporcionado no permiten verificar el funcionamiento en 40 Gbps.
Según mi impresión de las pruebas y el estudio de la arquitectura, gracias al algoritmo que distribuye los datos entre todos los hosts, obtenemos un rendimiento escalable y predecible, pero esta también es una limitación durante la lectura, ya que de los discos locales se podría extraer más; aquí podría ayudar una red más rápida, por ejemplo, hay FI disponibles de 40 Gbps.
También, un solo disco para caché y deduplicación puede ser una limitación, de hecho, en este stand podemos escribir en cuatro discos SSD. Sería excelente poder aumentar la cantidad de discos de caché y ver la diferencia.
Uso real
Para organizar un centro de datos secundario de respaldo, se pueden usar dos enfoques (no consideramos el almacenamiento de copias de seguridad en un sitio remoto):
- Activo-Pasivo. Todas las aplicaciones se alojan en el centro de datos principal. La replicación es sincrónica o asincrónica. En caso de caída del centro de datos principal, debemos activar el de respaldo. Esto se puede hacer manualmente, con scripts o aplicaciones de orquestación. Aquí obtendremos un RPO que es comparable con la frecuencia de replicación, y el RTO depende de la reacción y habilidades del administrador así como de la calidad de preparación/debugging del plan de conmutación.
- Activo-Activo. En este caso hay solo replicación sincrónica, la disponibilidad de los centros de datos se determina por el quórum/árbitro, que se aloja estrictamente en un tercer sitio. RPO = 0, y el RTO puede alcanzar 0 (si la aplicación lo permite) o ser igual al tiempo de manejo de la falla de una nodo en el clúster de virtualización. En el nivel de virtualización se crea un clúster extendido (Metro) que requiere un almacenamiento de red Activo-Activo.
Normalmente vemos que los clientes ya han implementado una arquitectura con almacenamiento clásico en el centro de datos principal, por lo que diseñamos otro para la replicación. Como mencioné, Cisco HyperFlex ofrece replicación asincrónica y la creación de un clúster de virtualización extendido. No necesitamos un almacenamiento de nivel Medio y superior con funciones de replicación y acceso Activo-Activo a datos en dos sistemas de almacenamiento costosos.
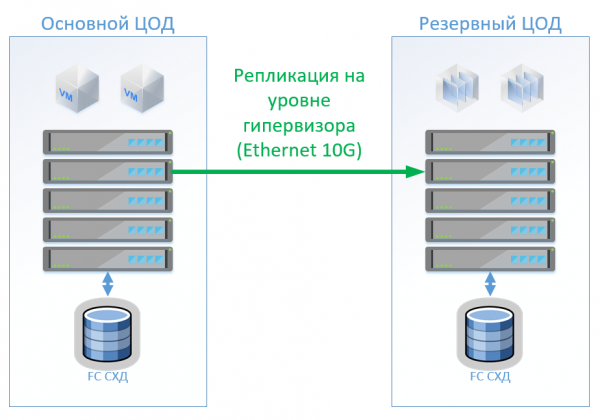
Escenario 1: Tenemos un centro de datos principal y un centro de datos de respaldo, con una plataforma de virtualización en VMware vSphere. Todos los sistemas productivos están en el centro de datos principal, y la replicación de máquinas virtuales se realiza a nivel de hipervisor, lo que permite no mantener las máquinas virtuales encendidas en el centro de datos de respaldo. Las bases de datos y aplicaciones especiales se replican usando medios incorporados y mantenemos las máquinas virtuales encendidas. En caso de falla del centro de datos principal, iniciamos los sistemas en el centro de datos de respaldo. Contamos con alrededor de 100 máquinas virtuales. Mientras el centro de datos principal esté activo, se pueden lanzar entornos de prueba y otros sistemas en el centro de datos de respaldo, que pueden apagarse en caso de conmutación del centro de datos principal. También es posible una opción en la que utilizamos replicación bidireccional. Desde el punto de vista del hardware, nada cambiará.
En el caso de la arquitectura clásica, colocaremos una SAN híbrida en cada centro de datos con acceso por FibreChannel, tiering, deduplicación y compresión (pero no en línea), 8 servidores en cada ubicación, 2 switches FibreChannel y Ethernet 10G. Para la replicación y el control de conmutación en la arquitectura clásica, podemos usar herramientas de VMware (Replication + SRM) o herramientas de terceros, que serán un poco más baratas y a veces más convenientes.
En la figura se presenta el esquema.
En caso de usar Cisco HyperFlex, se obtiene la siguiente arquitectura:
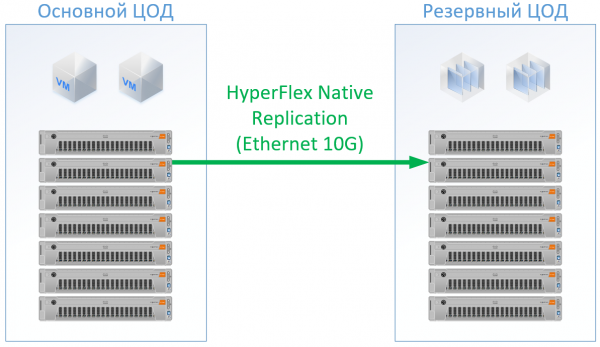
Para HyperFlex utilicé servidores con grandes recursos de CPU/RAM, ya que parte de los recursos se destinará a la VM del controlador HyperFlex. En cuanto a CPU y memoria, incluso hice un sobreaprovisionamiento en la configuración de HyperFlex para no favorecer a Cisco y garantizar recursos para las demás VMs. Así, podemos prescindir de los switches FibreChannel y no necesitaremos puertos Ethernet para cada servidor; el tráfico local se conmutará dentro de FI.
Como resultado, obtuvimos la siguiente configuración para cada centro de datos:
Servidores
8 x Servidor 1U (384 GB RAM, 2 x Intel Gold 6132, FC HBA)
8 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6150, 3,2 GB SSD, 10 x 6 TB NL-SAS)
Sistema de almacenamiento
SAN híbrida con FC Front-End (20TB SSD, 130 TB NL-SAS)
—
LAN
2 x switch Ethernet 10G de 12 puertos
—
SAN
2 x switch FC de 32/16Gb de 24 puertos
2 x Cisco UCS FI 6332
Licencias
VMware Ent Plus
Replicación y/o orquestación de conmutación de VM
VMware Ent Plus
Para HyperFlex no incluí licencias de software de replicación, ya que esto está disponible de serie.
Para la arquitectura clásica, seleccioné un proveedor que se ha afianzado como un fabricante de calidad y a buen precio. Para ambas opciones apliqué un descuento estándar para la solución específica, y al final obtuve precios reales.
La solución en Cisco HyperFlex resultó ser un 13% más barata.
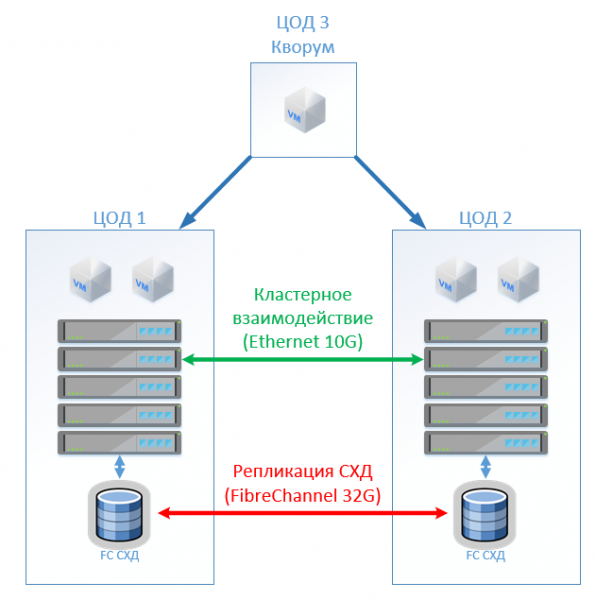
Escenario 2: creación de dos centros de datos activos. En este escenario, estamos diseñando un clúster extendido en VMware.
La arquitectura clásica consiste en servidores de virtualización, SAN (protocolo FC) y dos SAN que pueden leer y escribir en el almacenamiento, extendido entre ellas. En cada SAN, se prevé una capacidad útil para la ubicación.
Con HyperFlex simplemente creamos un Clúster Extendido con el mismo número de nodos en ambas ubicaciones. En este caso, se utiliza un factor de replicación 2+2.
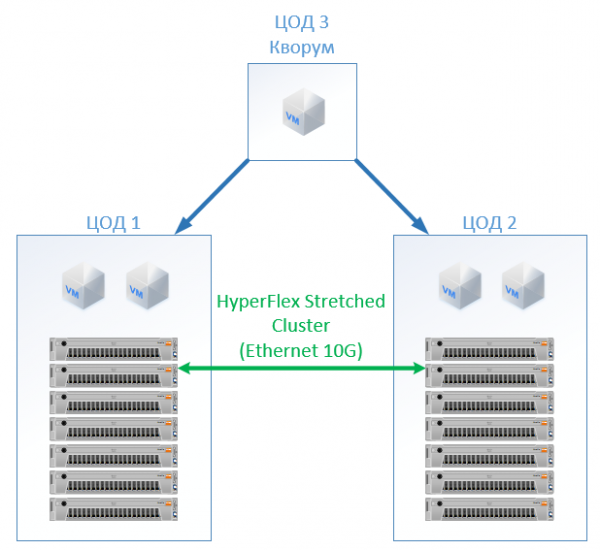
Se obtuvo la siguiente configuración:
Arquitectura clásica
HyperFlex
Servidores
16 x Servidor 1U (384 GB RAM, 2 x Intel Gold 6132, FC HBA, 2 x 10G NIC)
16 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6132, 1,6 TB NVMe, 12 x 3,8 TB SSD, VIC 1387)
Sistema de almacenamiento
2 x SAN AllFlash (150 TB SSD)
—
LAN
4 x switch Ethernet 10G de 24 puertos
—
SAN
4 x switch FC de 32/16Gb de 24 puertos
4 x Cisco UCS FI 6332
Licencias
VMware Ent Plus
VMware Ent Plus
En todos los cálculos, no consideré la infraestructura de red, los costos del centro de datos, etc.: serán idénticos para la arquitectura clásica y para la solución en HyperFlex.
En términos de costos, HyperFlex resultó ser un 5% más caro. Aquí cabe destacar que en cuanto a recursos de CPU/RAM, tuve un sesgo hacia Cisco, ya que en la configuración distribuí uniformemente los canales de los controladores de memoria. El costo es un poco más alto, pero no desproporcionado, lo que indica claramente que la hiperconvergencia no es necesariamente un "juguete para ricos", sino que puede competir con el enfoque estándar para la construcción de un centro de datos. También puede ser interesante para aquellos que ya tienen servidores Cisco UCS y la infraestructura correspondiente para ellos.
Entre las ventajas, obtendremos la ausencia de costos de administración de SAN y almacenamiento, compresión y deduplicación online, un único punto de entrada para soporte (virtualización, servidores, que son los mismos — almacenamiento), ahorro de espacio (aunque no en todos los escenarios) y simplificación de la operación.
En cuanto al soporte, aquí lo obtienes de un solo proveedor: Cisco. Si juzgo por mi experiencia con los servidores Cisco UCS, me parece bastante buena; en HyperFlex no tuve que abrir nada, ya que todo funcionaba bien. Los ingenieros responden rápidamente y pueden resolver no solo problemas estándar, sino también casos límite complejos. A veces me dirijo a ellos con preguntas como: "¿Se puede hacer esto, conectar aquello?" o "He configurado algo y no quiere funcionar. ¡Ayuda!" — con paciencia, ellos encuentran la guía necesaria y indican los pasos correctos; no responderán diciendo: "Solo solucionamos problemas de hardware".
Enlaces
- Mi correo es StGeneralov@croc.ru
Fuente: habr.com
