

¡Hola, Habr! En este artículo quiero hablarte de una herramienta maravillosa para el desarrollo de procesos por lotes para el procesamiento de datos, por ejemplo, en la infraestructura de un DWH corporativo o en tu DataLake. Hablaremos de Apache Airflow (en adelante Airflow). Ha sido injustamente ignorado en Habr, y en la parte principal intentaré convencerte de que al menos debes considerar Airflow al elegir un programador para tus procesos ETL/ELT.
Anteriormente escribí una serie de artículos sobre DWH cuando trabajaba en Tinkoff Bank. Ahora soy parte del equipo de Mail.Ru Group y estoy trabajando en el desarrollo de una plataforma para el análisis de datos en la dirección de juegos. A medida que surjan noticias y soluciones interesantes, mi equipo y yo compartiremos aquí sobre nuestra plataforma para el análisis de datos.
Prólogo
Así que empecemos. ¿Qué es Airflow? Es una biblioteca (o ) para el desarrollo, planificación y monitoreo de flujos de trabajo. La característica principal de Airflow es que para describir (desarrollar) procesos se utiliza código en Python. Esto trae consigo numerosas ventajas para organizar tu proyecto y desarrollo: en esencia, tu proyecto ETL (por ejemplo) es simplemente un proyecto de Python, y puedes organizarlo como desees teniendo en cuenta las particularidades de la infraestructura, el tamaño del equipo y otros requisitos. En cuanto a las herramientas, todo es sencillo. Usa, por ejemplo, PyCharm + Git. ¡Es fantástico y muy cómodo!
Ahora examinemos las entidades principales de Airflow. Al comprender su esencia y propósito, podrás organizar óptimamente la arquitectura de los procesos. Probablemente, la entidad principal es el Grafo Acíclico Dirigido (en adelante DAG).
DAG
Un DAG es una agrupación semántica de tus tareas que deseas ejecutar en un orden específico según un cronograma determinado. Airflow ofrece una interfaz web conveniente para trabajar con DAGs y otras entidades:
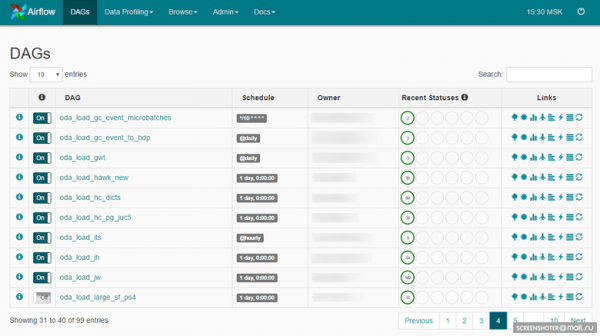
Un DAG puede verse así:
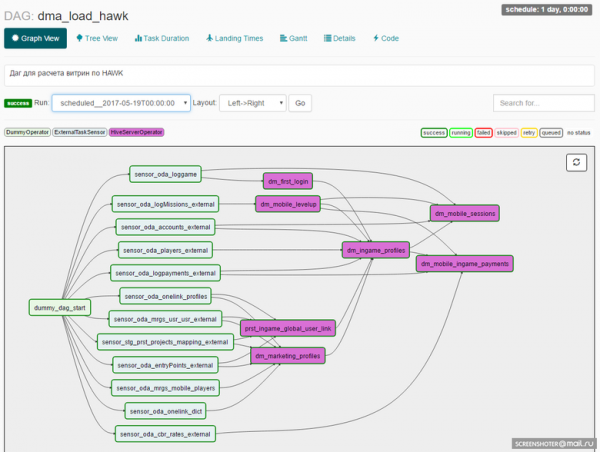
Un desarrollador, al diseñar un DAG, establece un conjunto de operadores en los que se basarán las tareas dentro del DAG. Aquí llegamos a otra entidad importante: el Operador de Airflow.
Operadores
Un Operador es la entidad a partir de la cual se crean instancias de tareas, donde se describe qué sucederá durante la ejecución de la instancia de la tarea. ya incluyen un conjunto de operadores listos para usar. Ejemplos:
- BashOperator: operador para ejecutar comandos bash.
- PythonOperator: operador para invocar código Python.
- EmailOperator: operador para enviar un correo electrónico.
- HTTPOperator: operador para trabajar con solicitudes http.
- SqlOperator: operador para ejecutar código SQL.
- Sensor: operador que espera a que ocurra un evento (como el momento adecuado, la aparición de un archivo requerido, una línea en la base de datos, una respuesta de API, etc.).
Hay operadores más específicos: DockerOperator, HiveOperator, S3FileTransferOperator, PrestoToMysqlOperator, SlackOperator.
También puedes desarrollar operadores ajustados a tus necesidades y usarlos en tu proyecto. Por ejemplo, creamos MongoDBToHiveViaHdfsTransfer, un operador que exporta documentos de MongoDB a Hive, y varios operadores para trabajar con: CHLoadFromHiveOperator y CHTableLoaderOperator. Esencialmente, cuando hay código que se usa frecuentemente en el proyecto, construido sobre operadores básicos, puedes considerar crear un nuevo operador. Esto facilitará el desarrollo futuro y enriquecerá tu biblioteca de operadores en el proyecto. A continuación, todas estas instancias de tareas deben ejecutarse, y ahora abordaremos el programador.
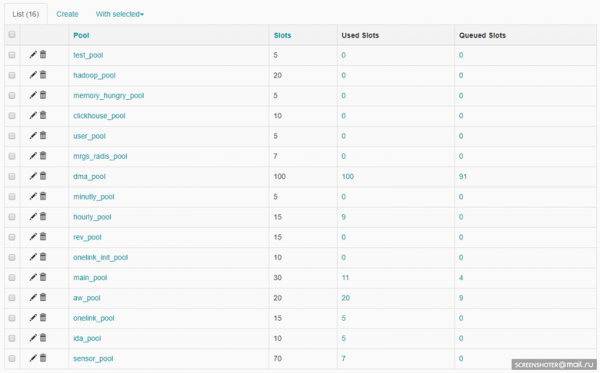
El programador de tareas en Airflow se basa en
Programador
Celery. Cada grupo tiene un límite en la cantidad de espacios. Al crear un DAG, se le asigna un grupo:
ALERT_MAILS = Variable.get("gv_mail_admin_dwh") DAG_NAME = 'dma_load' OWNER = 'Vasya Pupkin' DEPENDS_ON_PAST = True EMAIL_ON_FAILURE = True EMAIL_ON_RETRY = True RETRIES = int(Variable.get('gv_dag_retries')) POOL = 'dma_pool' PRIORITY_WEIGHT = 10start_dt = datetime.today() - timedelta(1) start_dt = datetime(start_dt.year, start_dt.month, start_dt.day)default_args = { 'owner': OWNER, 'depends_on_past': DEPENDS_ON_PAST, 'start_date': start_dt, 'email': ALERT_MAILS, 'email_on_failure': EMAIL_ON_FAILURE, 'email_on_retry': EMAIL_ON_RETRY, 'retries': RETRIES, 'pool': POOL, 'priority_weight': PRIORITY_WEIGHT } dag = DAG(DAG_NAME, default_args=default_args) dag.doc_md = __doc__
El grupo asignado a nivel de DAG se puede sobrescribir a nivel de tarea.La planificación de todas las tareas en Airflow es responsabilidad de un proceso separado: el Scheduler. Esencialmente, el Scheduler maneja toda la mecánica de la programación de tareas para su ejecución. Antes de que una tarea pueda ejecutarse, pasa por varias etapas:
La planificación de todas las tareas en Airflow es responsabilidad de un proceso separado: el Scheduler. Esencialmente, el Scheduler maneja toda la mecánica de la programación de tareas para su ejecución. Antes de que una tarea pueda ejecutarse, pasa por varias etapas:
- En DAG se han completado las tareas anteriores, la nueva se puede poner en cola.
- La cola se ordena según la prioridad de las tareas (también se puede gestionar la prioridad) y, si hay un espacio libre en el grupo, la tarea se puede agregar al trabajo.
- Si hay un worker de celery libre, la tarea se envía a él; comienza el trabajo que has programado en la tarea, utilizando el operador correspondiente.
Bastante simple.
El Scheduler trabaja en múltiples DAG y en todas las tareas dentro de los DAG.
Para que el Scheduler comience a trabajar con un DAG, se debe establecer un horario para el DAG:
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='@hourly')Hay un conjunto de presets listos: @once, @hourly, @daily, @weekly, @monthly, @yearly.
También se pueden usar expresiones de cron:
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='*\/10 * * * *')Fecha de Ejecución
Para entender cómo funciona Airflow, es importante comprender qué es la Fecha de Ejecución para un DAG. En Airflow, un DAG tiene una dimensión de Fecha de Ejecución, es decir, se crean instancias de tareas para cada Fecha de Ejecución, dependiendo del horario de trabajo del DAG. Y cada Fecha de Ejecución se puede ejecutar nuevamente — o, por ejemplo, el DAG puede trabajar simultáneamente en varias Fechas de Ejecución. Esto se ilustra claramente aquí:
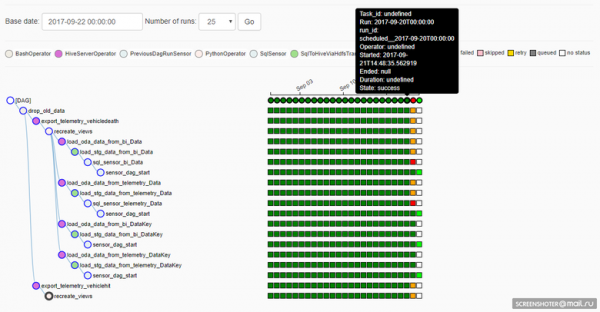
Desafortunadamente (o quizás afortunadamente: depende de la situación), si se modifica la implementación de una tarea en el DAG, la ejecución en las Fechas de Ejecución anteriores se realizará teniendo en cuenta las correcciones. Esto es bueno si necesitas recalcular datos en períodos pasados con un nuevo algoritmo, pero malo porque se pierde la reproducibilidad del resultado (por supuesto, nadie impide que devuelvas desde Git la versión necesaria del código fuente y calcules una vez lo que necesitas, tal como debe ser).
Generación de tareas
La implementación de un DAG es código en Python, por lo que tenemos una manera muy conveniente de reducir la cantidad de código cuando se trabaja, por ejemplo, con fuentes fragmentadas. Supongamos que tienes tres shards de MySQL como fuente, necesitas acceder a cada uno y recuperar algunos datos. Además, de manera independiente y paralela. El código en Python en el DAG podría verse así:
connection_list = lv.get('connection_list')

export_profiles_sql = '''
SELECT
  id,
  user_id,
  nickname,
  gender,
  {{params.shard_id}} as shard_id
FROM profiles
'''

for conn_id in connection_list:
    export_profiles = SqlToHiveViaHdfsTransfer(
        task_id='export_profiles_from_' + conn_id,
        sql=export_profiles_sql,
        hive_table='stg.profiles',
        overwrite=False,
        tmpdir='\/data\/tmp',
        conn_id=conn_id,
        params={'shard_id': conn_id[-1:], },
        compress=None,
        dag=dag
    )
    export_profiles.set_upstream(exec_truncate_stg)
    export_profiles.set_downstream(load_profiles
El DAG resulta así:
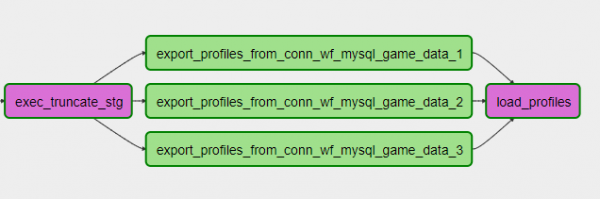
Se puede agregar o quitar un shard simplemente ajustando la configuración y actualizando el DAG. ¡Es conveniente!
También se puede utilizar una generación de código más compleja; por ejemplo, trabajar con fuentes en forma de bases de datos o describir una estructura tabular, un algoritmo para trabajar con la tabla y, teniendo en cuenta las particularidades de la infraestructura DWH, generar el proceso de carga de N tablas en su almacenamiento. O, por ejemplo, trabajar con una API que no admite operar con parámetros en forma de lista, puede generar N tareas en el DAG a partir de esta lista, limitar la paralelización de las solicitudes a la API a un grupo y extraer de la API los datos necesarios. ¡Es flexible!
Repositorio
Airflow tiene su propio repositorio backend, una base de datos (puede ser MySQL o Postgres, nosotros usamos Postgres), en la que se almacenan los estados de las tareas, los DAG, las configuraciones de conexiones, variables globales, etc. Aquí me gustaría mencionar que el repositorio en Airflow es muy simple (alrededor de 20 tablas) y conveniente si desea construir algún proceso sobre él. Recuerdo las 100500 tablas en el repositorio de Informatica, que requerían mucho tiempo para entender antes de poder formular una consulta.
Monitoreo
Dada la simplicidad del repositorio, puede construir su propio proceso de monitoreo de tareas. Nosotros utilizamos un cuaderno en Zeppelin, donde vemos el estado de las tareas:
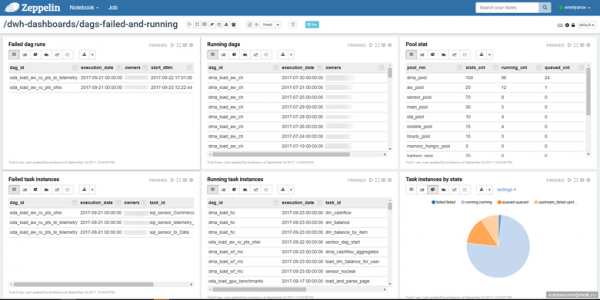
Esto puede ser también la interfaz web de Airflow en sí:
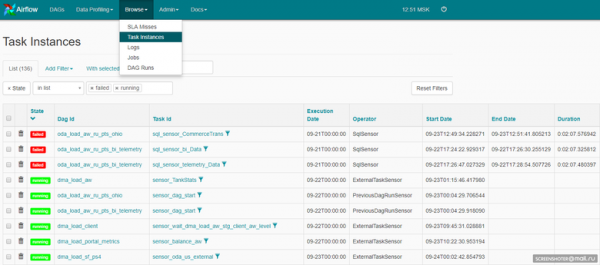
El código de Airflow es abierto, por lo que hemos añadido alertas en Telegram. Cada instancia de tarea que funciona, si ocurre un error, envía spam a un grupo de Telegram donde está todo el equipo de desarrollo y soporte.
Obtenemos reacciones rápidas a través de Telegram (si es necesario), y a través de Zeppelin, una visión general de las tareas en Airflow.
Total
Airflow es, ante todo, de código abierto, y no se debe esperar maravillas de él. Esté preparado para dedicar tiempo y esfuerzo en construir una solución funcional. Es un objetivo alcanzable, créame, vale la pena. La velocidad de desarrollo, la flexibilidad, la simplicidad en la adición de nuevos procesos — le gustará. Por supuesto, hay que prestar mucha atención a la organización del proyecto y la estabilidad del funcionamiento de Airflow: no hay milagros.
Actualmente, tenemos Airflow ejecutando diariamente alrededor de 6,500 tareas. Son bastante diferentes en su naturaleza. Hay tareas de carga de datos en el DWH principal desde muchas fuentes diferentes y muy específicas, hay tareas de cálculo de vistas dentro del DWH principal, hay tareas de publicación de datos en un DWH rápido, hay muchas, muchas tareas diferentes... y Airflow las gestiona día tras día. Hablando en cifras, esto es 2,3 mil tareas ELT de diversa complejidad dentro del DWH (Hadoop), alrededor de 250 bases de datos fuentes, este es un equipo de cuatro desarrolladores de ETL, que se dividen entre el procesamiento de datos ETL en el DWH y el procesamiento de datos ELT dentro del DWH y, por supuesto, también hay un administrador, que se encarga de la infraestructura del servicio.
Planes futuros
La cantidad de procesos está creciendo inexorablemente, y lo fundamental en lo que nos centraremos en la parte de infraestructura de Airflow será la escalabilidad. Queremos construir un clúster de Airflow, asignar un par de nodos para los workers de Celery y crear un nodo duplicado para los procesos de planificación de tareas y el repositorio.
Epílogo
Claro, esto no es todo lo que me gustaría contar sobre Airflow, pero traté de cubrir los puntos principales. El apetito viene comiendo, pruébalo y te gustará 🙂
Fuente: habr.com
