

En la antesala del inicio del curso hemos preparado para ustedes la traducción de otro material útil.
La codificación de Huffman es un algoritmo de compresión de datos que formula la idea principal de la compresión de archivos. En este artículo hablaremos sobre la codificación de longitud fija y variable, códigos que se decodifican de manera única, reglas de prefijos y la construcción de un árbol de Huffman.
Sabemos que cada símbolo se almacena como una secuencia de 0 y 1 y ocupa 8 bits. Esto se llama codificación de longitud fija, ya que cada símbolo utiliza la misma cantidad fija de bits para su almacenamiento.
Supongamos que se nos da un texto. ¿Cómo podemos reducir la cantidad de espacio requerid para almacenar un símbolo?
La idea principal es la codificación de longitud variable. Podemos utilizar el hecho de que algunos símbolos en el texto aparecen con más frecuencia que otros (), para desarrollar un algoritmo que represente la misma secuencia de símbolos con una menor cantidad de bits. En la codificación de longitud variable, asignamos a los símbolos una cantidad variable de bits dependiendo de la frecuencia de su aparición en este texto. Al final, algunos símbolos pueden ocupar solo 1 bit, otros 2 bits, 3 o más. El problema con la codificación de longitud variable radica únicamente en la posterior decodificación de la secuencia.
¿Cómo se puede decodificar de manera unívoca una secuencia de bits?
Consideremos la cadena «aabacdab». Tiene 8 símbolos, y al codificarla con longitud fija necesitaríamos 64 bits para almacenarla. Notemos que la frecuencia de los símbolos «a», «b», «c» y «d» es 4, 2, 1, 1 respectivamente. Intentemos representarla «aabacdab» con una menor cantidad de bits, utilizando el hecho de que «a» aparece con más frecuencia que «b»., y «b». aparece con más frecuencia que «c» y «d»Comenzaremos asignando «a» código de un bit, 0, «b». asignaremos un código de dos bits 11, y con tres bits codificaremos 100 y 011 «c» y «d».
Al final, obtendremos:
a
0
b
11
c
100
d
011
Así codificaremos la cadena «aabacdab» utilizando los códigos presentados anteriormente. Sin embargo, el problema principal será la decodificación. Cuando intentemos decodificar la cadena 00110100011011 (0|0|11|0|100|011|0|11), obtendremos un resultado ambiguo, ya que puede ser representada como: 001101000110110|011|0|100|011|0|11 adacdab 0|0|11|0|100|0|11|011 aabacabd 0|011|0|100|0|11|0|11 adacabab
0|011|0|100|011|0|11    adacdab
0|0|11|0|100|0|11|011   aabacabd
0|011|0|100|0|11|0|11   adacabab
…
etc.
Para evitar esta ambigüedad, debemos garantizar que nuestra codificación satisfaga el concepto de regla de prefijo, que a su vez implica que los códigos se pueden decodificar de manera única. La regla de prefijo garantiza que ningún código sea un prefijo de otro. Por código nos referimos a los bits utilizados para representar un carácter específico. En el ejemplo anterior, 0 – es un prefijo 011, lo que rompe la regla de prefijo. Así que, si nuestros códigos satisfacen la regla de prefijo, se puede realizar una decodificación única (y viceversa).
Revisemos el ejemplo anterior. Esta vez asignaremos a los caracteres «a», «b», «c» y «d» códigos que satisfacen la regla de prefijo.
a
0
b
10
c
110
d
111
Con esta codificación, la cadena «aabacdab» se codificará como 00100100011010 (0|0|10|0|100|011|0|10). Y aquí está 00100100011010 podremos decodificar de manera única y volver a nuestra cadena original. «aabacdab».
Codificación de Huffman
Ahora que hemos entendido la codificación de longitud variable y la regla de prefijo, hablemos sobre la codificación de Huffman.
El método se basa en crear árboles binarios. En él, un nodo puede ser o bien una hoja o interno. Inicialmente, todos los nodos se consideran hojas (finales), que representan el símbolo mismo y su peso (es decir, frecuencia de aparición). Los nodos internos contienen el peso del símbolo y se refieren a dos nodos hijos. Por convención, el bit «0» representa seguir por la rama izquierda, mientras que «1» representa la derecha. En un árbol completo, hay N hojas y N-1 nodos internos. Se recomienda que al construir el árbol de Huffman se desestimen los símbolos no utilizados para obtener códigos de longitud óptima.
Usaremos una cola de prioridad para construir el árbol de Huffman, donde se asignará la mayor prioridad al nodo con la frecuencia más baja. A continuación se describen los pasos para la construcción:
- Cree un nodo hoja para cada símbolo y agréguelo a la cola de prioridad.
- Mientras haya más de una hoja en la cola, haga lo siguiente:
- Elimine dos nodos con la mayor prioridad (frecuencia más baja) de la cola;
- Cree un nuevo nodo interno, donde estos dos nodos serán los hijos, y la frecuencia de aparición será la suma de las frecuencias de estos dos nodos.
- Agregue el nuevo nodo a la cola de prioridad.
- El único nodo restante será la raíz, y con esto la construcción del árbol terminará.
Imaginemos que tenemos un texto que consta únicamente de los caracteres «a», «b», «c», «d» y «e», y las frecuencias de su aparición son 15, 7, 6, 6 y 5 respectivamente. A continuación se presentan ilustraciones que reflejan los pasos del algoritmo.
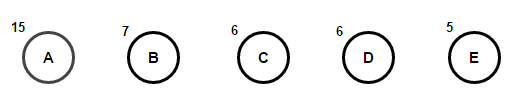
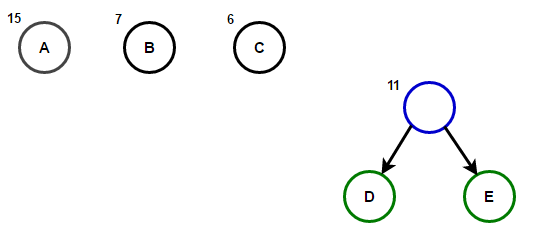
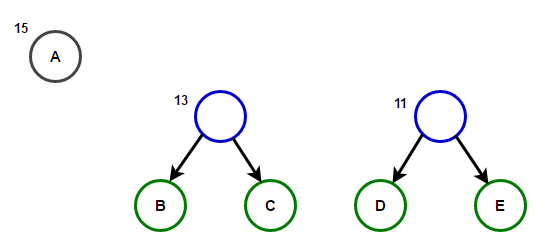
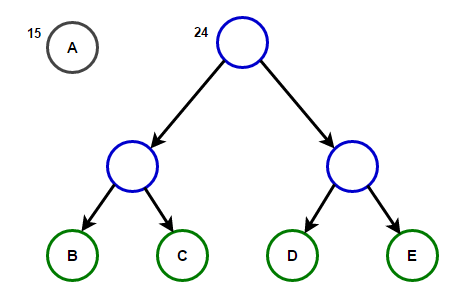
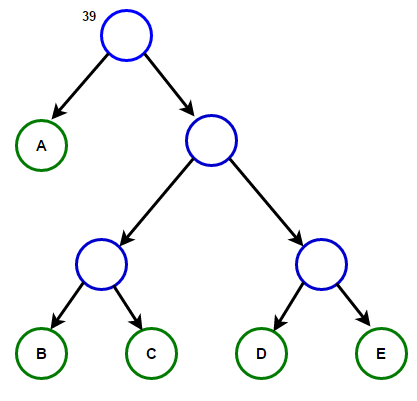
El camino desde la raíz hasta cualquier nodo hoja almacenará el código de prefijo óptimo (también conocido como código de Huffman) correspondiente al carácter asociado con ese nodo hoja.
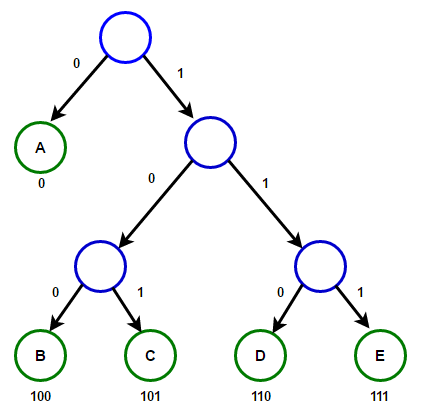
Árbol de Huffman
A continuación encontrará la implementación del algoritmo de compresión de Huffman en los lenguajes C++ y Java:
#include <iostream>
#include <string>
#include <queue>
#include <unordered_map>
using namespace std;

// A Tree node
struct Node
{
	char ch;
	int freq;
	Node *left, *right;
};

// Function to allocate a new tree node
Node* getNode(char ch, int freq, Node* left, Node* right)
{
	Node* node = new Node();

	node->ch = ch;
	node->freq = freq;
	node->left = left;
	node->right = right;

	return node;
}

// Comparison object to be used to order the heap
struct comp
{
	bool operator()(Node* l, Node* r)
	{
		// highest priority item has lowest frequency
		return l->freq > r->freq;
	}
};

// traverse the Huffman Tree and store Huffman Codes
// in a map.
void encode(Node* root, string str,
			unordered_map<char, string> &huffmanCode)
{
	if (root == nullptr)
		return;

	// found a leaf node
	if (!root->left && !root->right) {
		huffmanCode[root->ch] = str;
	}

	encode(root->left, str + "0", huffmanCode);
	encode(root->right, str + "1", huffmanCode);
}

// traverse the Huffman Tree and decode the encoded string
void decode(Node* root, int &index, string str)
{
	if (root == nullptr) {
		return;
	}

	// found a leaf node
	if (!root->left && !root->right)
	{
		cout << root->ch;
		return;
	}

	index++;

	if (str[index] =='0')
		decode(root->left, index, str);
	else
		decode(root->right, index, str);
}

// Builds Huffman Tree and decode given input text
void buildHuffmanTree(string text)
{
	// count frequency of appearance of each character
	// and store it in a map
	unordered_map<char, int> freq;
	for (char ch: text) {
		freq[ch]++;
	}

	// Create a priority queue to store live nodes of
	// Huffman tree;
	priority_queue<Node*, vector<Node*>, comp> pq;

	// Create a leaf node for each character and add it
	// to the priority queue.
	for (auto pair: freq) {
		pq.push(getNode(pair.first, pair.second, nullptr, nullptr));
	}

	// do till there is more than one node in the queue
	while (pq.size() != 1)
	{
		// Remove the two nodes of highest priority
		// (lowest frequency) from the queue
		Node *left = pq.top(); pq.pop();
		Node *right = pq.top();	pq.pop();

		// Create a new internal node with these two nodes
		// as children and with frequency equal to the sum
		// of the two nodes' frequencies. Add the new node
		// to the priority queue.
		int sum = left->freq + right->freq;
		pq.push(getNode(' ', sum, left, right));
	}

	// root stores pointer to root of Huffman Tree
	Node* root = pq.top();

	// traverse the Huffman Tree and store Huffman Codes
	// in a map. Also prints them
	unordered_map<char, string> huffmanCode;
	encode(root, "", huffmanCode);

	cout << "Huffman Codes are :n" << 'n';
	for (auto pair: huffmanCode) {
		cout << pair.first << " " << pair.second << 'n';
	}

	cout << "nOriginal string was :n" << text << 'n';

	// print encoded string
	string str = "";
	for (char ch: text) {
		str += huffmanCode[ch];
	}

	cout << "nEncoded string is :n" << str << 'n';

	// traverse the Huffman Tree again and this time
	// decode the encoded string
	int index = -1;
	cout << "nDecoded string is: n";
	while (index < (int)str.size() - 2) {
		decode(root, index, str);
	}
}

// Huffman coding algorithm
int main()
{
	string text = "Huffman coding is a data compression algorithm.";

	buildHuffmanTree(text);

	return 0;
}
import java.util.HashMap;
import java.util.Map;
import java.util.PriorityQueue;
// Un nodo de árbol
class Node
{
char ch;
int freq;
Node left = null, right = null;
Node(char ch, int freq)
{
this.ch = ch;
this.freq = freq;
}
public Node(char ch, int freq, Node left, Node right) {
this.ch = ch;
this.freq = freq;
this.left = left;
this.right = right;
}
};
class Huffman
{
// Recorre el árbol de Huffman y almacena los códigos de Huffman
// en un mapa.
public static void encode(Node root, String str,
Map huffmanCode)
{
if (root == null)
return;
// Se encontró un nodo hoja
if (root.left == null && root.right == null) {
huffmanCode.put(root.ch, str);
}
encode(root.left, str + "0", huffmanCode);
encode(root.right, str + "1", huffmanCode);
}
// Recorre el árbol de Huffman y decodifica la cadena codificada
public static int decode(Node root, int index, StringBuilder sb)
{
if (root == null)
return index;
// Se encontró un nodo hoja
if (root.left == null && root.right == null)
{
System.out.print(root.ch);
return index;
}
index++;
if (sb.charAt(index) == '0')
index = decode(root.left, index, sb);
else
index = decode(root.right, index, sb);
return index;
}
// Construye el árbol de Huffman, los códigos de Huffman y decodifica el texto de entrada dado
public static void buildHuffmanTree(String text)
{
// Cuenta la frecuencia de aparición de cada carácter
// y lo almacena en un mapa
Map freq = new HashMap();
for (int i = 0 ; i < text.length(); i++) {
if (!freq.containsKey(text.charAt(i))) {
freq.put(text.charAt(i), 0);
}
freq.put(text.charAt(i), freq.get(text.charAt(i)) + 1);
}
// Crea una cola de prioridad para almacenar nodos vivos del árbol de Huffman
// Obsérvese que el elemento de mayor prioridad tiene menor frecuencia
PriorityQueue pq = new PriorityQueue(
(l, r) -> l.freq - r.freq);
// Crea un nodo hoja para cada carácter y lo agrega
// a la cola de prioridad.
for (Map.Entry entry : freq.entrySet()) {
pq.add(new Node(entry.getKey(), entry.getValue()));
}
// Hazlo hasta que haya más de un nodo en la cola
while (pq.size() != 1)
{
// Remueve los dos nodos de mayor prioridad
// (menor frecuencia) de la cola
Node left = pq.poll();
Node right = pq.poll();
// Crea un nuevo nodo interno con estos dos nodos como hijos
// y con una frecuencia igual a la suma de las frecuencias de los dos nodos
// Agrega el nuevo nodo a la cola de prioridad.
int sum = left.freq + right.freq;
pq.add(new Node(' ', sum, left, right));
}
// root almacena el puntero a la raíz del árbol de Huffman
Node root = pq.peek();
// Recorre el árbol de Huffman y almacena los códigos de Huffman en un mapa
Map huffmanCode = new HashMap();
encode(root, "", huffmanCode);
// Imprimir los códigos de Huffman
System.out.println("Los códigos de Huffman son :\n");
for (Map.Entry entry : huffmanCode.entrySet()) {
System.out.println(entry.getKey() + " " + entry.getValue());
}
System.out.println("\nLa cadena original era :\n" + text);
// Imprimir cadena codificada
StringBuilder sb = new StringBuilder();
for (int i = 0 ; i < text.length(); i++) {
sb.append(huffmanCode.get(text.charAt(i)));
}
System.out.println("\nLa cadena codificada es :\n" + sb);
// Recorre el árbol de Huffman nuevamente y esta vez
// decodifica la cadena codificada
int index = -1;
System.out.println("\nLa cadena decodificada es: \n");
while (index < sb.length() - 2) {
index = decode(root, index, sb);
}
}
public static void main(String[] args)
{
String text = "La codificación de Huffman es un algoritmo de compresión de datos.";
buildHuffmanTree(text);
}
}Nota: La memoria utilizada por la cadena de entrada es de 47 * 8 = 376 bits, mientras que la cadena codificada ocupa solo 194 bits, es decir, los datos se comprimen aproximadamente en un 48%. En el programa en C++ anterior, utilizamos la clase string para almacenar la cadena codificada, para que el programa sea legible.
Dado que las estructuras de datos eficientes de colas de prioridad requieren un tiempo de inserción O(log(N)) y en un árbol binario completo con N hojas hay 2N-1 nodos, y el árbol de Huffman es un árbol binario completo, el algoritmo funciona en O(Nlog(N)) tiempo, donde N es el número de símbolos.
Fuentes:
Fuente: habr.com
