

En este artículo hablaremos sobre los contadores de rendimiento de la memoria RAM en vSphere.
Parece que con la memoria es todo más claro que con el procesador: si hay problemas de rendimiento en una VM, es difícil no notarlos. Pero cuando aparecen, es mucho más complicado solucionarlos. Pero vayamos por partes.
Un poco de teoría
La memoria RAM de las máquinas virtuales proviene de la memoria del servidor en el que operan las VMs. Esto es bastante obvio :). Si el servidor no tiene suficiente memoria RAM para todos los que la necesitan, ESXi comienza a aplicar técnicas de optimización del uso de la memoria (técnicas de recuperación de memoria). De lo contrario, los sistemas operativos de las VMs fallarían debido a errores de acceso a la RAM.
Qué técnicas aplica ESXi depende de la carga de la memoria RAM:
Estado de la memoria
Límite
Acciones
Alto
400% de minFree
Después de alcanzar el límite superior, las grandes páginas de memoria se dividen en pequeñas (TPS funciona en modo estándar).
Limpiar
100% de minFree
Las grandes páginas de memoria se dividen en pequeñas, TPS funciona forzosamente.
Soft
64% de minFree
TPS + Balloon
Duro
32% de minFree
TPS + Comprimir + Intercambiar
Bajo
16% de minFree
Comprimir + Intercambiar + Bloquear
minFree es la memoria RAM necesaria para el funcionamiento del hipervisor.
Hasta ESXi 4.1 inclusive, minFree por defecto era fijo: 6% de la capacidad de memoria RAM del servidor (el porcentaje se podía cambiar a través de la opción Mem.MinFreePct en ESXi). En versiones posteriores, debido al aumento en las capacidades de memoria en los servidores, minFree empezó a calcularse en función de la capacidad de memoria del host, en lugar de como un valor porcentual fijo.
El valor de minFree (por defecto) se calcula de la siguiente manera:
Porcentaje de memoria reservado para minFree
Rango de memoria
6%
0-4 GB
4%
4-12 GB
2%
12-28 GB
1%
Memoria restante
Por ejemplo, para un servidor con 128 GB de RAM, el valor de MinFree será el siguiente:
MinFree = 245,76 + 327,68 + 327,68 + 1024 = 1925,12 MB = 1,88 GB
El valor real puede diferir en un par de cientos de MB, esto depende del servidor y la memoria RAM.
Porcentaje de memoria reservado para minFree
Rango de memoria
Valor para 128 GB
6%
0-4 GB
245,76 MB
4%
4-12 GB
327,68 MB
2%
12-28 GB
327,68 MB
1%
Memoria restante (100 GB)
1024 MB
Generalmente, para entornos de producción solo se considera normal el estado Alto. Para entornos de pruebas y desarrollo, los estados Limpiar/Suave pueden ser aceptables. Si la memoria RAM en el host queda por debajo del 64% de MinFree, las VMs que operan en él seguramente experimentarán problemas de rendimiento.
En cada estado se aplican ciertas técnicas de reclamación de memoria, comenzando con TPS, que prácticamente no afecta el rendimiento de la VM, y terminando con swapping. Hablaré de ellas con más detalle.
Transparent Page Sharing (TPS). TPS es, en términos simples, deduplicación de páginas de memoria RAM de máquinas virtuales en el servidor.
ESXi busca páginas de memoria RAM idénticas de máquinas virtuales, calculando y comparando el hash de las páginas, y elimina las duplicadas, reemplazándolas por enlaces a la misma página en la memoria física del servidor. Como resultado, el consumo de memoria física se reduce y se puede lograr cierta sobreasignación de memoria prácticamente sin disminuir el rendimiento.
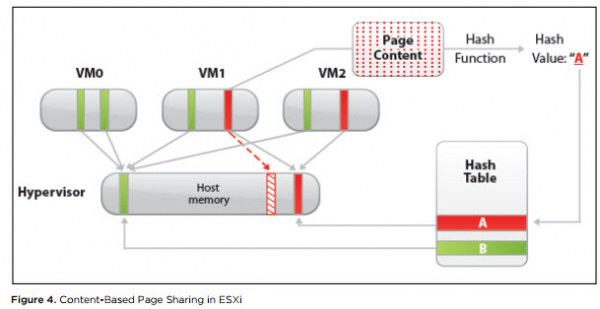
Este mecanismo solo funciona para páginas de memoria de 4 KB (páginas pequeñas). El hipervisor ni siquiera intenta deduplicar páginas de 2 MB (páginas grandes): la probabilidad de encontrar páginas idénticas de ese tamaño no es alta.
Por defecto, ESXi asigna memoria a las páginas grandes. La fragmentación de páginas grandes en pequeñas comienza al alcanzar un umbral de estado Alto y ocurre de forma forzosa cuando se alcanza el estado Claro (ver tabla de estados del hipervisor).
Si desea que TPS comience a funcionar sin esperar a llenar la memoria RAM del host, debe establecer el valor en las Opciones Avanzadas de ESXi “Mem.AllocGuestLargePage” en 0 (por defecto 1). Entonces, la asignación de grandes páginas de memoria para máquinas virtuales se desactivará.
Desde diciembre de 2014, en todos los lanzamientos de ESXi, TPS entre VMs está desactivado por defecto, ya que se encontró una vulnerabilidad que teóricamente permite acceder a la memoria RAM de otra VM desde una. Más detalles aquí. No he encontrado información sobre la implementación práctica de la explotación de la vulnerabilidad TPS.
La política TPS se controla a través de la opción avanzada “Mem.ShareForceSalting” en ESXi:
0 — TPS inter-VM. TPS funciona para páginas de diferentes VMs;
1 – TPS para VMs con el mismo valor de “sched.mem.pshare.salt” en VMX;
2 (por defecto) – TPS intra-VM. TPS funciona para páginas dentro de la VM.
Sin duda, tiene sentido desactivar las páginas grandes e incluir TPS inter-VM en bancos de pruebas. También se puede utilizar para entornos con un gran número de VMs similares. Por ejemplo, en entornos con VDI, el ahorro de memoria física puede alcanzar décimas de porcentaje.
Memory Ballooning. El Ballooning ya no es tan inofensivo y transparente para el sistema operativo de las máquinas virtuales como lo es TPS. Pero con un uso adecuado, se puede convivir e incluso trabajar con Ballooning.
Junto con Vmware Tools, se instala un controlador especial en la máquina virtual, llamado Balloon Driver (también conocido como vmmemctl). Cuando al hipervisor le falta memoria física y entra en estado Soft, ESXi solicita a la máquina virtual que devuelva la memoria RAM no utilizada a través de este Balloon Driver. A su vez, el controlador opera a nivel del sistema operativo y solicita memoria libre de este. El hipervisor ve qué páginas de memoria física ha ocupado el Balloon Driver, toma memoria de la máquina virtual y la devuelve al host. No hay problemas en el funcionamiento del sistema operativo, ya que a nivel del sistema operativo la memoria está ocupada por el Balloon Driver. Por defecto, el Balloon Driver puede reclamar hasta el 65% de la memoria de la máquina virtual.
Si no están instalados VMware Tools en la máquina virtual o si se desactiva el Ballooning (no lo recomiendo, pero existe :), el hipervisor inmediatamente recurre a técnicas más drásticas para la reclamación de memoria. Conclusión: asegúrate de que VMware Tools estén instalados en la máquina virtual.
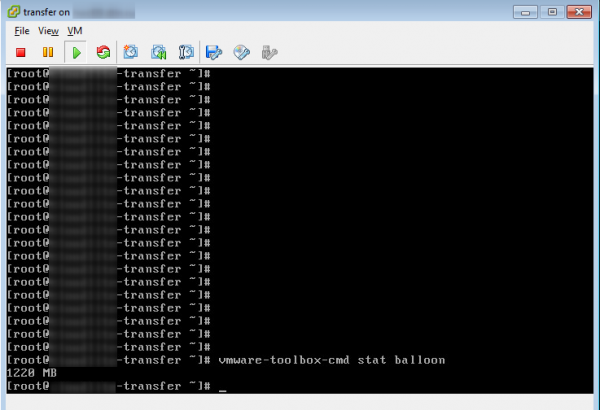
Se puede verificar el funcionamiento del Balloon Driver desde el sistema operativo a través de VMware Tools..
Compresión de Memoria. Esta técnica se aplica cuando ESXi alcanza el estado Hard. Como indica el nombre, ESXi intenta comprimir páginas de 4 Kbytes de memoria RAM a 2 Kbytes y así liberar un poco de espacio en la memoria física del servidor. Esta técnica aumenta significativamente el tiempo de acceso al contenido de las páginas de memoria de la máquina virtual, ya que la página debe descomprimirse previamente. A veces, no todas las páginas se pueden comprimir, y el propio proceso lleva cierto tiempo. Por lo tanto, en la práctica, esta técnica no es muy efectiva.
Intercambio de Memoria. Después de una breve fase de Compresión de Memoria, ESXi prácticamente inevitablemente (si las máquinas virtuales no se han trasladado a otros hosts o no se han apagado) pasa al intercambio. Y si queda muy poca memoria (estado Bajo), el hipervisor también deja de asignar páginas de memoria a la máquina virtual, lo que puede causar problemas en los sistemas operativos invitados de la máquina virtual.
Así es como funciona el Swapping. Al encender la máquina virtual, se crea un archivo con la extensión .vswp. Su tamaño es igual a la memoria RAM no reservada de la VM: esta es la diferencia entre la memoria configurada y la reservada. Durante el proceso de Swapping, ESXi descarga las páginas de memoria de la máquina virtual a este archivo y comienza a trabajar con él en lugar de con la memoria física del servidor. Por supuesto, esta "memoria RAM" es varios órdenes de magnitud más lenta que la real, incluso si .vswp está en un almacenamiento rápido.
A diferencia del Ballooning, cuando se quitan páginas no utilizadas de la VM, en el Swapping pueden trasladarse al disco páginas que están siendo utilizadas activamente por el sistema operativo o aplicaciones dentro de la VM. Como resultado, el rendimiento de la VM disminuye incluso hasta colapsar. La VM sigue funcionando formalmente y al menos se puede apagar correctamente desde el sistema operativo. Si tienes paciencia 😉
Si la VM ha sido desplazada a Swap, esta es una situación anómala que es mejor evitar si es posible.
Principales contadores de rendimiento de la memoria de la máquina virtual
Aquí llegamos a lo importante. Para monitorear el estado de la memoria en la VM, existen los siguientes contadores:
Activo — muestra la cantidad de memoria RAM (KB) a la que la VM tuvo acceso en el período de medición anterior.
Uso — lo mismo que Activo, pero en porcentaje de la memoria RAM configurada de la VM. Se calcula con la siguiente fórmula: activo ÷ tamaño de memoria configurada de la máquina virtual.
Un alto Uso y Activo, respectivamente, no siempre son indicadores de problemas de rendimiento en la VM. Si la VM está utilizando la memoria de manera agresiva (como mínimo, accediendo a ella), no significa que falte memoria. Más bien, es motivo para investigar qué está ocurriendo en el sistema operativo.
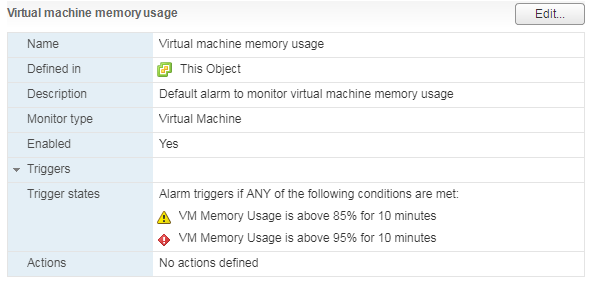
Hay una alarma estándar por Uso de Memoria para la VM:
Compartido — cantidad de memoria RAM de la VM, deduplicada mediante TPS (dentro de la VM o entre VMs).
Concedido — cantidad de memoria física del host (KB) que se ha asignado a la VM. Incluye Compartida.
Consumido (Concedido — Compartido) — cantidad de memoria física (KB) que la VM consume del host. No incluye Compartida.
Si parte de la memoria de la VM se asigna no desde la memoria física del host, sino desde un archivo de intercambio o se retira de la VM mediante el Driver de Balloon, esta cantidad no se tiene en cuenta en Concedido y Consumido.
Los altos valores de Granted y Consumed son totalmente normales. El sistema operativo gradualmente retira memoria del hipervisor y no la devuelve. Con el tiempo, en una VM activamente operativa, los valores de estos contadores se acercan al volumen de memoria configurada y permanecen allí.
Cero — el volumen de memoria RAM de la VM (Kbytes) que contiene ceros. Esta memoria es considerada libre por el hipervisor y puede ser asignada a otras máquinas virtuales. Después de que el sistema operativo invitado haya escrito algo en la memoria nulificada, esta se convierte en Consumed y ya no se devuelve.
Reserved Overhead — el volumen de memoria RAM de la VM (Kbytes) reservado por el hipervisor para la operación de la VM. Es un volumen pequeño, pero debe estar disponible en el host; de lo contrario, la VM no se iniciará.
Balloon — el volumen de memoria RAM (Kbytes) extraído de la VM mediante el Balloon Driver.
Compressed — el volumen de memoria RAM (Kbytes) que se ha logrado comprimir.
Swapped — el volumen de memoria RAM (Kbytes) que, por falta de memoria física en el servidor, ha sido trasladado al disco.
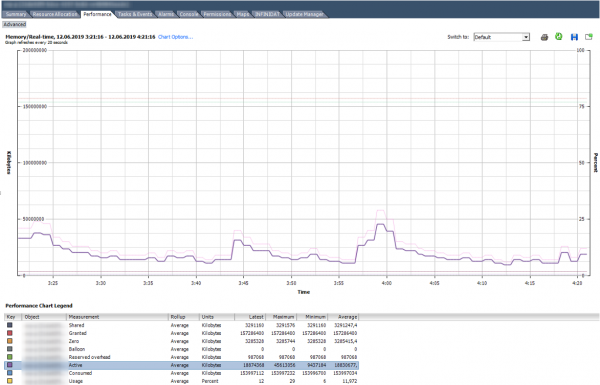
Balloon y otros contadores de técnicas de recuperación de memoria son iguales a cero.
Así es como se ve el gráfico con los contadores de una VM funcionando correctamente con 150 GB de RAM.
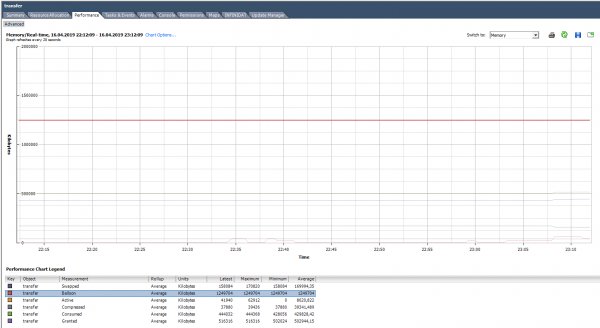
En el gráfico a continuación, la VM presenta claros problemas. Debajo del gráfico se puede ver que para esta VM se han utilizado todas las técnicas descritas para la gestión de la memoria. Balloon es significativamente mayor que Consumed para esta VM. De hecho, la VM está más muerta que viva.
ESXTOP
Al igual que con la CPU, si queremos evaluar rápidamente la situación en el host, así como su dinámica en intervalos de hasta 2 segundos, se recomienda utilizar ESXTOP.
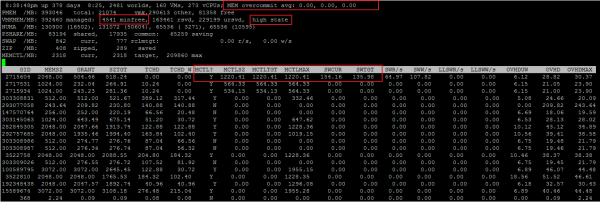
La pantalla de ESXTOP para la memoria se activa con la tecla "m" y se ve de la siguiente manera (se seleccionaron los campos B,D,H,J,K,L,O):
Los siguientes parámetros serán interesantes para nosotros:
Mem overcommit avg — el valor promedio de sobreasignación de memoria en el host durante 1, 5 y 15 minutos. Si está por encima de cero, es un motivo para examinar qué está sucediendo, aunque no siempre indica la presencia de problemas.
En las líneas PMEM/MB y VMKMEM/MB — información sobre la memoria física del servidor y la memoria disponible para VMkernel. Aquí se puede ver el valor minfree (en MB), el estado de la memoria del host (en nuestro caso, alto).
En la línea NUMA/MB se puede ver la distribución de la memoria RAM entre los nodos NUMA (zócalos). En este ejemplo, la distribución es desigual, lo cual no es muy bueno en general.
A continuación se presenta la estadística general del servidor sobre las técnicas de recuperación de memoria:
PSHARE/MB — es la estadística de TPS;
SWAP/MB — estadística del uso de Swap;
ZIP/MB — estadística de compresión de páginas de memoria;
MEMCTL/MB — estadística del uso del Balloon Driver.
Para cada VM, puede interesarnos la siguiente información. He ocultado los nombres de las VMs para no confundir a la audiencia:). Si la métrica ESXTOP es análoga al contador en vSphere, indico el contador correspondiente.
MEMSZ — el volumen de memoria configurado en la VM (MB).
MEMSZ = GRANT + MCTLSZ + SWCUR + untouched.
GRANT — Granted en megabytes.
TCHD — Activo en megabytes.
MCTL? — si está instalado el Balloon Driver en la VM.
MCTLSZ — Balloon en megabytes.
MCTLGT — cantidad de RAM (megabytes) que ESXi desea recuperar de la VM a través del Balloon Driver (Memctl Target).
MCTLMAX — cantidad máxima de RAM (megabytes) que ESXi puede recuperar de la VM a través del Balloon Driver.
SWCUR — cantidad actual de RAM (megabytes) asignada a la VM desde el archivo de Swap.
SWGT — cantidad de RAM (megabytes) que ESXi desea asignar a la VM desde el archivo de Swap (Swap Target).
También a través de ESXTOP se puede ver información más detallada sobre la topología NUMA de la VM. Para esto, se deben seleccionar los campos D,G:
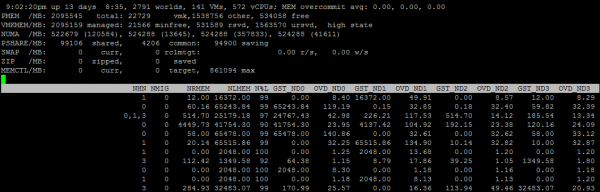
NHN – nodos NUMA donde se encuentra la VM. Aquí se pueden notar inmediatamente VMs amplias que no caben en un solo nodo NUMA.
NRMEM – cuántos megabytes de memoria toma la VM de un nodo NUMA remoto.
NLMEM – cuántos megabytes de memoria toma la VM de un nodo NUMA local.
N%L – porcentaje de memoria de la VM en el nodo NUMA local (si es menos del 80% — pueden surgir problemas de rendimiento).
Memoria en el hipervisor
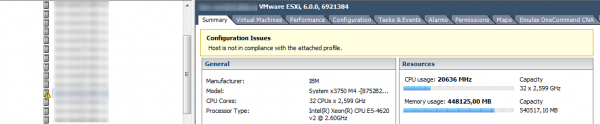
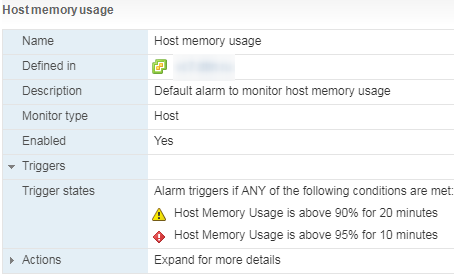
Si los contadores de CPU en el hipervisor generalmente no representan un gran interés, la situación con la memoria es diferente. Un alto uso de memoria en la VM no siempre indica un problema de rendimiento, pero un alto uso de memoria en el hipervisor sí activa técnicas de gestión de memoria y provoca problemas de rendimiento en la VM. Debemos estar atentos a las alarmas de uso de memoria del host y evitar que las VMs caigan en Swap.
Unswap
Si la VM ha caído en Swap, su rendimiento disminuye drásticamente. Las huellas del Ballooning y la compresión desaparecen rápidamente después de que hay memoria RAM libre en el host, pero la máquina virtual no se apresura a volver de Swap a la RAM del servidor.
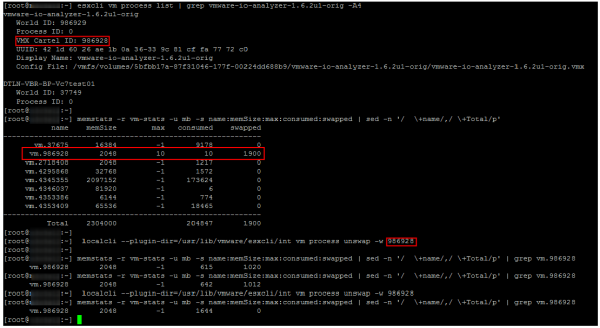
Hasta la versión ESXi 6.0, la única forma confiable y rápida de sacar una VM del Swap era reiniciar (más precisamente, apagar/encender el contenedor). A partir de ESXi 6.0, surgió un método que, aunque no es del todo oficial, es funcional y confiable para sacar una VM del Swap. En una de las conferencias, tuve la oportunidad de hablar con uno de los ingenieros de VMware a cargo del programador de CPU. Confirmó que este método es completamente seguro y operativo. En nuestra experiencia, no hemos tenido problemas con él.
Comandos para sacar VMs del Swap Duncan Epping. No repetiré la descripción completa, solo ofreceré un ejemplo de su uso. Como se puede ver en la captura de pantalla, después de un tiempo tras ejecutar el comando, el Swap en la VM desaparece.
Consejos para la gestión de memoria en ESXi
Por último, aquí hay algunos consejos que te ayudarán a evitar problemas de rendimiento en las VMs debido a la memoria:
- No permitas la sobreasignación de memoria en los clústeres productivos. Es recomendable mantener siempre un ~20-30% de memoria libre en el clúster para que el DRS (y el administrador) tengan espacio para maniobrar, y para que al migrar las VMs no vayan al Swap. Además, no olvides dejar un margen para la tolerancia a fallos. No es agradable cuando, tras la falla de un servidor y el reinicio de las VMs mediante HA, algunas máquinas también terminan en Swap.
- En infraestructuras con alta consolidación, trata de NO crear VMs con más de la mitad de la memoria del host. Esto nuevamente ayudará a que el DRS distribuya las máquinas virtuales sin problemas entre los servidores del clúster. Esta regla, por supuesto, no es universal :).
- Vigila la alarma de uso de memoria del host.
- No olvides instalar VMware Tools en las VMs y no desactives el Ballooning.
- Considera habilitar Inter-VM TPS y desactivar Large Pages en entornos con VDI y entornos de prueba.
- Si una VM está experimentando problemas de rendimiento, verifica si está utilizando memoria de un nodo NUMA remoto.
- Saca las VMs del Swap lo más rápido posible. Además, si una VM está en Swap, por razones obvias, el almacenamiento compartido sufre.
Con esto concluye mi discusión sobre la memoria. A continuación, artículos sobre el tema para aquellos que deseen profundizar en los detalles. El próximo artículo estará dedicado al almacenamiento.
Enlaces útiles
Fuente: habr.com
