

Hoy analizaremos las métricas del subsistema de discos en vSphere. Los problemas con el almacenamiento son la causa más común de un rendimiento lento de la máquina virtual. Mientras que en los casos de CPU y RAM la solución de problemas finaliza a nivel de hipervisor, en los problemas con discos, puede que tengamos que investigar la red de datos y el almacenamiento conectado (SAN).
El tema lo abordaré con el ejemplo del acceso por bloques a la SAN, aunque en el acceso por archivos los contadores son aproximadamente los mismos.
Un poco de teoría
Cuando se habla del rendimiento del subsistema de discos de las máquinas virtuales, normalmente se presta atención a tres parámetros interrelacionados:
- número de operaciones de entrada/salida (Input/Output Operations Per Second, IOPS);
- ancho de banda (Throughput);
- latencia de las operaciones de entrada/salida (Latency).
Número de IOPS es generalmente importante para cargas de trabajo aleatorias: acceso a bloques en el disco ubicados en diferentes lugares. Un ejemplo de dicha carga puede ser el de bases de datos, aplicaciones empresariales (ERP, CRM), etc.
Ancho de banda es importante para cargas de trabajo secuenciales: acceso a bloques localizados uno tras otro. Por ejemplo, este tipo de carga puede generarse en servidores de archivos (aunque no siempre) y sistemas de videovigilancia.
El ancho de banda está relacionado con el número de operaciones de entrada/salida de la siguiente manera:
Throughput = IOPS * Tamaño de bloque, donde Tamaño de bloque es el tamaño del bloque.
El tamaño de bloque es una característica bastante importante. Las versiones modernas de ESXi permiten bloques de hasta 32,767 KB. Si el bloque es aún mayor, se divide en varios. No todos los SAN pueden trabajar de manera eficiente con bloques tan grandes, por lo que en la Configuración Avanzada de ESXi existe un parámetro llamado DiskMaxIOSize. Con él, se puede reducir el tamaño máximo del bloque permitido por el hipervisor (más detalles ). Recomiendo consultar al fabricante del SAN antes de cambiar este parámetro, o al menos probar los cambios en un entorno de laboratorio.
Un tamaño de bloque grande puede afectar negativamente el rendimiento del SAN. Incluso si el número de IOPS y el throughputs son relativamente bajos, con un tamaño de bloque grande pueden observarse altas latencias. Por lo tanto, presten atención a este parámetro.
Latencia es el parámetro de rendimiento más interesante. La latencia de las operaciones de entrada/salida para la máquina virtual se compone de:
- retrasos dentro del hipervisor (KAVG, Milisegundos de Núcleo Promedio/Leer);
- retrasos causados por la red de transmisión de datos y el almacenamiento en red (DAVG, Milisegundos de Controlador Promedio/Comando).
La latencia total visible en el sistema operativo invitado (GAVG, Milisegundos Invitado Promedio/Comando) es la suma de KAVG y DAVG.
GAVG y DAVG se miden, mientras que KAVG se calcula: GAVG–DAVG.
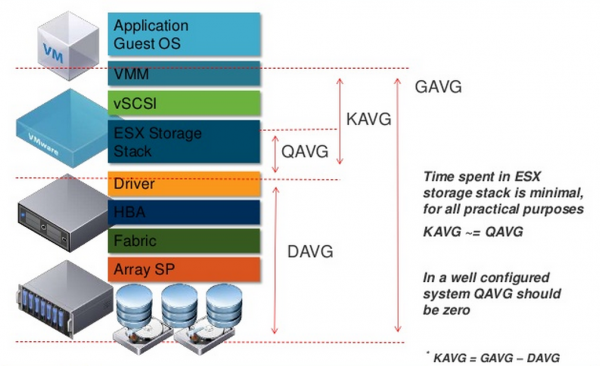
Detengámonos un momento en KAVG. En condiciones normales, KAVG debería tender a cero o, al menos, ser mucho menor que DAVG. La única situación que conozco en la que KAVG es inesperadamente alto es cuando hay un límite de IOPS en el disco de la VM. En ese caso, el KAVG aumentará al intentar exceder el límite.
La componente más significativa de KAVG es QAVG, que es el tiempo de espera para ser procesado dentro del hipervisor. Las otras componentes de KAVG son despreciables.
La cola en el controlador de adaptador de disco y las colas hacia los LUNs tienen un tamaño fijo. Para entornos de alta carga, es útil aumentar este tamaño. se describe cómo aumentar las colas en el controlador del adaptador (lo que también aumentará la cola hacia los LUNs). Esta configuración funciona cuando solo una VM interactúa con un LUN, lo cual es raro. Si hay varias VMs en el LUN, también es necesario aumentar el parámetro Disk.SchedNumReqOutstanding (instrucción ). Al aumentar la cola, reduces QAVG y KAVG respectivamente.
Sin embargo, primero consulta la documentación del proveedor HBA y prueba los cambios en un entorno de laboratorio.
El tamaño de la cola hacia el LUN puede verse afectado por la activación del mecanismo SIOC (Control de I/O de Almacenamiento). Este proporciona acceso equitativo al LUN por parte de todos los servidores del clúster mediante el ajuste dinámico de la cola hacia el LUN en los servidores. Es decir, si en alguno de los hosts una VM requiere desproporcionadamente más rendimiento (VM vecina problemática), SIOC reduce la longitud de la cola hacia el LUN en ese host (DQLEN). Más detalles .
Ya hemos abordado KAVG, ahora un poco sobre DAVG. Aquí es simple: DAVG es la latencia que introduce el entorno externo (la red de transmisión de datos y el almacenamiento en red). En cualquier almacenamiento en red moderno, y no tan moderno, hay contadores de rendimiento. Para analizar problemas con DAVG, tiene sentido observarlos. Si todo está bien desde el lado de ESXi y el almacenamiento en red, revisa la red de transmisión de datos.
Para evitar problemas de rendimiento, elija la política de selección de rutas (PSP) correcta para su SAN. Casi todos los SAN modernos son compatibles con PSP Round-Robin (con ALUA, Asymmetric Logical Unit Access, o sin ella). Esta política permite utilizar todas las rutas disponibles al SAN. En el caso de ALUA, solo se utilizan las rutas al controlador que posee la LUN. No todas las SAN en ESXi tienen reglas predeterminadas que establezcan la política Round-Robin. Si no hay reglas para su SAN, use el complemento del fabricante de la SAN que cree la regla correspondiente en todos los hosts del clúster, o cree la regla usted mismo. Más detalles. .
Además, algunos fabricantes de SAN recomiendan cambiar el número de IOPS en la ruta del valor estándar de 1000 a 1. En nuestra práctica, esto ha permitido "extraer" más rendimiento del SAN y reducir significativamente el tiempo necesario para un failover en caso de falla o actualización de los controladores. Consulte las recomendaciones del proveedor, y si no hay contraindicaciones, intente modificar este parámetro. Más detalles. .
Principales contadores de rendimiento del subsistema de discos de la máquina virtual
Los contadores de rendimiento del subsistema de discos en vCenter se recopilan en las secciones Datastore, Disk, Virtual Disk:
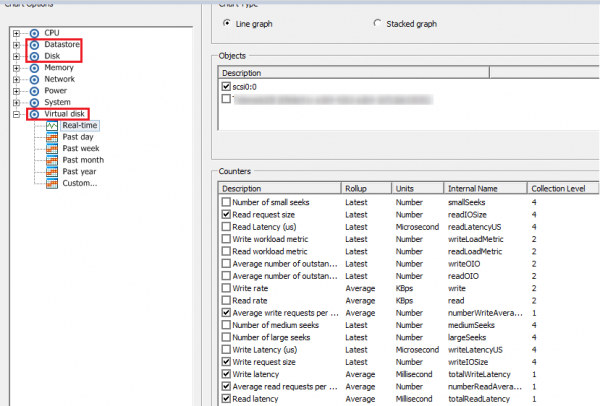
En la sección Datastore se encuentran las métricas de los almacenes de discos vSphere (datastores), donde están los discos de las VM. Aquí encontrará contadores estándar sobre:
- IOPS (promedio de solicitudes de lectura/escritura por segundo),
- ancho de banda (tasa de lectura/escritura),
- latencias (latencia más alta de lectura/escritura).
A partir de los nombres de los contadores, todo es bastante claro. Una vez más, quiero enfatizar que aquí la estadística no es para una VM específica (o disco de VM), sino general para todo el datastore. A mi parecer, es más conveniente ver esta estadística en ESXTOP, al menos por el hecho de que el período mínimo de medición allí es de 2 segundos.
En la sección Disco se encuentran las métricas de los dispositivos de bloque utilizados por la VM. Aquí hay contadores de IOPS del tipo sumación (número de operaciones de entrada/salida durante el período de medición) y varios contadores relacionados con el acceso a bloque (Comandos abortados, Reinicios del bus). Esta información, en mi opinión, también es más conveniente verla en ESXTOP.
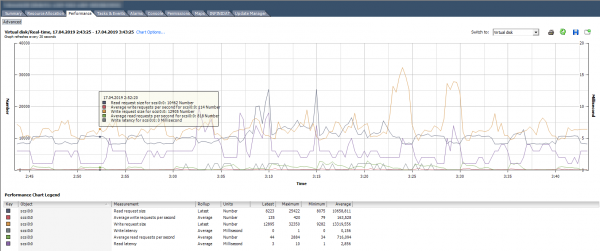
Sección Disco Virtual es el más útil para identificar problemas de rendimiento en el subsistema de discos de la máquina virtual. Aquí se puede ver el rendimiento de cada disco virtual. Esta información es necesaria para entender si hay un problema en una máquina virtual específica. Además de los contadores estándar de operaciones de entrada/salida, volumen de lectura/escritura y latencias, en esta sección hay contadores útiles que muestran el tamaño del bloque: tamaño de solicitud de lectura/escritura.
En la imagen a continuación se muestra un gráfico del rendimiento del disco de la máquina virtual, donde se puede ver el número de IOPS, latencias y tamaño del bloque.
También se pueden consultar las métricas de rendimiento de todo el datastore, si SIOC está habilitado. Aquí se presenta información básica sobre la latencia media y los IOPS. Por defecto, esta información solo se puede ver en tiempo real.
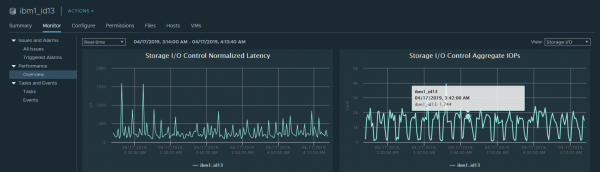
ESXTOP
En ESXTOP hay varias pantallas que presentan información sobre el subsistema de discos del host en general, así como para máquinas virtuales individuales y sus discos.
Comencemos con la información sobre las máquinas virtuales. La pantalla “Disk VM” se accede con la tecla “v”:
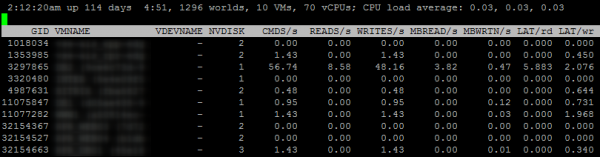
NVDISK es el número de discos de la máquina virtual. Para ver información sobre cada disco, presione “e” e introduzca el GID de la VM de interés.
El valor de los otros parámetros en esta pantalla es comprensible por sus nombres.
Otra pantalla útil para la identificación de problemas es la del adaptador de disco. Se accede con la tecla “d” (en la imagen a continuación se han seleccionado los campos A, B, C, D, E, G):
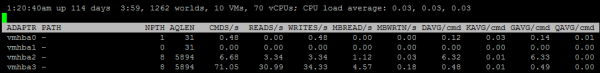
NPTH es el número de rutas a los LUNs que son visibles desde este adaptador. Para obtener información sobre cada ruta en el adaptador, presione “e” e introduzca el nombre del adaptador:
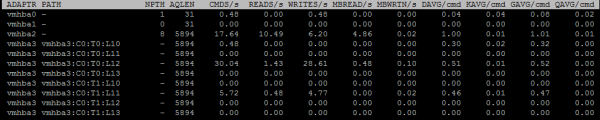
AQLEN es el tamaño máximo de la cola en el adaptador.
En esta pantalla también se presentan los contadores de latencia que mencioné anteriormente: KAVG/cmd, GAVG/cmd, DAVG/cmd, QAVG/cmd.
En la pantalla del dispositivo de disco, que se accede con la tecla “u”, se presenta información sobre dispositivos de bloques individuales – LUNs (en la imagen a continuación se han seleccionado los campos A, B, F, G, I). Aquí se puede ver el estado de la cola hacia los LUNs.

DQLEN es el tamaño de la cola para el dispositivo de bloques.
ACTV es el número de comandos de entrada/salida en el núcleo de ESXi.
QUED es el número de comandos de entrada/salida en la cola.
%USD es ACTV / DQLEN × 100%.
LOAD es (ACTV + QUED) / DQLEN.
Si %USD es alto, se debe considerar la posibilidad de aumentar la cola. Cuantos más comandos haya en la cola, mayor será QAVG y, en consecuencia, KAVG.
También en la pantalla del dispositivo de disco se puede verificar si VAAI (vStorage API for Array Integration) está funcionando en el almacenamiento SAN. Para ello, es necesario seleccionar los campos A y O.
El mecanismo VAAI permite trasladar parte del trabajo del hipervisor directamente al almacenamiento SAN, como el zerado, la copia de bloques o los bloqueos.

Como se puede ver en la imagen anterior, en este almacenamiento SAN VAAI está activo: se utilizan activamente los primitivas Zero y ATS.
Consejos para optimizar el funcionamiento del subsistema de disco en ESXi
- Presta atención al tamaño del bloque.
- Establece el tamaño óptimo de la cola en el HBA.
- No olvides habilitar SIOC en los datastores.
- Elige PSP de acuerdo con las recomendaciones del fabricante del almacenamiento SAN.
- Asegúrate de que VAAI está funcionando.
Artículos útiles sobre el tema:
Fuente: habr.com
