

La base de datos de series temporales (TSDB, time series database) en Prometheus 2 es un excelente ejemplo de una solución de ingeniería que ofrece mejoras significativas en comparación con el almacenamiento v2 en Prometheus 1, en términos de velocidad de acumulación de datos y ejecución de consultas, así como en eficiencia en el uso de recursos. Implementamos Prometheus 2 en Percona Monitoring and Management (PMM), y tuve la oportunidad de analizar el rendimiento de la TSDB de Prometheus 2. En este artículo, compartiré los resultados de estas observaciones.
Carga de trabajo promedio de Prometheus
Para aquellos que están acostumbrados a trabajar con bases de datos de propósito general, la carga de trabajo típica de Prometheus es bastante curiosa. La velocidad de acumulación de datos tiende a estabilizarse: normalmente, los servicios que monitorea envían una cantidad similar de métricas, y la infraestructura cambia con relativa lentitud.
Las solicitudes de información pueden provenir de diversas fuentes. Algunas de ellas, como las alertas, también tienden a ser estables y predecibles. Otras, como las solicitudes de usuarios, pueden provocar picos, aunque esto no es característico de la mayor parte de la carga.
Prueba de carga
Durante las pruebas, me concentré en la capacidad de acumulación de datos. Desplegué Prometheus 2.3.2, compilado con Go 1.10.1 (como parte de PMM 1.14) en el servicio Linode, utilizando este script: . Para generar carga de manera lo más realista posible, mediante este lancé varias instancias de MySQL con carga real (Prueba Sysbench TPC-C), cada una de las cuales emulaba 10 nodos Linux/MySQL.
Todas las pruebas siguientes se realizaron en un servidor Linode con ocho núcleos virtuales y 32 GB de memoria, donde se ejecutaron 20 simulaciones de carga monitoreando doscientas instancias de MySQL. O, en términos de Prometheus, 800 objetivos (targets), 440 recolecciones (scrapes) por segundo, 380,000 registros (samples) por segundo y 1.7 millones de series temporales activas.
Diseño
El enfoque habitual de las bases de datos tradicionales, incluido el utilizado en Prometheus 1.x, se basa en . Si no hay suficiente para soportar la carga, te enfrentarás a grandes retrasos, y algunas solicitudes no se completarán. El uso de memoria en Prometheus 2 se configura a través de la clave storage.tsdb.min-block-duration, que determina cuánto tiempo se almacenarán los registros en la memoria antes de ser volcado en disco (por defecto, son 2 horas). La cantidad necesaria de memoria dependerá de la cantidad de series temporales, etiquetas (labels) y la intensidad de la recolección de datos (scrapes) sumada al flujo de entrada puro. En cuanto al espacio en disco, Prometheus busca utilizar 3 bytes por registro (sample). Por otro lado, los requisitos de memoria son mucho más altos.
Aunque existe la opción de configurar el tamaño del bloque, no se recomienda ajustarlo manualmente, por lo que se enfrenta a la necesidad de dar a Prometheus toda la memoria que solicite para su carga.
Si no hay suficiente memoria para soportar el flujo de métricas entrantes, Prometheus se bloqueará con un out of memory o llegará al OOM killer.
Añadir swap para retrasar el momento del bloqueo cuando Prometheus se queda sin memoria no ayuda mucho, ya que el uso de esta función provoca un consumo explosivo de memoria. Creo que tiene que ver con Go, su recolector de basura y cómo maneja el swap.
Otro enfoque interesante es configurar el volcado del head block en disco a una hora específica, en lugar de contar desde el inicio del proceso.
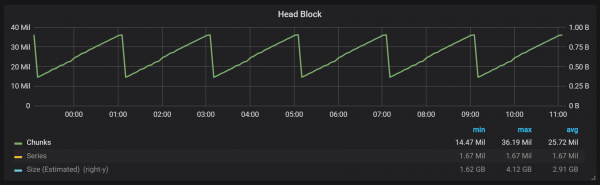
Como puedes ver en el gráfico, los volcados a disco ocurren cada dos horas. Si cambias el parámetro min-block-duration a una hora, esos volcados ocurrirán cada hora, comenzando dentro de media hora.
Si deseas utilizar este y otros gráficos en tu instalación de Prometheus, puedes usar este . Fue diseñado para PMM, pero con algunos cambios menores, se adapta a cualquier instalación de Prometheus.
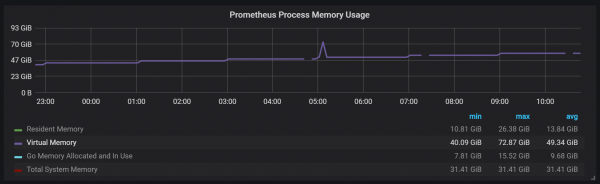
Tenemos un bloque activo, llamado head block, que se mantiene en memoria; los bloques con datos más antiguos están disponibles a través de mmap(). Esto elimina la necesidad de configurar la caché por separado, pero también significa que necesitas dejar suficiente espacio para la caché del sistema operativo si deseas realizar consultas sobre datos más antiguos que los que puede almacenar el head block.
Además, esto significa que el consumo de memoria virtual de Prometheus se verá bastante alto, lo cual no es motivo de preocupación.
Otro aspecto interesante del diseño es el uso de WAL (write ahead log). Como se puede ver en la documentación del almacenamiento, Prometheus utiliza WAL para evitar pérdidas en caso de caídas. Desafortunadamente, los mecanismos específicos de garantía de durabilidad de los datos no están suficientemente documentados. La versión 2.3.2 de Prometheus descarga WAL en disco cada 10 segundos, y este parámetro no se puede configurar por el usuario.
Compacciones
La TSDB de Prometheus está diseñada a imagen de un almacenamiento LSM (Log Structured Merge - árbol estructurado por registros con mezcla): el bloque head se descarga periódicamente en disco, mientras que el mecanismo de compactación combina varios bloques para evitar escanear una cantidad excesiva de bloques en las consultas. Aquí se puede ver la cantidad de bloques que he observado en el sistema de prueba después de un día de carga.
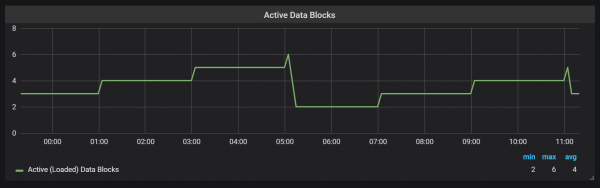
Si desea saber más sobre el almacenamiento, puede consultar el archivo meta.json, que contiene información sobre los bloques existentes y cómo aparecieron.
{
       "ulid": "01CPZDPD1D9R019JS87TPV5MPE",
       "minTime": 1536472800000,
       "maxTime": 1536494400000,
       "stats": {
               "numSamples": 8292128378,
               "numSeries": 1673622,
               "numChunks": 69528220
       },
       "compaction": {
               "level": 2,
               "sources": [
                       "01CPYRY9MS465Y5ETM3SXFBV7X",
                       "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                       "01CPZ6NR4Q3PDP3E57HEH760XS"
               ],
               "parents": [
                       {
                               "ulid": "01CPYRY9MS465Y5ETM3SXFBV7X",
                               "minTime": 1536472800000,
                               "maxTime": 1536480000000
                       },
                       {
                               "ulid": "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                               "minTime": 1536480000000,
                               "maxTime": 1536487200000
                       },
                       {
                               "ulid": "01CPZ6NR4Q3PDP3E57HEH760XS",
                               "minTime": 1536487200000,
                               "maxTime": 1536494400000
                       }
               ]
       },
       "version": 1
}
Las compactaciones en Prometheus están vinculadas al momento de descarga del bloque head en disco. En ese momento se pueden realizar varias de estas operaciones.
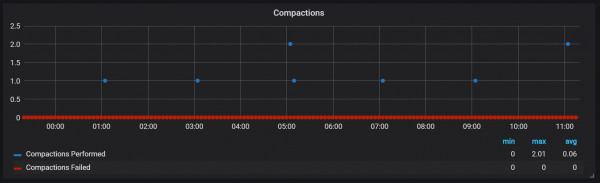
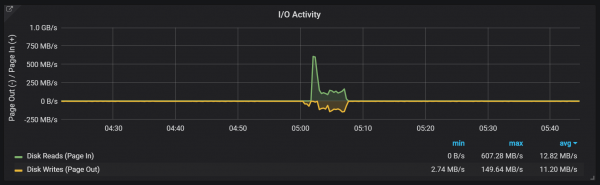
Parece que las compactaciones no están limitadas de ninguna manera y pueden causar grandes picos de I/O de disco durante su ejecución.
Picos de carga de CPU
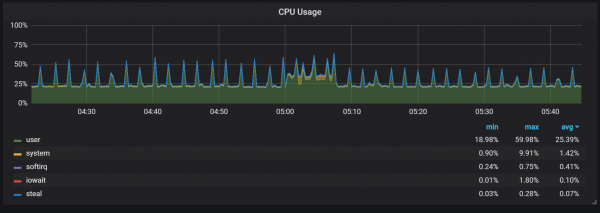
Por supuesto, esto afecta negativamente la velocidad del sistema y también representa un serio desafío para los almacenes LSM: ¿cómo realizar compactaciones para mantener una alta velocidad de consultas sin causar un exceso de sobrecarga?
El uso de memoria durante el proceso de compactación también parece bastante curioso.
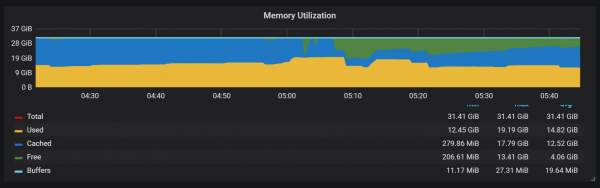
Podemos ver cómo después de la compactación, la mayor parte de la memoria cambia de estado de Cached a Free: lo que significa que información potencialmente valiosa ha sido eliminada de ahí. Es interesante saber si se está utilizando aquí fadvice() o alguna otra técnica de minimización, o si esto se debe a que el caché se ha liberado de bloques destruidos durante la compactación.
Recuperación de fallos
La recuperación de fallos lleva tiempo, y eso es razonable. Para un flujo entrante de un millón de registros por segundo, tuve que esperar alrededor de 25 minutos mientras se realizaba la recuperación teniendo en cuenta el disco SSD.
nivel=info ts=2018-09-13T13:38:14.09650965Z llamador=main.go:222 msg="Iniciando Prometheus" versión="(versión=2.3.2, rama=v2.3.2, revisión=71af5e29e815795e9dd14742ee7725682fa14b7b)"
nivel=info ts=2018-09-13T13:38:14.096599879Z llamador=main.go:223 contexto_de_compilacion="(go=go1.10.1, usuario=Jenkins, fecha=20180725-08:58:13OURCE)"
nivel=info ts=2018-09-13T13:38:14.096624109Z llamador=main.go:224 detalles_del_servidor="(Linux 4.15.0-32-generic #35-Ubuntu SMP Vie Ago 10 17:58:07 UTC 2018 x86_64 1bee9e9b78cf (ninguno))"
nivel=info ts=2018-09-13T13:38:14.096641396Z llamador=main.go:225 limites_fd="(suave=1048576, duro=1048576)"
nivel=info ts=2018-09-13T13:38:14.097715256Z llamador=web.go:415 componente=web msg="Comenzando a escuchar conexiones" dirección=:9090
nivel=info ts=2018-09-13T13:38:14.097400393Z llamador=main.go:533 msg="Iniciando TSDB ..."
nivel=info ts=2018-09-13T13:38:14.098718401Z llamador=repair.go:39 componente=tsdb msg="bloque saludable encontrado" mint=1536530400000 maxt=1536537600000 ulid=01CQ0FW3ME8Q5W2AN5F9CB7R0R
nivel=info ts=2018-09-13T13:38:14.100315658Z llamador=web.go:467 componente=web msg="prefijo del enrutador" prefijo=\/prometheus
nivel=info ts=2018-09-13T13:38:14.101793727Z llamador=repair.go:39 componente=tsdb msg="bloque saludable encontrado" mint=1536732000000 maxt=1536753600000 ulid=01CQ78486TNX5QZTBF049PQHSM
nivel=info ts=2018-09-13T13:38:14.102267346Z llamador=repair.go:39 componente=tsdb msg="bloque saludable encontrado" mint=1536537600000 maxt=1536732000000 ulid=01CQ78DE7HSQK0C0F5AZ46YGF0
nivel=info ts=2018-09-13T13:38:14.102660295Z llamador=repair.go:39 componente=tsdb msg="bloque saludable encontrado" mint=1536775200000 maxt=1536782400000 ulid=01CQ7SAT4RM21Y0PT5GNSS146Q
nivel=info ts=2018-09-13T13:38:14.103075885Z llamador=repair.go:39 componente=tsdb msg="bloque saludable encontrado" mint=1536753600000 maxt=1536775200000 ulid=01CQ7SV8WJ3C2W5S3RTAHC2GHB
nivel=error ts=2018-09-13T14:05:18.208469169Z llamador=wal.go:275 componente=tsdb msg="Corrupción de WAL detectada; truncando" err="checksum CRC32 inesperado d0465484, quiere 0" archivo=\/opt\/prometheus\/data\/.prom2-data\/wal\/007357 pos=15504363
nivel=info ts=2018-09-13T14:05:19.471459777Z llamador=main.go:543 msg="TSDB iniciado"
nivel=info ts=2018-09-13T14:05:19.471604598Z llamador=main.go:603 msg="Cargando archivo de configuración" nombre_archivo=\/etc\/prometheus.yml
nivel=info ts=2018-09-13T14:05:19.499156711Z llamador=main.go:629 msg="Carga completa del archivo de configuración" nombre_archivo=\/etc\/prometheus.yml
nivel=info ts=2018-09-13T14:05:19.499228186Z llamador=main.go:502 msg="El servidor está listo para recibir solicitudes web."
El principal problema del proceso de recuperación es el alto consumo de memoria. A pesar de que en una situación normal el servidor puede funcionar de manera estable con la misma cantidad de memoria, al caerse puede no levantarse debido a OOM. La única solución que encontré fue desactivar la recolección de datos, levantar el servidor, permitir que se recupere y reiniciarlo con la recolección de datos habilitada.
Calentamiento
Otro comportamiento a tener en cuenta durante el calentamiento es la relación entre bajo rendimiento y alto consumo de recursos justo después del inicio. En algunos, pero no en todos los arranques, observé una carga significativa en CPU y memoria.
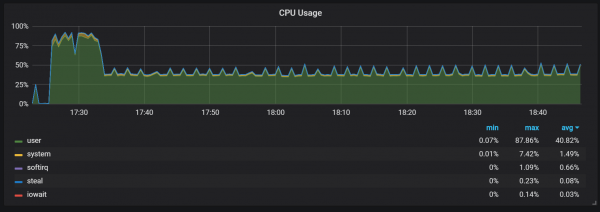
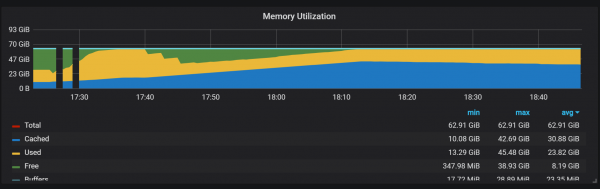
Las caídas en el uso de memoria indican que Prometheus no puede configurar todas las recolecciones desde el inicio, y cierta información se pierde.
No he determinado las razones exactas de la alta carga en la CPU y la memoria. Sospecho que está relacionado con la creación de nuevas series temporales en el bloque principal con alta frecuencia.
Picos de carga en la CPU
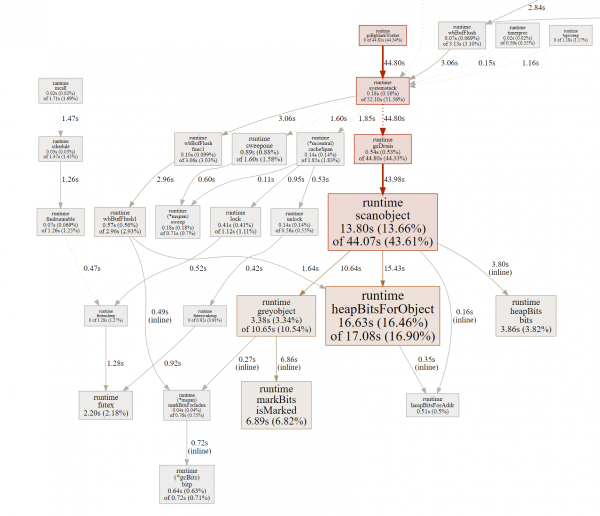
Además de los empaquetados, que generan una carga bastante alta en I/O, he notado picos significativos en la carga de la CPU cada dos minutos. Los picos son más largos con un alto flujo de entrada y parece que son causados por el recolector de basura de Go, al menos algunos núcleos están totalmente ocupados.
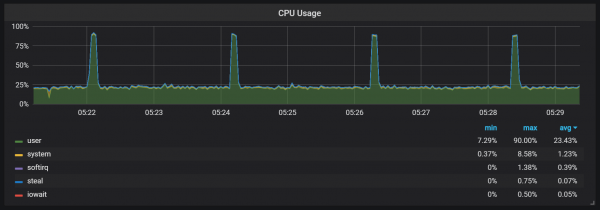
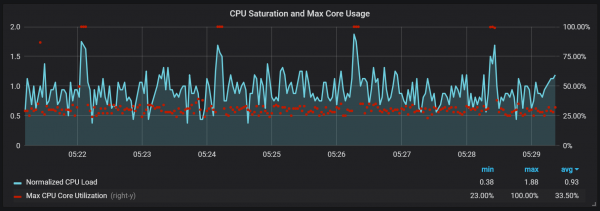
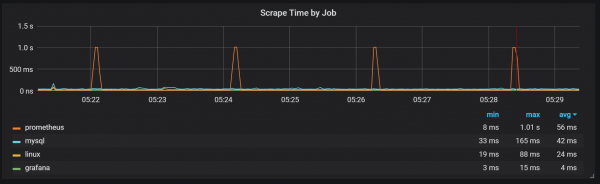
Estos picos no son triviales. Parece que cuando ocurren, el punto de entrada interno y las métricas de Prometheus se vuelven inaccesibles, lo que provoca fallos en los datos en esos mismos intervalos de tiempo.
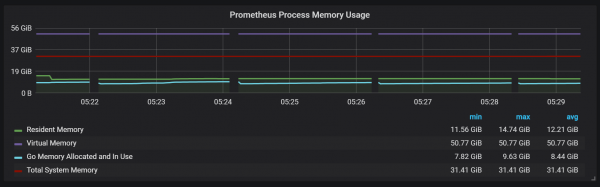
También se puede notar que el exportador de Prometheus se detiene durante un segundo.
Podemos notar correlaciones con la recolección de basura (GC).
Conclusión
La TSDB en Prometheus 2 funciona rápidamente, capaz de manejar millones de series temporales y, al mismo tiempo, miles de registros por segundo, utilizando hardware bastante modesto. La utilización de la CPU y el I/O de disco también son impresionantes. Mi ejemplo mostraba hasta 200,000 métricas por segundo en un solo núcleo en uso.
Al planificar la expansión, hay que tener en cuenta volúmenes suficientes de memoria, y debe ser memoria real. La cantidad de memoria utilizada que he observado era de alrededor de 5 GB por 100,000 registros por segundo del flujo de entrada, lo que sumado a la caché del sistema operativo daba un total de aproximadamente 8 GB de memoria ocupada.
Por supuesto, aún queda mucho trabajo por hacer para controlar los picos de CPU y de I/O de disco, y no es sorprendente, dado lo joven que es la TSDB Prometheus 2 en comparación con InnoDB, TokuDB, RocksDB, WiredTiger, pero todos ellos tuvieron problemas similares al inicio de su ciclo de vida.
Fuente: habr.com
