

Sistema para el análisis de tráfico sin su descifrado. Este método se llama simplemente "aprendizaje automático". Resulta que, si a un clasificador especial se le proporciona una gran cantidad de tráfico diverso, el sistema puede detectar con una alta probabilidad las actividades de código malicioso dentro del tráfico cifrado.
Las amenazas en la red han cambiado y se han vuelto más "inteligentes". Recientemente, la propia concepción de ataque y defensa ha cambiado. El número de eventos en la red ha aumentado exponencialmente. Los ataques se han vuelto más sofisticados y los hackers tienen un rango más amplio de ataques.
Según las estadísticas de Cisco, los delincuentes han triplicado en el último año el número de programas maliciosos que utilizan para sus actividades, específicamente para su ocultación — cifrado. Teóricamente, se sabe que un algoritmo de cifrado "correcto" no puede ser vulnerado. Para entender lo que se oculta dentro del tráfico cifrado, es necesario o bien descifrarlo conociendo la clave, o intentar descifrarlo mediante diversos trucos, o atacándolo directamente, o utilizando alguna vulnerabilidad en los protocolos de criptografía.
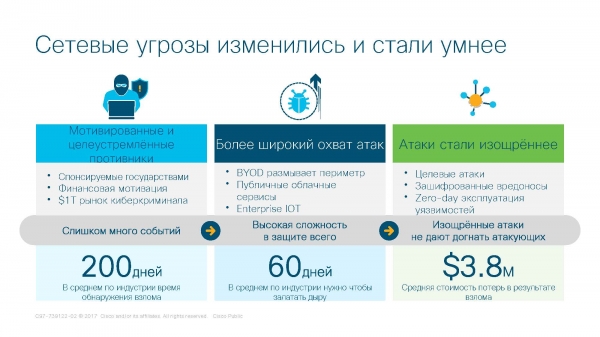
El panorama de las amenazas en la red de nuestra época
Aprendizaje automático
¡Conoce la tecnología de frente! Antes de hablar sobre cómo funciona la técnica de descifrado basada en el aprendizaje automático, es necesario analizar cómo funcionan las redes neuronales.
El aprendizaje automático (Machine Learning) es una amplia subdivisión de la inteligencia artificial que estudia los métodos para construir algoritmos capaces de aprender. Esta ciencia está dirigida a la creación de modelos matemáticos de "aprendizaje" para la computadora. El objetivo del aprendizaje es la predicción de algo. En términos humanos, llamamos a este proceso "sabiduría". «sabiduría». La sabiduría se manifiesta en personas que han vivido suficientes años (un niño de 2 años no puede ser sabio). Al solicitar consejo a nuestros mayores, les proporcionamos cierta información sobre el evento (datos de entrada) y pedimos ayuda. Ellos, a su vez, recuerdan todas las situaciones de la vida que están de alguna manera relacionadas con su problema (base de conocimientos) y, sobre la base de esos conocimientos (datos), nos brindan lo que sería una especie de predicción (consejo). Esta clase de consejo se ha denominado predicción porque la persona que ofrece el consejo no sabe con certeza qué sucederá, sino que solo lo presume. La experiencia de vida muestra que una persona puede tener razón, pero también puede equivocarse.
No se debe comparar las redes neuronales con el algoritmo de ramificación (if-else). Son cosas diferentes y tienen diferencias clave. El algoritmo de ramificación tiene una clara "comprensión" de qué hacer. Lo demostraré con ejemplos.
Tarea. Determinar la distancia de frenado de un automóvil según su marca y año de fabricación.
Ejemplo de funcionamiento del algoritmo de ramificación. Si el automóvil es de la marca 1 y fue producido en 2012, su distancia de frenado es de 10 metros; de lo contrario, si el automóvil es de la marca 2 y fue producido en 2011, y así sucesivamente.
Ejemplo de funcionamiento de una red neuronal. Reunimos datos sobre las distancias de frenado de automóviles de los últimos 20 años. Según la marca y el año, hacemos una tabla del tipo "marca-año de fabricación-distancia de frenado". Le damos esta tabla a la red neuronal y comenzamos a entrenarla. El entrenamiento se realiza de la siguiente manera: introducimos datos en la red neuronal, pero sin la distancia de frenado. La red intenta predecir cuál será la distancia de frenado, basada en la tabla que se le ha cargado. Predice algo y le pregunta al usuario: "¿Tengo razón?". Antes de la pregunta, crea una cuarta columna: la columna de adivinanzas. Si tiene razón, anota un 1 en la cuarta columna; si se equivoca, un 0. La red neuronal pasa al siguiente evento (incluso si cometió un error). Así es como la red aprende, y cuando el entrenamiento ha terminado (se alcanza un criterio de convergencia determinado), introducimos datos sobre el automóvil que nos interesa y finalmente obtenemos una respuesta.
Para aclarar la cuestión sobre el criterio de convergencia, explicaré que es una fórmula matemáticamente derivada para estadísticas. Un ejemplo claro de 2 fórmulas diferentes de convergencia. La roja es convergencia binaria, la azul es convergencia normal.
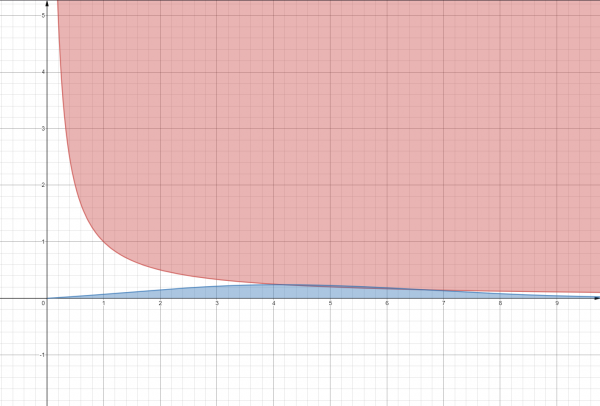
Distribuciones binomial y normal de probabilidad
Para que sea más claro, haga la pregunta: «¿Cuál es la probabilidad de encontrar un dinosaurio?». Hay 2 posibles respuestas. Opción 1: muy baja (gráfico azul). Opción 2: puede haber un encuentro o no (gráfico rojo).
Por supuesto, una computadora no es un ser humano y se entrena de manera diferente. Se distinguen 2 tipos de aprendizaje para el 'caballo de hierro' – aprendizaje por precedentes y aprendizaje deductivo.
El aprendizaje por precedentes es un método de formación basado en leyes matemáticas. Los matemáticos recopilan tablas estadísticas, hacen conclusiones y cargan los resultados en la red neuronal: una fórmula para el cálculo.
El aprendizaje deductivo ocurre completamente dentro de la red neuronal (desde la recopilación de datos hasta su análisis). Aquí se forma una tabla sin una fórmula, pero con estadísticas.
Un amplio panorama de la tecnología requeriría un par de docenas más de artículos. Por ahora, esto es suficiente para una comprensión general.
Neuroplasticidad
En biología existe el concepto de neuroplasticidad. La neuroplasticidad es la capacidad de las neuronas (células del cerebro) de actuar 'según la situación'. Por ejemplo, una persona que ha perdido la vista escucha mejor los sonidos, percibe olores y siente objetos. Esto se debe a que una parte del cerebro (parte de las neuronas) responsable de la visión redistribuye su trabajo hacia otras funcionalidades.
Un ejemplo brillante de neuroplasticidad en la vida es el caramelo BrainPort.
En 2009, la Universidad de Wisconsin en Madison anunció el lanzamiento de un nuevo dispositivo que desarrolla las ideas del 'pantalla de lengua', llamado BrainPort. BrainPort opera según este algoritmo: la señal de video se envía desde la cámara al procesador, que gestiona el zoom, el brillo y otros parámetros de la imagen. También convierte las señales digitales en impulsos eléctricos, asumiendo efectivamente las funciones de la retina.
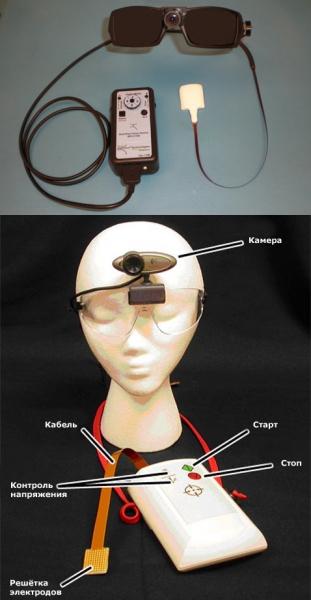
Caramelo BrainPort con gafas y cámara
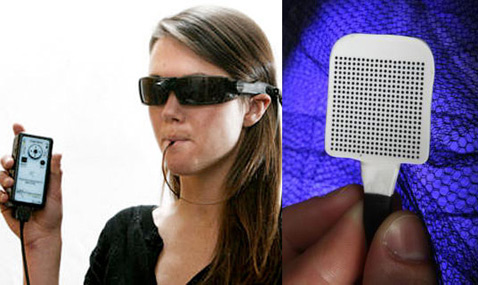
BrainPort en acción
También es así con la computadora. Si la red neuronal siente un cambio en el proceso, se ajusta a él. Esta es la clave de la ventaja de las redes neuronales sobre otros algoritmos: la autonomía. Es una especie de humanidad.
Análisis de tráfico encriptado
Encrypted Traffic Analytics es parte del sistema Stealthwatch. Stealthwatch es un desarrollo de Cisco en el sector de soluciones para la supervisión y analítica de seguridad, que utiliza datos de telemetría de la infraestructura de red existente.
La base de Stealthwatch Enterprise está compuesta por herramientas como Flow Rate License, Flow Collector, Management Console y Flow Sensor.
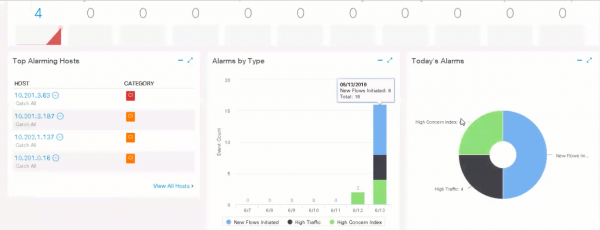
Interfaz de Cisco Stealthwatch
El problema del cifrado se ha vuelto muy agudo debido al aumento del tráfico cifrado. Antes, solo se cifraba el código (principalmente), pero ahora, todo el tráfico está cifrado, lo que hace muchísimo más difícil separar los datos 'limpios' de los virus. Un claro ejemplo es WannaCry, que utilizó Tor para ocultar su presencia en la red.
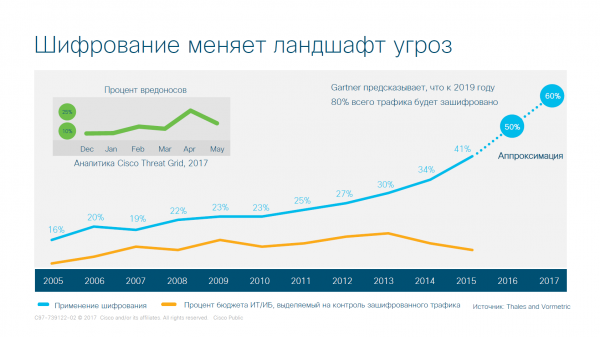
Visualización del crecimiento del tráfico cifrado en la red
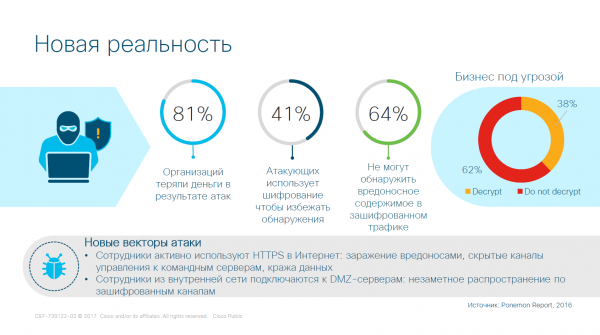
Cifrado en la macroeconomía
El sistema Encrypted Traffic Analytics (ETA) es necesario precisamente para trabajar con tráfico cifrado sin necesidad de descifrarlo. Los delincuentes son inteligentes y utilizan algoritmos de cifrado robustos, y romperlos no solo es problemático, sino que también implica enormes costos para las organizaciones.
El sistema funciona de la siguiente manera. Cualquier tráfico llega a la empresa. Este tráfico entra en TLS (transport layer security — protocolo de seguridad de la capa de transporte). Supongamos que el tráfico está cifrado. Intentamos responder una serie de preguntas sobre qué conexión se ha establecido.
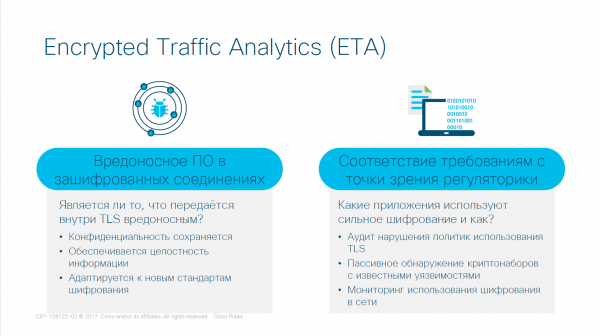
Principio de funcionamiento del sistema Encrypted Traffic Analytics (ETA)
Para responder a estas preguntas, utilizamos el aprendizaje automático en este sistema. Se toman investigaciones de Cisco y, basándose en estas investigaciones, se crea una tabla con 2 resultados: tráfico malicioso y 'bueno'. Por supuesto, no sabemos con certeza qué tráfico llegó al sistema en un momento dado, pero podemos rastrear la historia del tráfico tanto dentro de la empresa como fuera de ella, utilizando datos de la arena mundial. Al final de esta etapa, obtenemos una enorme tabla de datos.
Como resultado del estudio, se identifican características distintivas: ciertas reglas que pueden ser expresadas en forma matemática. Estas reglas variarán ampliamente según diferentes criterios, como el tamaño de los archivos transmitidos, el tipo de conexión, el país desde el cual se origina el tráfico, etc. Como resultado del trabajo, una gigantesca tabla se ha traducido en un conjunto de fórmulas. Se ha reducido su número, pero esto no es suficiente para un trabajo cómodo.
A continuación, se aplica la tecnología de aprendizaje automático: la convergencia de la fórmula, y a partir de esta convergencia obtenemos un disparador: un interruptor, donde al recibir datos, obtenemos un conmutador (flag) en posición elevada o baja.
La etapa resultante es obtener un conjunto de disparadores que cubran el 99% del tráfico.
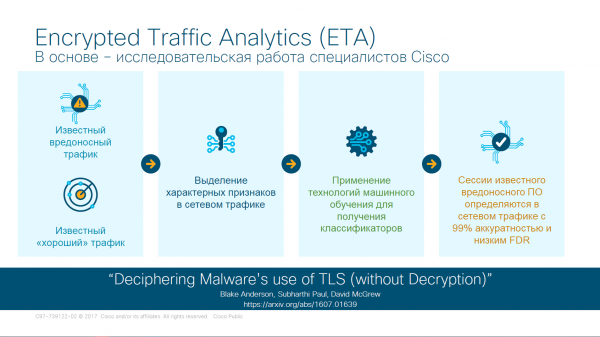
Etapas de verificación del tráfico en ETA
Como resultado del trabajo, se resuelve otro problema: el ataque interno. Ya no se requieren personas en medio que filtran el tráfico manualmente (en este punto me estoy comprometiendo). En primer lugar, ya no es necesario gastar mucho dinero en un administrador de sistemas competente (sigo comprometiéndome). En segundo lugar, se elimina el riesgo de hackeo desde dentro (al menos, parcialmente).
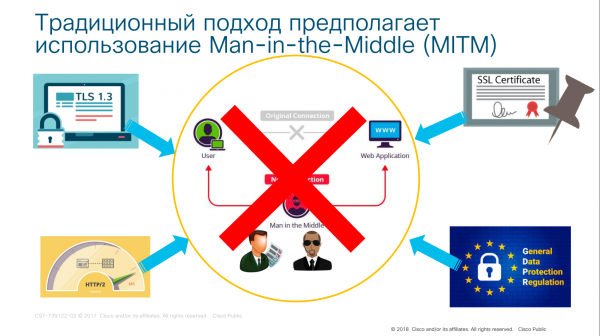
Concepto obsoleto de Man-in-the-Middle
Ahora, vamos a analizar sobre qué se basa el sistema.
El sistema opera sobre 4 protocolos de comunicación: TCP/IP – protocolo de transferencia de datos en Internet, DNS – servidor de nombres de dominio, TLS – protocolo de protección de nivel de transporte, SPLT (SpaceWire Physical Layer Tester) – tester de la capa física de comunicación.
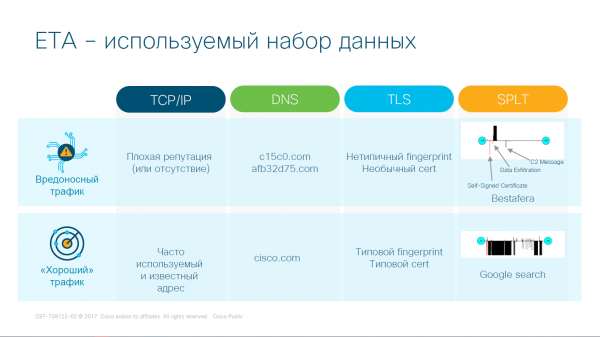
Protocolos que trabajan con ETA
La comparación se realiza mediante la correlación de datos. A través de los protocolos TCP/IP, se verifica la reputación de los sitios (historia de visitas, objetivo de creación del sitio, etc.), gracias al protocolo DNS, podemos eliminar direcciones de sitios "malos". El protocolo TLS trabaja con las "huellas" del sitio (fingerprint) y verifica el sitio en la base del grupo de respuesta a emergencias cibernéticas (cert). La última etapa de verificación de la conexión es la comprobación a nivel físico. Los detalles de esta etapa no se detallan, pero la idea es la siguiente: verificación de las sinusoidales y cosenoidales de las curvas de transmisión de datos en instalaciones oscilográficas, es decir, gracias a la estructura de la solicitud a nivel físico, definimos el objetivo de la conexión.
Como resultado del funcionamiento del sistema, podemos extraer datos de tráfico encriptado. A través del análisis de los paquetes, podemos leer la información máxima de los campos no encriptados en el paquete. Mediante la inspección del paquete a nivel físico, conoceremos las características del paquete (parcial o completamente). Además, no debemos olvidar la reputación de los sitios. Si la solicitud proviene de alguna fuente .onion, no debemos confiar en ella. Para facilitar el trabajo con este tipo de datos, se ha creado un mapa de riesgos.
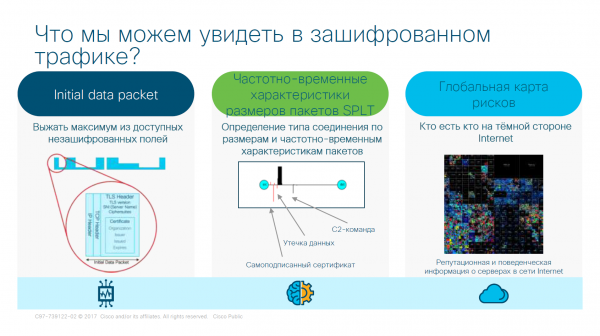
Resultado del trabajo de ETA
Y todo parece estar bien, pero hablemos sobre el despliegue de la red.
Implementación física de ETA
Aquí surgen una serie de matices y sutilezas. En primer lugar, al crear este tipo de
red con software de alto nivel, es necesario recopilar datos. Recoger datos manualmente es completamente
exhaustivo, y llevar a cabo un sistema de respuesta resulta ya más interesante. En segundo lugar, los datos
deben ser abundantes, lo que significa que los sensores instalados en la red deben funcionar
no solo de manera autónoma, sino también en un modo finamente ajustado, lo que crea una serie de complejidades.
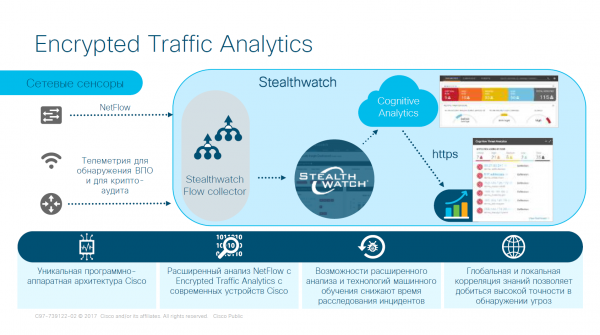
Sensores y sistema Stealthwatch
Instalar un sensor es una cosa, pero configurarlo es una tarea completamente diferente. Para la configuración de los sensores, existe un conjunto que opera bajo la siguiente topología: ISR = enrutador con integración de servicios de Cisco (Cisco Integrated Services Router); ASR = enrutador con agregación de servicios de Cisco (Cisco Aggregation Services Router); CSR = enrutador de servicios en la nube de Cisco (Cisco Cloud Services Router); WLC = controlador de redes LAN inalámbricas de Cisco (Cisco Wireless LAN Controller); IE = conmutador industrial Ethernet de Cisco (Cisco Industrial Ethernet); ASA = dispositivo de seguridad adaptativa de Cisco (Cisco Adaptive Security Appliance); FTD = solución de defensa contra amenazas Cisco Firepower Threat Defense; WSA = dispositivo de protección del tráfico web (Web Security Appliance); ISE = módulo de servicios de identidad (Identity Services Engine)
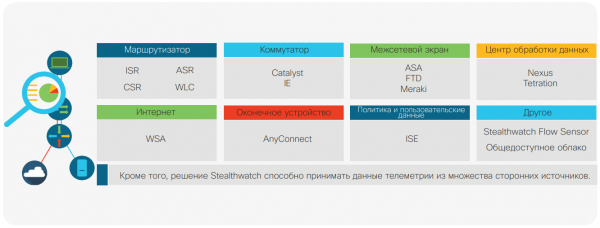
Monitoreo integral teniendo en cuenta cualquier dato de telemetría
Los administradores de red comienzan a tener arritmias por la cantidad de palabras "Cisco" en el párrafo anterior. El precio de esta maravilla no es bajo, pero no de eso se trata hoy...
La modelización del comportamiento de un hacker se llevará a cabo de la siguiente manera. Stealthwatch rastrea cuidadosamente la actividad de cada dispositivo en la red y es capaz de crear un patrón de comportamiento normal. Además, esta solución proporciona una comprensión profunda del comportamiento indebido conocido. En el marco de esta solución se utilizan alrededor de 100 diferentes algoritmos de análisis o reglas heurísticas que abordan distintos tipos de comportamiento del tráfico, como el escaneo, la transmisión de cuadros de alarma desde un nodo, el ingreso al sistema mediante fuerza bruta, la captación sujeta de datos, la posible fuga de datos, etc. Los eventos de seguridad enumerados caen bajo la categoría de alerta lógica de alto nivel. Algunos eventos de seguridad también pueden disparar una alarma por sí mismos. Así, el sistema es capaz de correlacionar numerosos incidentes anómalos aislados y reunirlos para determinar el posible tipo de ataque, así como asociarlo a un dispositivo específico y a un usuario (figura 2). Posteriormente, el incidente puede ser estudiado en dinámica y considerando los datos de telemetría relacionados. Esto constituye información contextual en su mejor forma. Los médicos que examinan a un paciente para entender qué ocurrió no consideran los síntomas de manera aislada. Estudian el panorama general para llegar a un diagnóstico. De manera similar, Stealthwatch registra cada actividad anormal en la red y la analiza en conjunto para emitir señales de alarma considerando el contexto, ayudando así a los especialistas en seguridad a priorizar los riesgos.
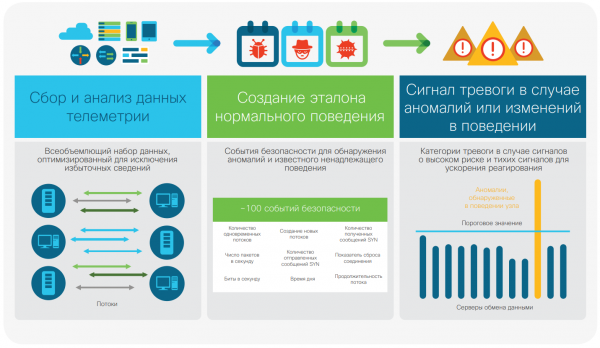
Detección de anomalías mediante modelización del comportamiento
El despliegue físico de la red se ve así:
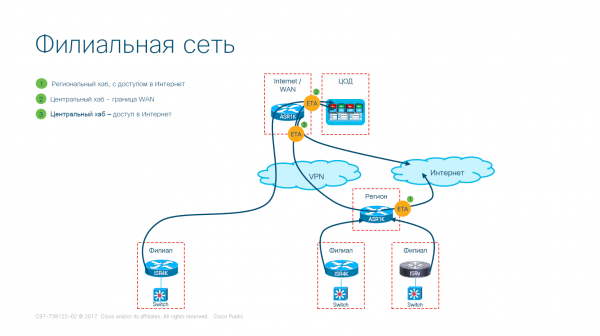
Opción de despliegue de red para una red de sucursal (simplificada)
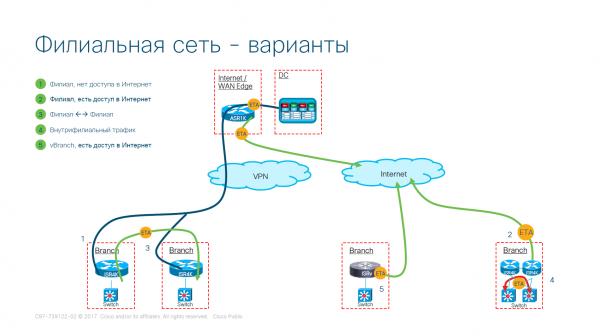
Opción de despliegue de red para una red de sucursal
La red está desplegada, pero queda la cuestión abierta sobre la red neuronal. Se organizó una red de transmisión de datos, se instalaron sensores en los umbrales y se puso en marcha un sistema de recopilación de información, pero la red neuronal no participó en el proceso. Por ahora.
Red neuronal de múltiples capas
El sistema analiza el comportamiento del usuario y del dispositivo para detectar infecciones maliciosas, comunicaciones con servidores de comando, filtraciones de datos y aplicaciones potencialmente no deseadas que operan en la infraestructura de la organización. Existen varios niveles de procesamiento de datos en los que la combinación de métodos de inteligencia artificial, aprendizaje automático y estadística matemática ayuda a la red a autoaprender su actividad normal, para que pueda identificar actividades maliciosas.
El pipeline de análisis de seguridad de la red, que recopila datos de telemetría de todas las partes de la red ampliada, incluyendo el tráfico cifrado, es una característica única de Stealthwatch. Formulando gradualmente una comprensión de lo que es 'anómalo', luego clasifica los elementos individuales de 'actividad amenazante' y, finalmente, toma una decisión final respecto a si el dispositivo o el usuario han sido realmente comprometidos. La capacidad de reunir pequeñas piezas que, juntas, forman evidencia para tomar una decisión final sobre el compromiso del objeto se logra gracias a un análisis y correlación muy cuidadosos.
Esta capacidad es muy importante, ya que una empresa estándar puede recibir una enorme cantidad de alertas diariamente, y no es posible investigar cada una de ellas, dado que los recursos de los especialistas en seguridad son limitados. El módulo de aprendizaje automático procesa una cantidad inmensa de información prácticamente en tiempo real para identificar incidentes críticos con un alto nivel de confianza, y también es capaz de sugerir un orden claro de acciones para una respuesta rápida.
Analicemos más a fondo los numerosos métodos de aprendizaje automático utilizados por Stealthwatch. Cuando un incidente es enviado al módulo de aprendizaje automático de Stealthwatch, pasa por un embudo de análisis de seguridad, donde se utiliza una combinación de métodos de aprendizaje automático supervisado y no supervisado.
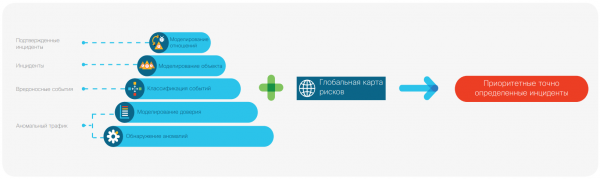
Capacidades de aprendizaje automático en múltiples niveles
Nivel 1. Detección de anomalías y modelado de confianza
En este nivel, se descarta el 99 % del tráfico mediante detectores de anomalías estadísticos. Estos sensores juntos forman modelos complejos de lo que es normal y lo que, por el contrario, es anómalo. Sin embargo, lo anómalo no necesariamente es malicioso. Muchas de las actividades en su red no están relacionadas con una amenaza, simplemente son inusuales. Es importante clasificar tales procesos sin considerar el comportamiento amenazante. Por esta razón, los resultados de estos detectores pasan por un análisis adicional para registrar comportamientos extraños que puedan explicarse y en los que se pueda confiar. Al final, solo una pequeña fracción de los flujos y solicitudes más importantes pasa a los niveles 2 y 3. Sin estos métodos de aprendizaje automático, los costos operativos para separar la señal del ruido serían demasiado altos.
Detección de anomalías. En la primera etapa de la detección de anomalías, se utilizan métodos estadísticos de aprendizaje automático para separar el tráfico estadísticamente normal del anómalo. Más de 70 detectores separados procesan los datos de telemetría recopilados por Stealthwatch sobre el tráfico que pasa por el perímetro de su red, separando el tráfico interno del sistema de nombres de dominio (DNS) y los datos de un servidor proxy, si los hay. Cada solicitud es procesada por más de 70 detectores, cada uno utilizando su propio algoritmo estadístico, generando una evaluación de las anomalías detectadas. Estas evaluaciones se combinan, y como resultado de aplicar varios métodos estadísticos, se obtiene una única evaluación para cada solicitud individual. Luego, esta evaluación combinada se utiliza para separar el tráfico normal del anómalo.
Modelado de la confianza. A continuación, se agrupan solicitudes similares y la evaluación acumulativa de anomalías para dichos grupos se determina como el promedio a largo plazo. Con el tiempo, se analiza una mayor cantidad de solicitudes con la posterior determinación del promedio a largo plazo, lo que permite reducir las falsas positivas y negativas. Los resultados de la modelización de la confianza se utilizan para seleccionar un subconjunto de tráfico cuya evaluación de anomalías supera un umbral dinámicamente definido, para moverlo al siguiente nivel de procesamiento.
Nivel 2. Clasificación de eventos y modelado de objetos
En este nivel se realiza la clasificación de los resultados obtenidos en las etapas anteriores, asignando estos a eventos maliciosos específicos. La clasificación de eventos se lleva a cabo según el valor asignado por los clasificadores de aprendizaje automático con el fin de garantizar un índice de precisión constante superior al 90%. Estos incluyen:
- modelos lineales basados en el lema de Neyman-Pearson (ley de la distribución normal del gráfico al principio del artículo)
- máquinas de soporte vectorial que utilizan aprendizaje multivariante
- redes neuronales y el algoritmo de "bosque aleatorio".
Luego, tales eventos de seguridad aislados se asocian con un único dispositivo final con el tiempo. Es en esta etapa en la que se forma una descripción de la amenaza, a partir de lo cual se crea una imagen completa de cómo el respectivo atacante logró alcanzar ciertos resultados.
Clasificación de eventos. Un subconjunto estadísticamente anómalo del nivel anterior se distribuye en 100 o más categorías mediante clasificadores. La mayoría de los clasificadores se basan en el comportamiento individual, relaciones en grupo o comportamiento a escala global o local, mientras que otros pueden ser bastante específicos. Por ejemplo, un clasificador puede apuntar al tráfico de servidores de comando, extensiones sospechosas o actualizaciones de software no autorizadas. Al final de esta etapa se forma un conjunto de eventos anómalos en el sistema de seguridad, clasificados en categorías específicas.
Modelado de objetos. Si la cantidad de pruebas en apoyo a la hipótesis de la malignidad de un objeto específico supera el umbral de significancia, se determina la amenaza. Los eventos relevantes que influyeron en la determinación de la amenaza se vinculan a ella y se convierten en parte de un modelo discreto a largo plazo del objeto. A medida que se acumulan pruebas a lo largo del tiempo, el sistema determina nuevas amenazas al alcanzar el umbral de significancia. Este umbral tiene un carácter dinámico y se ajusta inteligentemente en función del nivel de riesgo de que se materialice la amenaza y otros factores. Después de esto, la amenaza aparece en el panel de información de la interfaz web y se eleva al siguiente nivel.
Nivel 3. Modelado de Relaciones
El objetivo del modelado de relaciones es sintetizar los resultados obtenidos en los niveles anteriores desde una perspectiva global, considerando no solo el contexto local, sino también el contexto global del incidente correspondiente. Es en esta etapa donde se puede determinar cuántas organizaciones han enfrentado un ataque de este tipo, para entender si fue dirigido específicamente contra usted o si forma parte de una campaña global, y usted simplemente fue un daño colateral.
Los incidentes son confirmados o detectados. Un incidente confirmado implica una certeza del 99 al 100%, ya que los métodos y herramientas relevantes se han observado previamente en acción a una escala más amplia (global). Los incidentes detectados son únicos para usted y forman parte de una campaña enfocada. Los resultados obtenidos anteriormente se transmiten junto con un conjunto conocido de acciones, lo que ahorra tiempo y recursos durante la respuesta. Se presentan junto con las herramientas de investigación que necesitará para comprender quién lo atacó y cuál es el grado de dirección de la campaña hacia su negocio digital. Como puede imaginar, el número de incidentes confirmados supera con creces al de los detectados, precisamente porque los incidentes confirmados no implican altos costos para los atacantes, mientras que los incidentes detectados suelen ser más costosos.
caro, ya que deben ser nuevos y personalizados. Al crear la posibilidad de identificar incidentes confirmados, la economía del juego finalmente se ha trasladado a favor de los defensores, brindándoles una ventaja clara.
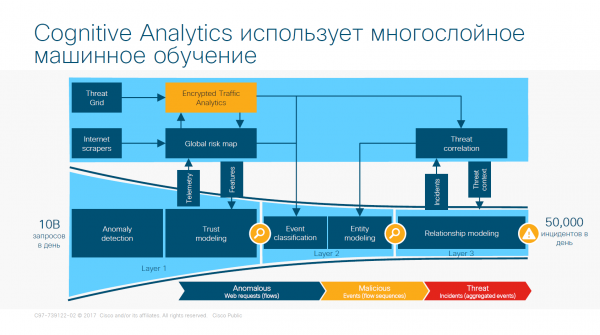
Aprendizaje multinivel del sistema de redes neuronales basado en ETA
Mapa global de riesgos
El mapa global de riesgos se genera a partir del análisis aplicado por algoritmos de aprendizaje automático a uno de los mayores conjuntos de datos del sector. Proporciona datos estadísticos exhaustivos sobre el comportamiento de los servidores en línea, incluso si no son conocidos. Dichos servidores están relacionados con ataques, pueden ser involucrados o utilizados en un ataque futuro. No es una «lista negra», sino una visión integral del servidor en cuestión desde el punto de vista de la seguridad. Esa información sobre la actividad de los servidores mencionados, preparada en contexto, permite a los detectores y clasificadores de aprendizaje automático Stealthwatch predecir con precisión el nivel de riesgo asociado con las comunicaciones con tales servidores.
Puedes ver los mapas disponibles .
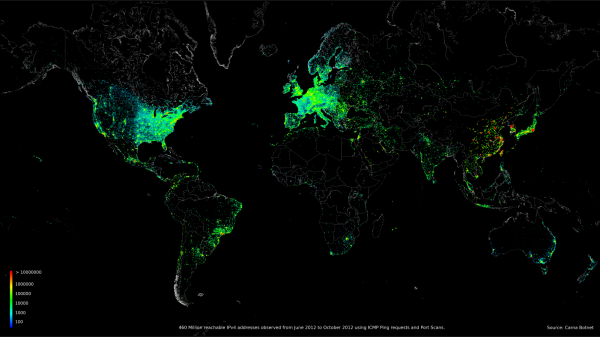
Un mapa del mundo que muestra 460 millones direcciones IP
Ahora la red se está entrenando y protegiendo su red.
¿Finalmente se ha encontrado la panacea?
Desafortunadamente, no. De la experiencia con el sistema, puedo decir que hay 2 problemas globales.
Problema 1. Precio. Toda la red está desplegada en un sistema Cisco. Esto es tanto bueno como malo. El lado positivo es que no tienes que preocuparte por instalar un montón de dispositivos de marcas como D-Link, MikroTik, etc. El lado negativo es el alto costo del sistema. Dada la situación económica del negocio en Rusia, en este momento solo un propietario adinerado de una gran empresa o banco puede permitirse esta maravilla.
Problema 2. Capacitación. No mencioné en el artículo el tiempo de entrenamiento de la red neuronal, no porque no exista, sino porque está en constante aprendizaje y no podemos predecir cuándo aprenderá. Claro, hay herramientas de estadística matemática (por ejemplo, la formulación del criterio de convergencia de Pearson), pero eso son medias tintas. Obtenemos una probabilidad de filtración de tráfico, y eso solo si el ataque ya ha sido llevado a cabo y es conocido.
A pesar de estos 2 problemas, hemos logrado un gran avance en el desarrollo de la seguridad de la información en general y de la protección de la red en particular. Este hecho puede ser motivador para el estudio de las tecnologías de la red y de las redes neuronales, que actualmente son un campo muy prometedor.
Fuente: habr.com
