

Hola, soy Dmitry Logvinenko, ingeniero de datos del departamento de análisis del grupo de empresas «Vezёт».
Les hablaré de una herramienta maravillosa para el desarrollo de procesos ETL: Apache Airflow. Pero Airflow es tan versátil y multifacético que debería interesarles incluso si no están involucrados en flujos de datos, y solo necesitan ejecutar procesos de vez en cuando y monitorear su ejecución.
Y sí, no solo hablaré, sino que también mostraré: el programa incluye mucho código, capturas de pantalla y recomendaciones.
Lo que normalmente ves cuando buscas la palabra Airflow / Wikimedia Commons
Tabla de contenido
Introducción
Apache Airflow — es como Django:
- escrito en Python,
- tiene un excelente panel de administración,
- es ilimitadamente extensible,
— solo que mejor, y está hecho para otros propósitos, específicamente (como se menciona antes):
- ejecución y monitoreo de tareas en un número ilimitado de máquinas (cuantas te permita Celery/Kubernetes y tu conciencia)
- con generación dinámica de flujos de trabajo a partir de un código Python muy fácil de escribir y entender
- y la posibilidad de vincular cualquier base de datos y API entre sí usando tanto componentes listos como plugins personalizados (lo cual es extremadamente simple de hacer).
Usamos Apache Airflow de la siguiente manera:
- reuniendo datos de diversas fuentes (numerosos instancias de SQL Server y PostgreSQL, varias API con métricas de aplicaciones, incluso 1C) en DWH y ODS (para nosotros esto es Vertica y Clickhouse).
- como un avanzado
cron, que inicia procesos de consolidación de datos en ODS, así como supervisa su mantenimiento.
Hasta hace poco, nuestras necesidades eran cubiertas por un pequeño servidor con 32 núcleos y 50 GB de RAM. En Airflow, funcionan:
- más de 200 dags (de hecho, flujos de trabajo, en los que hemos agrupado tareas),
- cada uno con un promedio de 70 tareas,
- se inicia este asunto (también en promedio) una vez por hora.
Y sobre cómo nos expandimos, escribiré más adelante, pero ahora definamos la über-tarea que vamos a resolver:
Hay tres servidores SQL de origen, cada uno con 50 bases de datos: instancias de un mismo proyecto, por lo tanto, su estructura es idéntica (casi en todas partes, muaha-ha), lo que significa que en cada uno hay una tabla de Orders (afortunadamente, se puede meter una tabla con este nombre en cualquier negocio). Recuperamos datos, añadiendo campos adicionales (servidor de origen, base de datos de origen, identificador de tarea ETL) y de manera ingenua los lanzamos en, digamos, Vertica.
¡Vamos!
Parte principal, práctica (y un poco teórica)
¿Por qué lo necesitamos (y ustedes también)?
Cuando los árboles eran grandes y yo era sencillo SQL-helador en una tienda minorista rusa, acelerábamos los procesos ETL, también conocidos como flujos de datos, con dos herramientas disponibles para nosotros:
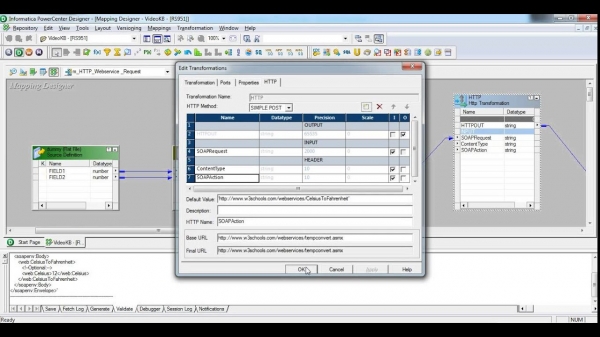
- Informatica Power Center — un sistema extremadamente amplio y muy eficiente, con su propio hardware y versionado. Usé, con suerte, el 1% de sus capacidades. ¿Por qué? Bueno, en primer lugar, esa interfaz parece sacada de los 2000 y psicológicamente nos afectaba. En segundo lugar, esta cosa está diseñada para procesos extremadamente complejos, un feroz reutilización de componentes y otras características muy importantes de empresas. Sobre lo que cuesta, como el ala de un Airbus A380/año, mejor ni hablemos.
Cuidado, la captura de pantalla puede hacerle un poco de daño a las personas menores de 30 años

- SQL Server Integration Server — con este compañero lo utilizamos en nuestros flujos internos del proyecto. Realmente: ya estamos usando SQL Server, y no usar sus herramientas ETL sería un poco ilógico. Todo en él es bueno: la interfaz es bonita y los informes de ejecución... Pero no es por eso que amamos los productos de software, oh, no es por eso. Versionar su
dtsx(que es un XML con nodos que se mezclan al guardar) podemos, ¿y de qué sirve? ¿Y crear un paquete de tareas que trasladará cientos de tablas de un servidor a otro? Vamos, con veinte tablas, su dedo índice se quedará cansado de hacer clic en el mouse. Pero definitivamente se ve más moderno:
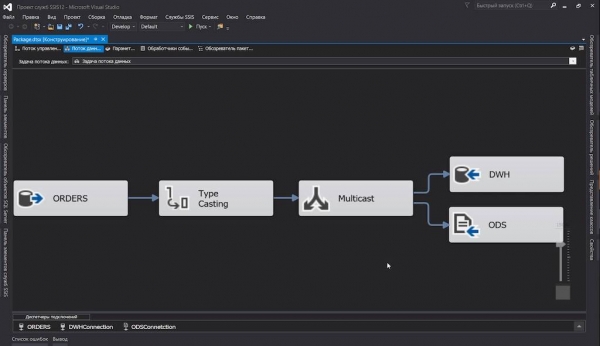
Sin duda, estábamos buscando soluciones. La cosa llegó incluso casi a un generador de paquetes SSIS hecho a medida...
… luego me llegó un nuevo trabajo. Y en este trabajo me encontré con Apache Airflow.
Cuando supe que las descripciones de los procesos ETL son simplemente código Python, casi empecé a saltar de alegría. Así, los flujos de datos fueron versionados y difuminados, y verter tablas con una estructura única de cien bases de datos en un solo objetivo se convirtió en cuestión de código Python en una pantalla de 13".
Construyendo un clúster
No hagamos un espectáculo infantil y no hablemos de cosas totalmente obvias, como la instalación de Airflow, la base de datos que eligieron, Celery y otros asuntos descritos en la documentación.
Para que podamos comenzar de inmediato con los experimentos, he esbozado docker-compose.yml en el que:
- Levantemos propiamente Airflow: Scheduler, Webserver. Ahí también estará funcionando Flower para monitorear las tareas de Celery (porque ya lo han incluido en
apache/airflow:1.10.10-python3.7, y no tenemos inconveniente); - PostgreSQL, en el que Airflow escribirá su información de servicio (datos del planificador, estadísticas de ejecución, etc.), y Celery marcará las tareas completadas;
- Redis, que actuará como broker de tareas para Celery;
- Celery worker, que se encargará de ejecutar las tareas directamente.
- En la carpeta
./dagsvamos a colocar nuestros archivos con la descripción de los DAGs. Se recogerán sobre la marcha, por lo que no es necesario reiniciar todo el stack después de cada pequeño cambio.
En algunos lugares, el código en los ejemplos no está completo (para no sobrecargar el texto), y en otros, se modifica a lo largo del proceso. Se pueden ver ejemplos de código completos y funcionales en el repositorio. .
docker-compose.yml
versión: '3.4'

x-airflow-config: &airflow-config
  AIRFLOW__CORE__DAGS_FOLDER: /dags
  AIRFLOW__CORE__EXECUTOR: CeleryExecutor
  AIRFLOW__CORE__FERNET_KEY: MJNz36Q8222VOQhBOmBROFrmeSxNOgTCMaVp2_HOtE0=
  AIRFLOW__CORE__HOSTNAME_CALLABLE: airflow.utils.net:get_host_ip_address
  AIRFLOW__CORE__SQL_ALCHEMY_CONN: postgres+psycopg2://airflow:airflow@airflow-db:5432/airflow

  AIRFLOW__CORE__PARALLELISM: 128
  AIRFLOW__CORE__DAG_CONCURRENCY: 16
  AIRFLOW__CORE__MAX_ACTIVE_RUNS_PER_DAG: 4
  AIRFLOW__CORE__LOAD_EXAMPLES: 'False'
  AIRFLOW__CORE__LOAD_DEFAULT_CONNECTIONS: 'False'

  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_RETRY: 'False'
  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_FAILURE: 'False'

  AIRFLOW__CELERY__BROKER_URL: redis://broker:6379/0
  AIRFLOW__CELERY__RESULT_BACKEND: db+postgresql://airflow:airflow@airflow-db/airflow

x-airflow-base: &airflow-base
  imagen: apache/airflow:1.10.10-python3.7
  entrada: /bin/bash
  reiniciar: siempre
  volúmenes:
    - ./dags:/dags
    - ./requirements.txt:/requirements.txt

servicios:
  # Redis como un corredor de Celery
  corredor:
    imagen: redis:6.0.5-alpine

  # Base de datos para los metadatos de Airflow
  airflow-db:
    imagen: postgres:10.13-alpine

    entorno:
      - POSTGRES_USER=airflow
      - POSTGRES_PASSWORD=airflow
      - POSTGRES_DB=airflow

    volúmenes:
      - ./db:/var/lib/postgresql/data

  # Contenedor principal con el servidor web de Airflow, Scheduler, Celery Flower
  airflow:
    <<: *airflow-base

    entorno:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint initdb &&
          (/entrypoint webserver &) &&
          (/entrypoint flower &) &&
           /entrypoint scheduler"

    puertos:
      # Celery Flower
      - 5555:5555
      # Servidor web de Airflow
      - 8080:8080

  # Trabajador de Celery, se escalará usando `--scale=n`
  trabajador:
    <<: *airflow-base

    entorno:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint worker"

    depende_de:
      - airflow
      - airflow-db
      - corredor
Notas:
- En la construcción del composito, me basé en gran medida en la conocida imagen – asegúrate de echar un vistazo. Puede que no necesites nada más en la vida.
- Todas las configuraciones de Airflow están disponibles no solo a través de
airflow.cfg, sino también a través de variables de entorno (gracias a los desarrolladores), lo cual utilicé ampliamente. - Naturalmente, no está listo para producción: intencionalmente no configuré heartbeats en los contenedores, ni me preocupé por la seguridad. Pero hice un mínimo adecuado para nuestros experimentos.
- Ten en cuenta que:
- La carpeta de los DAGs debe ser accesible tanto para el programador como para los trabajadores.
- Lo mismo se aplica a todas las bibliotecas externas: todas deben estar instaladas en las máquinas del programador y de los trabajadores.
Y ahora simplemente:
$ docker-compose up --scale worker=3Una vez que todo esté levantado, puedes mirar las interfaces web:
- Airflow:
- Flower:
Conceptos básicos
Si no entendiste nada de todos estos "dags", aquí tienes un breve glosario:
- Scheduler — el tipo más importante en Airflow, que se asegura de que los robots trabajen y no las personas: supervisa el horario, actualiza los dags, inicia las tareas.
En general, en las versiones antiguas, tenía problemas de memoria (no, no amnesia, sino fugas) y en las configuraciones incluso quedó un parámetro legado
run_duration— el intervalo de su reinicio. Pero ahora todo está bien. - DAG (también conocido como "dag") — "grafico acíclico dirigido", pero esa definición poco dirá a muchos, y en esencia es un contenedor para tareas que interactúan entre sí (ver abajo) o el equivalente a Package en SSIS y Workflow en Informatica.
Además de los dags, también pueden haber subdags, pero probablemente no llegaremos a ellos.
- DAG Run — un dag inicializado al que se le asigna su
execution_date. Los dag runs de un mismo dag pueden funcionar en paralelo (siempre y cuando, claro, hayas hecho tus tareas idempotentes). - Operator — son fragmentos de código responsables de llevar a cabo una acción específica. Hay tres tipos de operadores:
- acción, como nuestro favorito
PythonOperator, que puede ejecutar cualquier (válido) código Python; - transferencia, que trasladan datos de un lugar a otro, digamos,
MsSqlToHiveTransfer; - sensor también permitirá reaccionar o detener la ejecución del dag hasta que ocurra un evento determinado.
HttpSensorpuede consultar el endpoint especificado, y cuando reciba la respuesta correcta, iniciar la transferenciaGoogleCloudStorageToS3Operator. Una mente curiosa preguntará: "¿por qué? ¡Si se pueden hacer repeticiones directamente en el operador!" Y la razón es para no colapsar el pool de tareas con operadores atascados. El sensor se activa, verifica y muere hasta el próximo intento.
- acción, como nuestro favorito
- Task — los operadores declarados, independientemente del tipo y asignados al dag, se elevan al rango de tarea.
- Task instance — cuando el planificador general decide que es hora de enviar las tareas a los trabajadores ejecutores (en el lugar, si utilizamos
LocalExecutoro en un nodo remoto en el caso deCeleryExecutor), les asigna un contexto (es decir, un conjunto de variables — parámetros de ejecución), despliega las plantillas de comandos o consultas y las agrupa en un pool.
Generamos tareas
Primero vamos a delinear el esquema general de nuestro dag, y luego iremos profundizando en los detalles, porque aplicamos algunas soluciones no triviales.
Así que, en su forma más simple, un dag como este se verá así:
de datetime importar timedelta, datetime

de airflow importar DAG
de airflow.operators.python_operator importar PythonOperator

de commons.datasources importar sql_server_ds

dag = DAG('orders',
          schedule_interval=timedelta(hours=6),
          start_date=datetime(2020, 7, 8, 0))

def workflow(**context):
    print(context)

for conn_id, schema in sql_server_ds:
    PythonOperator(
        task_id=schema,
        python_callable=workflow,
        provide_context=True,
        dag=dag)
Vamos a analizar:
- Primero, importamos las bibliotecas necesarias y algo más;
sql_server_ds— esList[namedtuple[str, str]]con los nombres de las conexiones de Airflow y las bases de datos de las que vamos a tomar nuestra tabla;dages la declaración de nuestro DAG, que necesariamente debe estar englobals(), de lo contrario, Airflow no lo encontrará. También necesitamos decirle a nuestro DAG:- cómo se llama
orderseste nombre aparecerá en la interfaz web, - que comenzará a funcionar a partir de la medianoche del ocho de julio,
- y debe ejecutarse aproximadamente cada 6 horas (para los chicos geniales, aquí en lugar de
timedelta()se permitecronuna cadena0 0 0/6 ? * * *, para los menos geniales, una expresión como@daily);
- cómo se llama
workflow()realizará el trabajo principal, pero no ahora. Por ahora, simplemente volcaremos nuestro contexto en el registro.- Y ahora, la simple magia de crear tareas:
- recorremos nuestras fuentes;
- inicializamos
PythonOperator, que ejecutará nuestra plantilla vacíaworkflow(). No olvides especificar un nombre único (dentro del DAG) para la tarea y vincular el propio DAG. La banderaprovide_contexten sí misma pasará a la función argumentos adicionales que recogemos cuidadosamente con**context.
Por ahora, esto es todo. ¿Qué hemos obtenido?
- un nuevo DAG en la interfaz web,
- ciento cincuenta tareas que se ejecutarán en paralelo (si las configuraciones de Airflow, Celery y la potencia de los servidores lo permiten).
Bueno, casi lo hemos obtenido.
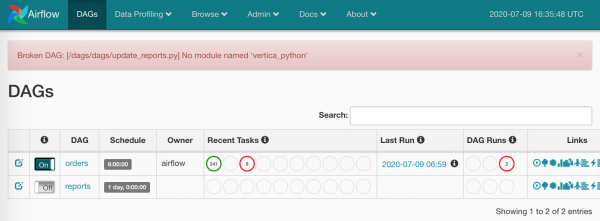
¿Quién establecerá las dependencias?
Para simplificar todo esto, lo incluí en docker-compose.yml el manejo requirements.txt en todos los nodos.
Ahora sí, ¡empecemos!
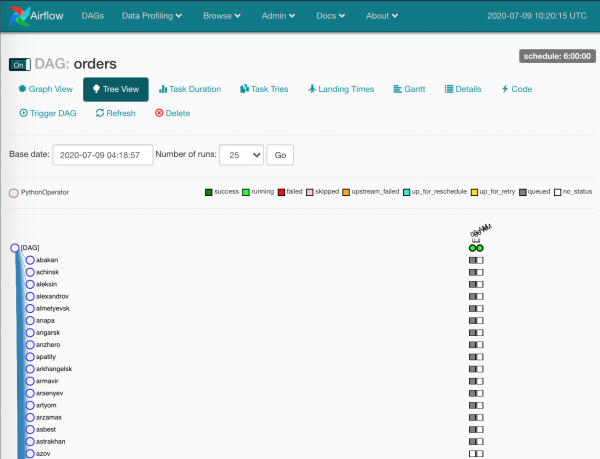
Los cuadros grises son instancias de tareas, procesadas por el planificador.
Esperamos un poco, las tareas son recogidas por los trabajadores:
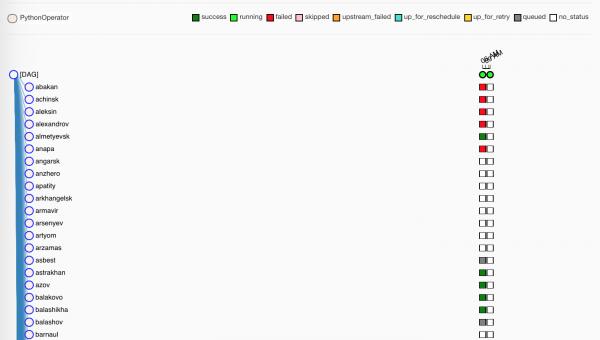
Los verdes, como es obvio, son los que se han completado con éxito. Los rojos no tan exitosamente.
Por cierto, en nuestra producción no hay ninguna carpeta,
./dagssincronizándose entre máquinas — todos los DAGs están engitnuestro Gitlab, y Gitlab CI despliega actualizaciones en las máquinas al hacer merge enmaster.
Un poco sobre Flower
Mientras los trabajadores procesan nuestras tareas vacías, recordemos otra herramienta que puede mostrarnos algo — Flower.
La primera página con información sumaria sobre los nodos-trabajadores:
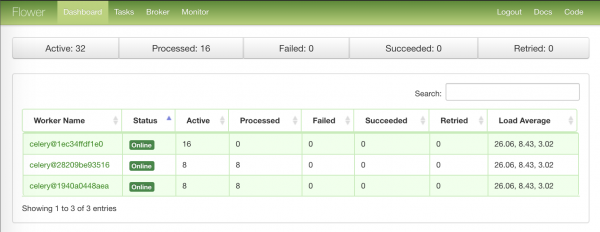
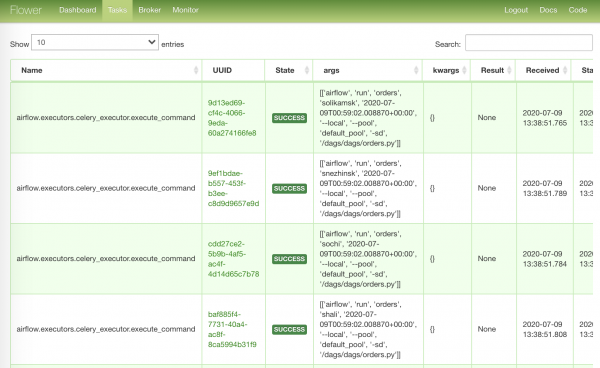
La página más completa con las tareas que se han enviado para su ejecución:
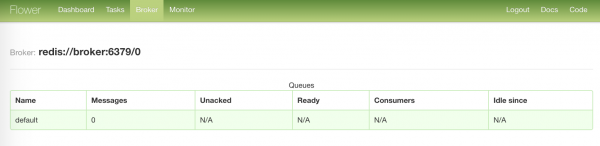
La página más aburrida con el estado de nuestro broker:
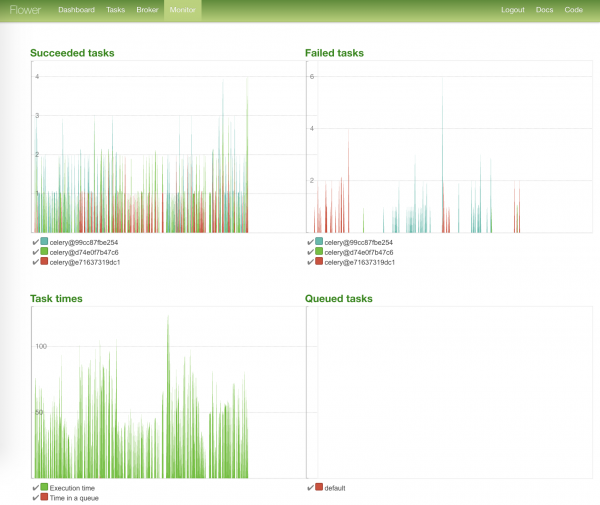
La página más vibrante: gráficos del estado de las tareas y su tiempo de ejecución:
Cargando lo que no se cargó
Entonces, todas las tareas han sido procesadas, ahora podemos llevar a los heridos.
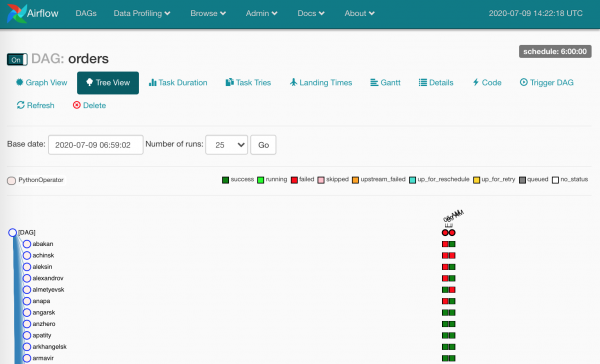
Resulta que hay muchos heridos, por diversas razones. En caso de utilizar Airflow correctamente, estos cuadros indican que los datos definitivamente no llegaron.
Es necesario revisar el registro y reiniciar las instancias de tarea que hayan fallado.
Al hacer clic en cualquier cuadro, veremos las acciones disponibles para nosotros:
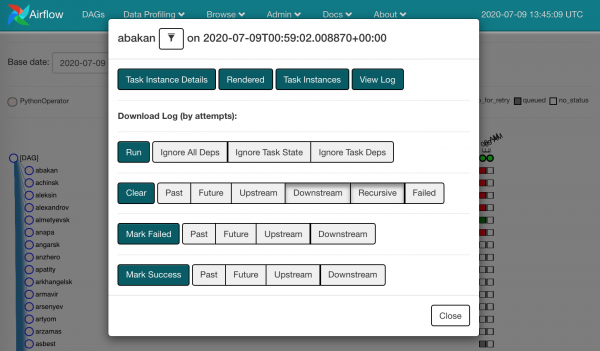
Podemos optar por hacer un Clear a lo que ha fallado. Es decir, olvidamos que algo se ha estancado, y la misma instancia de tarea volverá al planificador.
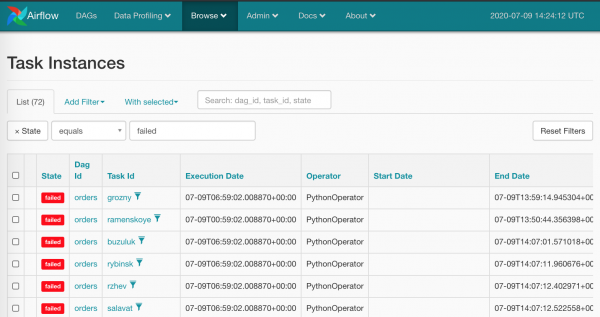
Es evidente que hacer esto con el ratón para todos los cuadros rojos no es muy humano — no es eso lo que esperamos de Airflow. Por supuesto, tenemos un arma de destrucción masiva: Browse/Task Instances
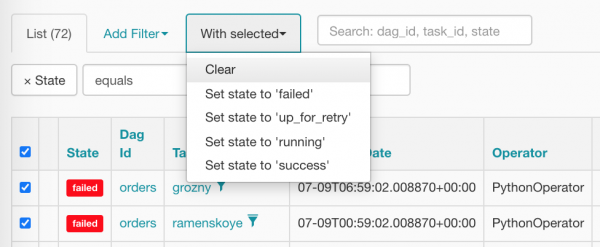
Seleccionemos todo de una vez y reiniciemos presionando la opción correcta:
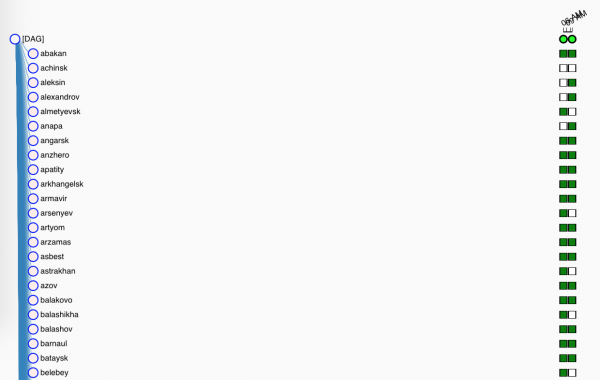
Después de limpiar, nuestras tareas lucen así (ya están esperando ansiosamente que el programador las planifique):
Conexiones, hooks y otras variables
Es el momento perfecto para mirar el siguiente DAG, update_reports.py:
from collections import namedtuple
from datetime import datetime, timedelta
from textwrap import dedent

from airflow import DAG
from airflow.contrib.operators.vertica_operator import VerticaOperator
from airflow.operators.email_operator import EmailOperator
from airflow.utils.trigger_rule import TriggerRule

from commons.operators import TelegramBotSendMessage

dag = DAG('update_reports',
          start_date=datetime(2020, 6, 7, 6),
          schedule_interval=timedelta(days=1),
          default_args={'retries': 3, 'retry_delay': timedelta(seconds=10)})

Report = namedtuple('Report', 'source target')
reports = [Report(f'{table}_view', table) for table in [
    'reports.city_orders',
    'reports.client_calls',
    'reports.client_rates',
    'reports.daily_orders',
    'reports.order_duration']]

email = EmailOperator(
    task_id='email_success', dag=dag,
    to='{{ var.value.all_the_kings_men }}',
    subject='DWH Reports updated',
    html_content=dedent("""Estimados, los informes han sido actualizados"""),
    trigger_rule=TriggerRule.ALL_SUCCESS)

tg = TelegramBotSendMessage(
    task_id='telegram_fail', dag=dag,
    tg_bot_conn_id='tg_main',
    chat_id='{{ var.value.failures_chat }}',
    message=dedent("""
         Natasha, despierta, hemos caído con {{ dag.dag_id }}
        """),
    trigger_rule=TriggerRule.ONE_FAILED)

for source, target in reports:
    queries = [f"TRUNCATE TABLE {target}",
               f"INSERT INTO {target} SELECT * FROM {source}"]

    report_update = VerticaOperator(
        task_id=target.replace('reports.', ''),
        sql=queries, vertica_conn_id='dwh',
        task_concurrency=1, dag=dag)

    report_update >> [email, tg]
¿Acaso no hemos hecho todos alguna vez una actualización de informes? Aquí está de nuevo: hay una lista de fuentes de donde obtener los datos; hay una lista de a dónde colocarlos; no olvidemos avisar cuando todo sucedió o falló (aunque eso no es sobre nosotros, claro).
Repasemos el archivo y veamos las nuevas cosas que no entendemos:
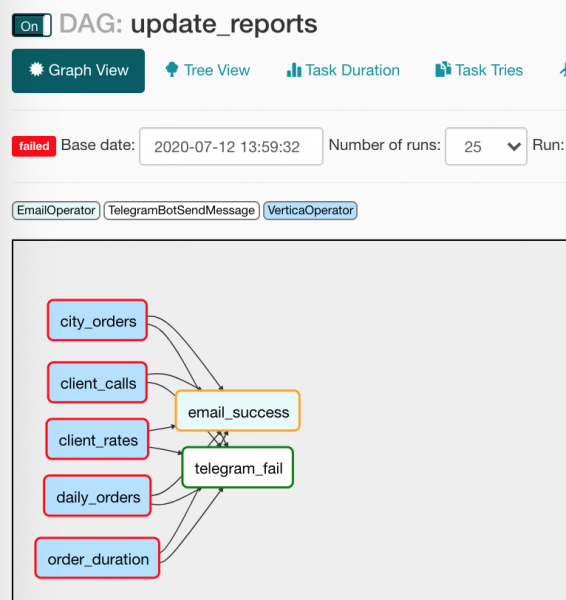
from commons.operators import TelegramBotSendMessage— nada nos impide crear nuestros propios operadores, y así lo hicimos, creando un pequeño envoltorio para enviar mensajes a Desbloqueado. (Sobre este operador hablaremos más adelante);default_args={}— el DAG puede distribuir los mismos argumentos a todos sus operadores;to='{{ var.value.all_the_kings_men }}'— el campoano estará codificado, sino que se generará dinámicamente mediante Jinja y una variable con una lista de correos electrónicos, que cuidé de colocar enAdmin/Variables;trigger_rule=TriggerRule.ALL_SUCCESS— condición de activación del operador. En nuestro caso, el correo se enviará a los jefes solo si todas las dependencias han funcionado con éxito;tg_bot_conn_id='tg_main'— los argumentosconn_idreciben los identificadores de conexión que creamos enAdmin/Connections;trigger_rule=TriggerRule.ONE_FAILED— los mensajes en Telegram solo se enviarán si hay tareas fallidas;task_concurrency=1— prohibimos el lanzamiento simultáneo de varias instancias de tarea de una misma tarea. De lo contrario, obtendremos el lanzamiento simultáneo de variasVerticaOperator(observando una tabla);report_update >> [email, tg]— todoVerticaOperatorse unirá en el envío del correo y el mensaje, así es como:

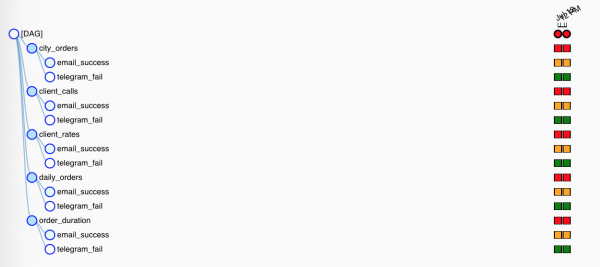
Pero, dado que los operadores de notificación tienen diferentes condiciones de activación, solo uno funcionará. En Tree View, se ve un poco menos claro:

Diré un par de palabras sobre los macros y sus amigos — de variables.
Los macros son marcadores de posición de Jinja que pueden insertar información útil en los argumentos de los operadores. Por ejemplo, así:
SELECT
    id,
    payment_dtm,
    payment_type,
    client_id
FROM orders.payments
WHERE
    payment_dtm::DATE = '{{ ds }}'::DATE
{{ ds }} se desplegará en el contenido de la variable de contexto execution_date en el formato YYYY-MM-DD: 2020-07-14. Lo mejor es que las variables de contexto se vinculan a una instancia específica de la tarea (un pequeño cuadrado en Tree View), y al reiniciar, los marcadores de posición se revelarán con los mismos valores.
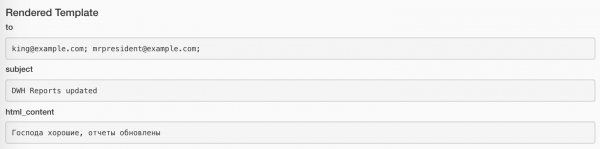
Los valores asignados se pueden ver usando el botón Rendered en cada instancia de tarea. Así es como se ve en la tarea de envío de correo:
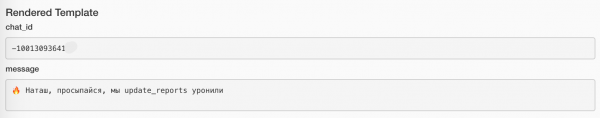
Y así en la tarea de envío de mensajes:
La lista completa de macros integradas para la última versión disponible se puede encontrar aquí:
Además, con los plugins, podemos declarar nuestras propias macros, pero esa es otra historia.
Además de los elementos predefinidos, podemos insertar valores de nuestras variables (ya he utilizado esto anteriormente en el código). Vamos a crear en Admin/Variables un par de elementos:
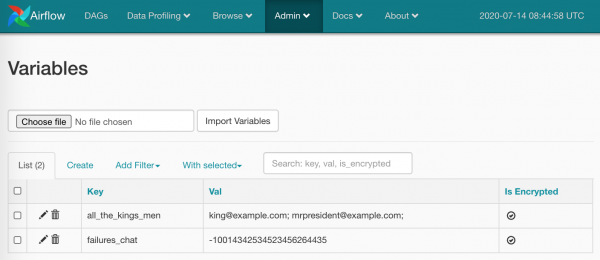
Listo, se puede usar:
TelegramBotSendMessage(chat_id='{{ var.value.failures_chat }}')El valor puede ser un escalar o también puede ser JSON. En el caso de JSON:
bot_config

{
    "bot": {
        "token": 881hskdfASDA16641,
        "name": "Verter"
    },
    "service": "TG"
}
solo usamos la ruta a la clave necesaria: {{ var.json.bot_config.bot.token }}.
Diré una sola palabra y mostraré una captura de pantalla sobre conexiones. Aquí es bastante simple: en la página Admin/Connections creamos la conexión, ponemos nuestros nombres de usuario/contraseñas y parámetros más específicos. Así es:
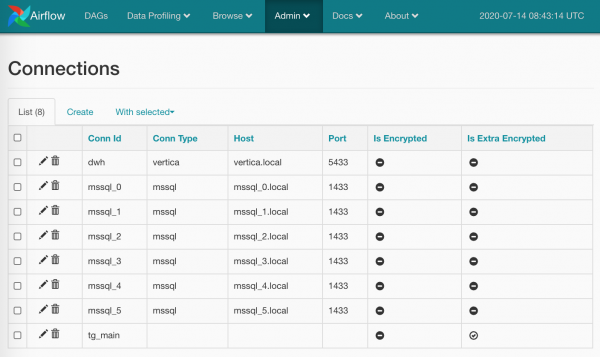
Las contraseñas se pueden cifrar (más rigurosamente que en la variante predeterminada), o se puede no especificar el tipo de conexión (como hice para tg_main) — el hecho es que la lista de tipos está embebida en los modelos de Airflow y no se puede expandir sin tocar el código fuente (si de repente no lo busqué bien, pido que me corrijan), pero obtener credenciales simplemente por el nombre no nos impedirá nada.
Además, se pueden hacer varias conexiones con el mismo nombre: en tal caso, el método BaseHook.get_connection(), que nos obtiene conexiones por nombre, devolverá uno aleatorio de varios iguales (sería más lógico hacer un Round Robin, pero dejémoslo en manos de los desarrolladores de Airflow).
Las Variables y Conexiones son, sin duda, herramientas geniales, pero es importante no perder el equilibrio: qué partes de tus flujos almacenas en el código y cuáles dejas en el almacenamiento de Airflow. Por un lado, cambiar rápidamente un valor, por ejemplo, el buzón de envío, puede ser conveniente a través de la interfaz. Pero, por otro lado, es un regreso a hacer clic con el ratón, del cual queríamos deshacernos.
Trabajar con conexiones es una de las tareas ganchos. En general, los hooks de Airflow son puntos de conexión a servicios y bibliotecas externas. Por ejemplo, JiraHook nos abrirá un cliente para interactuar con Jira (se pueden mover tareas de aquí para allá), y con SambaHook se puede enviar un archivo local a un punto smb.Y estamos cerca de ver cómo está hecho
Desglosando un operador personalizado
TelegramBotSendMessage commons/operators.py
Código con el operador: con el propio operador:
de typing import Union

de airflow.operators import BaseOperator

de commons.hooks import TelegramBotHook, TelegramBot

class TelegramBotSendMessage(BaseOperator):
    """Envía un mensaje a chat_id usando TelegramBotHook

    Ejemplo:
        >>> TelegramBotSendMessage(
        ...     task_id='telegram_fail', dag=dag,
        ...     tg_bot_conn_id='tg_bot_default',
        ...     chat_id='{{ var.value.all_the_young_dudes_chat }}',
        ...     message='{{ dag.dag_id }} falló :(',
        ...     trigger_rule=TriggerRule.ONE_FAILED)
    """
    template_fields = ['chat_id', 'message']

    def __init__(self,
                 chat_id: Union[int, str],
                 message: str,
                 tg_bot_conn_id: str = 'tg_bot_default',
                 *args, **kwargs):
        super().__init__(*args, **kwargs)

        self._hook = TelegramBotHook(tg_bot_conn_id)
        self.client: TelegramBot = self._hook.client
        self.chat_id = chat_id
        self.message = message

    def execute(self, context):
        print(f'Enviar "{self.message}" al chat {self.chat_id}')
        self.client.send_message(chat_id=self.chat_id,
                                 message=self.message)
Aquí, al igual que el resto en Airflow, todo es muy sencillo:
- Heredamos de
BaseOperator, que implementa muchas cosas específicas de Airflow (mira con calma) - Declaramos los campos
template_fields, en los que Jinja buscará macros para su procesamiento. - Organizamos los argumentos correctos para
__init__(), colocando valores predeterminados donde es necesario. - No olvidamos la inicialización del ancestro.
- Abrimos el hook correspondiente
TelegramBotHook, obteniendo de él el objeto cliente. - Sobreescribimos (redefinimos) el método
BaseOperator.execute(), que Airflow llamará cuando sea el momento de ejecutar el operador — en él implementamos la acción principal, sin olvidarnos de registrar. (Nos registramos, por cierto, directamente enstdoutystderr— Airflow interceptará todo, lo envolverá cuidadosamente y lo organizará donde sea necesario.)
Veamos qué tenemos en commons/hooks.py. La primera parte del archivo, con el hook mismo:
de typing import Union

de airflow.hooks.base_hook import BaseHook

de requests_toolbelt.sessions import BaseUrlSession

class TelegramBotHook(BaseHook):
    """Hook de la API de Telegram Bot

    Nota: añade una conexión con un tipo de conexión vacío y no olvides
    completar Extra:

        {"bot_token": "YOuRAwEsomeBOtToKen"}
    """
    def __init__(self,
                 tg_bot_conn_id='tg_bot_default'):
        super().__init__(tg_bot_conn_id)

        self.tg_bot_conn_id = tg_bot_conn_id
        self.tg_bot_token = None
        self.client = None
        self.get_conn()

    def get_conn(self):
        extra = self.get_connection(self.tg_bot_conn_id).extra_dejson
        self.tg_bot_token = extra['bot_token']
        self.client = TelegramBot(self.tg_bot_token)
        return self.client
Ni siquiera sé qué se puede explicar aquí, solo señalaré puntos importantes:
- Heredamos, pensamos en los argumentos — en la mayoría de casos será uno solo:
conn_id; - Sobreescribimos los métodos estándar: me limité a
get_conn(), donde obtengo los parámetros de conexión por nombre y simplemente extraigo la secciónextra(este campo es para JSON), donde coloqué el token del bot de Telegram (según mis instrucciones):{"bot_token": "YOuRAwEsomeBOtToKen"}. - Creando una instancia de nuestro
TelegramBot, dándole ya un token específico.
Eso es todo. Se puede obtener el cliente desde el hook utilizando TelegramBotHook().clent o TelegramBotHook().get_conn().
Y la segunda parte del archivo, donde realizo un microenvoltorio para la API REST de Telegram, para no cargar el mismo solo para un método sendMessage.
class TelegramBot:
    """Envoltorio de la API del Bot de Telegram

    Ejemplos:
        >>> TelegramBot('YOuRAwEsomeBOtToKen', '@myprettydebugchat').send_message('Hola, querido')
        >>> TelegramBot('YOuRAwEsomeBOtToKen').send_message('Hola, querido', chat_id=-1762374628374)
    """
    API_ENDPOINT = 'https://api.telegram.org/bot{}/'

    def __init__(self, tg_bot_token: str, chat_id: Union[int, str] = None):
        self._base_url = TelegramBot.API_ENDPOINT.format(tg_bot_token)
        self.session = BaseUrlSession(self._base_url)
        self.chat_id = chat_id

    def send_message(self, message: str, chat_id: Union[int, str] = None):
        method = 'sendMessage'

        payload = {'chat_id': chat_id or self.chat_id,
                   'text': message,
                   'parse_mode': 'MarkdownV2'}

        response = self.session.post(method, data=payload).json()
        if not response.get('ok'):
            raise TelegramBotException(response)

class TelegramBotException(Exception):
    def __init__(self, *args, **kwargs):
        super().__init__((args, kwargs))
La forma correcta es juntar todo esto:
commons/operators.py,TelegramBotHook,TelegramBot— en un plugin, subirlo a un repositorio público y liberarlo como Open Source.
Mientras estudiábamos todo esto, nuestras actualizaciones de informes lograron colapsar exitosamente y me enviaron un mensaje de error en el canal. Iré a verificar qué está mal de nuevo...
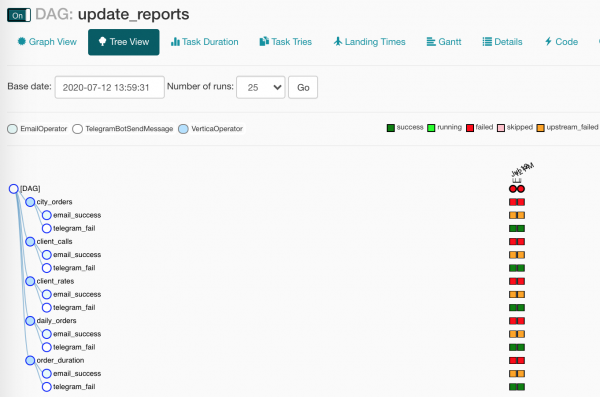
¡Algo se rompió en nuestro DAG! ¿Y no es esto lo que esperábamos? ¡Exactamente!
¿Vas a servir?
¿Sientes que me he saltado algo? Se suponía que iba a transferir los datos de SQL Server a Vertica, y aquí me desvío del tema, ¡ladrón!
Este desliz fue intencional; simplemente tenía que explicarte cierta terminología. Ahora podemos continuar.
Nuestro plan era el siguiente:
- Crear el DAG
- Generar tareas
- Ver cómo todo se ve bonito
- Asignar números de sesión a las cargas
- Recoger datos de SQL Server
- Colocar datos en Vertica
- Recopilar estadísticas
Así que, para poner todo esto en marcha, hice una pequeña adición a nuestro docker-compose.yml:
docker-compose.db.yml
versión: '3.4'

x-mssql-base: &mssql-base
  imagen: mcr.microsoft.com/mssql/server:2017-CU21-ubuntu-16.04
  reiniciar: siempre
  entorno:
    ACEPTAR_EULA: Y
    MSSQL_PID: Express
    SA_PASSWORD: SayThanksToSatiaAt2020
    MSSQL_MEMORY_LIMIT_MB: 1024

servicios:
  dwh:
    imagen: jbfavre/vertica:9.2.0-7_ubuntu-16.04

  mssql_0:
    <<: *mssql-base

  mssql_1:
    <<: *mssql-base

  mssql_2:
    <<: *mssql-base

  mssql_init:
    imagen: mio101/py3-sql-db-client-base
    comando: python3 ./mssql_init.py
    depends_on:
      - mssql_0
      - mssql_1
      - mssql_2
    entorno:
      SA_PASSWORD: SayThanksToSatiaAt2020
    volúmenes:
      - ./mssql_init.py:/mssql_init.py
      - ./dags/commons/datasources.py:/commons/datasources.py
Allí levantamos:
- Vertica como anfitrión
dwhcon la configuración predeterminada más básica, - tres instancias de SQL Server,
- llenamos las bases con algunos datos recientes (por favor, no mires en
mssql_init.py!)
Iniciamos todo con un comando algo más complejo que la vez pasada:
$ docker-compose -f docker-compose.yml -f docker-compose.db.yml up --scale worker=3Lo que generó nuestro maravilloso generador aleatorio se puede consultar usando la opción Data Profiling/Ad Hoc Query:
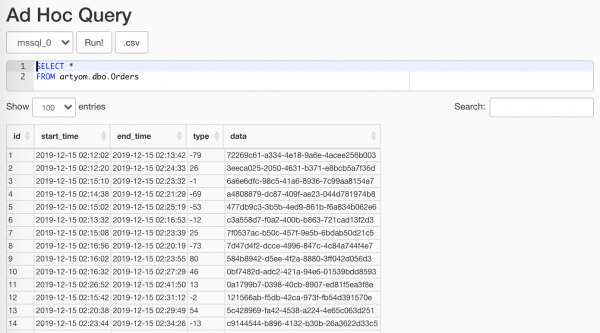
Lo más importante es no mostrarlo a los analistas
No voy a detenerme en detalles sobre sesiones ETL es trivial: hacemos la base, creamos una tabla, lo envolvemos todo en un gestor de contexto, y ahora hacemos lo siguiente:
with Session(task_name) as session:
    print('Carga', session.id, 'comenzada')

    # Cargar flujo de trabajo
    ...

    session.successful = True
    session.loaded_rows = 15
session.py
de sys import stderr

class Session:
    """Sesión del flujo de trabajo ETL

    Ejemplo:
        con Session(task_name) como session:
            print(session.id)
            session.successful = True
            session.loaded_rows = 15
            session.comment = 'Bien hecho'
    """

    def __init__(self, connection, task_name):
        self.connection = connection
        self.connection.autocommit = True

        self._task_name = task_name
        self._id = None

        self.loaded_rows = None
        self.successful = None
        self.comment = None

    def __enter__(self):
        return self.open()

    def __exit__(self, exc_type, exc_val, exc_tb):
        if any(exc_type, exc_val, exc_tb):
            self.successful = False
            self.comment = f'{exc_type}: {exc_val}n{exc_tb}'
            print(exc_type, exc_val, exc_tb, file=stderr)
        self.close()

    def __repr__(self):
        return (f'')

    @property
    def task_name(self):
        return self._task_name

    @property
    def id(self):
        return self._id

    def _execute(self, query, *args):
        with self.connection.cursor() as cursor:
            cursor.execute(query, args)
            return cursor.fetchone()[0]

    def _create(self):
        query = """
            CREATE TABLE IF NOT EXISTS sessions (
                id          SERIAL       NOT NULL PRIMARY KEY,
                task_name   VARCHAR(200) NOT NULL,

                started     TIMESTAMPTZ  NOT NULL DEFAULT current_timestamp,
                finished    TIMESTAMPTZ           DEFAULT current_timestamp,
                successful  BOOL,

                loaded_rows INT,
                comment     VARCHAR(500)
            );
            """
        self._execute(query)

    def open(self):
        query = """
            INSERT INTO sessions (task_name, finished)
            VALUES (%s, NULL)
            RETURNING id;
            """
        self._id = self._execute(query, self.task_name)
        print(self, 'abierto')
        return self

    def close(self):
        if not self._id:
            raise SessionClosedError('La sesión no está abierta')
        query = """
            UPDATE sessions
            SET
                finished    = DEFAULT,
                successful  = %s,
                loaded_rows = %s,
                comment     = %s
            WHERE
                id = %s
            RETURNING id;
            """
        self._execute(query, self.successful, self.loaded_rows,
                      self.comment, self.id)
        print(self, 'cerrado',
              ', exitoso: ', self.successful,
              ', Cargado: ', self.loaded_rows,
              ', comentario:', self.comment)

class SessionError(Exception):
    pass

class SessionClosedError(SessionError):
    pass
Ha llegado el momento de recuperar nuestros datos de nuestras más de ciento cincuenta tablas. Vamos a hacerlo con unas líneas muy sencillas:
source_conn = MsSqlHook(mssql_conn_id=src_conn_id, schema=src_schema).get_conn()

query = f"""
    SELECT
        id, start_time, end_time, type, data
    FROM dbo.Orders
    WHERE
        CONVERT(DATE, start_time) = '{dt}'
    """

df = pd.read_sql_query(query, source_conn)- Con la ayuda de un gancho vamos a obtener de Airflow
pymssql-conexión - En la consulta vamos a introducir una limitación en forma de fecha — el template la colocará.
- Alimentamos nuestra consulta
pandas, que obtendrá para nosotrosDataFrame— nos será útil más adelante.
Utilizo la sustitución
{dt}en lugar del parámetro de la consulta%sno porque sea un malvado Pinocho, sino porquepandasno puede lidiar conpymssqly se lo pasa al últimoparams: Lista, aunque realmente lo deseatupla.
También nota que el desarrolladorpymssqldecidió dejar de soportarlo, y es momento de mudarse apyodbc.
Veamos qué argumentos ha inyectado Airflow en nuestras funciones:
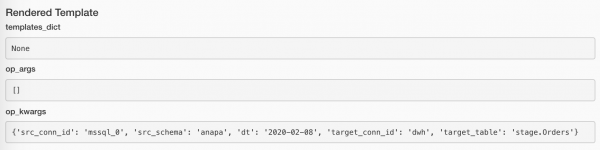
Si no hay datos, no tiene sentido continuar. Pero también es extraño considerar que la carga fue exitosa. Pero eso no es un error. ¡Ah, qué hacer?! Esto es lo que:
if df.empty:
    raise AirflowSkipException('No hay filas para cargar')
AirflowSkipException dirá Airflow que, en realidad, no hay errores, y que estamos omitiendo la tarea. En la interfaz no habrá un cuadrado verde ni rojo, sino del color rosa.
Agregaremos a nuestros datos varias columnas:
df['etl_source'] = src_schema
df['etl_id'] = session.id
df['hash_id'] = hash_pandas_object(df[['etl_source', 'id']])
Es decir:
- La base de datos de la que obtuvimos los pedidos,
- El identificador de nuestra sesión de carga (será diferente para cada tarea),
- El hash de la fuente y del identificador del pedido — para que en la base de datos final (donde todo se fusionará en una tabla) tengamos un identificador único del pedido.
Queda el penúltimo paso: cargar todo en Vertica. Y, curiosamente, una de las maneras más efectivas de hacerlo es a través de CSV.
# Export data to CSV buffer
buffer = StringIO()
df.to_csv(buffer,
          index=False, sep='|', na_rep='NUL', quoting=csv.QUOTE_MINIMAL,
          header=False, float_format='%.8f', doublequote=False, escapechar='\')
buffer.seek(0)

# Push CSV
target_conn = VerticaHook(vertica_conn_id=target_conn_id).get_conn()

copy_stmt = f"""
    COPY {target_table}({df.columns.to_list()})
    FROM STDIN
    DELIMITER '|'
    ENCLOSED '"'
    ABORT ON ERROR
    NULL 'NUL'
    """

cursor = target_conn.cursor()
cursor.copy(copy_stmt, buffer)- Creamos un receptor especial
StringIO. pandasque amablemente almacenará nuestroDataFrameen forma deCSV-filas.- Abriremos una conexión a nuestra querida Vertica a través del hook.
- Y ahora, con la ayuda de
copy()enviamos nuestros datos directamente a Vertica!
Recogemos del controlador cuántas filas se han cargado y le comunicamos al gerente de sesión que todo está OK:
session.loaded_rows = cursor.rowcount
session.successful = True
Y eso es todo.
En producción, creamos la tabla de destino manualmente. Aquí me permití un pequeño automatismo:
create_schema_query = f'CREATE SCHEMA IF NOT EXISTS {target_schema};'
create_table_query = f"""
    CREATE TABLE IF NOT EXISTS {target_schema}.{target_table} (
         id         INT,
         start_time TIMESTAMP,
         end_time   TIMESTAMP,
         type       INT,
         data       VARCHAR(32),
         etl_source VARCHAR(200),
         etl_id     INT,
         hash_id    INT PRIMARY KEY
     );"""

create_table = VerticaOperator(
    task_id='create_target',
    sql=[create_schema_query,
         create_table_query],
    vertica_conn_id=target_conn_id,
    task_concurrency=1,
    dag=dag)
Con la ayuda de
VerticaOperator()creo el esquema de la base de datos y la tabla (si aún no existen, por supuesto). Lo principal es asignar correctamente las dependencias:
for conn_id, schema in sql_server_ds:
    load = PythonOperator(
        task_id=schema,
        python_callable=workflow,
        op_kwargs={
            'src_conn_id': conn_id,
            'src_schema': schema,
            'dt': '{{ ds }}',
            'target_conn_id': target_conn_id,
            'target_table': f'{target_schema}.{target_table}'},
        dag=dag)

    create_table >> load
Resumen
— Bien, — dijo el ratón, — ¿no es cierto que ahora?
¿Te has dado cuenta de que en el bosque soy la bestia más temible?
Julia Donaldson, «El Gruffalo»
Creo que si mis colegas hicieran una competencia sobre quién puede crear y lanzar un proceso ETL desde cero más rápido: ellos con sus SSIS y su ratón y yo con Airflow... Y luego compararíamos la facilidad de mantenimiento... ¡Uff, creo que estarías de acuerdo en que les superaría en todos los aspectos!
Si vamos a ser un poco más serios, Apache Airflow, gracias a la descripción de procesos en forma de código, ha facilitado mi trabajo mucho más cómodo y agradable.
Su ilimitada extensibilidad: tanto en términos de complementos como de escalabilidad, te permite aplicar Airflow prácticamente en cualquier campo: ya sea en todo el ciclo de recolección, preparación y procesamiento de datos, o en el lanzamiento de cohetes (a Marte, por supuesto).
Parte final, informativa y de referencia
Los obstáculos que hemos reunido para ti
start_date. Sí, ya es un meme local. A través del argumento principal del DAGstart_datepasan todos. En resumen, si se indica enstart_datela fecha actual, y enschedule_interval— un día, el DAG se ejecutará mañana, no antes.start_date = datetime(2020, 7, 7, 0, 1, 2)Y no habrá más problemas.
También hay un error de ejecución relacionado:
Task is missing the start_date parameter, que a menudo indica que olvidaste asociar el operador al DAG.- Todo en una sola máquina. Sí, y las bases de datos (tanto las de Airflow como nuestra capa), el servidor web, el planificador y los trabajadores. Y funcionaba incluso. Pero con el tiempo, la cantidad de tareas en los servicios creció, y cuando PostgreSQL empezó a dar respuesta por índice en 20 ms en lugar de 5 ms, lo movimos.
- LocalExecutor. Sí, todavía estamos en él, y ya nos hemos acercado al borde del abismo. LocalExecutor aún nos era suficiente, pero ahora ha llegado el momento de expandirse al menos con un trabajador más, y tendremos que esforzarnos para mudarnos a CeleryExecutor. Dado que se puede trabajar con él incluso en una sola máquina, nada impide usar Celery incluso en un servidor que «naturalmente, nunca irá a producción, ¡te lo prometo!»
- No usar los recursos integrados:
- Connections para almacenar credenciales de servicios,
- SLA Misses para reaccionar a tareas que no se completaron a tiempo,
- XCom para intercambiar metadatos (dije metadatos!) entre las tareas del DAG.) entre tareas del DAG.
- Abuso del correo. ¿Qué se puede decir al respecto? Se configuraron alertas para todas las repeticiones de tareas caídas. Ahora en mi Gmail de trabajo hay más de 90,000 correos de Airflow, y la interfaz web de correo se niega a recibir y eliminar más de 100 a la vez.
Más escollos:
Herramientas para una mayor automatización
Para que podamos trabajar más con la mente y no con las manos, Airflow nos ha preparado lo siguiente:
- — todavía tiene el estado de Experimental, lo que no impide su funcionamiento. Con él se puede no solo obtener información sobre DAGs y tareas, sino también detener/iniciar un DAG, crear un DAG Run o un pool.
- — hay muchas herramientas disponibles a través de la línea de comandos que no solo son incómodas de usar a través de la WebUI, sino que en realidad están ausentes. Por ejemplo:
backfillse necesita para reiniciar instancias de tareas.
Por ejemplo, llegan los analistas y dicen: "¡Oye, hay un problema en los datos del 1 al 13 de enero! ¡Repara, repara, repara, repara!". Y tú dices:airflow backfill -s '2020-01-01' -e '2020-01-13' orders- Mantenimiento de la base:
initdb,resetdb,upgradedb,checkdb. run, que permite ejecutar una sola instancia de tarea, además de ignorar todas las dependencias. Además, se puede ejecutar a través deLocalExecutor, incluso si tienes un clúster de Celery.- Más o menos lo mismo hace
test, solo que tampoco escribe nada en la base. connectionspermite crear múltiples conexiones desde la consola.
- — es una forma bastante dura de interactuar, destinada a plugins, no a juguetear manualmente. Pero, ¿quién nos impide ir a
/home/airflow/dags, ejecutaripythony comenzar a experimentar? Por ejemplo, se pueden exportar todas las conexiones con este código:from airflow import settings from airflow.models import Connection fields = 'conn_id conn_type host port schema login password extra'.split() session = settings.Session() for conn in session.query(Connection).order_by(Connection.conn_id): d = {field: getattr(conn, field) for field in fields} print(conn.conn_id, '=', d) - Conexión a la base de datos de metadatos de Airflow. No recomiendo escribir en ella, pero obtener estados de tareas para diversas métricas específicas puede hacerse mucho más rápido y fácil que a través de cualquiera de las API.
Digamos que no todas nuestras tareas son idempotentes, y a veces pueden fallar y eso es normal. Pero unos cuantos fallos son sospechosos y sería bueno revisar.
¡Cuidado, SQL!
CON LAST_EXECUTIONS COMO (
SELECCIONAR
    TASK_ID,
    DAG_ID,
    EXECUTION_DATE,
    STATE,
        ROW_NUMBER()
        OVER (
            PARTITION BY TASK_ID, DAG_ID
            ORDER BY EXECUTION_DATE DESC) COMO RN
DE PUBLIC.TASK_INSTANCE
DONDE
    EXECUTION_DATE > AHORA() - INTERVALO '2' DÍAS
),
FALLIDOS COMO (
    SELECCIONAR
        TASK_ID,
        DAG_ID,
        EXECUTION_DATE,
        STATE,
        CASO CUANDO RN = ROW_NUMBER() OVER (
            PARTITION BY TASK_ID, DAG_ID
            ORDER BY EXECUTION_DATE DESC)
                 ENTONCES VERDADERO FIN COMO LAST_FAIL_SEQ
    DE LAST_EXECUTIONS
    DONDE
        STATE EN ('FALLIDO', 'A_REINTENTAR')
)
SELECCIONAR
    TASK_ID,
    DAG_ID,
    CONTAR(LAST_FAIL_SEQ)                       COMO NO_EXITOSO,
    CONTAR(CASO CUANDO LAST_FAIL_SEQ
        Y STATE = 'FALLIDO' ENTONCES 1 FIN)       COMO FALLIDO,
    CONTAR(CASO CUANDO LAST_FAIL_SEQ
        Y STATE = 'A_REINTENTAR' ENTONCES 1 FIN) COMO A_REINTENTAR
DE FALLIDOS
AGRUPAR POR
    TASK_ID,
    DAG_ID
TENIENDO
    CONTAR(LAST_FAIL_SEQ) > 0
Enlaces
Y, por supuesto, los primeros diez enlaces de los resultados de Google son el contenido de la carpeta Airflow de mis marcadores.
- — por supuesto, hay que empezar por la documentación oficial, pero, ¿quién lee instrucciones?
- — al menos, lea las recomendaciones de los creadores.
- — lo más básico: la interfaz de usuario en imágenes.
- — se describen bien los conceptos básicos, en caso de que (¡por si acaso!) no haya entendido algo de lo que digo.
- — una breve guía sobre cómo configurar un clúster de Airflow.
- — un artículo casi igual de interesante, aunque con más formalismo y menos ejemplos.
- — sobre el trabajo en conjunto con Celery.
- — sobre la idempotencia de las tareas, carga por ID en lugar de fecha, transformaciones, estructura de archivos y otras cosas interesantes.
- — dependencias de tareas y Trigger Rule, que mencioné solo de pasada.
- — cómo superar algunas situaciones de "funciona como se esperaba" en el programador, cargar datos perdidos y priorizar tareas.
- — consultas SQL útiles para los metadatos de Airflow.
- — hay una sección útil sobre cómo crear un sensor personalizado.
- — una breve nota interesante sobre la construcción de una infraestructura en AWS para Ciencia de Datos.
- — errores comunes (cuando alguien, de todos modos, no lee las instrucciones).
- — sonríe, cómo la gente improvisa el almacenamiento de contraseñas, aunque se podría usar simplemente Connections.
- — el paso implícito del DAG, el paso del contexto en funciones, nuevamente sobre dependencias, y también sobre omisión de ejecuciones de tareas.
- — sobre el uso de
argumentos por defectoyparamsen plantillas, así como sobre Variables y Conexiones. - — una historia sobre cómo se prepara el programador para Airflow 2.0.
- — un artículo algo desactualizado sobre el despliegue de nuestro clúster en
docker-compose. - — tareas dinámicas utilizando plantillas y paso de contexto.
- — notificaciones estándar y personalizadas por correo y Slack.
- — ramificaciones de tareas, macros y XCom.
Y los enlaces utilizados en el artículo:
- — placeholders disponibles para su uso en las plantillas.
- — Errores comunes al crear DAGs.
- —
docker-composepara experimentos, depuración y más. - — wrapper de Python para la API REST de Telegram.
Fuente: habr.com
