

Probablemente, no es un secreto para nadie que el año pasado fue un año de grandes cambios para Apache Hadoop. El año pasado, se produjo la fusión de Cloudera y Hortonworks (prácticamente, la adquisición de la segunda), y Mapr, debido a serios problemas financieros, fue vendido a Hewlett Packard. Si hace unos años la elección en caso de instalaciones on-premises recaía a menudo entre Cloudera y Hortonworks, hoy, lamentablemente, no tenemos esa opción. Un sorpresa también fue el hecho de que Cloudera anunció en febrero de este año el cese de la publicación de versiones binarias de su distribución en el repositorio público, y ahora solo están disponibles mediante suscripción de pago. Por supuesto, todavía es posible descargar las últimas versiones de CDH y HDP, lanzadas hasta finales de 2019, y se prevé su soporte durante uno o dos años. Pero, ¿qué hacer a continuación? Para aquellos que anteriormente pagaron por la suscripción, nada ha cambiado. Y para aquellos que no desean pasar a la versión de pago de la distribución, pero quieren poder recibir nuevas versiones de los componentes del clúster, así como parches y otras actualizaciones, hemos preparado este artículo. En él, analizaremos las posibles opciones para salir de esta situación.
El artículo es más una revisión. No habrá comparación de distribuciones ni análisis detallados de las mismas, tampoco habrá recetas para su instalación y configuración. ¿Qué habrá entonces? Brevemente hablaremos sobre una distribución llamada Arenadata Hadoop, que merece nuestra atención debido a su accesibilidad, lo que hoy en día es una gran rareza. Luego hablaremos sobre Vanilla Hadoop, principalmente sobre cómo se puede 'preparar' con Apache Bigtop. ¿Listos? Entonces, bienvenidos al artículo.
Arenadata Hadoop
Es una distribución completamente nueva y, hasta ahora, poco conocida de desarrollo nacional. Desafortunadamente, en este momento en Habr solo hay información sobre ella. .
Se puede encontrar información más detallada en el sitio oficial. Las últimas versiones de la distribución se basan en Hadoop 3.1.2 para la versión 3, y 2.8.5 para la versión 2.
La información sobre la hoja de ruta se puede encontrar .
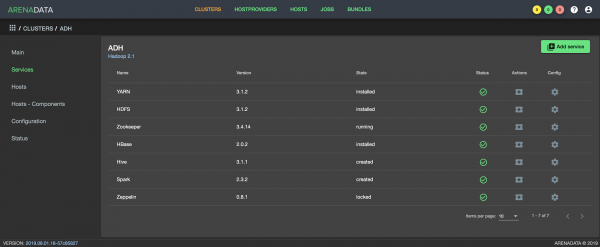
La interfaz de Arenadata Cluster Manager
El producto clave de Arenadata es , que se utiliza para la instalación, configuración y monitorización de diversas soluciones de software de la empresa. ADCM se distribuye de forma gratuita, y su funcionalidad se amplía mediante la adición de bundles, que son conjuntos de ansible-playbooks. Los bundles se dividen en dos tipos: enterprise y community. Los últimos están disponibles para su descarga gratuita desde el sitio de Arenadata. También existe la posibilidad de desarrollar su propio bundle y conectarlo a ADCM.
Para el despliegue y gestión de Hadoop 3 se ofrece una versión community del bundle en combinación con ADCM, mientras que para Hadoop 2 solo hay como alternativa. En cuanto a los repositorios de paquetes, estos están abiertos al acceso público y se pueden descargar e instalar de la manera habitual para todos los componentes del clúster. En general, la distribución se ve bastante interesante. Estoy seguro de que habrá quienes estén acostumbrados a soluciones como Cloudera Manager y Ambari, y que les gustará ADCM. Para algunos, será un gran beneficio el hecho de que la distribución para la sustitución de importaciones.
En cuanto a los inconvenientes, serán los mismos que para todas las demás distribuciones de Hadoop. Es decir:
- El llamado 'vendor lock-in'. A través de ejemplos de Cloudera y Hortonworks, ya hemos comprendido que siempre hay riesgo de cambio en la política de la empresa.
- Un notable retraso respecto al upstream de Apache.
Vanilla Hadoop
Como saben, Hadoop no es un producto monolítico, sino, esencialmente, una serie de servicios alrededor de su sistema de archivos distribuido HDFS. A pocos les bastará con un solo clúster de archivos. Algunos necesitan Hive, otros Presto, y también están HBase y Phoenix, además de que Spark se usa cada vez más. Para la orquestación y carga de datos, a veces se encuentran Oozie, Sqoop y Flume. Y cuando surge la cuestión de la seguridad, inmediatamente se recuerda Kerberos en combinación con Ranger.
Las versiones binarias de los componentes de Hadoop están disponibles en el sitio de cada uno de los proyectos de la ecosistema en forma de tarballs. Se pueden descargar y comenzar la instalación, pero con una condición: además de compilar los paquetes a partir de binarios "crudos", que probablemente querrá hacer, no tendrá ninguna certeza sobre la compatibilidad de las versiones descargadas entre sí. Una opción más preferible es la compilación utilizando Apache Bigtop. Bigtop permitirá realizar la compilación a partir de los repositorios de Maven de Apache, ejecutar pruebas y compilar paquetes. Pero, lo que es muy importante para nosotros, Bigtop compilará las versiones de los componentes que serán compatibles entre sí. Sobre esto hablaremos más en detalle a continuación.
Apache Bigtop
Apache Bigtop es una herramienta para la compilación, empaquetado y prueba de una serie
de proyectos de código abierto, como Hadoop y Greenplum. Bigtop tiene múltiples
lanzamientos. Al momento de escribir este artículo, la última versión estable era la 1.4,
y en master se encontraba la 1.5. En diferentes versiones de lanzamiento se utilizan diferentes versiones
de componentes. Por ejemplo, para 1.4, los componentes clave de Hadoop tienen la versión 2.8.5, mientras que en master
la 2.10.0. También cambia la composición de los componentes soportados. Algo obsoleto y
no actualizado se elimina, y en su lugar entra algo nuevo, más demandado, y
no necesariamente algo del propio ámbito de Apache.
Además, Bigtop tiene múltiples .
Cuando comenzamos a familiarizarnos con Bigtop, lo que nos sorprendió ante todo fue su modesta, en comparación con otros proyectos de Apache, difusión y notoriedad, así como una comunidad muy pequeña. De esto se deduce que la información sobre el producto es escasa y la búsqueda de soluciones a problemas surgidos en foros y listas de correo puede no dar resultados. Inicialmente, nos resultó un desafío completar la compilación del distribuidor debido a las características de la herramienta misma, pero sobre eso hablaremos un poco más adelante.
Como un teaser: aquellos que en su momento disfrutaron de proyectos del universo Linux como Gentoo y LFS, podrían encontrar nostálgicamente agradable trabajar con esta herramienta y recordar aquellos tiempos "legendarios" cuando buscábamos (o incluso escribíamos) ebuilds y recompilábamos con nuevos parches a Mozilla.
Una gran ventaja de Bigtop es su apertura y versatilidad de las herramientas en las que se basa. En su núcleo se encuentran Gradle y Apache Maven. Gradle es bastante conocido como la herramienta que Google utiliza para compilar Android. Es flexible y, como se dice, "probado en el campo". Maven es la herramienta oficial para la compilación de proyectos en Apache, y dado que la mayoría de sus productos se lanzan a través de Maven, no podría faltar aquí. Hay que prestar atención al POM (modelo de objeto del proyecto): un archivo xml "fundamental" que describe todo lo necesario para que Maven funcione con su proyecto, alrededor del cual se organiza todo el trabajo. Exactamente en
la parte de Maven surgen algunos obstáculos que normalmente encuentran aquellos que se adentran por primera vez en Bigtop.
Práctica
Entonces, ¿por dónde empezar? Vamos a la página de descarga y bajamos la última versión estable en forma de archivo comprimido. Allí también se pueden encontrar los artefactos binarios compilados de Bigtop. Por cierto, entre los gestores de paquetes comunes, se soportan YUM y APT.
Como método alternativo, se puede descargar la última versión estable directamente desde
github:
$ git clone --branch branch-1.4 https://github.com/apache/bigtop.gitClonando en 'bigtop'...
remote: Enumerando objetos: 46, hecho.
remote: Contando objetos: 100% (46/46), hecho.
remote: Comprimiendo objetos: 100% (41/41), hecho.
remote: Total 40217 (delta 14), reutilizados 10 (delta 1), pack-reutilizados 40171
Recibiendo objetos: 100% (40217/40217), 43.54 MiB | 1.05 MiB/s, listo.
Determinando cambios: 100% (20503/20503), listo.
Actualizando archivos: 100% (1998/1998), listo.
El directorio resultante ./bigtop se ve aproximadamente así:
./bigtop-bigpetstore — aplicaciones de demostración, ejemplos sintéticos
./bigtop-ci — herramientas CI, jenkins
./bigtop-data-generators — generación de datos, sintéticos, para pruebas smoke, etc.
./bigtop-deploy — herramientas para el despliegue
./bigtop-packages — configuraciones, scripts, parches para la compilación, la parte principal de la herramienta
./bigtop-test-framework — marco de pruebas
./bigtop-tests — las propias pruebas, pruebas de carga y smoke
./bigtop_toolchain — entorno para la compilación, preparación del entorno para el funcionamiento de la herramienta
./build — directorio de trabajo de la compilación
./dl — directorio para los fuentes descargados
./docker — compilación en imágenes docker, pruebas
./gradle — configuración de gradle
./output – directorio donde van los artefactos de la compilación
./provisioner — aprovisionamiento
Lo más interesante en esta etapa para nosotros es la configuración principal ./bigtop/bigtop.bom, donde vemos todos los componentes soportados con sus versiones. Aquí podemos especificar otra versión del producto (si por casualidad queremos probar una diferente) o la versión de compilación (si, por ejemplo, hemos agregado un parche significativo).
También es de gran interés el subdirectorio .\/bigtop\/bigtop-packages, que está directamente relacionado con el proceso de compilación de componentes y sus paquetes.
Entonces, hemos descargado el archivo, lo hemos descomprimido o hemos hecho un clon desde github, ¿podemos comenzar a compilar?
No, primero debemos preparar el entorno.
Preparación del entorno
Y aquí es necesario un pequeño paréntesis. Para compilar prácticamente cualquier producto más o menos complejo, se necesita un entorno específico; en nuestro caso, esto es JDK, las mismas bibliotecas compartidas, archivos de encabezado, etc., herramientas como ant, ivy2 y muchas más. Una de las opciones para obtener el entorno necesario para Bigtop es instalar los componentes necesarios en el host de compilación. Puedo estar equivocado en la cronología, pero parece que con la versión 1.0 también se introdujo la opción de compilar en imágenes de docker preconfiguradas y disponibles, que se pueden consultar aquí.
En cuanto a la preparación del entorno, hay una ayuda: Puppet.
Se pueden usar los siguientes comandos, ejecutándose desde el directorio raíz
del herramienta, .\/bigtop:
.\/gradlew toolchain\n.\/gradlew toolchain-devtools\n.\/gradlew toolchain-puppetmodules
O directamente a través de puppet:
puppet apply --modulepath= -e "include bigtop_toolchain::installer"\npuppet apply --modulepath= -e "include bigtop_toolchain::deployment-tools"\npuppet apply --modulepath= -e "include bigtop_toolchain::development-tools"Desafortunadamente, incluso en esta etapa pueden surgir complicaciones. Un consejo general aquí es usar una distribución soportada, que esté actualizada en el host de compilación, o intentar el camino con docker.
Compilación
¿Qué podemos intentar compilar? La respuesta a esta pregunta la dará la salida del comando
.\/gradlew tasks En la sección de tareas de paquetes hay varios productos que son artefactos finales de Bigtop.
Se pueden identificar por el sufijo -rpm o -pkg-ind (en el caso de la compilación
en docker). En nuestro caso, lo más interesante es Hadoop.
Intentemos realizar la compilación en el entorno de nuestro servidor de construcción:
.\/gradlew hadoop-rpmBigtop descargará automáticamente los fuentes necesarios para el componente específico y comenzará la compilación. De esta manera, el funcionamiento de la herramienta depende de los repositorios de Maven y otras fuentes, es decir, necesita acceso a Internet.
Durante el proceso de trabajo, se genera una salida estándar. A veces, a partir de ella y de los mensajes de error, se puede entender qué salió mal. Y en ocasiones es necesario obtener información adicional. En este caso, conviene agregar argumentos --info o --debug, y también puede ser útil –stacktrace. Hay una manera conveniente de formar un conjunto de datos para futuras consultas en las listas de correo, clave --scan.
. Con esto, bigtop recopilará toda la información y la publicará en gradle, luego proporcionará un enlace,
a través del cual una persona competente podrá entender por qué la compilación no tuvo éxito.
Hay que tener en cuenta que esta opción puede hacer pública información que no desearías, como nombres de usuarios, nodos, variables de entorno, etc., así que ten cuidado.
A menudo, los errores son consecuencia de la imposibilidad de obtener algún componente necesario para la compilación. Por lo general, el problema se puede solucionar creando un parche para corregir algo en los fuentes, como por ejemplo, la dirección en pom.xml en el directorio raíz de los fuentes. Esto se hace creando y colocándolo en el directorio correspondiente .\/bigtop\/bigtop-packages\/src\/common\/oozie\/ parche, por ejemplo, en forma de patch2-fix.diff.
--- a\/pom.xml
+++ b\/pom.xml
@@ -136,7 +136,7 @@
<repositories>
<repository>
<id>central<\/id>
- <url>http:\/\/repo1.maven.org\/maven2<\/url>
+ <url>https:\/\/repo1.maven.org\/maven2<\/url>
<snapshots>
<enabled>false<\/enabled>
<\/snapshots>
Lo más probable es que, en el momento de leer este artículo, no tengas que hacer tú mismo la corrección mencionada anteriormente.
Al implementar parches y correcciones en el mecanismo de construcción, puede ser necesario "reiniciar" la construcción mediante el comando de limpieza:
.\/gradlew hadoop-clean
> Tarea :hadoop_vardefines
> Tarea :hadoop-clean
COMPILACIÓN EXITOSA en 5s
2 tareas ejecutables: 2 ejecutadas
Esta operación deshará todos los cambios en la construcción de este componente, después de lo cual la construcción se realizará nuevamente. Esta vez intentaremos compilar el proyecto en una imagen de docker:
.\/gradlew -POS=centos-7 -Pprefix=1.2.1 hadoop-pkg-ind
> Tarea :hadoop-pkg-ind
Construyendo 1.2.1 hadoop-pkg en centos-7 en Docker...
+++ dirname .\/bigtop-ci\/build.sh
++ cd .\/bigtop-ci\/..
++ pwd
+ BIGTOP_HOME=\/tmp\/bigtop
+ '[' 6 -eq 0 ']'
+ [[ 6 -gt 0 ]]
+ key=--prefix
+ case $key in
+ PREFIX=1.2.1
+ shift
+ shift
+ [[ 4 -gt 0 ]]
+ key=--os
+ case $key in
+ OS=centos-7
+ shift
+ shift
+ [[ 2 -gt 0 ]]
+ key=--target
+ case $key in
+ TARGET=hadoop-pkg
+ shift
+ shift
+ [[ 0 -gt 0 ]]
+ '[' -z x ']'
+ '[' -z x ']'
+ '[' '' == true ']'
+ IMAGE_NAME=bigtop\/slaves:1.2.1-centos-7
++ uname -m
+ ARCH=x86_64
+ '[' x86_64 '!=' x86_64 ']'
++ docker run -d bigtop\/slaves:1.2.1-centos-7 \/sbin\/init
+
CONTAINER_ID=0ce5ac5ca955b822a3e6c5eb3f477f0a152cd27d5487680f77e33fbe66b5bed8
+ trap 'docker rm -f
0ce5ac5ca955b822a3e6c5eb3f477f0a152cd27d5487680f77e33fbe66b5bed8' EXIT
....
mucho output
....
Escribió: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-2.8.5-1.el7.x86_64.rpm
Escribió: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-2.8.5-1.el7.x86_64.rpm
Escribió: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-2.8.5-1.el7.x86_64.rpm
Escribió: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-mapreduce-2.8.5-1.el7.x86_64.rpm
Escribió: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-namenode-2.8.5-1.el7.x86_64.rpm
Escribió: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-secondarynamenode-2.8.5-
1.el7.x86_64.rpm
Escribió: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-zkfc-2.8.5-1.el7.x86_64.rpm
Escribió: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-journalnode-2.8.5-
1.el7.x86_64.rpm
Escribió: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-datanode-2.8.5-1.el7.x86_64.rpm
Escribió: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-httpfs-2.8.5-1.el7.x86_64.rpm
Escribió: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-resourcemanager-2.8.5-
1.el7.x86_64.rpm
Escribió: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-nodemanager-2.8.5-
1.el7.x86_64.rpm
Escribió: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-proxyserver-2.8.5-
1.el7.x86_64.rpm
Escribió: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-timelineserver-2.8.5-
1.el7.x86_64.rpm
Escribió: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-mapreduce-historyserver-2.8.5-
1.el7.x86_64.rpm
Escribió: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-client-2.8.5-1.el7.x86_64.rpm
Escribió: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-conf-pseudo-2.8.5-1.el7.x86_64.rpm
Escribió: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-doc-2.8.5-1.el7.x86_64.rpm
Escribió: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-libhdfs-2.8.5-1.el7.x86_64.rpm
Escribió: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-libhdfs-devel-2.8.5-1.el7.x86_64.rpm
Escribió: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-fuse-2.8.5-1.el7.x86_64.rpm
Escribió: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-debuginfo-2.8.5-1.el7.x86_64.rpm
+ umask 022
+ cd \/bigtop\/build\/hadoop\/rpm\/\/BUILD
+ cd hadoop-2.8.5-src
+ \/usr\/bin\/rm -rf \/bigtop\/build\/hadoop\/rpm\/BUILDROOT\/hadoop-2.8.5-1.el7.x86_64
Ejecutando(%clean): \/bin\/sh -e \/var\/tmp\/rpm-tmp.uQ2FCn
+ exit 0
+ umask 022
Ejecutando(--clean): \/bin\/sh -e \/var\/tmp\/rpm-tmp.CwDb22
+ cd \/bigtop\/build\/hadoop\/rpm\/\/BUILD
+ rm -rf hadoop-2.8.5-src
+ exit 0
[ant:touch] Creando \/bigtop\/build\/hadoop\/.rpm
:hadoop-rpm (Hilo[Tarea trabajador para ':',5,principal]) completado. Tomó 38 mins 1.151 secs.
:hadoop-pkg (Hilo[Tarea trabajador para ':',5,principal]) iniciado.
> Tarea :hadoop-pkg
Tarea ':hadoop-pkg' no está actualizada porque:
La tarea no ha declarado ninguna salida a pesar de ejecutar acciones.
:hadoop-pkg (Hilo[Tarea trabajador para ':',5,principal]) completado. Tomó 0.0 secs.
BUILD EXITOSO en 40m 37s
6 tareas ejecutables: 6 ejecutadas
+ RESULT=0
+ mkdir -p output
+ docker cp
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb:\/bigtop\/build .
+ docker cp
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb:\/bigtop\/output .
+ docker rm -f ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
+ '[' 0 -ne 0 ']'
+ docker rm -f ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
Error: No existe tal contenedor:
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
BUILD EXITOSO en 41m 24s
1 tarea ejecutable: 1 ejecutada
La compilación se realizó bajo CentOS, pero también se puede llevar a cabo bajo Ubuntu:
.\/gradlew -POS=ubuntu-16.04 -Pprefix=1.2.1 hadoop-pkg-indAdemás de la compilación de paquetes para diversas distribuciones de Linux, la herramienta puede formar un repositorio con los paquetes compilados, por ejemplo:
.\/gradlew yumTambién se pueden recordar las pruebas de humo y el despliegue en docker.
Crear un cluster de tres nodos:
.\/gradlew -Pnum_instances=3 docker-provisionerEjecutar pruebas de humo en un cluster de tres nodos:
.\/gradlew -Pnum_instances=3 -Prun_smoke_tests docker-provisionerEliminar el cluster:
.\/gradlew docker-provisioner-destroyObtener comandos para conectarse dentro de los contenedores docker:
.\/gradlew docker-provisioner-sshMostrar estado:
.\/gradlew docker-provisioner-statusPuede leer más detalladamente sobre las tareas de despliegue en la documentación.
En cuanto a las pruebas, hay una cantidad considerable, principalmente pruebas de humo e integración. Su análisis está fuera del alcance de este artículo. Solo diré que la compilación de la distribución no es tan complicada como puede parecer a primera vista. Todos los componentes que utilizamos en producción se pudieron compilar y se les realizaron pruebas, y no tuvimos problemas con su despliegue y la realización de operaciones básicas en el entorno de prueba.
Además de los componentes existentes en Bigtop, hay la posibilidad de añadir algo más, incluso un desarrollo de software propio. Todo esto se automatiza perfectamente y se encuadra en el concepto de CI/CD.
Conclusión
Es evidente que una distribución compilada de esta manera no debe enviarse directamente a producción. Es necesario entender que si hay una necesidad real de compilar y mantener su propia distribución, es necesario invertir recursos financieros y tiempo en ello.
Sin embargo, con un enfoque adecuado y un equipo profesional, es completamente posible prescindir de soluciones comerciales.
Es importante señalar que el propio proyecto Bigtop necesita desarrollo y, al parecer, no se está llevando a cabo una desarrollo activa en él en la actualidad. También es incierta la perspectiva de la aparición de Hadoop 3 en él. Por cierto, si tiene una necesidad real de compilar Hadoop 3, puede echar un vistazo a de Arenadata, que además de los componentes estándar
cuenta con una serie de adicionales (Ranger, Knox, NiFi).
En cuanto a Rostelecom, para nosotros Bigtop es una de las opciones consideradas en la actualidad. Si optaremos por él o no, lo dirá el tiempo.
Anexo
Para incluir un nuevo componente en la construcción, es necesario agregar su descripción en bigtop.bom y .\/bigtop-packages. Puedes intentar hacerlo por analogía con los componentes existentes. Intenta averiguarlo. No es tan complicado como parece a primera vista.
¿Y ustedes qué piensan? ¡Nos encantaría ver su opinión en los comentarios y gracias por su atención!
Este artículo fue preparado por el equipo de gestión de datos de «Rostelecom»
Fuente: habr.com
