

En 2017, ganamos un concurso para desarrollar el núcleo transaccional del negocio de inversiones de Alfa-Bank y comenzamos a trabajar en ello (en HighLoad++ 2018 con una presentación sobre el núcleo del negocio de inversiones) Vladimir Drynkin, jefe del departamento del núcleo transaccional del negocio de inversiones de Alfa-Bank). Este sistema debía agregar datos sobre transacciones de diversas fuentes en diferentes formatos, unificar los datos, almacenarlos y proporcionar acceso a ellos.
Durante el proceso de desarrollo, el sistema evolucionó y fue adquiriendo funcionalidad, y en algún momento nos dimos cuenta de que estábamos cristalizando algo mucho más grande que un simple software aplicado creado para resolver un conjunto definido de tareas: obtuvimos un sistema para la construcción de aplicaciones distribuidas con almacenamiento persistente. La experiencia que obtuvimos sentó las bases para un nuevo producto — (TDG).
Quiero hablar sobre la arquitectura de TDG y sobre las soluciones a las que llegamos durante el proceso de desarrollo, familiarizarlos con la funcionalidad principal y mostrar cómo nuestro producto puede convertirse en la base para construir soluciones completas.
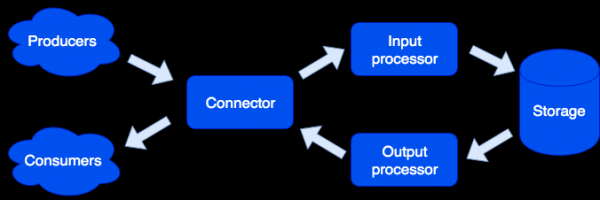
Arquitectónicamente, dividimos el sistema en componentes separados roles, cada uno responsable de resolver un conjunto específico de tareas. Una instancia de aplicación en ejecución implementa uno o más tipos de roles. En el clúster puede haber varios roles del mismo tipo:
Connector
El conector es responsable de la conexión con el mundo exterior; su tarea es recibir la solicitud, analizarla y, si tiene éxito, enviar los datos para su procesamiento al input processor. Soportamos formatos como HTTP, SOAP, Kafka y FIX. La arquitectura permite agregar fácilmente el soporte para nuevos formatos, pronto se añadirá el soporte para IBM MQ. Si el análisis de la solicitud falla, el conector devolverá un error; de lo contrario, responderá que la solicitud fue procesada con éxito, incluso si ocurrió un error durante su procesamiento posterior. Esto se hace específicamente para trabajar con sistemas que no pueden repetir solicitudes, o viceversa, lo hacen de manera demasiado insistente. Para evitar la pérdida de datos, se utiliza una cola de reparación: el objeto primero se coloca en ella y solo se elimina tras un procesamiento exitoso. El administrador puede recibir notificaciones sobre los objetos que permanecen en la cola de reparación y, después de solucionar el error de programación o la falla de hardware, intentar nuevamente.
Input processor
El input processor clasifica los datos recibidos según características distintivas y llama a los manejadores apropiados. Los manejadores son código en el lenguaje Lua, que se ejecuta en un entorno aislado, por lo que no pueden afectar el funcionamiento del sistema. En esta etapa, los datos se pueden formatear como se requiere y, si es necesario, se pueden activar una cantidad arbitraria de tareas que pueden implementar la lógica necesaria. Por ejemplo, en el producto MDM (Master Data Management), construido sobre Tarantool Data Grid, al agregar un nuevo usuario, para no retrasar el procesamiento de la solicitud, la creación de la grabación maestra se inicia como una tarea separada. El entorno aislado soporta solicitudes de lectura, modificación y adición de datos, permite ejecutar algunas funciones en todos los roles tipo storage y agrega el resultado (map/reduce).
Los manejadores pueden ser descritos en archivos:
sum.lua

local x, y = unpack(...)
return x + y
Y luego, declarados en la configuración:
functions:
  sum: { __file: sum.lua }
¿Por qué Lua? Lua es un lenguaje muy simple. Según nuestra experiencia, después de unas pocas horas de familiarización, las personas comienzan a escribir código que resuelve su problema. Y no son solo desarrolladores profesionales, sino por ejemplo, analistas. Además, gracias al compilador JIT, Lua funciona muy rápido.
Almacenamiento
El almacenamiento guarda datos persistentes. Antes de guardar, los datos son validados según el esquema de datos. Para describir el esquema, utilizamos un formato extendido. . Ejemplo:
{
    "name": "Usuario",
    "type": "record",
    "logicalType": "Agregado",
    "fields": [
        { "name": "id", "type": "string"},
        {"name": "nombre", "type": "string"},
        {"name": "apellidos", "type": "string"}
    ],
    "indexes": ["id"]
}
A partir de esta descripción se genera automáticamente DDL (Lenguaje de Definición de Datos) para la base de datos Tarantool y el esquema para el acceso a los datos.
Se admite la replicación asíncrona de datos (está previsto agregar replicación sincrónica).
Procesador de salida
A veces es necesario notificar a consumidores externos sobre la llegada de nuevos datos, para ello existe el rol de Procesador de salida. Después de guardar los datos, pueden ser enviados al manejador correspondiente (por ejemplo, para transformarlos en el formato que requiere el consumidor) — y después enviados al conector para su envío. Aquí también se utiliza una cola de reparación: si nadie acepta el objeto, el administrador puede intentar nuevamente más tarde.
Escalado
Los roles de conector, procesador de entrada y procesador de salida no tienen estado, lo que nos permite escalar la sistema horizontalmente, simplemente añadiendo nuevas instancias de la aplicación con el rol del tipo necesario. Para el escalado horizontal del almacenamiento se utiliza para la organización de clústeres utilizando buckets virtuales. Después de añadir un nuevo servidor, parte de los buckets de los servidores antiguos se trasladan en segundo plano al nuevo servidor; esto ocurre de manera transparente para los usuarios y no afecta el funcionamiento de todo el sistema.
Propiedades de los datos
Los objetos pueden ser muy grandes y contener otros objetos. Garantizamos la atomicidad en la adición y actualización de datos, manteniendo el objeto con todas sus dependencias en un solo bucket virtual. De esta manera se evita la "dispersión" del objeto en varios servidores físicos.
Se admite el versionado: cada actualización de un objeto crea una nueva versión, y siempre podemos hacer una instantánea y ver cómo era el mundo en ese momento. Para los datos que no necesitan una larga historia, podemos limitar el número de versiones o incluso almacenar solo una: la más reciente, lo que prácticamente desactiva el versionado para un tipo específico. También se puede limitar la historia por tiempo: por ejemplo, eliminar todos los objetos de un cierto tipo que tengan más de un año. Se admite la archivación: podemos descargar objetos que tengan más de un período especificado, liberando espacio en el clúster.
Tareas
De las funciones interesantes vale la pena destacar la posibilidad de ejecutar tareas según un horario, a petición del usuario o programáticamente desde el sandbox:
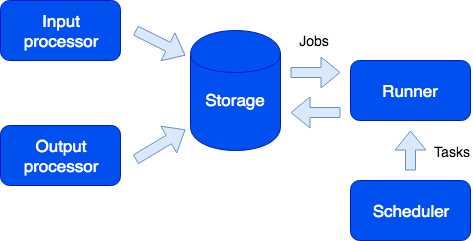
Aquí vemos otro rol: runner. Este rol no tiene estado, y si es necesario, se pueden agregar instancias adicionales de la aplicación con este rol al clúster. La responsabilidad del runner es ejecutar tareas. Como se mencionó, desde el sandbox se pueden generar nuevas tareas; se almacenan en una cola en el storage y luego se ejecutan en el runner. Este tipo de tareas se llama Job. También tenemos un tipo de tareas llamado Task: son tareas definidas por el usuario y se ejecutan según un horario (se utiliza la sintaxis cron) o bajo demanda. Para iniciar y rastrear tales tareas disponemos de un conveniente administrador de tareas. Para que esta funcionalidad esté disponible, es necesario activar el rol scheduler; este rol tiene estado, por lo que no se escala, aunque no es necesario; sin embargo, al igual que todos los demás roles, puede tener una réplica que comienza a funcionar si el maestro falla inesperadamente.
Logger
Otro rol se llama logger. Recolecta registros de todos los miembros del clúster y proporciona una interfaz para su descarga y visualización a través de la interfaz web.
Servicios
Vale la pena mencionar que el sistema permite crear servicios fácilmente. En el archivo de configuración se puede indicar qué solicitudes dirigir al manejador escrito por el usuario, que se ejecuta en el sandbox. En este manejador se puede, por ejemplo, realizar una consulta analítica y devolver el resultado.
El servicio se describe en el archivo de configuración:
services:
   sum:
      doc: "suma dos números"
      function: sum
      return_type: int
      args:
         x: int
         y: int
La API de GraphQL se genera automáticamente y el servicio se vuelve accesible para ser llamado:
consulta {
   suma(x: 1, y: 2)
}
Esto llevará a la invocación del manejador suma, que devolverá el resultado:
3
Perfilado de consultas y métricas
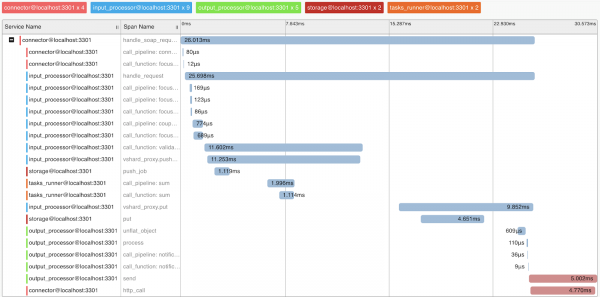
Para entender el funcionamiento del sistema y el perfilado de consultas, hemos implementado soporte para el protocolo OpenTracing. El sistema puede, bajo demanda, enviar información a herramientas que soporten este protocolo, como Zipkin, lo que permitirá entender cómo se ejecutó la consulta:
Naturalmente, el sistema proporciona métricas internas que se pueden recopilar utilizando Prometheus y visualizar a través de Grafana.
Despliegue
Tarantool Data Grid puede ser desplegado a partir de paquetes RPM o de un archivo comprimido, utilizando la utilidad incluida o Ansible, además de contar con soporte para Kubernetes ().
La aplicación que implementa la lógica de negocio (configuración, manejadores) se carga en el clúster desplegado de Tarantool Data Grid en forma de un archivo comprimido a través de la interfaz de usuario o utilizando un script a través de nuestra API proporcionada.
Ejemplos de aplicaciones
¿Qué aplicaciones se pueden crear utilizando Tarantool Data Grid? De hecho, la mayoría de las tareas empresariales están de alguna manera relacionadas con el procesamiento de flujos de datos, su almacenamiento y acceso. Por lo tanto, si tiene grandes flujos de datos que necesita almacenar de manera confiable y tener acceso a ellos, nuestro producto puede ahorrarle mucho tiempo en desarrollo y permitirle concentrarse en su lógica de negocio.
Por ejemplo, queremos recopilar información sobre el mercado inmobiliario, para posteriormente, por ejemplo, tener información sobre las ofertas más atractivas. En este caso, identificaremos las siguientes tareas:
- Los bots que recopilan información de fuentes abiertas serán nuestras fuentes de datos. Esta tarea se puede resolver utilizando soluciones listas para usar o escribiendo código en cualquier lenguaje.
- A continuación, Tarantool Data Grid aceptará y guardará los datos. Si el formato de los datos de diferentes fuentes es diferente, puede escribir código en el lenguaje Lua que realice la conversión a un formato unificado. En la etapa de preprocesamiento, también podrá, por ejemplo, filtrar ofertas duplicadas o actualizar en la base de datos información sobre agentes que operan en el mercado.
- Ahora ya tiene una solución escalable en un clúster que puede llenarse de datos y realizar consultas de datos. A continuación, puede implementar nuevas funcionalidades, por ejemplo, escribir un servicio que haga una solicitud a los datos y ofrezca la propuesta más ventajosa del día; esto requerirá algunas líneas en el archivo de configuración y un poco de código en Lua.
¿Qué sigue?
Nuestra prioridad es mejorar la comodidad de desarrollo a través de . Por ejemplo, se trata de un IDE con soporte para perfiles y depuración de controladores que funcionan en un entorno aislado.
También prestamos mucha atención a las cuestiones de seguridad. En este momento, estamos en proceso de certificación por parte del FSTEC de Rusia para confirmar un alto nivel de seguridad y cumplir con los requisitos de certificación de productos de software utilizados en sistemas de información de datos personales y sistemas de información estatales.
Fuente: habr.com
