

El SDSM ha terminado, pero el deseo incontrolado de escribir sigue ahí.
Durante muchos años, nuestro hermano sufrió al realizar trabajos rutinarios, cruzando los dedos antes del commit y desvelándose por los rollbacks nocturnos.
Pero todo tiempo oscuro llega a su fin.
Con este artículo comenzaré una serie sobre cómo yo veo la automatización.
A lo largo del camino, abordaremos las etapas de la automatización, el almacenamiento de variables, la formalización del diseño, con RestAPI, NETCONF, YANG, YDK y programaremos mucho.
Yo significa que a) no es una verdad objetiva, b) no es el enfoque más incondicionalmente mejor c) mi perspectiva podría cambiar incluso a medida que avance de un artículo a otro — sinceramente, desde la etapa de borrador hasta la publicación, reescribí todo completamente dos veces.
Contenido
- Objetivos
- La red — como un organismo único
- Pruebas de configuración
- Versionado
- Monitoreo y autorrecuperación de servicios
- Herramientas
- Sistema de inventario
- Sistema de gestión del espacio IP
- Sistema de descripción de servicios de red
- Mecanismo de inicialización de dispositivos
- Modelo de configuración independiente del proveedor
- Interfaz específica del proveedor de controlador
- Mecanismo de entrega de configuración al dispositivo
- CI/CD
- Mecanismo de copia de seguridad y detección de desviaciones
- Sistema de monitoreo
- Conclusión
Intentaré llevar el ADSM en un formato algo diferente al SDSM. Seguirán apareciendo artículos sustanciales y numerados, y entre ellos publicaré pequeñas notas de experiencias cotidianas. Intentaré aquí luchar contra el perfeccionismo y no pulir cada uno de ellos.
Qué curioso que por segunda vez tenga que recorrer el mismo camino.
Al principio, tuve que escribir yo mismo artículos sobre redes porque no había ninguno en la red rusa.
Ahora no pude encontrar un documento completo que sistematizara los enfoques de automatización y desglosara, con ejemplos prácticos sencillos, las tecnologías mencionadas anteriormente.
Puede que me equivoque, así que envíenme enlaces a buenos recursos. Sin embargo, esto no cambiará mi determinación de escribir, porque el objetivo principal es aprender algo por mí mismo, y facilitar la vida de los demás es un bono agradable que acaricia el gen de compartir experiencias.
Intentaremos tomar un centro de datos de tamaño mediano LAN DC y desarrollar todo el esquema de automatización.
Algunas cosas las haré prácticamente por primera vez junto a ustedes.
No seré original en las ideas y herramientas que describo aquí. Dmitry Figol tiene un excelente .
Los artículos se cruzarán con ellos en muchos aspectos.
En LAN DC hay 4 centros de datos, alrededor de 250 conmutadores, media docena de enrutadores y un par de cortafuegos.
No es Facebook, pero es suficiente para reflexionar profundamente sobre la automatización.
Sin embargo, existe la opinión de que si tienes más de un dispositivo, ya necesitas automatización.
Es difícil imaginar que alguien pueda vivir actualmente sin al menos un paquete de scripts de rodilleras.
Aunque he oído que hay empresas donde el registro de direcciones IP se lleva a cabo en Excel, y cada uno de miles de dispositivos de red se configura manualmente y tiene su propia configuración única. Esto, por supuesto, se puede presentar como arte moderno, pero los sentimientos de un ingeniero estarán indudablemente heridos.
Objetivos
Ahora establezcamos objetivos máximamente abstractos:
- La red — como un organismo único
- Pruebas de configuración
- Versionado del estado de la red
- Monitoreo y autorrecuperación de servicios
Más adelante en este artículo, analizaremos qué herramientas utilizaremos, y en los siguientes, los objetivos y medios en detalle.
La red — como un organismo único
La frase definitoria del ciclo, aunque a primera vista pueda parecer no tan significativa: vamos a configurar la red, no dispositivos individuales.
En los últimos años hemos estado observando un cambio de enfoque hacia tratar la red como una sola entidad, de ahí la llegada a nuestras vidas de Software Defined Networking, Intent Driven Networks y Autonomous Networks.
Porque lo que las aplicaciones necesitan globalmente de la red es: conectividad entre puntos A y B (bueno, a veces +B-Y) y aislamiento de otras aplicaciones y usuarios.
Y así, nuestra tarea en esta serie es construir un sistema, que apoye la configuración actual de toda la red, que ya se descompone en la configuración actual de cada dispositivo según su rol y ubicación.
Sistema La gestión de la red implica que para hacer cambios nos dirigimos a ella, y a su vez calcula el estado necesario para cada dispositivo y lo configura.
De esta manera, minimizamos casi a cero la necesidad de interactuar con la CLI manualmente: cualquier cambio en la configuración de los dispositivos o el diseño de la red debe estar formalizado y documentado, y solo después implementarse en los elementos necesarios de la red.
Es decir, por ejemplo, si decidimos que a partir de ahora los switches de rack en Kazán deben anunciar dos redes en lugar de una, nosotros
- Primero documentamos los cambios en los sistemas
- Generamos la configuración objetivo de todos los dispositivos de la red
- Ejecutamos el programa de actualización de configuración de red, que calcula qué se debe eliminar en cada nodo, qué agregar y pone a los nodos en el estado deseado.
En este proceso, hacemos los cambios a mano solo en el primer paso.
Pruebas de configuración
, que el 80% de los problemas ocurren durante el cambio de configuración, prueba de ello es que durante el período de vacaciones de Año Nuevo normalmente todo está tranquilo.
Yo personalmente he sido testigo de decenas de caídas globales debido a errores humanos: comandos incorrectos, ejecutados en la rama de configuración equivocada, olvidando la comunidad, borrando MPLS globalmente en un enrutador, configurando cinco dispositivos, y en el sexto no notando el error, comitiendo cambios antiguos realizados por otra persona. Hay infinitos escenarios.
La automatización nos permitirá cometer menos errores, pero a una escala mayor. Así se puede bloquear no solo un dispositivo, sino toda la red de golpe.
Desde tiempos inmemoriales, nuestros antepasados verificaban la corrección de los cambios realizados con ojo agudo, testículos de acero y la operatividad de la red después de su implementación.
Aquellos ancianos cuyas acciones provocaban inactividad y pérdidas catastróficas dejaban menos descendencia y debían extinguirse con el tiempo, pero la evolución es un proceso lento, y por eso aún no todos prueban los cambios anticipadamente en el laboratorio.
Sin embargo, a la vanguardia del progreso están aquellos que automatizaron el proceso de prueba de configuración y su posterior aplicación en la red. En otras palabras, adoptaron el procedimiento de CI/CD () de los desarrolladores.
En una de las secciones, veremos cómo realizar esto utilizando un sistema de control de versiones, probablemente GitHub.
Tan pronto como te acostumbres a la idea de CI/CD en redes, de repente el método de verificar la configuración aplicándola en la red de trabajo te parecerá una necedad de la edad media temprana. Aproximadamente como golpear con un martillo una cabeza nuclear.
Una continuación orgánica de las ideas sobre el sistema de gestión de redes y CI/CD se convierte en un versionado completo de la configuración.
Versionado
Supondremos que con cualquier cambio, incluso el más mínimo, incluso en un dispositivo imperceptible, toda la red pasa de un estado a otro.
Y siempre que no ejecutemos comandos en el dispositivo, cambiamos el estado de la red.
¿Vamos a llamar a esos estados versiones?
Supongamos que la versión actual es 1.0.0.
¿Ha cambiado la dirección IP de la interfaz Loopback en uno de los ToR? Esa es una versión menor; obtendrá el número 1.0.1.
Si revisamos las políticas de importación de rutas en BGP, es algo más serio; ya sería 1.1.0.
Decidimos deshacernos del IGP y pasar solo a BGP; ya es un cambio radical en el diseño: 2.0.0.
A su vez, diferentes centros de datos pueden tener diferentes versiones; la red evoluciona, se instala nuevo hardware, en algunos lugares se agregan nuevos niveles de spine, en otros no, etc.
Sobre hablaremos de esto en un artículo aparte.
Repito, cualquier cambio (excepto los comandos de depuración) es una actualización de versión. Los administradores deben ser notificados de cualquier desviación de la versión actual.
Lo mismo se aplica a la reversión de cambios; no se trata de anular los últimos comandos, ni de un rollback por parte del sistema operativo del dispositivo; se trata de llevar toda la red a una nueva (o anterior) versión.
Monitoreo y autorrecuperación de servicios
Es una tarea autoevidente en redes modernas que está alcanzando un nuevo nivel.
A menudo, los grandes proveedores de servicios practican el enfoque de que un servicio caído debe ser rápidamente resuelto y levantada una nueva, en lugar de investigar qué sucedió.
El "muy" significa que de todas partes se necesita estar ampliamente bañado en monitoreos que detecten en segundos la menor desviación de la norma.
Y aquí no son suficientes las métricas habituales, como la carga de la interfaz o la disponibilidad del nodo. No es suficiente tampoco que un encargado las siga manualmente.
Para muchas cosas, debe haber los monitores se encienden en rojo y van a aplicar un vendaje donde duele.
Y aquí también monitoreamos no solo dispositivos individuales, sino también la salud de la red en su totalidad, tanto como blanco (whitebox), que es relativamente claro, como negro (blackbox), que es más complicado.
¿Qué necesitaremos para llevar a cabo esos ambiciosos planes?
- Tener un listado de todos los dispositivos en la red, su ubicación, roles, modelos y versiones de software.
kazan-leaf-1.lmu.net, Kazan, leaf, Juniper QFX 5120, R18.3. - Tener un sistema de descripción de servicios de red.
IGP, BGP, L2/3VPN, Policy, ACL, NTP, SSH. - Saber inicializar el dispositivo.
Hostname, IP de gestión, ruta de gestión, usuarios, claves RSA, LLDP, NETCONF - Configurar el dispositivo y llevar la configuración a la versión requerida (incluyendo versiones anteriores).
- Probar la configuración
- Verificar periódicamente el estado de todos los dispositivos para detectar desviaciones de lo actual y notificar a las partes correspondientes.
Durante la noche, alguien añadió en silencio una regla al ACL. - Supervisar el funcionamiento.
Herramientas
Suena lo suficientemente complicado como para comenzar a descomponer el proyecto en componentes.
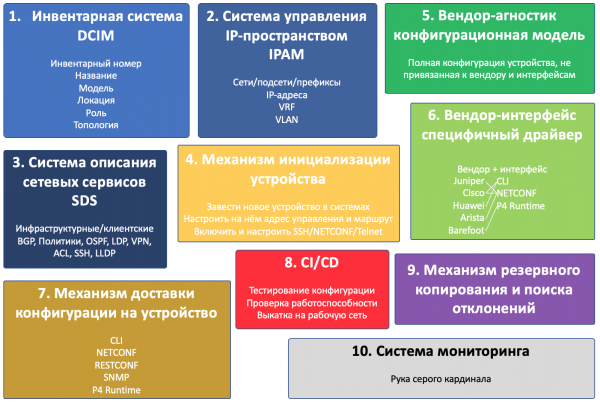
Y serán diez:
- Sistema de inventario
- Sistema de gestión del espacio IP
- Sistema de descripción de servicios de red
- Mecanismo de inicialización de dispositivos
- Modelo de configuración independiente del proveedor
- Interfaz específica del proveedor de controlador
- Mecanismo de entrega de configuración al dispositivo
- CI/CD
- Mecanismo de copia de seguridad y detección de desviaciones
- Sistema de monitoreo
Este, por cierto, es un ejemplo de cómo ha cambiado la perspectiva sobre los objetivos del ciclo: en el borrador de componentes había 4.
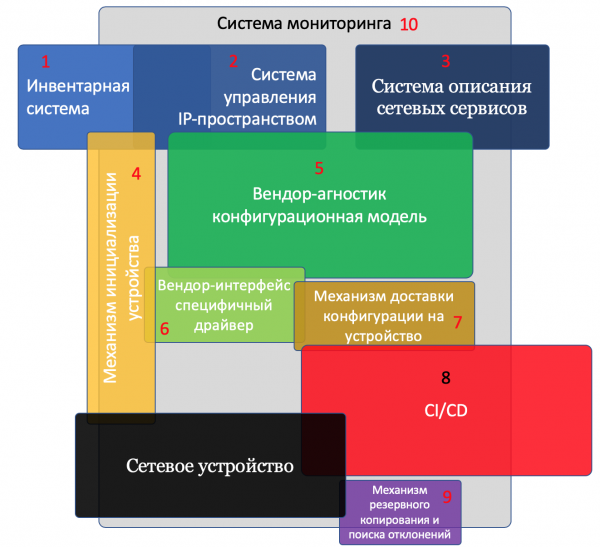
En la ilustración he representado todos los componentes y el propio dispositivo.
Los componentes que se intersectan interactúan entre sí.
Cuanto mayor sea el bloque, más atención necesita este componente.
Componente 1. Sistema de inventario
Obviamente, queremos saber qué equipo está en cada lugar y a qué está conectado.
El sistema de inventario es una parte esencial de cualquier empresa.
A menudo, la empresa tiene un sistema de inventario separado para dispositivos de red que aborda tareas más específicas.
En el marco de este ciclo de artículos, lo llamaremos DCIM — Gestión de Infraestructura de Centros de Datos. Aunque, estrictamente hablando, el término DCIM abarca mucho más.
Para nuestros propósitos, almacenaremos la siguiente información sobre el dispositivo:
- Número de inventario
- Nombre/descripción
- Modelo (Huawei CE12800, Juniper QFX5120, etc.)
- Parámetros característicos (placas, interfaces, etc.)
- Rol (Leaf, Spine, Border Router, etc.)
- Ubicación (región, ciudad, centro de datos, rack, unidad)
- Interconexiones entre dispositivos
- Topología de la red
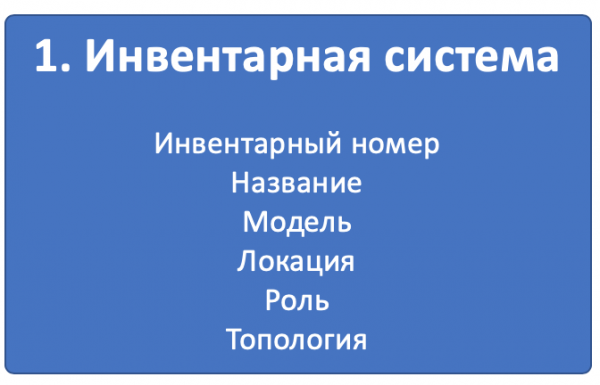
Está claro que nosotros mismos queremos saber todo esto.
Pero, ¿ayudará esto en términos de automatización?
Sin duda.
Por ejemplo, sabemos que en este centro de datos, en los switches Leaf, si es Huawei, los ACL para filtrar cierto tráfico deben aplicarse en VLAN, y si es Juniper, en la unidad 0 de la interfaz física.
O necesitamos desplegar un nuevo servidor Syslog en todos los bordes de la región.
En este sistema también almacenaremos dispositivos de red virtuales, como enrutadores virtuales o route reflectors. Podemos añadir servidores DNS, NTP, Syslog y, en general, todo lo que esté relacionado con la red.
Componente 2. Sistema de gestión del espacio IP
Sí, incluso hoy en día hay grupos de personas que mantienen un registro de prefijos y direcciones IP en archivos de Excel. Pero el enfoque moderno es, sin duda, una base de datos con un frontend en nginx/apache, API y amplias funciones para el manejo de direcciones IP y redes separadas por VRF.
IPAM — Gestión de Direcciones IP.
Para nuestras tareas en ella, almacenaremos la siguiente información:
- VLAN
- VRF
- Redes/Subredes
- IP
- Asignación de direcciones a dispositivos, redes a ubicaciones y números de VLAN
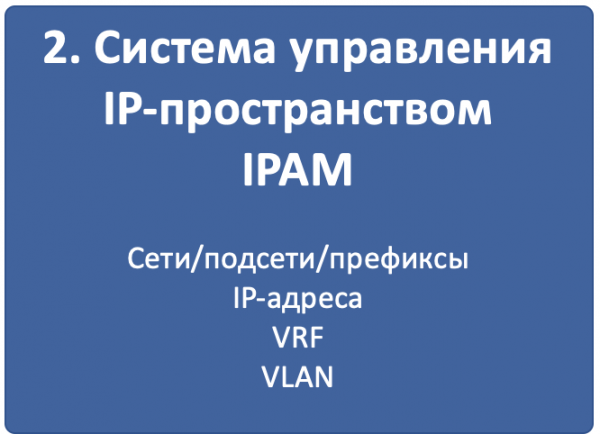
De nuevo, es comprensible que queramos asegurarnos de que al asignar una nueva dirección IP para el bucle de retorno ToR, no nos tropecemos con el hecho de que ya ha sido asignada a alguien. O que el mismo prefijo no se haya utilizado dos veces en diferentes extremos de la red.
Pero, ¿cómo ayudará esto en la automatización?
Fácil.
Solicitamos en el sistema un prefijo con el rol de Loopbacks, en el que hay direcciones IP disponibles para asignar; si se encuentra, asignamos la dirección, si no, solicitamos la creación de un nuevo prefijo.
O al crear la configuración del dispositivo, desde este mismo sistema podemos averiguar en qué VRF debe estar la interfaz.
Y al iniciar un nuevo servidor, un script consultará el sistema, averiguará en cuál switch del servidor, en qué puerto y qué subred está asignada a la interfaz — de ahí es donde se asignará la dirección del servidor.
Surge el deseo de combinar DCIM e IPAM en un solo sistema, para no duplicar funciones y no gestionar dos entidades similares.
Así lo haremos.
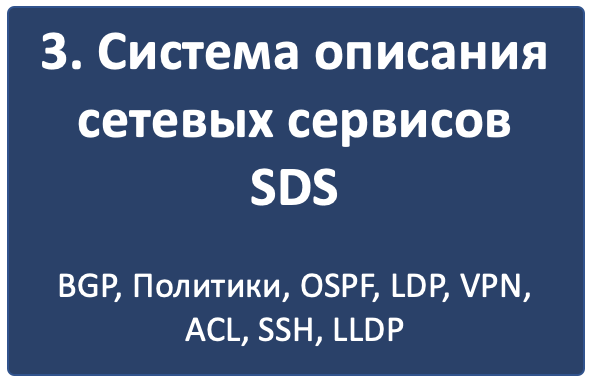
Componente 3. Sistema de Descripción de Servicios de Red
Si los primeros dos sistemas almacenan variables que aún deben utilizarse de alguna manera, el tercero describe cómo debe estar configurado cada rol de dispositivo.
Cabe destacar dos tipos diferentes de servicios de red:
- Infraestructurales
- De Cliente.
Los primeros están destinados a proporcionar conectividad básica y gestión del dispositivo. Aquí se incluyen VTY, SNMP, NTP, Syslog, AAA, protocolos de enrutamiento, CoPP, etc.
Los segundos organizan un servicio para el cliente: MPLS L2/L3VPN, GRE, VXLAN, VLAN, L2TP, etc.
Por supuesto, también hay casos límite: ¿a dónde clasificar MPLS LDP, BGP? Y los protocolos de enrutamiento pueden utilizarse para los clientes. Pero eso no es fundamental.
Ambos tipos de servicios se desglosan en primitivas de configuración:
- interfaces físicas y lógicas (tag/untag, mtu)
- Direcciones IP y VRF (IP, IPv6, VRF)
- ACL y políticas de tratamiento de tráfico
- Protocolos (IGP, BGP, MPLS)
- Políticas de enrutamiento (listas de prefijos, comunidades, filtros ASN).
- Servicios de sistema (SSH, NTP, LLDP, Syslog…)
- Etc.
No tengo idea de cómo lo haremos exactamente. Lo abordaremos en un artículo aparte.
Si lo llevamos un poco más a la práctica, podríamos describir que
El conmutador Leaf debe tener sesiones BGP con todos los conmutadores Spine conectados, importar las redes conectadas al proceso, aceptar de los conmutadores Spine solo redes de un prefijo específico. Limitar CoPP IPv6 ND a 10 pps, etc.
Por su parte, los Spine mantienen sesiones con todos los Leaf conectados, actuando como reflectores raíz, y aceptan de ellos solo rutas de cierta longitud y con una comunidad específica.
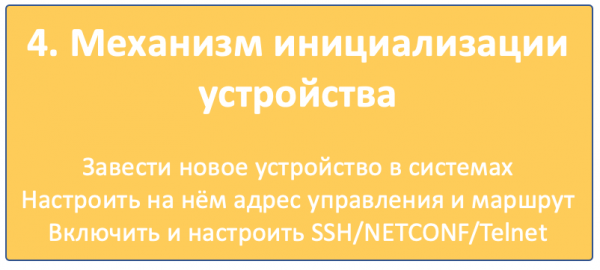
Componente 4. Mecanismo de inicialización del dispositivo
Bajo este título agrupo múltiples acciones que deben ocurrir para que el dispositivo aparezca en los radares y para que se pueda acceder a él de forma remota.
- Registrar el dispositivo en el sistema de inventario.
- Asignar una dirección IP de gestión.
- Configurar el acceso básico a él:
Nombre del host, dirección IP de gestión, ruta a la red de gestión, usuarios, claves SSH, protocolos — telnet/SSH/NETCONF
Existen tres enfoques:
- Todo manualmente. El dispositivo se lleva al banco de pruebas, donde una persona orgánica común lo registrará en los sistemas, se conectará a él mediante consola y lo configurará. Puede funcionar en pequeñas redes estáticas.
- ZTP — Zero Touch Provisioning. El hardware llegó, se encendió, obtuvo una dirección mediante DHCP, se conectó a un servidor especial y se autoconfiguró.
- Infraestructura de servidores de consola, donde la configuración inicial se realiza a través del puerto de consola de manera automática.
Hablaremos de los tres en un artículo separado.
Componente 5. Modelo de configuración agnóstico del proveedor
Hasta ahora, todos los sistemas han sido parches desarticulados que dan descripciones variables y declarativas de lo que nos gustaría ver en la red. Pero tarde o temprano, habrá que lidiar con la concreción.
En esta etapa, para cada dispositivo específico, los primitivos, servicios y variables se combinan en un modelo de configuración que describe efectivamente la configuración completa de un dispositivo específico, solo de manera independiente del proveedor.
¿Qué nos da este paso? ¿Por qué no simplemente generar la configuración del dispositivo que se puede cargar directamente?
De hecho, esto permite resolver tres tareas:
- No adaptarse a una interfaz de interacción específica con el dispositivo. Ya sea CLI, NETCONF, RESTCONF, SNMP, el modelo será el mismo.
- No mantener la cantidad de plantillas / scripts según la cantidad de proveedores en la red, y en caso de un cambio de diseño, modificar lo mismo en varios lugares.
- Cargar la configuración desde el dispositivo (copia de seguridad), distribuirla en el mismo modelo y comparar directamente la configuración objetivo con la existente para calcular la diferencia y preparar un parche de configuración que solo cambiará las partes necesarias o para identificar desviaciones.
Como resultado de esta etapa, obtenemos una configuración independiente del proveedor.
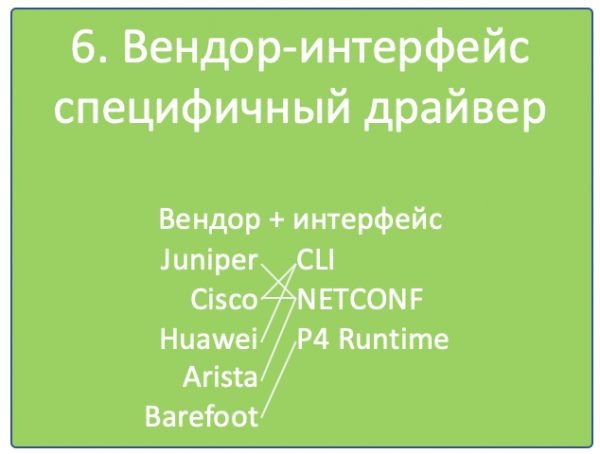
Componente 6. Controlador específico de interfaz del proveedor.
No debemos hacernos ilusiones de que algún día se podrá configurar un Cisco de la misma manera que un Juniper, simplemente enviando las mismas llamadas. A pesar de la creciente popularidad de los dispositivos 'whitebox' y la aparición del soporte para NETCONF, RESTCONF, OpenConfig, el contenido específico que estos protocolos entregan varía de un proveedor a otro, y esta es una de sus diferencias competitivas que no cederán fácilmente.
Es algo similar a OpenContrail y OpenStack, que tienen RestAPI como su interfaz NorthBound, pero esperan llamadas completamente diferentes.
Entonces, en el quinto paso, el modelo independiente del proveedor debe adoptar la forma en que se implementará en el hardware.
Y aquí todos los medios son válidos (no): CLI, NETCONF, RESTCONF, SNMP ya son realmente bastante simples.
Por lo tanto, necesitaremos un controlador que transforme el resultado del paso anterior en el formato específico del proveedor: un conjunto de comandos CLI, estructura XML.
Componente 7. Mecanismo de entrega de configuración al dispositivo.
Hemos generado la configuración, pero aún necesitamos entregarla a los dispositivos, y, por supuesto, no de forma manual.
Primero, surge la pregunta de qué transporte vamos a utilizar. Y la elección hoy en día no es pequeña:
- CLI (telnet, ssh)
- SNMP
- NETCONF
- RESTCONF
- REST API
- OpenFlow (aunque este queda fuera de la lista, ya que es un método para entregar FIB, no configuraciones)
Aquí vamos a aclarar las cosas. CLI es legado. SNMP… ejem-ejem.
RESTCONF aún es una bestia desconocida, casi nadie admite el soporte para REST API. Por lo tanto, en este ciclo nos enfocaremos en NETCONF.
De hecho, como ya ha comprendido el lector, con la interfaz ya hemos tomado una decisión en este momento: el resultado del paso anterior ya se presenta en el formato de la interfaz elegida.
En segundo lugar, ¿y qué herramientas usaremos para hacerlo?
Aquí también hay muchas opciones:
- Un script hecho a mano o una plataforma. Armémonos con ncclient y asyncIO y hagámoslo nosotros mismos. ¿Qué nos cuesta construir un sistema de despliegue desde cero?
- Ansible, con su rica biblioteca de módulos de red.
- Salt, con su limitada funcionalidad de red y su conexión con Napalm.
- Napalm en sí, que conoce un par de proveedores y ya, adiós.
- Nornir — otro animalito que analizaremos en el futuro.
Aquí aún no se ha elegido un favorito — vamos a probar.
¿Qué más es importante aquí? Las consecuencias de aplicar la configuración.
Si ha sido exitoso o no. Si se mantuvo el acceso al dispositivo o no.
Parece que aquí puede ayudar un commit con confirmación y validación de lo que se ha cargado en el dispositivo.
Esto, junto con una correcta implementación de NETCONF, reduce significativamente el número de dispositivos compatibles: no muchos fabricantes soportan commits normales. Pero esto es solo uno de los requisitos en . Al final, nadie se preocupa de que ningún proveedor ruso cumpla con la condición de 32*100GE de interfaz. ¿O sí?
Componente 8. CI/CD
Para este momento ya tenemos la configuración lista para todos los dispositivos de la red.
Escribo «para todos» porque estamos hablando de la versionado del estado de la red. E incluso si se necesitan cambiar las configuraciones de un solo switch, se calculan los cambios para toda la red. Obviamente, estos pueden ser nulos para la mayoría de los nodos.
Pero, como ya se mencionó anteriormente, no somos unos bárbaros para lanzar todo de una vez en producción.
La configuración generada debe pasar primero por Pipeline CI/CD.
CI/CD significa Integración Continua, Despliegue Continuo. Este es un enfoque en el que el equipo no libera una nueva versión mayor cada seis meses, reemplazando completamente la anterior, sino que implementa (Despliegue) regularmente nuevas funcionalidades de forma incremental en pequeñas porciones, cada una de las cuales se prueba exhaustivamente en compatibilidad, seguridad y funcionalidad (Integración).
Para esto, tenemos un sistema de control de versiones que rastrea los cambios de configuración, un laboratorio donde se verifica que el servicio del cliente no se rompa, un sistema de monitoreo que supervisa este hecho, y el último paso es la implementación de cambios en la red de producción.
Con la excepción de los comandos de depuración, todos los cambios en la red deben pasar por el CI/CD Pipeline, que es nuestra garantía de una vida tranquila y una carrera larga y feliz.
Componente 9. Sistema de copias de seguridad y detección de anomalías
No es necesario hablar una vez más sobre las copias de seguridad.
Simplemente las almacenaremos en cron o cuando haya cambios de configuración en Git.
Pero la segunda parte es más interesante: alguien debe supervisar estas copias de seguridad. En algunos casos, esa persona deberá restaurar todo como estaba, y en otros, alertar a alguien de que hay un problema.
Por ejemplo, si aparece un nuevo usuario que no está registrado en las variables, es necesario eliminarlo del hack. Y si es una nueva regla de cortafuegos, es mejor no tocarla; puede ser que alguien simplemente activó la depuración o que un nuevo servicio, despistado, no la haya registrado según el reglamento, y ya hay personas utilizándolo.
A pesar de cualquier sistema de automatización y de la mano firme de la dirección, no escaparemos a cierta pequeña delta en la escala de toda la red. Para depurar problemas, nadie estará ingresando la configuración en los sistemas. Más aún, incluso podría no estarlo considerando el modelo de configuración.
Por ejemplo, una regla de cortafuegos para contar el número de paquetes a una dirección IP específica, para localizar problemas, es una configuración temporal bastante común.
Componente 10. Sistema de monitoreo
Al principio, no pensaba tratar el tema del monitoreo; es un tema extenso, polémico y complicado. Pero a medida que avanzaba, resultó ser una parte integral de la automatización. No se puede ignorar, incluso sin práctica.
Desarrollando la idea: es una parte orgánica del proceso de CI/CD. Después de implementar la configuración en la red, necesitamos poder determinar si todo está en orden.
Y no se trata solo de gráficos de uso de interfaces o disponibilidad de nodos, sino de aspectos más sutiles: la existencia de rutas necesarias, los atributos en ellas, el número de sesiones BGP, los vecinos OSPF, y la funcionalidad de extremo a extremo de los servicios superiores.
¿No se han dejado de almacenar los syslogs en el servidor externo, ni se ha roto el agente SFlow, ni han comenzado a aumentar las pérdidas en las colas, ni se ha interrumpido la conectividad entre algún par de prefijos?
En un artículo separado reflexionaremos sobre esto también.
Conclusión
Como base, elegí uno de los diseños modernos de redes de centros de datos: L3 Clos Fabric con BGP como protocolo de enrutamiento.
Esta vez construiremos la red en Juniper, porque ahora la interfaz JunOs es un sueño.
Complicaremos un poco las cosas utilizando solo herramientas de código abierto y una red multivendor; por eso, además de Juniper, elegiré otro afortunado a lo largo del camino.
El plan de publicaciones más cercano es aproximadamente el siguiente:
Primero hablaré sobre redes virtuales. En primer lugar, porque quiero, y en segundo, porque sin esto el diseño de la red de infraestructura no será muy claro.
Luego sobre el diseño de la red: topología, enrutamiento, políticas.
Montaremos un banco de pruebas.
Reflexionaremos y quizás practiquemos en la inicialización del dispositivo en la red.
Y luego sobre cada componente en detalles íntimos.
Y sí, no prometo terminar elegantemente este ciclo con una solución lista. 🙂
Enlaces útiles
- Antes de profundizar en la serie, vale la pena leer el libro de Natasha Samoylenko . Quizás también hacer .
- También será útil leer sobre el diseño de fábricas de centros de datos de Facebook, escrito por Petr Lapukhov.
- La documentación sobre la arquitectura (anteriormente Open Contrail) te dará una idea de cómo funciona el SDN basado en Overlay.
Gracias
Roman Gorge. Por los comentarios y correcciones.
Artyom Chernobay. Por el KDPV.
Fuente: habr.com
