

En He descrito un marco de automatización de redes. Según los comentarios, para algunas personas, incluso este primer enfoque al problema ya ha aclarado algunas cuestiones. Y esto me alegra mucho, porque nuestro objetivo en este ciclo no es cubrir Ansible con scripts de Python, sino construir un sistema.
Este mismo marco establece el orden en el que abordaremos la cuestión.
La virtualización de redes, que se aborda en esta edición, no encaja especialmente en la temática de ADSM, donde tratamos la automatización.
Pero veamos esto desde otra perspectiva.
Desde hace tiempo, muchos servicios utilizan la misma red. En el caso de un operador de telecomunicaciones, esto incluye 2G, 3G, LTE, banda ancha y B2B, por ejemplo. En el caso de un centro de datos: conectividad para diferentes clientes, Internet, almacenamiento en bloque, almacenamiento de objetos.
Y todos los servicios requieren aislamiento entre sí. Así surgieron las redes overlay.
Y todos los servicios no quieren esperar a que una persona los configure manualmente. Así surgieron los orquestadores y SDN.
El primer enfoque hacia la automatización sistemática de redes, más precisamente de su parte, se ha intentado desde hace tiempo y se ha implementado en muchos lugares: VMWare, OpenStack, Google Compute Cloud, AWS, Facebook.
Hoy vamos a profundizar en ello.
Contenido
- Causas
- Terminología
- Underlay — red física
- Overlay — red virtual
- Overlay desde ToR
- Overlay desde el host
- Ejemplo de Tungsten Fabric
- Comunicación dentro de una máquina física
- Comunicación entre máquinas virtuales ubicadas en diferentes máquinas físicas
- Salida al mundo exterior
- Preguntas Frecuentes
- Conclusión
- Enlaces útiles
Causas
Y ya que hemos mencionado este tema, vale la pena hablar de los antecedentes de la virtualización de redes. En realidad, este proceso no comenzó ayer.
Probablemente, hayas escuchado que la red siempre ha sido la parte más inercial de cualquier sistema. Y esto es cierto en todos los sentidos. La red es la base sobre la que se apoya todo, y hacer cambios en ella es bastante complicado: los servicios no toleran que la red esté caída. A menudo, la desactivación de un único nodo puede afectar a gran parte de las aplicaciones y tener un impacto en muchos clientes. En parte, por esta razón, el equipo de redes puede resistirse a cualquier cambio, porque ahora funciona de alguna manera (quizás ni siquiera sabemos cómo), y aquí hay que configurar algo nuevo, y no se sabe cómo afectará a la red.
Para no tener que esperar a que los administradores de red implementen VLAN y no tener que configurar servicios en cada nodo de la red, se idearon las superposiciones: redes superpuestas, de las cuales hay una gran variedad: GRE, IPinIP, MPLS, MPLS L2/L3VPN, VXLAN, GENEVE, MPLSoverUDP, MPLSoverGRE, etc.
Su atractivo radica en dos cosas simples:
- Solo se configuran los nodos finales: los nodos de tránsito no necesitan ser tocados. Esto acelera significativamente el proceso, y a veces incluso permite excluir al departamento de infraestructura de red del proceso de implementación de nuevos servicios.
- La carga está oculta profundamente dentro de los encabezados: los nodos de tránsito no necesitan saber nada sobre ella, sobre la direccionamiento en los hosts, las rutas de la red superpuesta. Esto significa que se necesita almacenar menos información en las tablas, por lo que se puede optar por dispositivos más simples y económicos.
En esta entrega no tan completa, no planeo revisar todas las tecnologías posibles, sino más bien describir el marco de trabajo de las redes de superposición en el centro de datos.
Toda la serie describirá un centro de datos compuesto por filas de racks homogéneos, en los que se instala el mismo equipo de servidores.
En este equipo se ejecutan máquinas virtuales/contenedores/servidores sin servidor que implementan servicios.
Terminología
En el ciclo el servidor llamaré programa a la parte del servidor de la comunicación cliente-servidor.
Las máquinas físicas en los racks las llamaremos servidores no .
Una máquina física es un ordenador x86 instalado en un rack. El término más comúnmente utilizado es host. Así que la llamaremos «máquinao host.
Hipervisor es una aplicación que se ejecuta en una máquina física, emulando los recursos físicos donde se ejecutan las Máquinas Virtuales. A veces, en la literatura y en la red, se usa la palabra «hipervisor» como sinónimo de «host».
Máquina virtual es el sistema operativo que se ejecuta en una máquina física sobre el hipervisor. Para nosotros, dentro del marco de este ciclo, no es tan importante si se trata de una verdadera máquina virtual o simplemente de un contenedor. Lo llamaremos «VM«
Inquilino es un concepto amplio que en este artículo definiré como un servicio separado o un cliente separado.
Multi-inquilino o multiarrendamiento es la utilización de una misma aplicación por diferentes clientes/servicios. En este caso, la aislamiento de los clientes entre sí se logra gracias a la arquitectura de la aplicación y no a instancias separadas en ejecución.
ToR — Switch ubicado en la parte superior del rack — un conmutador instalado en un rack al que se conectan todas las máquinas físicas.
Además de la topología ToR, diferentes proveedores practican End of Row (EoR) o Middle of Row (aunque esta última es bastante rara y no he encontrado las abreviaturas MoR).
Red subyacente o red subyacente o underlay — infraestructura de red física: conmutadores, enrutadores, cables.
Red de superposición o red de superposición o overlay — red virtual de túneles que opera sobre la física.
Fábrica L3 o fábrica IP — un increíble invento de la humanidad que permite no repetir STP en las entrevistas y no aprender TRILL. Una conceptualización en la que toda la red hasta el nivel de acceso es exclusivamente L3, sin VLAN y, por lo tanto, enormes dominios de difusión extendidos. En la próxima parte veremos de dónde proviene la palabra "fábrica".
SDN — Red Definida por Software. Apenas necesita presentación. Un enfoque para la gestión de redes en el que los cambios en la red son realizados no por una persona, sino por un programa. Generalmente significa llevar el Control Plane fuera de los dispositivos de red finales a un controlador.
NFV — Virtualización de Funciones de Red — la virtualización de dispositivos de red que propone que algunas funciones de la red se puedan ejecutar como máquinas virtuales o contenedores para acelerar la implementación de nuevos servicios, organizar la Cadena de Servicios y permitir una escalabilidad horizontal más sencilla.
VNF — Función de Red Virtual. Dispositivo virtual específico: enrutador, conmutador, firewall, NAT, IPS/IDS, etc.
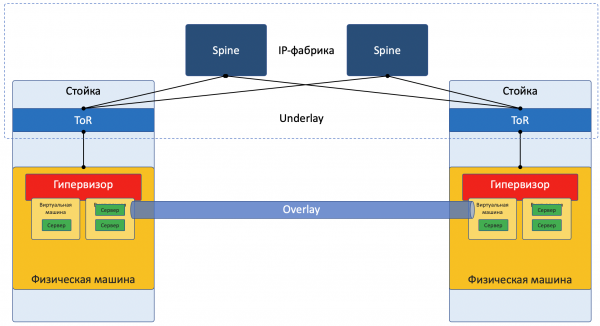
Ahora estoy simplificando intencionadamente la descripción a una implementación concreta para no confundir demasiado al lector. Para una lectura más reflexiva, lo remito a la sección . Además, Roma Gorge, quien critica este artículo por inexactitudes, promete escribir una edición separada sobre tecnologías de virtualización de servidores y redes, más profunda y detallada.
La mayoría de las redes hoy en día se pueden dividir claramente en dos partes:
Subyacente — red física con configuración estable.
Superposición — abstracción sobre la red subyacente para la aislamiento de inquilinos.
Esto es cierto tanto para el caso de los centros de datos (que abordaremos en este artículo), como para los ISP (que no vamos a discutir, ya que ya fue tratado en ). Con las redes empresariales, por supuesto, la situación es algo diferente.
Imagen centrada en la red:
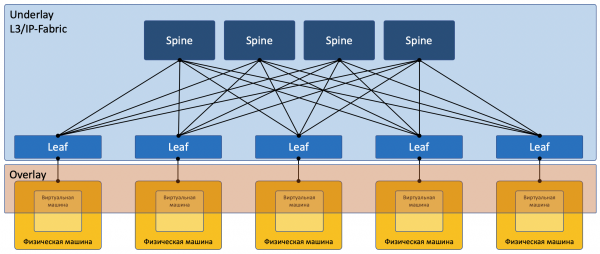
Subyacente
Underlay es una red física: conmutadores de hardware y cables. Los dispositivos en el underlay saben cómo llegar a las máquinas físicas.
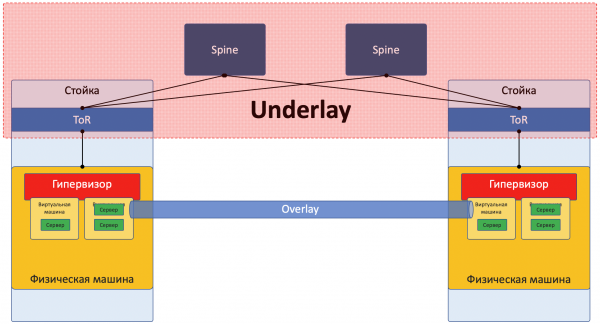
Se basa en protocolos y tecnologías estándar. No menos importante, porque los dispositivos de hardware todavía funcionan con software propietario que no permite la programación de chips ni la implementación de sus propios protocolos, por lo tanto, se necesita compatibilidad con otros proveedores y estandarización.
Pero alguien como Google puede permitirse desarrollar sus propios conmutadores y renunciar a los protocolos convencionales. Pero LAN_DC no es Google.
El underlay cambia relativamente poco, ya que su tarea es proporcionar conectividad IP básica entre máquinas físicas. El underlay no sabe nada sobre los servicios, clientes o tenantes que se ejecutan sobre él, solo necesita entregar un paquete de una máquina a otra.
Un ejemplo de underlay podría ser:
- IPv4+OSPF
- IPv6+ISIS+BGP+L3VPN
- L2+TRILL
- L2+STP
La red underlay se configura de forma clásica: CLI/GUI/NETCONF.
Manualmente, mediante scripts o herramientas propietarias.
Un artículo posterior de la serie se dedicará a explicar con más detalle el underlay.
Superposición
Overlay es una red virtual de túneles que se extiende sobre el underlay, permite que las máquinas virtuales de un cliente se comuniquen entre sí, garantizando la separación de otros clientes.
Los datos del cliente se encapsulan en encabezados de túnel para su transmisión a través de la red compartida.
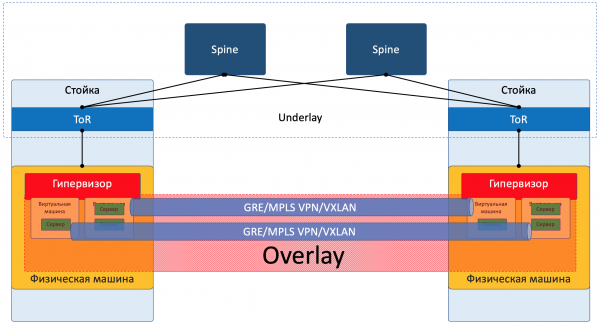
Así, las máquinas virtuales de un cliente (de un servicio) pueden comunicarse entre sí a través del overlay, sin saber realmente qué camino sigue el paquete.
Un ejemplo de overlay podría ser, como mencioné anteriormente:
- túnel GRE
- VXLAN
- EVPN
- L3VPN
- GENEVE
La red overlay se configura y se mantiene normalmente a través de un controlador central. Desde allí, la configuración, el Control Plane y el Data Plane se entregan a los dispositivos que manejan el enrutamiento y la encapsulación del tráfico del cliente. Un poco lo desglosaremos con ejemplos.
Sí, es SDN en su forma más pura.
Existen dos enfoques fundamentalmente diferentes para organizar una red overlay:
- Overlay desde ToR
- Overlay desde el host
Overlay desde ToR
El overlay puede comenzar en el conmutador de acceso (ToR) que está en el rack, como ocurre, por ejemplo, en el caso de una fábrica de VXLAN.
Este es un mecanismo probado en redes ISP y todos los proveedores de equipos de red lo apoyan.
Sin embargo, en este caso, el conmutador ToR debe ser capaz de separar los diferentes servicios, y el administrador de red debe colaborar hasta cierto punto con los administradores de máquinas virtuales y hacer cambios (aunque sea de manera automática) en la configuración de los dispositivos.
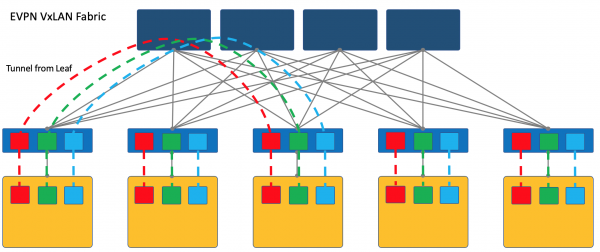
Aquí remito al lector al artículo sobre nuestro viejo amigo .
En este se describen detalladamente los enfoques para construir una red de centro de datos con una fábrica EVPN VXLAN.
Y para una inmersión más completa en la realidad, se puede leer el libro de Cisco .
Cabe señalar que VXLAN es solo un método de encapsulación y la terminación de túneles puede no ocurrir en el ToR, sino en el host, como sucede en el caso de OpenStack, por ejemplo.
Sin embargo, una fábrica VXLAN donde el overlay comienza en el ToR es uno de los diseños establecidos de red superpuesta.
Overlay desde el host
Otro enfoque es comenzar y terminar los túneles en los hosts finales.
En este caso, la red (Underlay) permanece lo más simple y estática posible.
Y el host se encarga de realizar todas las encapsulaciones necesarias.
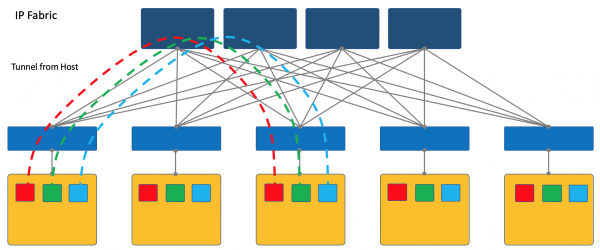
Para ello, sin duda, se requerirá ejecutar una aplicación especial en los hosts, pero vale la pena.
En primer lugar, es más fácil ejecutar un cliente en una máquina Linux o, digamos, es posible, mientras que en el conmutador probablemente tendrá que recurrir a soluciones SDN propietarias, lo que mata la idea de la multi-vendibilidad.
En segundo lugar, el conmutador ToR en este caso puede permanecer lo más simple posible, tanto desde el punto de vista del Control Plane como del Data Plane. De hecho, con el controlador SDN no necesita comunicarse y no es necesario almacenar las redes/ARP de todos los clientes conectados; basta con conocer la dirección IP de la máquina física, lo que simplifica enormemente las tablas de conmutación/ruteo.
En la serie ADS de M, elijo el enfoque de overlay desde el host; a partir de ahora solo hablaremos de eso y no volveremos a la fábrica VXLAN.
Es más fácil verlo con ejemplos. Y como sujeto, tomaremos la plataforma de SDN de código abierto OpenContrail, ahora conocida como .
Al final del artículo, presentaré algunas reflexiones sobre la analogía con OpenFlow y OpenvSwitch.
Ejemplo de Tungsten Fabric
En cada máquina física hay vRouter — un enrutador virtual que conoce las redes conectadas a él y a qué clientes pertenecen — en esencia — un enrutador PE. Para cada cliente, mantiene una tabla de enrutamiento aislada (lee VRF). Y el propio vRouter realiza el tunneling de superposición.
Un poco más sobre vRouter — al final del artículo.
Cada VM ubicada en el hipervisor se conecta al vRouter de esta máquina a través de .
TAP — Terminal Access Point — una interfaz virtual en el núcleo de Linux que permite la interacción de redes.
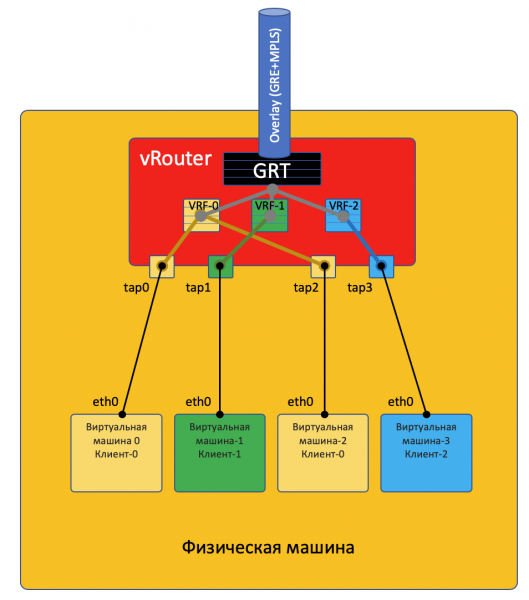
Si hay varias redes detrás del vRouter, se crea una interfaz virtual para cada una de ellas, a la cual se le asigna una dirección IP — esta será la dirección del gateway por defecto.
Todas las redes de un cliente se colocan en una VRF (una tabla), y las de diferentes clientes, en tablas distintas.
Haré aquí una salvedad, que no todo es tan simple, y enviaré al curioso lector al final del artículo..
Para que los vRouter puedan comunicarse entre sí, y, por ende, las VM que se encuentran detrás de ellos, intercambian información de enrutamiento a través de un controlador SDN.
Para salir al mundo exterior, existe un punto de salida de la matriz — el gateway de la red virtual VNGW — Virtual Network GateWay (término mío).
Ahora veamos ejemplos de comunicaciones — y quedará claro.
Comunicación dentro de una máquina física
VM0 quiere enviar un paquete a VM2. Supongamos por ahora que son VM de un mismo cliente.
Data Plane
- VM-0 tiene una ruta por defecto a su interfaz eth0. El paquete se envía allí.
Esta interfaz eth0 está en realidad conectada virtualmente con el enrutador virtual vRouter a través de la interfaz TAP tap0. - vRouter analiza en qué interfaz llegó el paquete, es decir, a qué cliente (VRF) corresponde, verifica la dirección del receptor con la tabla de enrutamiento de ese cliente.
- Al descubrir que el receptor está en la misma máquina bajo otro puerto, vRouter simplemente envía el paquete a él sin encabezados adicionales — para este caso, ya hay una entrada ARP en el vRouter.
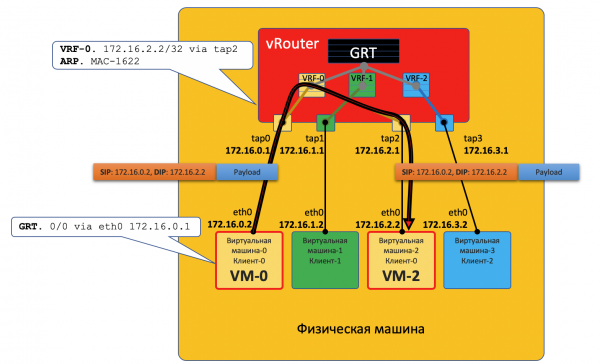
En este caso, el paquete no entra en la red física — se enrutó dentro del vRouter.
Control Plane
El hipervisor, al iniciar una máquina virtual, le informa:
- Su propia dirección IP.
- Ruta por defecto — a través de la dirección IP del vRouter en esta red.
El hipervisor informa al vRouter a través de una API especial:
- Que necesita crear una interfaz virtual.
- Qué Virtual Network necesita crear (VM).
- A qué VRF vincularlo (VN).
- La entrada ARP estática para esta VM muestra qué interfaz tiene su dirección IP y a qué dirección MAC está asociada.
Una vez más, el procedimiento real de interacción se ha simplificado para facilitar la comprensión del concepto.
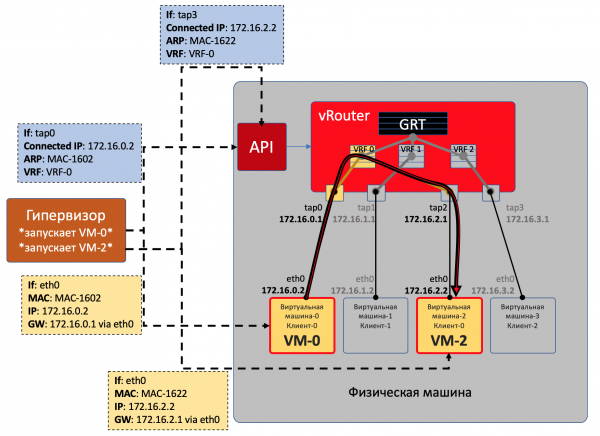
Así, todas las VMs de un cliente en esta máquina vRouter las ve como redes directamente conectadas y puede enrutar entre ellas.
Mientras que VM0 y VM1 pertenecen a diferentes clientes, por lo tanto, están en diferentes tablas de vRouter.
Si pueden comunicarse directamente entre sí depende de la configuración del vRouter y del diseño de la red.
Por ejemplo, si las VMs de ambos clientes usan direcciones públicas, o si el NAT ocurre en el propio vRouter, se puede hacer una ruta directa en el vRouter.
En la otra situación, puede haber una superposición de espacios de direcciones; se necesita pasar por un servidor NAT para obtener una dirección pública, lo que es similar a salir a redes externas, como se describirá más adelante.
Comunicación entre máquinas virtuales ubicadas en diferentes máquinas físicas
Data Plane
- El inicio es igual: VM-0 envía un paquete destinado a VM-7 (172.17.3.2) a su destino predeterminado.
- El vRouter lo recibe y esta vez ve que el destinatario está en otra máquina y es accesible a través del túnel Tunnel0.
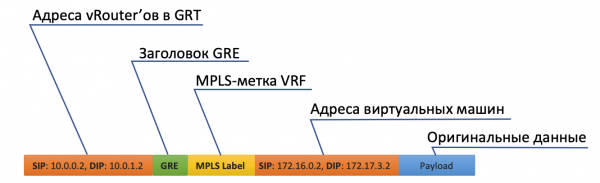
- Primero, coloca una etiqueta MPLS que identifica la interfaz remota, para que del otro lado el vRouter pueda determinar a dónde debe colocar este paquete sin bucles adicionales.
- Tunnel0 tiene como origen 10.0.0.2 y como destinatario 10.0.1.2.
El vRouter añade encabezados GRE (o UDP) y una nueva IP al paquete original. - En la tabla de enrutamiento del vRouter hay una ruta por defecto a través de la dirección ToR1 10.0.0.1. Envía allí.

- ToR1, como parte de la red Underlay, sabe (por ejemplo, a través de OSPF) cómo llegar a 10.0.1.2 y envía el paquete a lo largo de esa ruta. Tenga en cuenta que aquí se incluye ECMP. En la ilustración, hay dos next hops y diferentes flujos se distribuirán entre ellos mediante un hash. En un verdadero centro de datos, habría más como 4 next hops.
Sin embargo, no necesita saber qué hay bajo el encabezado IP externo. Es decir, en realidad, bajo IP podría haber un sándwich de IPv6 sobre MPLS sobre Ethernet sobre MPLS sobre GRE.
- Por lo tanto, en el lado receptor, el vRouter elimina el GRE y, según la etiqueta MPLS, entiende a qué interfaz debe entregar este paquete, lo desenreda y lo envía a su destinatario original.
Control Plane
Al iniciar la máquina, ocurre todo lo que se describió anteriormente.
Y además lo siguiente:
- Para cada cliente, el vRouter asigna una etiqueta MPLS. Esta es una etiqueta de servicio L3VPN, a través de la cual los clientes se segmentarán dentro de una misma máquina física.
De hecho, la etiqueta MPLS se asigna al vRouter incondicionalmente siempre, ya que no se sabe de antemano que la máquina solo interactuará con otras máquinas detrás del mismo vRouter, y probablemente no sea así.
- El vRouter establece una conexión con el controlador SDN mediante el protocolo BGP (o uno similar; en el caso de TF, es XMPP 0_o).
- A través de esta sesión, el vRouter informa al controlador SDN sobre las rutas a las redes conectadas:
- Dirección de la red
- Método de encapsulación (MPLSoGRE, MPLSoUDP, VXLAN)
- Etiqueta MPLS del cliente
- Su dirección IP como nexthop
- El controlador SDN recibe estas rutas de todos los vRouter conectados y las refleja a otros. Es decir, actúa como un Route Reflector.
Lo mismo ocurre en dirección opuesta.
El overlay puede cambiar cada minuto. Así es como sucede en las nubes públicas, cuando los clientes inician y detienen regularmente sus máquinas virtuales.
El controlador central asume todas las complejidades del mantenimiento de la configuración y el control de las tablas de conmutación/ruteo en el vRouter.
En términos generales, el controlador se conecta a todos los vRouter a través de BGP (o un protocolo similar) y simplemente transmite la información de enrutamiento. BGP, por ejemplo, ya tiene un Address-Family para la transmisión del método de encapsulación. o .
De este modo, la configuración de la red Underlay no se modifica de ninguna manera, que, por cierto, es mucho más compleja de automatizar, y es más fácil romperla con un movimiento torpe.
Salida al mundo exterior
En algún momento, la simulación debe terminar, y se necesita salir del mundo virtual hacia el real. Y se requiere un gateway telefónico.
Se practican dos enfoques:
- Se instala un router de hardware.
- Se ejecuta algún appliance que implementa las funciones de un router (sí, después de SDN, también nos encontramos con VNF). Llamémoslo gateway virtual.
La ventaja del segundo enfoque es la escalabilidad horizontal económica: si no hay suficiente potencia, se puede iniciar otra máquina virtual con el gateway. En cualquier máquina física, sin necesidad de buscar racks disponibles, unidades, suministro de energía, comprar el hardware, transportarlo, instalarlo, conectarlo, configurarlo y luego reemplazar los componentes defectuosos.
Las desventajas de un gateway virtual son que una unidad física de router es significativamente más potente que una máquina virtual multicore, y su software, ajustado a su propia base de hardware, funciona de manera mucho más estable (no). No se puede negar el hecho de que el complejo de hardware y software simplemente funciona, requiriendo solo configuración, mientras que el lanzamiento y mantenimiento de un gateway virtual es tarea para ingenieros capacitados.
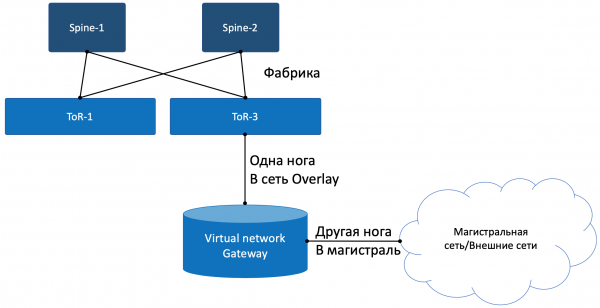
Con una de sus patas, el gateway observa la red virtual Overlay, como una Máquina Virtual normal, y puede interactuar con todas las otras VM. Al mismo tiempo, puede terminar las redes de todos los clientes y, en consecuencia, llevar a cabo la ruta entre ellas.
Con la otra pata, el gateway observa la red troncal y sabe cómo llegar a Internet.
Data Plane
Es decir, el proceso se ve así:
- VM-0, teniendo por defecto el mismo vRouter, envía un paquete con un destinatario en el mundo exterior (185.147.83.177) a la interfaz eth0.
- El vRouter recibe este paquete y hace una consulta de la dirección de destino en la tabla de rutas, encontrando la ruta predeterminada a través del gateway VNGW1 a través del Tunnel 1.
También ve que este es un túnel GRE con SIP 10.0.0.2 y DIP 10.0.255.2, y además es necesario primero agregar la etiqueta MPLS de este cliente, que espera VNGW1. - El vRouter empaqueta el paquete original en encabezados MPLS, GRE y una nueva IP, y lo envía a la dirección ToR1 10.0.0.1 por defecto.
- La red subyacente entrega el paquete al gateway VNGW1.
- El gateway VNGW1 quita los encabezados de túnel GRE y MPLS, ve la dirección de destino, consulta su tabla de enrutamiento y comprende que está destinado a Internet, por lo que va a través de Full View o Default. Realiza NAT si es necesario.
- Desde VNGW hasta la frontera puede haber una red IP normal, lo cual es poco probable.
Puede haber una red MPLS clásica (IGP+LDP/RSPV TE), puede ser una fábrica inversa con BGP LU o un túnel GRE desde VNGW hasta la frontera a través de una red IP.
De cualquier manera, VNGW1 realiza las encapsulaciones necesarias y envía el paquete original hacia la frontera.
El tráfico en la dirección inversa pasa por los mismos pasos en orden contrario.
- La frontera entrega el paquete a VNGW1.
- Este lo desmantela, observa la dirección del destinatario y ve que está disponible a través del túnel Tunnel1 (MPLSoGRE o MPLSoUDP).
- En consecuencia, añade la etiqueta MPLS, el encabezado GRE/UDP y una nueva IP, y envía a su ToR3 10.0.255.1.
La dirección de destino del túnel es la dirección IP del vRouter detrás del cual se encuentra la VM objetivo: 10.0.0.2. - La red subyacente envía el paquete al vRouter correspondiente.
- El vRouter objetivo extrae GRE/UDP, determina la interfaz según la etiqueta MPLS y envía el paquete IP puro a su interfaz TAP, vinculada con eth0 de la VM.
Control Plane
VNGW1 establece la vecindad BGP con el controlador SDN, desde el cual recibe toda la información de rutas sobre los clientes: qué cliente está detrás de qué dirección IP (vRouter) y qué etiqueta MPLS lo identifica.
De manera similar, informa al controlador SDN de la ruta por defecto con la etiqueta de este cliente, señalando a sí mismo como nexthop. Luego, esta ruta por defecto llega a los vRouters.
En VNGW, generalmente se realiza la agregación de rutas o la traducción NAT.
Y en el otro sentido, para la sesión con los bordes o Route Reflectors, entrega precisamente esta ruta agregada. Y de ellos recibe la ruta por defecto o Full-View, o algo más.
En términos de encapsulación y intercambio de tráfico, VNGW no se diferencia del vRouter.
Si se amplía un poco el ámbito, a VNGW y vRouters se les pueden añadir otros dispositivos de red, como firewalls, granjas de limpieza o enriquecimiento de tráfico, IPS, etc.
Y mediante la creación secuencial de VRF y el anuncio adecuado de rutas, se puede hacer que el tráfico circule como desee, lo que se llama Service Chaining.
Es decir, aquí el controlador SDN actúa como Route-Reflector entre VNGW, vRouters y otros dispositivos de red.
Pero de hecho, el controlador también envía información sobre ACL y PBR (Routing Basado en Políticas), forzando a flujos de tráfico individuales a no seguir lo que indica la ruta.
Preguntas Frecuentes
¿Por qué siempre mencionas GRE/UDP?
Bueno, en realidad, se podría decir que es específico de Tungsten Fabric; se puede ignorar por completo.
Sin embargo, si tomamos en cuenta, TF, incluso cuando era OpenContrail, admitía ambas encapsulaciones: MPLS in GRE y MPLS in UDP.
UDP es bueno porque en el Puerto de Origen de su encabezado se puede codificar fácilmente una función hash de las direcciones IP+Proto+Port originales, lo que permite hacer balanceo.
En el caso de GRE, desafortunadamente, solo hay encabezados externos IP y GRE que son idénticos para todo el tráfico encapsulado, y no se puede hablar de balanceo, ya que pocos pueden mirar tan profundamente dentro del paquete.
Durante un tiempo, los enrutadores, si sabían hacer túneles dinámicos, solo podían hacerlo en MPLSoGRE, y recién hace poco aprendieron a hacerlo en MPLSoUDP. Por lo tanto, siempre es necesario hacer una mención sobre la posibilidad de dos diferentes encapsulaciones.
A modo de justicia, vale la pena mencionar que TF también soporta conectividad L2 mediante VXLAN.
Prometiste establecer paralelismos con OpenFlow.
De hecho, son bastante evidentes. vSwitch en OpenStack realiza cosas muy similares, utilizando VXLAN, que, por cierto, también tiene un encabezado UDP.
En el Data Plane funcionan de manera similar, aunque el Control Plane varía considerablemente. Tungsten Fabric utiliza XMPP para entregar información sobre rutas a vRouter, mientras que en OpenStack funciona OpenFlow.
¿Puedes contarme un poco más sobre vRouter?
Se divide en dos partes: vRouter Agent y vRouter Forwarder.
El primero se ejecuta en el User Space del sistema operativo anfitrión y se comunica con el controlador SDN, intercambiando información sobre rutas, VRF y ACL.
El segundo implementa el Data Plane, generalmente en el Kernel Space, pero puede ejecutarse también en SmartNICs: tarjetas de red con CPU y un chip de conmutación programable separado, lo que permite aliviar la carga de la CPU de la máquina anfitriona, haciendo que la red sea más rápida y predecible.
También es posible un escenario donde vRouter sea una aplicación DPDK en User Space.
vRouter Agent transfiere configuraciones al vRouter Forwarder.
¿Qué es la Red Virtual?
Mencioné al principio del artículo sobre VRF, que cada inquilino se asocia a su VRF. Y aunque esto fue suficiente para una comprensión superficial del funcionamiento de la red de superposición, a la siguiente iteración ya es necesario hacer aclaraciones.
Normalmente, en los mecanismos de virtualización, la entidad Red Virtual (se puede considerar esto un nombre propio) se introduce por separado de los clientes/inquilinos/maquinas virtuales - una entidad completamente independiente. Y esta Red Virtual se puede conectar a uno, dos o más inquilinos a través de interfaces. Así, por ejemplo, se realiza el Service Chaining, donde el tráfico debe pasar a través de ciertos nodos en un orden específico, simplemente creando y vinculando Redes Virtuales en la secuencia correcta.
Por lo tanto, no hay una correspondencia directa entre la Red Virtual y el inquilino.
Conclusión
Esta es una descripción bastante superficial del funcionamiento de la red virtual con un overlay desde el host y el controlador SDN. Pero cualquier plataforma de virtualización que tomes hoy funcionará de manera similar, ya sea VMWare, ACI, OpenStack, CloudStack, Tungsten Fabric o Juniper Contrail. Variarán en los tipos de encapsulaciones y encabezados, así como en los protocolos de entrega de información a los dispositivos de red finales, pero el principio de la red overlay programable que opera sobre una red subyacente relativamente simple y estática seguirá siendo el mismo.
Se puede decir que en el ámbito de la creación de nubes privadas, el SDN basado en redes overlay ha ganado en la actualidad. Sin embargo, esto no significa que Openflow no tenga un lugar en el mundo moderno—se utiliza en OpenStack y en el mismo VMWare NSX, y, hasta donde sé, Google lo utiliza para configurar la red subyacente.
Más abajo he proporcionado enlaces a materiales más detallados si deseas investigar el tema más a fondo.
¿Y qué pasa con nuestro Underlay?
En realidad, nada. No ha cambiado en absoluto. Todo lo que necesita hacer en el caso de un overlay desde el host es actualizar rutas y ARP a medida que aparecen y desaparecen vRouter/VNGW y trasladar paquetes entre ellos.
Formulemos una lista de requisitos para la red Underlay.
- Ser compatible con algún protocolo de enrutamiento, en nuestro caso—BGP.
- Tener un ancho de banda amplio, preferiblemente sin sobre-suscripción, para no perder paquetes debido a la congestión.
- Soporte para ECMP—una parte integral de la fábrica.
- Capacidad para garantizar QoS, incluyendo cosas complejas como ECN.
- Soporte para NETCONF—una preparación para el futuro.
He dedicado muy poco tiempo al funcionamiento de la red Underlay aquí. Esto se debe a que en el resto de la serie me centraré precisamente en ella, mientras que el Overlay solo lo tocaremos de manera superficial.
Obviamente, me estoy limitando al usar como ejemplo una red de centro de datos construida sobre la fábrica de ClouZ con enrutamiento IP puro y un overlay desde el host.
Sin embargo, estoy seguro de que cualquier red que tenga un diseño puede describirse en términos formales y automatizarse. Simplemente, aquí estoy persiguiendo el objetivo de entender los enfoques para la automatización, y no complicar las cosas al resolver el problema en un sentido general.
Dentro del ADSM, Roman Gorge y yo planeamos publicar una edición separada sobre la virtualización de potencias de cálculo y su interacción con la virtualización de la red. Mantente en contacto.
Enlaces útiles
- .
- . 6 horas sobre Yandex.Cloud, donde también se aborda la red virtual en TF.
- .
- . Aquí se describe toda la red del centro de datos, incluyendo Underlay, Overlay, enfoques de multi-homing y gestión.
Gracias
- — ex presentador del podcast linkmeup, y ahora experto en plataformas en la nube. Por sus comentarios y correcciones. Además, esperamos pronto su artículo más profundo sobre virtualización.
- — mi colega y experto en el desarrollo de redes virtuales. Por sus comentarios y correcciones.
- — mi colega y experto en Tungsten Fabric. Por sus comentarios y correcciones.
- — ilustrador de linkmeup. Por su KDPV.
- Alexander Limonov. Por el meme «automato».
Fuente: habr.com
