

La escalabilidad es un requisito clave para las aplicaciones en la nube. Con Kubernetes, escalar una aplicación es tan sencillo como aumentar el número de réplicas para el despliegue correspondiente o ReplicaSet — pero es un proceso manual.
Kubernetes permite escalar automáticamente las aplicaciones (es decir, los Pods en un despliegue o ReplicaSet) de manera declarativa utilizando la especificación Horizontal Pod Autoscaler. Por defecto, el criterio para la escalabilidad automática son las métricas de uso de CPU (métricas de recursos), pero se pueden integrar métricas personalizadas y métricas proporcionadas externamente.
Comando ha traducido un artículo sobre cómo utilizar métricas externas para la escalabilidad automática de aplicaciones Kubernetes. Para mostrar cómo funciona todo, el autor utiliza métricas de solicitudes de acceso HTTP, que se recopilan utilizando Prometheus.
En lugar de la escalabilidad horizontal de pods, se aplica Kubernetes Event Driven Autoscaling (KEDA) — un operador de Kubernetes de código abierto. Se integra inicialmente con Horizontal Pod Autoscaler para proporcionar una escalabilidad fluida (incluyendo hasta/de cero) para cargas de trabajo impulsadas por eventos. El código está disponible en .
Resumen breve del funcionamiento del sistema
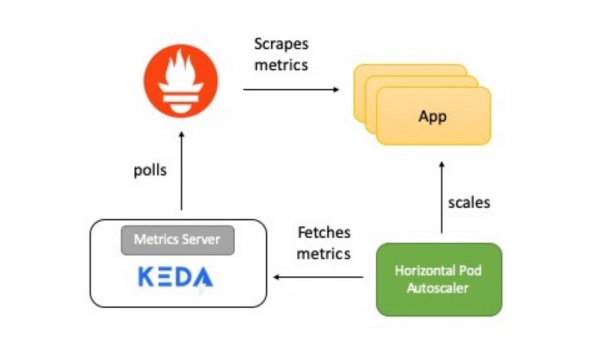
En el diagrama — una descripción breve de cómo funciona todo:
- La aplicación proporciona métricas de la cantidad de solicitudes a HTTP en formato Prometheus.
- Prometheus está configurado para recopilar estas métricas.
- El escalador de Prometheus en KEDA está configurado para escalar automáticamente la aplicación en función de la cantidad de solicitudes a HTTP.
Ahora hablaré en detalle sobre cada elemento.
KEDA y Prometheus
Prometheus es un conjunto de herramientas de monitoreo y alerta de código abierto, parte de . Recopila métricas de diversas fuentes y las almacena como datos de series temporales. Para visualizar los datos, se pueden usar u otras herramientas de visualización que trabajan con la API de Kubernetes.
KEDA soporta el concepto de escalador — actúa como un puente entre KEDA y un sistema externo. La implementación del escalador es específica para cada sistema objetivo y extrae datos de él. Luego, KEDA los utiliza para gestionar la escalabilidad automática.
Los escaladores admiten múltiples fuentes de datos, como Kafka, Redis y Prometheus. Es decir, KEDA se puede usar para la escalabilidad automática de implementaciones de Kubernetes, utilizando métricas de Prometheus como criterios.
Aplicación de prueba
La aplicación de prueba en Golang proporciona acceso HTTP y realiza dos funciones importantes:
- Utiliza la biblioteca cliente de Prometheus Go para instrumentar la aplicación y ofrecer la métrica http_requests, que contiene un contador de accesos. El punto final, donde las métricas de Prometheus están disponibles, se encuentra en el URI
/metrics.var httpRequestsCounter = promauto.NewCounter(prometheus.CounterOpts{ Name: "http_requests", Help: "número de solicitudes http", }) - En respuesta a la solicitud
GETla aplicación incrementa el valor de la clave (access_count) en Redis. Esta es una forma sencilla de llevar a cabo la tarea como parte del controlador HTTP, así como verificar las métricas de Prometheus. El valor de la métrica debe ser igual aaccess_counten Redis.func main() { http.Handle("/metrics", promhttp.Handler()) http.HandleFunc("/test", func(w http.ResponseWriter, r *http.Request) { defer httpRequestsCounter.Inc() count, err := client.Incr(redisCounterName).Result() if err != nil { fmt.Println("No fue posible incrementar el contador de redis", err) os.Exit(1) } resp := "Accedido en " + time.Now().String() + "nCuenta de accesos " + strconv.Itoa(int(count)) w.Write([]byte(resp)) }) http.ListenAndServe(":8080", nil) }
La aplicación se implementa en Kubernetes a través de Deployment. También se crea un servicio ClusterIP, que permite al servidor de Prometheus recibir métricas de la aplicación.
Aquí .
Servidor Prometheus
El manifiesto de implementación de Prometheus consiste en:
ConfigMap— para transmitir la configuración de Prometheus;Deployment— para implementar Prometheus en el clúster de Kubernetes;ClusterIP— servicio para acceder a la interfaz de usuario de Prometheus;ClusterRole,ClusterRoleBindingyServiceAccount— para la función de auto-descubrimiento de servicios en Kubernetes (Auto-discovery).
Aquí .
KEDA Prometheus ScaledObject
El escalador actúa como un puente entre KEDA y el sistema externo del cual se deben obtener métricas. ScaledObject — es un recurso configurable que debe implementarse para sincronizar la implementación con la fuente de eventos, en este caso, con Prometheus.
ScaledObject contiene información sobre el escalado de la implementación, metadatos sobre la fuente de eventos (por ejemplo, secretos para la conexión, nombre de la cola), intervalo de sondeo, período de recuperación y otros datos. Se traduce en el recurso de auto-escalado correspondiente (definición de HPA) para escalar la implementación.
Cuando el objeto ScaledObject se elimina, se limpia la definición correspondiente de HPA.
Aquí está la definición ScaledObject para nuestro ejemplo, se utiliza un escalador Prometheus:
apiVersion: keda.k8s.io/v1alpha1
kind: ScaledObject
metadata:
 name: prometheus-scaledobject
 namespace: default
 labels:
   deploymentName: go-prom-app
spec:
 scaleTargetRef:
   deploymentName: go-prom-app
 pollingInterval: 15
 cooldownPeriod:  30
 minReplicaCount: 1
 maxReplicaCount: 10
 triggers:
 - type: prometheus
   metadata:
     serverAddress:
http://prometheus-service.default.svc.cluster.local:9090
     metricName: access_frequency
     threshold: '3'
     query: sum(rate(http_requests[2m]))
Tenga en cuenta lo siguiente:
- Se refiere a
Deploymentllamadogo-prom-app. - El tipo de disparador es
Prometheus. La dirección del servidor Prometheus se menciona junto con el nombre de la métrica, el valor umbral y , que se utilizará. La consulta PromQL essum(rate(http_requests[2m])). - Según
pollingInterval, KEDA consulta el objetivo a Prometheus cada quince segundos. Se admite un mínimo de un pod (minReplicaCount), y el número máximo de pods no superamaxReplicaCount(en este ejemplo, diez).
Se puede establecer en minReplicaCount cero. En este caso, KEDA activa el despliegue de cero a uno, y luego proporciona HPA para escalado automático adicional. También es posible el orden inverso, es decir, escalar de uno a cero. En nuestro ejemplo, no seleccionamos cero, ya que se trata de un servicio HTTP, no de un sistema bajo demanda.
La magia dentro del escalado automático
El valor umbral se utiliza como disparador para escalar el despliegue. En nuestro ejemplo, la consulta PromQL sum(rate (http_requests [2m])) devuelve el valor agregado de la tasa de solicitudes HTTP (número de solicitudes por segundo), medido en los últimos dos minutos.
Dado que el valor umbral es tres, habrá un pod mientras el valor sea sum(rate (http_requests [2m])) inferior a tres. Sin embargo, si el valor aumenta, se añade un pod adicional cada vez que sum(rate (http_requests [2m])) aumenta en tres. Por ejemplo, si el valor va de 12 a 14, entonces el número de pods es cuatro.
¡Ahora intentemos configurarlo!
Configuración preliminar
Todo lo que necesita es un clúster de Kubernetes y la herramienta configurada kubectl. En este ejemplo se utiliza un clúster minikube, pero puede usar cualquier otro. Para instalar el clúster hay .
Instalar la última versión en Mac:
curl -Lo minikube
https://storage.googleapis.com/minikube/releases/latest/minikube-linux-amd64
&& chmod +x minikube
sudo mkdir -p /usr/local/bin/
sudo install minikube /usr/local/bin/
Instala , para acceder al clúster de Kubernetes.
Instalar la última versión en Mac:
curl -LO
"https://storage.googleapis.com/kubernetes-release/release/$(curl -s
https://storage.googleapis.com/kubernetes-release/release/stable.txt)/bin/darwin/amd64/kubectl"
chmod +x ./kubectl
sudo mv ./kubectl /usr/local/bin/kubectl
kubectl version
Instalación de KEDA
Puede desplegar KEDA de varias maneras, las cuales se enumeran en . Estoy utilizando un YAML monolítico:
kubectl apply -f
https://raw.githubusercontent.com/kedacore/keda/master/deploy/KedaScaleController.yaml
KEDA y sus componentes se instalan en el espacio de nombres keda. El comando para verificar:
kubectl get pods -n keda
Espere a que el pod del Operador KEDA inicie — cambie a Running State. Y después continue.
Instalación de Redis usando Helm
Si no tiene Helm instalado, utilice esto . El comando para la instalación en Mac:
brew install kubernetes-helm
helm init --history-max 200
helm init inicializa la interfaz de la línea de comandos local, así como instala Tiller en el clúster de Kubernetes.
kubectl get pods -n kube-system | grep tiller
Espere a que el pod de Tiller cambie al estado Running.
Nota del traductor: El autor utiliza Helm@2, que requiere la instalación del componente servidor Tiller. Actualmente, Helm@3 es el vigente, para el cual no se necesita la parte de servidor.
Después de instalar Helm, para ejecutar Redis se necesita un solo comando:
helm install --name redis-server --set cluster.enabled=false --set
usePassword=false stable/redis
Asegúrese de que Redis se haya iniciado correctamente:
kubectl get pods/redis-server-master-0
Espere a que el pod de Redis cambie al estado En ejecución.
Despliegue de la aplicación
Comando para desplegar:
kubectl apply -f go-app.yaml

//output
deployment.apps/go-prom-app created
service/go-prom-app-service created
Verifique que todo se haya iniciado:
kubectl get pods -l=app=go-prom-app
Espere a que Redis cambie al estado En ejecución.
Despliegue del servidor Prometheus
El manifiesto de Prometheus utiliza . Esto permite descubrir dinámicamente los pods de la aplicación en función de la etiqueta del servicio.
kubernetes_sd_configs:
   - role: service
   relabel_configs:
   - source_labels: [__meta_kubernetes_service_label_run]
     regex: go-prom-app-service
     action: keep
Para el despliegue:
kubectl apply -f prometheus.yaml

//output
clusterrole.rbac.authorization.k8s.io/prometheus created
serviceaccount/default configured
clusterrolebinding.rbac.authorization.k8s.io/prometheus created
configmap/prom-conf created
deployment.extensions/prometheus-deployment created
service/prometheus-service created
Verifique que todo se haya iniciado:
kubectl get pods -l=app=prometheus-server
Espere a que el pod de Prometheus cambie al estado En ejecución.
desde cualquier lugar del mundo. Es la solución ideal para crear una oficina en la nube, donde todos los programas y datos de los empleados están en un entorno seguro kubectl port-forward para acceder a la interfaz de usuario de Prometheus (o al servidor API) en la dirección .
kubectl port-forward service/prometheus-service 9090
Despliegue de la configuración de escalado automático de KEDA
Comando para crear ScaledObject:
kubectl apply -f keda-prometheus-scaledobject.yaml
Verifique los registros del operador KEDA:
KEDA_POD_NAME=$(kubectl get pods -n keda
-o=jsonpath='{.items[0].metadata.name}')
kubectl logs $KEDA_POD_NAME -n keda
El resultado se verá algo así:
time="2019-10-15T09:38:28Z" level=info msg="Observando ScaledObject:
default/prometheus-scaledobject"
time="2019-10-15T09:38:28Z" level=info msg="HPA creado con
namespace default y nombre keda-hpa-go-prom-app"
Verifique los pods de la aplicación. Debe estar en funcionamiento una instancia, ya que minReplicaCount es igual a 1:
kubectl get pods -l=app=go-prom-app
Verifique que el recurso HPA se haya creado correctamente:
kubectl get hpa
Debería ver algo como:
NOMBRE                   REFERENCIA                OBJETIVOS     MINPODS   MAXPODS   REPLICAS   EDAD
keda-hpa-go-prom-app   Deployment/go-prom-app   0/3 (promedio)   1         10        1          45s
Verificación de disponibilidad: acceso a la aplicación
Para acceder al punto final REST de nuestra aplicación, ejecute:
kubectl port-forward service/go-prom-app-service 8080
Ahora puedes acceder a la aplicación Go utilizando la dirección . Para ello, ejecute el comando:
curl http://localhost:8080/test
El resultado se verá algo así:
Accedido el 2019-10-21 11:29:10.560385986 +0000 UTC
m=+406004.817901246
Contador de accesos 1
En esta etapa, también verifique Redis. Verá que la clave access_count ha aumentado a 1:
kubectl exec -it redis-server-master-0 -- redis-cli get access_count
//output
"1"
Asegúrese de que el valor de la métrica http_requests sea el mismo:
curl http://localhost:8080/metrics | grep http_requests
//output
# HELP http_requests número de solicitudes HTTP
# TYPE http_requests contador
http_requests 1
Generando carga
Usaremos — una utilidad para generar carga:
curl -o hey https://storage.googleapis.com/hey-release/hey_darwin_amd64
&& chmod a+x hey
También puede descargar la utilidad para o .
Ejecutela:
./hey http://localhost:8080/test
Por defecto, la utilidad envía 200 solicitudes. Puede verificar esto utilizando métricas de Prometheus, así como Redis.
curl http://localhost:8080/metrics | grep http_requests
//output
# HELP http_requests número de solicitudes HTTP
# TYPE http_requests contador
http_requests 201
kubectl exec -it redis-server-master-0 -- redis-cli get access_count
//output
201
Confirme el valor de la métrica real (devuelta por la consulta PromQL):
curl -g
'http://localhost:9090/api/v1/query?query=sum(rate(http_requests[2m]))'
//output
{"status":"success","data":{"resultType":"vector","result":[{"metric":{},"value":[1571734214.228,"1.686057971014493"]}]}}
En este caso, el resultado real es 1,686057971014493 y se muestra en el campo value. Esto no es suficiente para escalar, ya que nuestro umbral establecido es 3.
¡Más carga!
En una nueva terminal, supervise la cantidad de pods de la aplicación:
kubectl get pods -l=app=go-prom-app -w
Aumentemos la carga con el comando:
./hey -n 2000 http://localhost:8080/test
Después de un tiempo, verá que HPA escala el despliegue y lanza nuevos pods. Verifique HPA para confirmar:
kubectl get hpa
NOMBRE                   REFERENCIA                OBJETIVOS         MINPODS   MAXPODS   REPLICAS   EDAD
keda-hpa-go-prom-app   Deployment/go-prom-app   1830m/3 (promedio)   1         10        6          4m22s
Si la carga es inconstante, el despliegue se reducirá a un punto en el que solo funcione un pod. Si desea verificar la métrica real (devuelta por la consulta PromQL), utilice el siguiente comando:
curl -g
'http://localhost:9090/api/v1/query?query=sum(rate(http_requests[2m]))'
Limpiar
//Delete KEDA
kubectl delete namespace keda
//Delete the app, Prometheus server and KEDA scaled object
kubectl delete -f .
//Delete Redis
helm del --purge redis-server
Conclusión
KEDA permite escalar automáticamente sus despliegues de Kubernetes (hasta/bajo cero) basándose en datos de métricas externas. Por ejemplo, basándose en métricas de Prometheus, longitud de la cola en Redis, o latencia del consumidor en el tema de Kafka.
KEDA se integra con una fuente externa y proporciona sus métricas a través del Metrics Server para el Horizontal Pod Autoscaler.
¡Éxitos!
Qué más leer:
- .
- .
- .
Fuente: habr.com
