

En los grandes sistemas en la nube, la cuestión del balanceo automático o la distribución de la carga sobre los recursos computacionales es especialmente crítica. Este problema también ha sido abordado por Tionix (desarrollador y operador de servicios en la nube, que forma parte del grupo de empresas de Rostelecom).
Y, dado que nuestra plataforma principal de desarrollo es OpenStack, y al igual que todas las personas, somos un poco perezosos, se decidió seleccionar algún módulo ya disponible en la plataforma. Nuestra elección recayó en Watcher, que decidimos utilizar para nuestras necesidades.
Primero, aclaremos los términos y definiciones.
Términos y definiciones
El objetivo — es un resultado final legible, observable y medible que debe ser alcanzado. Para cada objetivo hay una o más estrategias. Estrategia es la implementación de un algoritmo que puede encontrar una solución para dicho objetivo.
Acción (Action) — es una tarea elemental que cambia el estado actual del recurso controlado del clúster OpenStack, como: migración de una máquina virtual (migration), cambio del estado de alimentación de un nodo (change_node_power_state), cambio del estado del servicio nova (change_nova_service_state), cambio de sabor (resize), registro de un mensaje NOP (nop), ausencia de acciones durante un período de tiempo determinado — pausa (sleep), migración de un disco (volume_migrate).
Plan de acción (Action Plan) — es un flujo específico de acciones realizadas en un orden determinado para alcanzar un objetivo concreto. El plan de acción también incluye una eficiencia global evaluada con un conjunto de indicadores de rendimiento. El plan de acción es generado por Watcher tras un auditoría exitosa, durante la cual la estrategia utilizada encuentra una solución para alcanzar el objetivo. El plan de acción consiste en una lista de acciones secuenciales.
Auditoría (Audit) — es una solicitud para la optimización del clúster. La optimización se realiza para alcanzar un objetivo en dicho clúster. Para cada auditoría exitosa, Watcher genera un plan de acción.
Ámbito de la auditoría (Audit Scope) es un conjunto de recursos mediante el cual se lleva a cabo la auditoría (zona(s) de disponibilidad, agregadores de nodos, nodos computacionales individuales o nodos de almacenamiento, etc.). El ámbito de la auditoría está definido en cada plantilla. Si no se especifica un ámbito de auditoría, se audita todo el clúster.
Plantilla de auditoría (Audit Template) es un conjunto guardado de configuraciones para ejecutar auditorías. Las plantillas son necesarias para ejecutar auditorías repetidamente con las mismas configuraciones. La plantilla debe incluir obligatoriamente el objetivo de la auditoría; si no se especifican estrategias, se eligen las más adecuadas de las estrategias existentes.
Clúster (Cluster) es un conjunto de máquinas físicas que proporcionan recursos computacionales, recursos de almacenamiento y recursos de red, y son gestionadas por el mismo nodo controlador de OpenStack.
Modelo de datos del clúster (Cluster Data Model, CDM) es una representación lógica del estado actual y la topología de los recursos gestionados por el clúster.
Indicador de eficacia (Efficacy Indicator) es un indicador que señala cómo se está ejecutando la solución creada con esta estrategia. Los indicadores de eficacia son específicos para cada objetivo y generalmente se utilizan para calcular la eficacia global del plan de acción final.
Especificación de eficacia (Efficacy Specification) es un conjunto de características específicas asociadas a cada Objetivo, que define diferentes indicadores de eficacia que la estrategia, encargada de lograr el objetivo correspondiente, debe cumplir en su solución. De hecho, cada solución propuesta por la estrategia será verificada en cuanto a su cumplimiento con la especificación antes de calcular su eficacia global.
Motor de puntuación (Scoring Engine) es un archivo ejecutable que tiene entradas definidas de manera clara, salidas definidas de manera clara y realiza una tarea puramente matemática. De este modo, el cálculo no depende del entorno en el que se ejecuta; dará el mismo resultado en cualquier lugar.
Planificador Watcher (Watcher Planner) — parte del mecanismo de toma de decisiones de Watcher. Este módulo acepta un conjunto de acciones generadas por la estrategia y crea un plan de trabajo que determina cómo programar en el tiempo estas diversas acciones y cuáles son las condiciones previas para cada acción.
Objetivos y estrategias de Watcher
El objetivo
Estrategias
Objetivo ficticio
Estrategia ficticia
Estrategia ficticia utilizando motores de puntuación de muestra
Estrategia ficticia con cambio de tamaño
Ahorro de energía
Estrategia de ahorro de energía
Consolidación de servidores
Consolidación básica de servidores fuera de línea
Estrategia de consolidación de carga de trabajo de VM
Equilibrio de carga de trabajo
Estrategia de migración de equilibrio de carga
Estrategia de balanceo de capacidad de almacenamiento
Estabilización de carga de trabajo
Vecino ruidoso
Vecino ruidoso
Optimización térmica
Estrategia basada en la temperatura de salida
Optimización del flujo de aire
Estrategia de migración de flujo de aire uniforme
Mantenimiento de hardware
Migración de zona
No clasificado
Actuador
Objetivo ficticio — objetivo reservado que se utiliza para pruebas.
Estrategias relacionadas: Estrategia ficticia, Estrategia ficticia utilizando motores de puntuación de muestra y Estrategia ficticia con cambio de tamaño. La estrategia ficticia es una estrategia simulada utilizada para pruebas de integración a través de Tempest. Esta estrategia no proporciona ninguna optimización útil, su único propósito es utilizar las pruebas de Tempest.
La estrategia ficticia utilizando motores de puntuación de muestra es similar a la anterior, con la única diferencia de que utiliza una muestra de 'motor de puntuación', que cuenta utilizando métodos de aprendizaje automático.
La estrategia ficticia con cambio de tamaño es similar a la anterior, con la única diferencia de que utiliza un cambio de tamaño (migración y redimensionamiento).
No se utiliza en producción.
Ahorro de energía — minimizar el consumo de energía. La estrategia de este objetivo, Estrategia de Ahorro de Energía, junto con la Estrategia de Consolidación de Carga de Trabajo de VM, puede cumplir funciones de gestión dinámica de energía (DPM), que ahorran electricidad mediante la consolidación dinámica de cargas de trabajo, incluso en períodos de baja utilización de recursos: las máquinas virtuales se trasladan a un menor número de nodos y los nodos innecesarios se apagan. Después de la consolidación, la estrategia propone una solución para encender/apagar nodos de acuerdo con los parámetros establecidos: “min_free_hosts_num” — número de nodos libres encendidos que esperan carga, y “free_used_percent” — la proporción porcentual de nodos libres encendidos en comparación con el número de nodos ocupados por máquinas. Para que la estrategia funcione, se debe activar y configurar Ironic para trabajar con la encendido/apagado de la energía en los nodos.
Parámetros de la estrategia
parámetro
tipo
por defecto
descripción
porcentaje_usado_gratuito
Número
10.0
la relación entre la cantidad de nodos de computación libres y la cantidad de nodos de computación con máquinas virtuales
num_min_hosts_libres
Int
1
número mínimo de nodos de computación libres
Debe haber al menos dos nodos en la nube. El método utilizado es cambiar el estado de alimentación del nodo (change_node_power_state). La estrategia de recopilación de métricas no es necesaria.
Consolidación de Servidores — minimizar la cantidad de nodos de computación (consolidación). Tiene dos estrategias: Basic Offline Server Consolidation y VM Workload Consolidation Strategy.
La estrategia Basic Offline Server Consolidation minimiza el número total de servidores utilizados, así como el número de migraciones.
La estrategia básica requiere las siguientes métricas:
métrica
servicio
complementos
comentario
compute.node.cpu.percent
ninguno
cpu_util
ninguno
Parámetros de la estrategia: migration_attempts — número de combinaciones para buscar candidatos potenciales para apagado (por defecto, 0, sin límites), period — intervalo de tiempo en segundos para obtener una agregación estática de la fuente de datos de métricas (por defecto, 700).
Métodos utilizados: migración, cambio de estado del servicio nova (change_nova_service_state).
La estrategia VM Workload Consolidation Strategy se basa en un algoritmo heurístico de primer ajuste (first-fit), que se enfoca en la carga medida de CPU y busca minimizar los nodos que tienen una carga demasiado alta o demasiado baja, teniendo en cuenta las limitaciones de capacidad de recursos. Esta estrategia proporciona una solución que conlleva un uso más eficiente de los recursos del clúster, utilizando las siguientes cuatro etapas:
- Fase de descarga — manejo de recursos sobregastados;
- Fase de consolidación — manejo de recursos apenas utilizados;
- Optimización de la solución — reducción de la cantidad de migraciones;
- Desactivar nodos de computación no utilizados.
La estrategia requiere las siguientes métricas:
métrica
servicio
complementos
comentario
memoria
ninguno
disk.root.size
ninguno
Las siguientes métricas no son obligatorias, pero aumentan la precisión de la estrategia si están disponibles:
métrica
servicio
complementos
comentario
memory.resident
ninguno
cpu_util
ninguno
Parámetros de la estrategia: period — intervalo de tiempo en segundos para obtener una agregación estática de la fuente de datos de métricas (por defecto, 3600).
Utiliza los mismos métodos que la estrategia anterior. Más detalles .
Equilibrio de carga de trabajo — equilibrar la carga de trabajo entre los nodos de cómputo. La meta cuenta con tres estrategias: Estrategia de Migración de Balance de Carga de Trabajo, Estabilización de Carga de Trabajo, Estrategia de Balance de Capacidad de Almacenamiento.
La Estrategia de Migración de Balance de Carga de Trabajo inicia migraciones de máquinas virtuales basadas en la carga de trabajo de las máquinas virtuales de los nodos. La decisión de trasladar se toma cada vez que el % de uso de CPU o RAM de un nodo excede el umbral especificado. La máquina virtual trasladada debe acercar el nodo a la carga de trabajo promedio de todos los nodos.
Requisitos
- Uso de procesadores físicos;
- Mínimo de dos nodos de cómputo físicos;
- Componente Ceilometer instalado y configurado — ceilometer-agent-compute, funcionando en cada nodo de cómputo, y API de Ceilometer, así como la recolección de las siguientes métricas:
métrica
servicio
complementos
comentario
cpu_util
ninguno
memory.resident
ninguno
Parámetros de la estrategia:
parámetro
tipo
por defecto
descripción
metrics
String
‘cpu_util’
Métricas que sustentan: ‘cpu_util’, ‘memory.resident’.
umbral
Número
25.0
Umbral de carga de trabajo para la migración.
periodo
Número
300
Período acumulado de tiempo de Ceilometer.
Método utilizado — migración.
La estabilización de carga de trabajo — estrategia dirigida a estabilizar la carga de trabajo mediante migración en vivo. La estrategia se basa en el algoritmo de desviación estándar y determina si hay sobrecarga en el clúster, respondiendo a ella iniciando migraciones de máquinas para estabilizar el clúster.
Requisitos
- Uso de procesadores físicos;
- Mínimo de dos nodos de cómputo físicos;
- Componente Ceilometer instalado y configurado — ceilometer-agent-compute, funcionando en cada nodo de cómputo, y API de Ceilometer, así como la recolección de las siguientes métricas:
métrica
servicio
complementos
comentario
cpu_util
ninguno
memory.resident
ninguno
Estrategia de Balance de Capacidad de Almacenamiento (estrategia implementada a partir de Queens) — la estrategia traslada discos según la carga de los grupos Cinder. La decisión de traslado se toma cada vez que la tasa de uso del grupo excede el umbral especificado. El disco trasladado debe acercar el grupo a la carga promedio de todos los grupos Cinder.
Requisitos y limitaciones
- Mínimo de dos grupos Cinder;
- Capacidad de migrar discos.
- Modelo de datos del clúster — recolector del modelo de datos del clúster Cinder.
Parámetros de la estrategia:
parámetro
tipo
por defecto
descripción
volume_threshold
Número
80.0
Valor umbral de discos para balancear volúmenes.
Método utilizado — migración de disco (volume_migrate).
Noisy Neighbor — identificar y trasladar al 'vecino ruidoso', una máquina virtual con prioridad baja que afecta negativamente el rendimiento de una máquina virtual de alta prioridad en términos de IPC, utilizando en exceso el Last Level Cache. Estrategia propia: Noisy Neighbor (el parámetro utilizado para la estrategia es cache_threshold (valor predeterminado — 35), cuando el rendimiento cae por debajo de este valor se inicia la migración. Para el funcionamiento de la estrategia es necesario tener habilitadas las métricas LLC (Last Level Cache), el último servidor Intel que soporte CMT, así como recoger las siguientes métricas:
métrica
servicio
complementos
comentario
cpu_l3_cache
ninguno
Se requiere Intel .
Modelo de datos del clúster (por defecto): recolector de modelo de datos de clúster Nova. Método aplicado — migración.
El trabajo con este objetivo a través del Dashboard no está completamente implementado en Queens.
Optimización térmica — optimizar el régimen de temperatura. La temperatura de salida (aire de escape) es uno de los sistemas de telemetría térmica importantes para medir el estado de la carga térmica / carga de trabajo del servidor. Para este objetivo hay una estrategia — Outlet temperature based strategy, que toma decisiones sobre la migración de cargas de trabajo a nodos con condiciones térmicas favorables (la temperatura de salida más baja), cuando la temperatura de salida de los hosts originales alcanza el umbral ajustable.
Para el funcionamiento de la estrategia se requiere un servidor con Intel Power Node Manager instalado y configurado , así como recoger las siguientes métricas:
métrica
servicio
complementos
comentario
hardware.ipmi.node.outlet_temperature
IPMI
Parámetros de la estrategia:
parámetro
tipo
por defecto
descripción
umbral
Número
35.0
Umbral de temperatura para la migración.
periodo
Número
30
Intervalo de tiempo en segundos para la agregación estadística de la fuente de datos de métricas.
Método utilizado — migración.
Optimización del flujo de aire — optimizar el modo de ventilación. Estrategia propia — Uniform Airflow using live migration. La estrategia inicia la migración de la máquina virtual cada vez que el flujo de aire del ventilador del servidor supera el umbral especificado.
Para el funcionamiento de la estrategia se requieren:
- Hardware: nodos computacionales <soportando NodeManager 3.0;
- Mínimo dos nodos computacionales;
- Componente ceilometer-agent-compute instalado y configurado en cada nodo computacional y API de Ceilometer, que puede reportar con éxito métricas como flujo de aire, potencia del sistema, temperatura de entrada:
métrica
servicio
complementos
comentario
hardware.ipmi.node.airflow
IPMI
hardware.ipmi.node.temperature
IPMI
hardware.ipmi.node.power
IPMI
Para operar la estrategia, se requiere un servidor con Intel Power Node Manager 3.0 o una versión más reciente instalada y configurada.
Restricciones: El concepto no está destinado para producción.
Se sugiere utilizar este algoritmo con auditorías continuas, ya que en una iteración se planea migrar solo una máquina virtual.
Las migraciones en vivo son posibles.
Parámetros de la estrategia:
parámetro
tipo
por defecto
descripción
threshold_airflow
Número
400.0
Umbral de flujo de aire para la migración. La unidad es 0.1CFM.
threshold_inlet_t
Número
28.0
Umbral de temperatura de entrada para la decisión de migración.
threshold_power
Número
350.0
Umbral de potencia del sistema para la decisión de migración.
periodo
Número
30
Intervalo de tiempo en segundos para la agregación estadística de la fuente de datos de métricas.
Método utilizado — migración.
Mantenimiento de Hardware — mantenimiento de hardware. La estrategia relacionada con este objetivo es la migración zonal. La estrategia es una herramienta para la migración automática y mínima de máquinas virtuales y discos en caso de que sea necesario realizar mantenimiento de hardware. La estrategia organiza un plan de acciones basado en pesos: el conjunto de acciones con mayor peso se programará primero. Existen dos parámetros de configuración: pesos de acciones (action_weights) y paralelización (parallelization).
Restricciones: se requiere la configuración de pesos de acciones y paralelización.
Parámetros de la estrategia:
parámetro
tipo
por defecto
descripción
compute_nodes
array
None
Nodos computacionales para la migración.
storage_pools
array
None
Nodos de almacenamiento para la migración.
parallel_total
integer
6
Número total de acciones que deben ejecutarse en paralelo.
parallel_per_node
integer
2
Número de acciones que se ejecutan en paralelo por cada nodo computacional.
parallel_per_pool
integer
2
Número de acciones que se ejecutan en paralelo por cada grupo de almacenamiento.
priority
object
None
Lista de prioridades para máquinas virtuales y discos.
with_attached_volume
boolean
False
False: las máquinas virtuales se trasladarán después de migrar todos los discos. True: las máquinas virtuales se trasladarán después de migrar todos los discos conectados.
Elementos de la matriz de nodos computacionales:
parámetro
tipo
por defecto
descripción
src_node
string
None
Nodo computacional desde el cual se trasladan las máquinas virtuales (obligatorio).
dst_node
string
None
Nodo de cómputo al que se migran las máquinas virtuales.
Elementos de la matriz de grupos de almacenamiento:
parámetro
tipo
por defecto
descripción
src_pool
string
None
Grupo de almacenamiento desde el cual se trasladan los discos (obligatorio).
dst_pool
string
None
Grupo de almacenamiento al que se trasladan los discos.
src_type
string
None
Tipo de disco original (obligatorio).
dst_type
string
None
Tipo final de disco (obligatorio).
Elementos de priorización de objetos:
parámetro
tipo
por defecto
descripción
project
array
None
Nombres de proyectos.
compute_node
array
None
Nombres de nodos computacionales.
storage_pool
array
None
Nombres de grupos de almacenamiento.
compute
enum
None
Parámetros de la máquina virtual [“vcpu_num”, “mem_size”, “disk_size”, “created_at”].
almacenamiento
enum
None
Parámetros de los discos [“size”, “created_at”].
Los métodos utilizados son la migración de máquinas virtuales y la migración de discos.
No clasificado — un objetivo auxiliar utilizado para facilitar el proceso de desarrollo de la estrategia. No contiene especificaciones y se puede utilizar cada vez que la estrategia aún no esté vinculada a un objetivo existente. Este objetivo también se puede usar como un paso intermedio. La estrategia vinculada a este objetivo es Actuator.
Creación de un nuevo objetivo
Watcher Decision Engine tiene una interfaz de plugin de “objetivo externo”, que permite integrar un objetivo externo que se puede alcanzar mediante una estrategia.
Antes de crear un nuevo objetivo, debe asegurarse de que ninguno de los objetivos existentes cumpla con sus necesidades.
Creación de un nuevo plugin
Para crear un nuevo objetivo, debe: extender la clase objetivo, implementar el método de la clase get_name () para devolver un identificador único del nuevo objetivo que desea crear. Este identificador único debe coincidir con el nombre del punto de entrada que declara más adelante.
A continuación, debe implementar el método de la clase get_display_name () para devolver el nombre de visualización traducido del objetivo que desea crear (no use una variable para devolver la cadena traducida, para que pueda ser recogida automáticamente por la herramienta de traducción).
Implemente el método de la clase get_translatable_display_name (), para devolver la clave de traducción (de hecho, el nombre de visualización en inglés) de su nuevo objetivo. El valor devuelto debe coincidir con la cadena traducida en get_display_name ().
Implemente su método get_efficacy_specification (), para devolver la especificación de eficacia para su objetivo. El método get_efficacy_specification () devuelve una instancia de Unclassified (), proporcionada por Watcher. Esta especificación de eficacia es útil en el proceso de desarrollo de su objetivo, ya que corresponde a una especificación vacía.
→
Arquitectura de Watcher (más información ).
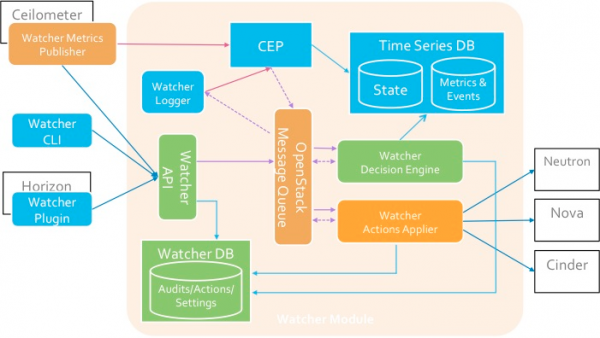
Componentes
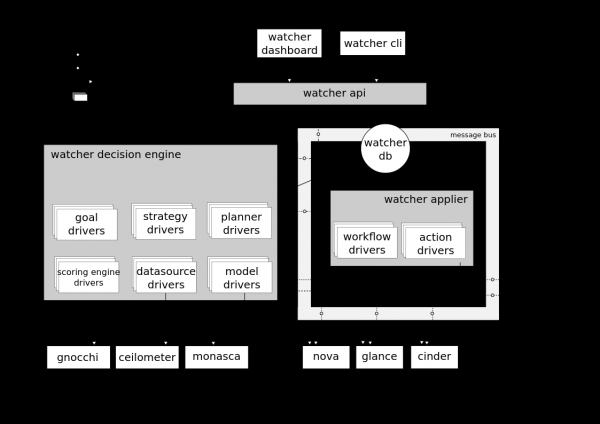
API de Watcher — un componente que implementa la REST API proporcionada por Watcher. Mecanismos de interacción: CLI, plugin de Horizon, SDK de Python.
Base de datos de Watcher — base de datos de Watcher.
Watcher Applier — un componente que implementa la ejecución del plan de acción creado por el componente Watcher Decision Engine.
Watcher Decision Engine — componente responsable de calcular un conjunto de acciones potenciales para la optimización con el fin de cumplir el objetivo de auditoría. Si no se especifica una estrategia, el componente elige por sí mismo la más adecuada.
Publicador de Métricas de Watcher — componente que recopila y calcula algunas métricas o eventos y los publica en un punto final CEP. La funcionalidad del componente también puede ser proporcionada por el publicador de Ceilometer.
Motor de Procesamiento de Eventos Complejos (CEP) — motor de procesamiento de eventos complejos. Por razones de rendimiento, puede haber múltiples instancias del motor CEP funcionando simultáneamente, cada una de las cuales procesa un tipo específico de métrica / eventos. En el sistema Watcher, el CEP lanza dos tipos de acciones: — registrar eventos / métricas correspondientes en una base de datos de series temporales; — enviar eventos correspondientes al componente de Motor de Decisión de Watcher, cuando este evento puede influir en el resultado de la estrategia de optimización actual, ya que el clúster de OpenStack no es un sistema estático.
La interacción entre componentes se realiza a través del protocolo AMQP.
→
Esquema de interacción con Watcher
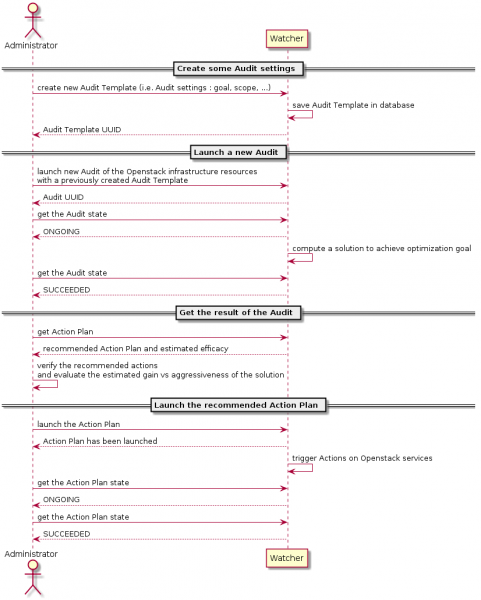
Resultados de pruebas de Watcher
- En la página de Optimización — Planes de acción, se muestra un error 500 (tanto en Queens limpio como en el entorno con módulos Tionix), aparece solo después de que se inicia la auditoría y se genera un plan de acción; la página en blanco se abre normalmente.
- En la pestaña de Detalles de acción hay errores, no se puede obtener el objetivo y la estrategia de auditoría (tanto en Queens limpio como en el entorno con módulos Tionix).
- Las auditorías con el objetivo Dummy (de prueba) se crean y se inician normalmente, generando planes de acción.
- Las auditorías con el objetivo No clasificado no se crean, ya que el objetivo no es funcional y está destinado para ajustes intermedios al crear nuevas estrategias.
- Las auditorías con el objetivo de Balanceo de Carga de Trabajo (estrategia de Equilibrio de Capacidad de Almacenamiento) se crean con éxito, pero no se genera un plan de acción. No se requiere optimización de los grupos de almacenamiento.
- Las auditorías con el objetivo de Balanceo de Carga de Trabajo (estrategia de Estrategia de Migración de Balanceo de Carga de Trabajo) se crean con éxito, pero no se genera un plan de acción.
- Las auditorías con el objetivo de Balanceo de Carga de Trabajo (estrategia de Estrategia de Estabilización de Carga de Trabajo) terminan con un error.
- Las auditorías con el objetivo de Vecino Ruidoso se crean con éxito, pero no se genera un plan de acción.
- Las auditorías con el objetivo de mantenimiento de hardware se crean correctamente, pero el plan de acción se genera de manera incompleta (se generan indicadores de rendimiento, pero no se genera la lista de acciones en sí).
- Los ajustes en los archivos de configuración nova.conf (en la sección predeterminada compute_monitors = cpu.virt_driver) en los nodos de cómputo y control no corrigen los errores.
- Las auditorías con el objetivo de consolidación de servidores (estrategia básica) también finalizan con error.
- Las auditorías con el objetivo de consolidación de servidores (estrategia de consolidación de carga de trabajo de VM) finalizan con error. En los registros hay un error al obtener los datos de origen. Discusión sobre el error, en particular, .
Intentamos especificar en el archivo de configuración de Watcher (no funcionó — como resultado, errores en todas las páginas de Optimización; volver al contenido original del archivo de configuración no resuelve la situación):[watcher_strategies.basic]
datasource = ceilometer, gnocchi - Las auditorías con el objetivo de ahorro de energía finalizan con error. Según los registros, el problema está en la falta de Ironic, no funcionará sin el servicio baremetal.
- Las auditorías con el objetivo de optimización térmica finalizan con error. El traceback es el mismo que para la consolidación de servidores (estrategia de consolidación de carga de trabajo de VM) (error de datos de origen)
- Las auditorías con el objetivo de optimización de flujo de aire finalizan con error.
También se presentan los siguientes errores al finalizar la auditoría. Traceback en los registros decision-engine.log (estado del clúster no definido).
→ Discusión sobre el error
Conclusión
El resultado de nuestras investigaciones durante dos meses fue la conclusión inequívoca de que, para obtener un sistema de balanceo de carga completo y funcional, tendremos que trabajar intensamente en la mejora de las herramientas para la plataforma Openstack.
Watcher ha demostrado ser un producto serio y en rápida evolución con un gran potencial, para el cual se requerirá un trabajo extenso y serio para su uso completo.
Pero eso será en los siguientes artículos del ciclo.
Fuente: habr.com
