

KDB+, producto de la empresa es una base de datos en columna, excepcionalmente rápida, que es ampliamente conocida en círculos especializados y está diseñada para almacenar series temporales y realizar cálculos analíticos basados en ellas. Originalmente disfrutó (y sigue disfrutando) de gran popularidad en la industria financiera: todos los bancos de inversión top 10 y muchos fondos de cobertura, bolsas y otras organizaciones la utilizan. Recientemente, KX decidió ampliar su base de clientes y ahora ofrece soluciones en otros campos donde hay grandes volúmenes de datos organizados por tiempo u otras categorías, como telecomunicaciones, bioinformática, manufactura, etc. También se han asociado con el equipo Aston Martin Red Bull Racing en la Fórmula 1, donde ayudan a recopilar y procesar datos de los sensores de los vehículos y a analizar pruebas en el túnel de viento. En este artículo, quiero explicar qué características hacen que KDB+ sea de alto rendimiento, por qué las empresas están dispuestas a gastar grandes sumas en ella y, finalmente, por qué en realidad no es una base de datos.
En este artículo, trataré de explicar en términos generales qué es KDB+, qué posibilidades y limitaciones tiene, y cuál es su utilidad para las empresas que desean procesar grandes volúmenes de datos. No entraré en detalles sobre la implementación de KDB+ ni en su lenguaje de programación Q. Ambas son temáticas muy amplias y merecen artículos separados. Se puede encontrar mucha información sobre estos temas en el sitio web code.kx.com, incluida una guía sobre Q: Q For Mortals (ver el enlace a continuación).
Algunos términos
- Base de datos en memoria. Una base de datos que almacena datos en la memoria RAM para acelerar el acceso. Las ventajas de este tipo de base de datos son claras, mientras que sus desventajas incluyen la posibilidad de pérdida de datos y la necesidad de contar con mucha memoria en el servidor.
- Base de datos en columna. Una base de datos donde los datos se almacenan por columnas, en lugar de fila por fila. La principal ventaja de este tipo de base de datos es que los datos de una misma columna se almacenan juntos en el disco y en la memoria, lo que acelera significativamente el acceso a ellos. No es necesario cargar columnas que no se utilizan en la consulta. La principal desventaja es que es complicado modificar y eliminar registros.
- Serie temporal. Datos con una columna de tipo fecha o hora. Por lo general, para estos datos es importante que haya un orden temporal, para poder determinar fácilmente qué registro precede o sigue al actual, o para aplicar funciones cuyo resultado dependa del orden de los registros. Las bases de datos clásicas se construyen sobre un principio completamente diferente: la representación de un conjunto de registros como una colección, donde el orden de los registros no está definido en principio.
- Vector. En el contexto de KDB+ — es una lista de elementos de un tipo atómico, por ejemplo, números. En otras palabras, un arreglo de elementos. Los arreglos, a diferencia de las listas, se pueden almacenar de manera compacta y procesar utilizando instrucciones vectoriales del procesador.
Nota histórica
La compañía KX fue fundada en 1993 por Arthur Whitney, quien anteriormente había trabajado en el banco Morgan Stanley en el lenguaje A+, un sucesor de APL — un lenguaje muy original y en su momento popular en el mundo financiero. Por supuesto, en KX, Arthur continuó en la misma línea y creó el lenguaje funcional vectorial K, guiándose por ideas de radical minimalismo. Los programas en K parecen un conjunto desordenado de signos de puntuación y símbolos especiales, el significado de los signos y funciones depende del contexto, y cada operación lleva consigo mucho más sentido que en los lenguajes de programación convencionales. Gracias a esto, un programa en K ocupa un espacio mínimo — unas pocas líneas pueden reemplazar páginas de texto en lenguajes prolijos como Java — y es una implementación altamente concentrada de un algoritmo.
Función en K que implementa gran parte del generador de un parser LL1 según la gramática dada:
1. pp:{q:{(x;p3(),y)};r:$[-11=@x;$x;11=@x;q[`N;$*x];10=abs@@x;q[`N;x]
2.   ($)~*x;(`P;p3 x 1);(1=#x)&11=@*x;pp[{(1#x;$[2=#x;;,:]1_x)}@*x]
3.      (?)~*x;(`Q;pp[x 1]);(*)~*x;(`M;pp[x 1]);(+)~*x;(`MP;pp[x 1]);(!)~*x;(`Y;p3 x 1)
4.      (2=#x)&(@x 1)in 100 101 107 7 -7h;($[(@x 1)in 100 101 107h;`Ff;`Fi];p3 x 1;pp[*x])
5.      (|)~*x;`S,(pp'1_x);2=#x;`C,{@[@[x;-1+#x;{x,")"}];0;"(",]}({$[".s.C"~4#x;6_-2_x;x]}'pp'x);'`pp];
6.   $[@r;r;($[1<#r;".s.";""],$*r),$[1<#r;"[",(";"/1_r),"]";""]]}
Esta filosofía de eficiencia extrema con el mínimo de movimiento fue llevada a cabo por Arthur también en KDB+, que apareció en 2003 (creo que ahora está claro de dónde proviene la letra K en el nombre) y no es más que un intérprete de la cuarta versión del lenguaje K. Sobre K se ha añadido una versión visualmente más agradable para el usuario llamada Q. En Q también se ha añadido el soporte para un dialecto específico de SQL — QSQL, y en el intérprete — el soporte para tablas como tipo de dato del sistema, herramientas para trabajar con tablas en memoria y en disco, etc.
Así, desde el punto de vista del usuario, KDB+ es simplemente un intérprete del lenguaje Q con soporte para tablas y expresiones similares a SQL al estilo LINQ de C#. Esta es la distinción más importante de KDB+ en comparación con otras bases de datos y su principal ventaja competitiva que a menudo se pasa por alto. No es una base de datos + un lenguaje auxiliar inválido, sino un completo y poderoso lenguaje de programación + soporte incorporado para funciones de bases de datos. Esta diferencia jugará un papel crucial al enumerar todas las ventajas de KDB+. Por ejemplo…
Tamaño
Según los estándares modernos, KDB+ tiene un tamaño simplemente microscópico. Literalmente, se trata de un solo archivo ejecutable de menos de un megabyte y un pequeño archivo de texto con algunas funciones del sistema. De hecho, es menos de un megabyte y las empresas pagan decenas de miles de dólares al año por un procesador en el servidor por este programa.
- Este tamaño permite que KDB+ funcione perfectamente en cualquier hardware, desde microcomputadoras Pi hasta servidores con terabytes de memoria. La funcionalidad no se ve afectada en absoluto, de hecho, Q arranca al instante, lo que permite utilizarlo también como un lenguaje de scripting.
- Con tal tamaño, el intérprete Q cabe completamente en la caché del procesador, lo que acelera la ejecución de programas.
- Con tal tamaño de archivo ejecutable, el proceso Q ocupa un espacio insignificante en la memoria, se pueden ejecutar cientos de ellos. Al mismo tiempo, si es necesario, Q puede operar con decenas o cientos de gigabytes de memoria en un solo proceso.
Versatilidad
Q es ideal para una amplia variedad de tareas. El proceso Q puede funcionar como una base de datos histórica y proporcionar acceso rápido a terabytes de información. Por ejemplo, tenemos decenas de bases de datos históricas, en algunas de las cuales un día de datos sin comprimir ocupa más de 100 gigabytes. Sin embargo, con límites razonables, la consulta a la base de datos se ejecutará en decenas a cientos de milisegundos. En general, tenemos un tiempo de espera universal para las consultas de los usuarios de 30 segundos, y se activa muy raramente.
Con la misma facilidad, Q puede ser una base de datos en memoria. La adición de nuevos datos a las tablas en memoria se realiza tan rápido que el factor limitante son las consultas de los usuarios. Los datos en las tablas se almacenan por columnas, lo que significa que cualquier operación por columna utilizará el caché del procesador al máximo. Además, en KX hemos tratado de implementar todas las operaciones básicas tipo aritméticas a través de instrucciones vectoriales del procesador, maximizando su velocidad. Q puede llevar a cabo tareas no propias de las bases de datos, por ejemplo, procesar datos en streaming y calcular en "tiempo real" (con un retraso de decenas de milisegundos a varios segundos dependiendo de la tarea) diversas funciones de agregación para instrumentos financieros en diferentes intervalos de tiempo o construir un modelo del impacto de una transacción en el mercado y realizar su perfilado prácticamente inmediatamente después de su ejecución. En dichas tareas, la mayor parte del retraso temporal es ocasionado no por Q, sino por la necesidad de sincronizar datos de diferentes fuentes. La alta velocidad se logra gracias a que los datos y las funciones que los procesan están en un solo proceso, y el procesamiento se reduce a la ejecución de varias expresiones QSQL y joins, que no son interpretados, sino que se ejecutan como código binario.
Finalmente, en Q se pueden escribir también cualquier proceso de servicio. Por ejemplo, procesos Gateway, que distribuyen automáticamente las consultas de los usuarios entre las bases y servidores necesarios. El programador tiene plena libertad para implementar cualquier algoritmo para balanceo, priorización, tolerancia a fallos, control de acceso, cuotas y, en general, lo que desee. El principal problema aquí es que tendrá que implementar todo eso por sí mismo.
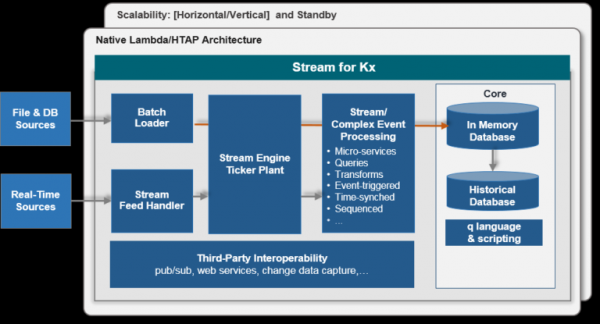
A modo de ejemplo, enumeraré los tipos de procesos que tenemos. Todos ellos se utilizan activamente y trabajan en conjunto, combinando decenas de bases diferentes, procesando datos de múltiples fuentes y atendiendo a cientos de usuarios y aplicaciones.
- Conectores (feedhandler) a fuentes de datos. Estos procesos utilizan, por regla general, bibliotecas externas que se cargan en Q. La interfaz C en Q es extremadamente simple y permite crear fácilmente funciones proxy para cualquier biblioteca en C/C++. Q es lo suficientemente rápido como para manejar, por ejemplo, el procesamiento de flujos de mensajes FIX de todas las bolsas de valores europeas al mismo tiempo.
- Distribuidores de datos (tickerplant), que actúan como intermediarios entre los conectores y los consumidores. Al mismo tiempo, registran los datos entrantes en un registro binario especial, asegurando que los consumidores sean resistentes a la pérdida de conexión o a reinicios.
- Bases de datos en memoria (rdb). Estas bases permiten un acceso extremadamente rápido a datos en crudo recién obtenidos, almacenándolos en la memoria. En general, acumulan datos en tablas a lo largo del día y los reinician por la noche.
- Bases de datos persistentes (pdb). Estas bases garantizan la conservación de los datos del día actual en una base histórica. A diferencia de las rdb, por regla general no almacenan datos en memoria, sino que utilizan un caché especial en disco durante el día y copian los datos a la base histórica a medianoche.
- Bases de datos históricas (hdb). Estas bases proporcionan acceso a datos de días, meses y años anteriores. Su tamaño (en días) está limitado únicamente por la capacidad de los discos duros. Los datos pueden estar ubicados en cualquier lugar, incluso en diferentes discos para acelerar el acceso. Existe la posibilidad de comprimir los datos utilizando varios algoritmos. La estructura de la base está bien documentada y es simple, y los datos se almacenan columna por columna en archivos normales, lo que permite procesarlos incluso con herramientas del sistema operativo.
- Bases de datos con información agregada. Almacenan diversas agregaciones, generalmente agrupadas por nombre de instrumento y intervalo de tiempo. Las bases de datos en memoria actualizan su estado con cada mensaje entrante, mientras que las históricas almacenan datos pre-calculados para acelerar el acceso a los datos históricos.
- Finalmente, procesos de gateway, que atienden aplicaciones y usuarios. Q permite implementar un procesamiento totalmente asíncrono de los mensajes entrantes, su distribución a bases de datos, comprobación de derechos de acceso, etc. Cabe destacar que los mensajes no están limitados y a menudo no son expresiones SQL, como sucede en otras bases de datos. La mayoría de las veces, la expresión SQL se oculta en una función especial y se construye a partir de los parámetros solicitados por el usuario; se lleva a cabo la conversión de tiempo, filtrado y los datos se normalizan (por ejemplo, el precio de las acciones se alinea si hubo un pago de dividendos), etc.
Arquitectura típica para un tipo de datos:
Velocidad
Aunque Q es un lenguaje interpretado, al mismo tiempo es un lenguaje vectorial. Esto significa que muchas funciones integradas, en particular las aritméticas, aceptan argumentos de cualquier forma: números, vectores, matrices, listas, y se espera que el programador implemente el programa como operaciones sobre arreglos. En un lenguaje así, si sumas dos vectores de un millón de elementos, ya no importa que el lenguaje sea interpretado; la suma se realizará mediante una función binaria superoptimizadora. Dado que la mayor parte del tiempo en los programas en Q se dedica a operaciones con tablas que utilizan estas funciones vectorizadas básicas, el resultado es una velocidad de operación bastante aceptable, lo que permite procesar grandes volúmenes de datos incluso en un solo proceso. Esto es similar a las bibliotecas matemáticas en Python: aunque Python en sí no es un lenguaje muy rápido, tiene muchas excelentes bibliotecas como numpy, que permiten procesar datos numéricos a la velocidad de un lenguaje compilado (por cierto, numpy está ideológicamente cercana a Q).
Además, KX ha abordado meticulosamente el diseño de tablas y la optimización del trabajo con ellas. Primero, se admiten varios tipos de índices, que son compatibles con funciones integradas y se pueden aplicar no solo a las columnas de las tablas, sino también a cualquier vector: agrupación, ordenación, atributo de unicidad y agrupación especial para bases históricas. El índice se aplica de manera elemental y se ajusta automáticamente al agregar elementos a la columna/vector. Los índices pueden aplicarse con igual éxito a las columnas de las tablas, tanto en memoria como en disco. Al ejecutar una consulta QSQL, los índices se utilizan automáticamente, si es posible. En segundo lugar, el trabajo con datos históricos se realiza a través de un mecanismo de mapeo de archivos del sistema operativo (memory map). Las tablas grandes nunca se cargan en memoria; en su lugar, las columnas necesarias se representan directamente en memoria, y solo se carga realmente aquella parte que se necesita (los índices ayudan en esto). Para el programador, no hay diferencia en si los datos están en memoria o no, el mecanismo de trabajo con mmap está completamente oculto en las entrañas de Q.
KDB+ es una base de datos no relacional; las tablas pueden contener datos arbitrarios, y el orden de las filas en la tabla no cambia al agregar nuevos elementos y puede y debe utilizarse al escribir consultas. Esta característica es extremadamente necesaria para trabajar con series temporales (datos del mercado, telemetría, registros de eventos), porque si los datos están ordenados por tiempo, el usuario no necesita aplicar trucos de SQL para encontrar en la tabla la primera o última fila por tiempo o las N filas, o determinar qué fila sigue a la N-ésima fila, etc. Los joins de tablas se simplifican aún más, por ejemplo, encontrar para 16000 transacciones de VOD.L (Vodafone) la última cotización en una tabla de 500 millones de elementos toma alrededor de un segundo en disco y una docena de milisegundos en memoria.
Un ejemplo de un join por tiempo: la tabla de quotes se representa en memoria, por lo que no es necesario indicar VOD.L en el where; se utilizan implícitamente el índice en la columna sym y el hecho de que los datos están ordenados por tiempo. Casi todos los joins en Q son funciones ordinarias, no parte de la expresión select:
1. aj[`sym`time;select from trade where date=2019.03.26, sym=`VOD.L;select from quote where date=2019.03.26]
Por último, es importante mencionar que los ingenieros de KX, comenzando por Arthur Whitney, están realmente obsesionados con la eficiencia y hacen todo lo posible para maximizar las funciones estándar de Q y optimizar los patrones de uso más comunes.
Summary
KDB+ es popular entre las empresas principalmente debido a su excepcional versatilidad; funciona igualmente bien como una base de datos en memoria, como almacenamiento de terabytes de datos históricos y como plataforma para el análisis de datos. Gracias a que el procesamiento de datos se realiza directamente en la base, se logra una alta velocidad de operación y un ahorro de recursos. Un lenguaje de programación completo, integrado con funciones de base de datos, permite implementar en una sola plataforma todo el proceso necesario, desde la obtención de datos hasta el procesamiento de las solicitudes de usuarios.
Información adicional
Desventajas
Una desventaja significativa de KDB+/Q es su alta barrera de entrada. El lenguaje tiene una sintaxis peculiar, algunas funciones están muy sobrecargadas (value, por ejemplo, tiene alrededor de 11 variantes de uso). Lo más importante es que requiere un enfoque radicalmente diferente para escribir programas. En un lenguaje vectorial, es necesario pensar constantemente en términos de transformaciones de matrices, implementar todos los bucles a través de varias funciones map/reduce (que se llaman adverbs en Q) y nunca intentar ahorrar reemplazando operaciones vectoriales por atómicas. Por ejemplo, para encontrar el índice de la N-ésima aparición de un elemento en una matriz, hay que escribir:
1. (where element=vector)[N]
aunque esto puede parecer horriblemente ineficiente a los estándares de C/Java (ya que crea un vector booleano, donde where devuelve los índices de los elementos verdaderos en él). Pero esta notación hace que el significado de la expresión sea más claro y utiliza operaciones vectoriales rápidas en lugar de operaciones atómicas lentas. La diferencia conceptual entre un lenguaje vectorial y otros es comparable a la diferencia entre los enfoques imperativo y funcional en la programación, y a esto hay que estar preparado.
Algunos usuarios también pueden estar descontentos con QSQL. La cuestión es que solo se parece a un SQL real. En realidad, es solo un intérprete de expresiones similares a SQL, que no admite la optimización de consultas. El usuario debe escribir consultas óptimas por sí mismo, y además en Q, lo que muchos no están preparados para hacer. Por otro lado, siempre se puede escribir una consulta óptima uno mismo, en lugar de confiar en una caja negra optimizadora.
Como ventaja, el libro sobre Q — Q For Mortals está disponible gratuitamente en , donde también se recopilan muchos otros materiales útiles.
Otra gran desventaja es el costo de la licencia. Son decenas de miles de dólares al año por un solo CPU. Solo las grandes empresas pueden permitirse tales gastos. Recientemente, KX ha hecho su política de licencias más flexible y ofrece la posibilidad de pagar solo por el tiempo de uso o rentar KDB+ en los nubes de Google y Amazon. KX también ofrece para descargar (versión de 32 bits o de 64 bits a solicitud).
Competidores
Existen muchas bases de datos especializadas construidas sobre principios similares: basadas en columnas, en memoria, orientadas a volúmenes de datos muy grandes. El problema es que son precisamente bases de datos especializadas. Un ejemplo notable es Clickhouse. Esta base de datos tiene un principio de almacenamiento en disco y construcción de índices muy similar a KDB+, y algunos de sus queries se ejecutan más rápido que KDB+, aunque no de manera significativa. Pero incluso como base de datos, Clickhouse es más especializada que KDB+: análisis web frente a series temporales arbitrarias (esta diferencia es muy importante; por ejemplo, en Clickhouse no hay posibilidad de utilizar el orden de los registros). Sin embargo, lo principal es que Clickhouse carece de la versatilidad de KDB+, un lenguaje que permite procesar datos directamente en la base, en lugar de cargarlos previamente en una aplicación separada, construir expresiones SQL arbitrarias, aplicar funciones arbitrarias en una consulta y crear procesos no relacionados con la ejecución de funciones de la base histórica. Por lo tanto, es difícil comparar KDB+ con otras bases; pueden ser mejores en ciertos escenarios de uso o simplemente mejores cuando se trata de tareas de bases de datos clásicas, pero no conozco otra herramienta tan efectiva y versátil para procesar datos temporales.
Integración con Python
Para simplificar el trabajo con KDB+ para las personas que no están familiarizadas con la tecnología, KX creó bibliotecas para una integración estrecha con Python dentro de un solo proceso. Se puede invocar cualquier función de Python desde Q y viceversa — invocar cualquier función Q desde Python (en particular expresiones QSQL). Las bibliotecas convierten, si es necesario (por eficiencia no siempre), los datos del formato de un lenguaje al formato de otro. Como resultado, Q y Python conviven en tal simbiosis que las fronteras entre ambos se desdibujan. Por lo tanto, el programador, por un lado, tiene acceso completo a numerosas útiles bibliotecas de Python; por otro lado, obtiene una base rápida integrada en Python para trabajar con grandes datos, lo que es especialmente útil para quienes se dedican al aprendizaje automático o la modelación.
Trabajando con Q en Python:
1. >>> q()
2. q)trade:([]date:();sym:();qty:())
3. q)
4. >>> q.insert('trade', (date(2006,10,6), 'IBM', 200))
5. k(',0')
6. >>> q.insert('trade', (date(2006,10,6), 'MSFT', 100))
7. k(',1')
Enlaces
Sitio web de la empresa —
Sitio para desarrolladores —
Libro Q For Mortals (en inglés) —
Artículos sobre aplicaciones de KDB+/Q por empleados de kx —
Fuente: habr.com
