

Hemos diseñado con éxito la estructura de nuestra base de datos PostgreSQL para almacenar correspondencia; ha pasado un año y los usuarios la están llenando activamente, ya contiene millones de registros, y... algo comenzó a ralentizarse.
- Parte 2: seccionamos 'en vivo'
La cuestión es que Con el aumento del tamaño de la tabla, también crece la «profundidad» de los índices — aunque de manera logarítmica. Pero con el tiempo esto obliga al servidor a procesar muchas más páginas de datos, en comparación con al principio.
Aquí es donde entra en juego el particionamiento.
Cabe señalar que no se trata de sharding, es decir, la distribución de datos entre diferentes bases de datos o servidores. Porque, incluso si divides los datos entre varios servidores, no podrás evitar el problema de la «inflación» de los índices con el tiempo. Es obvio que si puedes permitirte poner en funcionamiento un nuevo servidor cada día, entonces tus problemas estarán en un nivel diferente al de una base de datos específica.
Vamos a considerar no los scripts específicos para implementar el particionamiento «en hardware», sino el enfoque mismo — qué y cómo se debe «cortar en porciones», y a qué lleva este deseo.
Concepto
Una vez más definamos nuestro objetivo: queremos asegurarnos de que hoy, mañana y dentro de un año, la cantidad de datos legibles de PostgreSQL en cualquier operación de lectura/escritura permanezca aproximadamente igual.
Para cualquier dato acumulado cronológicamente (mensajes, documentos, registros, archivos,…), la elección natural como clave de particionamiento es la fecha/hora del evento. En nuestro caso, ese evento es el momento del envío del mensaje.
Notemos que los usuarios casi siempre trabajan solo con los «últimos» datos de este tipo — leen los mensajes más recientes, analizan los registros más recientes,… No, claro, pueden desplazarse más atrás en el tiempo, solo que lo hacen muy raramente.
De estas limitaciones se deduce que la solución óptima para los mensajes será secciones «diarias» — ya que casi siempre nuestro usuario leerá lo que le ha llegado «hoy» o «ayer».
Si durante el día escribimos y leemos prácticamente solo en una sección, esto nos brinda también un uso más eficiente de la memoria y del disco — dado que todos los índices de la sección caben cómodamente en la memoria, a diferencia de los «grandes y pesados» de toda la tabla.
step-by-step
En general, todo lo mencionado anteriormente suena como una gran ganancia. Y es alcanzable, pero para ello tendremos que esforzarnos mucho, porque la decisión de seccionar una de las entidades conlleva la necesidad de "recortar" también las relacionadas con ella.
El mensaje, sus propiedades y proyecciones
Dado que hemos decidido segmentar los mensajes por fechas, también sería razonable dividir las entidades-propiedades dependientes (archivos adjuntos, lista de destinatarios), y también por fecha del mensaje.
Dado que una de nuestras tareas típicas es revisar los registros de mensajes (no leídos, entrantes, todos), también sería lógico "incluirlos" en la segmentación por fechas de los mensajes.
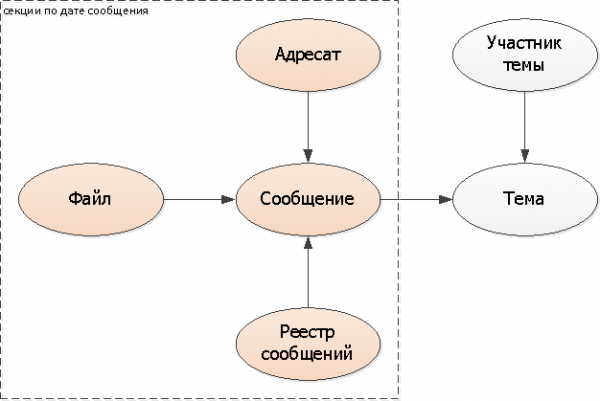
Agregamos la clave de segmentación (fecha del mensaje) a todas las tablas: destinatarios, archivo, registros. No es necesario añadirla al propio mensaje, sino utilizar el existente FechaHora.
Temas
Dado que un tema se relaciona con varios mensajes, no se puede "recortar" en el mismo modelo, hay que basarse en otra cosa. En nuestro caso, encaja perfectamente la fecha del primer mensaje en la conversación es decir, el momento en que se creó, en realidad, el tema.
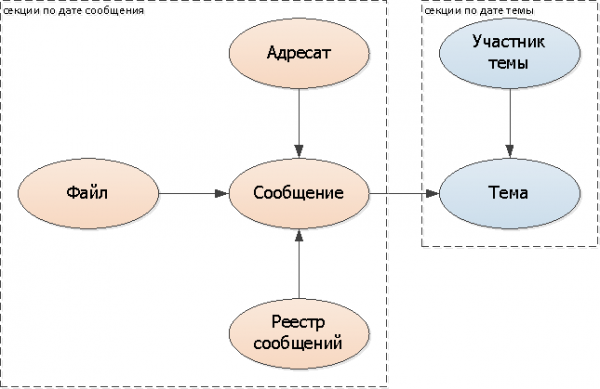
Agregamos la clave de segmentación (fecha del tema) a todas las tablas: tema, participante.
Pero ahora nos surgen de inmediato dos problemas:
- ¿en qué sección buscar mensajes por tema?
- ¿en qué sección buscar el tema a partir del mensaje?
Claro que se puede seguir buscando en todas las secciones, pero eso sería muy triste y anularía todas nuestras ganancias. Por lo tanto, para saber dónde buscar exactamente, haremos enlaces lógicos/indicadores en las secciones:
- en el mensaje añadiremos un campo con la fecha del tema
- al tema añadiremos un conjunto de fechas de mensajes de esta conversación (puede ser una tabla separada o un array de fechas)
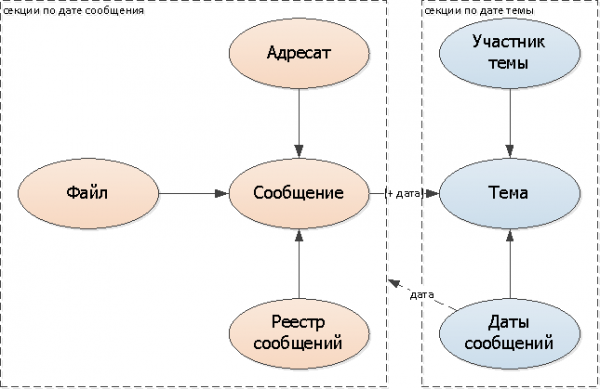
Dado que habrá pocas modificaciones en la lista de fechas de mensajes para cada conversación en particular (ya que casi todos los mensajes caen en 1-2 días consecutivos), me quedaré con esta opción.
En resumen, la estructura de nuestra base se ha configurado de la siguiente manera considerando la segmentación:
Tablas: RU, si se siente aversión a usar cirílico en los nombres de las tablas/campos, es mejor no mirar
-- secciones por fecha del mensaje
CREATE TABLE "Mensaje_YYYYMMDD"(
  "Mensaje"
    uuid
      PRIMARY KEY
, "Tema"
    uuid
, "FechaTema"
    date
, "Autor"
    uuid
, "FechaHora" -- utilizado como fecha
    timestamp
, "Texto"
    text
);

CREATE TABLE "Destinatario_YYYYMMDD"(
  "FechaMensaje"
    date
, "Mensaje"
    uuid
, "Persona"
    uuid
, PRIMARY KEY("Mensaje", "Persona")
);

CREATE TABLE "Archivo_YYYYMMDD"(
  "FechaMensaje"
    date
, "Archivo"
    uuid
      PRIMARY KEY
, "Mensaje"
    uuid
, "BLOB"
    uuid
, "Nombre"
    text
);

CREATE TABLE "RegistroMensajes_YYYYMMDD"(
  "FechaMensaje"
    date
, "Propietario"
    uuid
, "TipoRegistro"
    smallint
, "FechaHora"
    timestamp
, "Mensaje"
    uuid
, PRIMARY KEY("Propietario", "TipoRegistro", "Mensaje")
);
CREATE INDEX ON "RegistroMensajes_YYYYMMDD"("Propietario", "TipoRegistro", "FechaHora" DESC);

-- secciones por fecha del tema
CREATE TABLE "Tema_YYYYMMDD"(
  "FechaTema"
    date
, "Tema"
    uuid
      PRIMARY KEY
, "Documento"
    uuid
, "Título"
    text
);

CREATE TABLE "ParticipanteTema_YYYYMMDD"(
  "FechaTema"
    date
, "Tema"
    uuid
, "Persona"
    uuid
, PRIMARY KEY("Tema", "Persona")
);

CREATE TABLE "FechasMensajesTema_YYYYMMDD"(
  "FechaTema"
    date
, "Tema"
    uuid
      PRIMARY KEY
, "Fecha"
    date);
Ahorremos un poco
Pero, si no utilizamos el basado en la distribución de los valores del campo (a través de triggers y herencia o PARTITION BY), y lo hacemos "manualmente" a nivel de aplicación, se puede notar que el valor de la clave de particionado ya se almacena en el nombre de la tabla misma.
Por lo tanto, si estás tan preocupado por el volumen de datos almacenados, entonces puedes deshacerte de estos "campos innecesarios" y acceder directamente a tablas específicas. Sin embargo, todas las selecciones de varias secciones en este caso deberán ser manejadas por la aplicación.
Fuente: habr.com
